<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>Perry&#39;s Galaxy</title>
  
  <subtitle>Biology · Computation · Curiosity</subtitle>
  <link href="https://perry.apay.eu.cc/atom.xml" rel="self"/>
  
  <link href="https://perry.apay.eu.cc/"/>
  <updated>2026-10-05T11:41:38.000Z</updated>
  <id>https://perry.apay.eu.cc/</id>
  
  <author>
    <name>Perry</name>
    
  </author>
  
  <generator uri="https://hexo.io/">Hexo</generator>
  
  <entry>
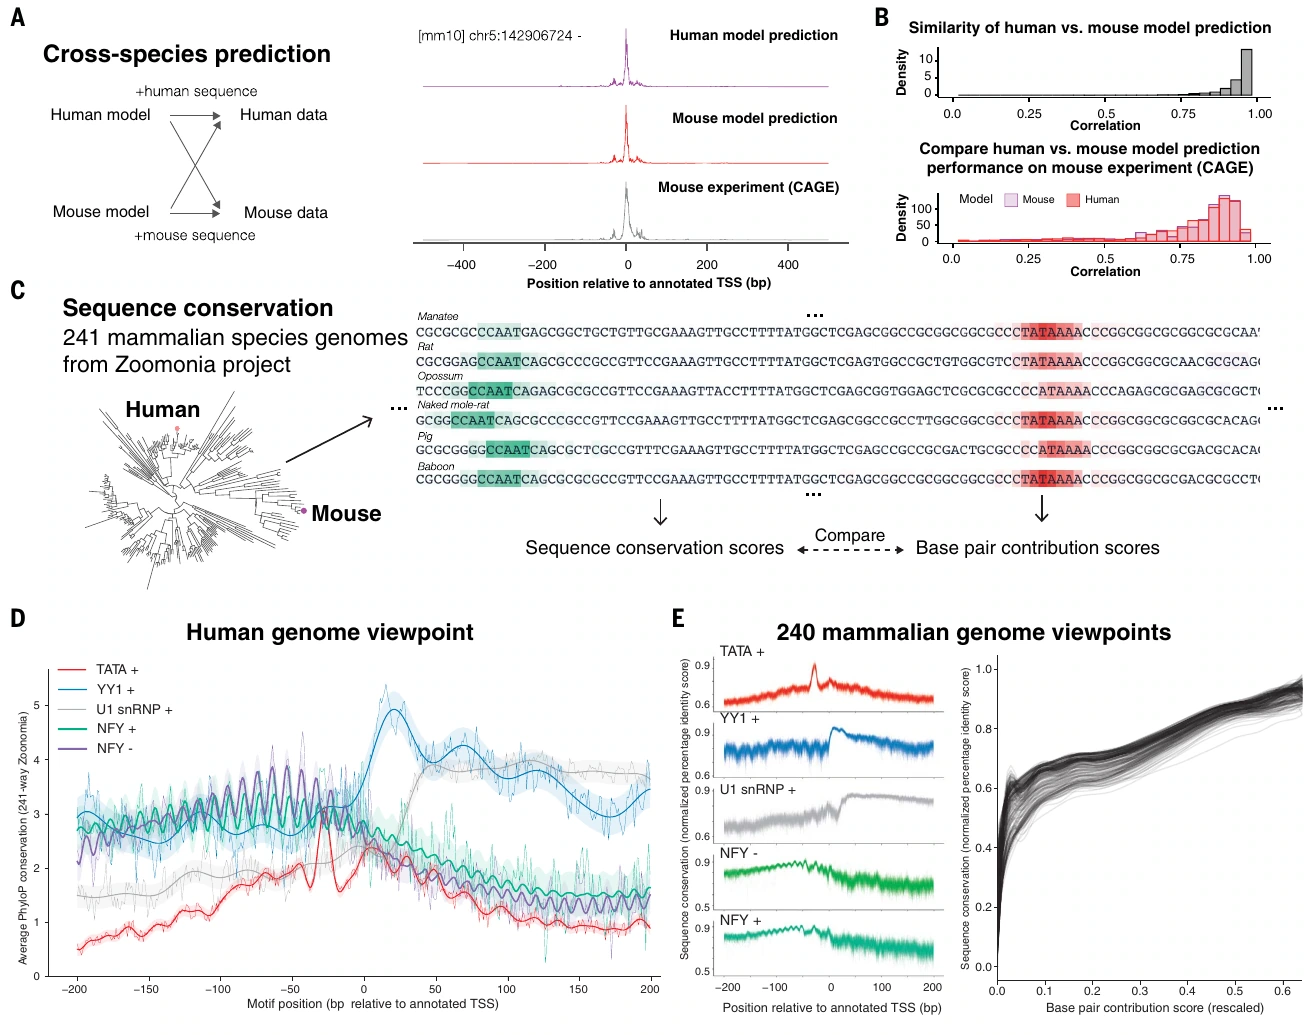
    <title>92.ProCapNet：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad92005c/"/>
    <id>https://perry.apay.eu.cc/posts/ad92005c/</id>
    <published>2026-10-04T12:01:32.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
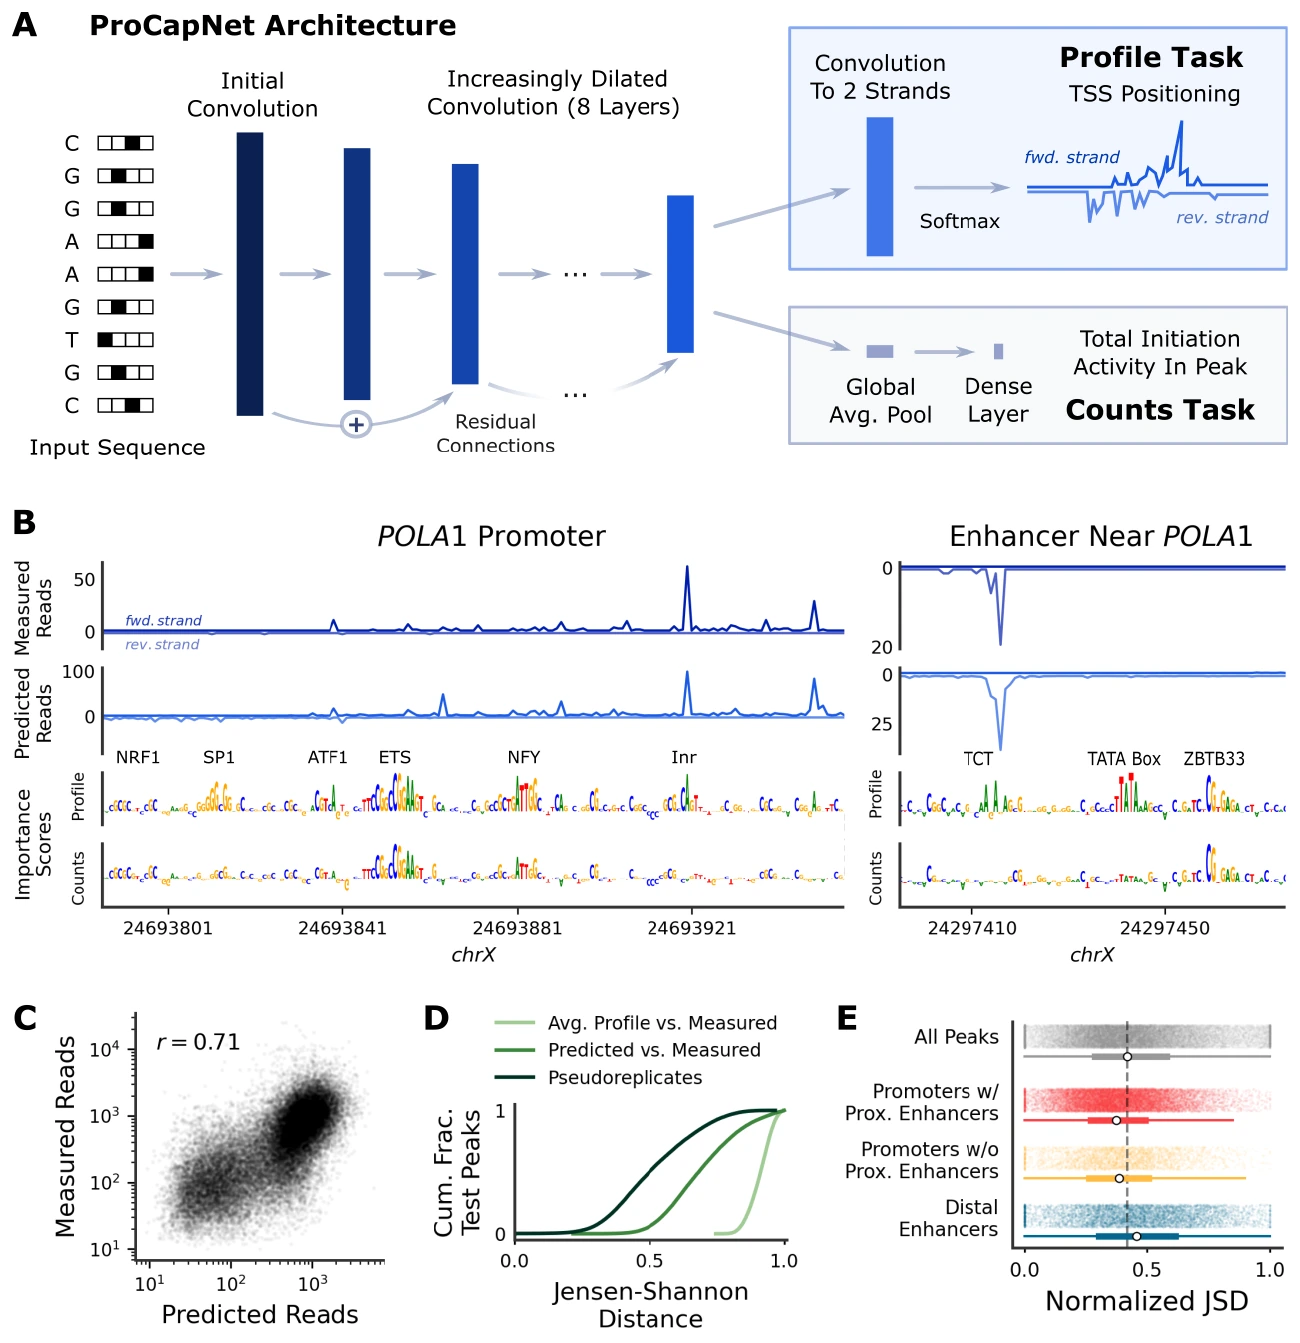
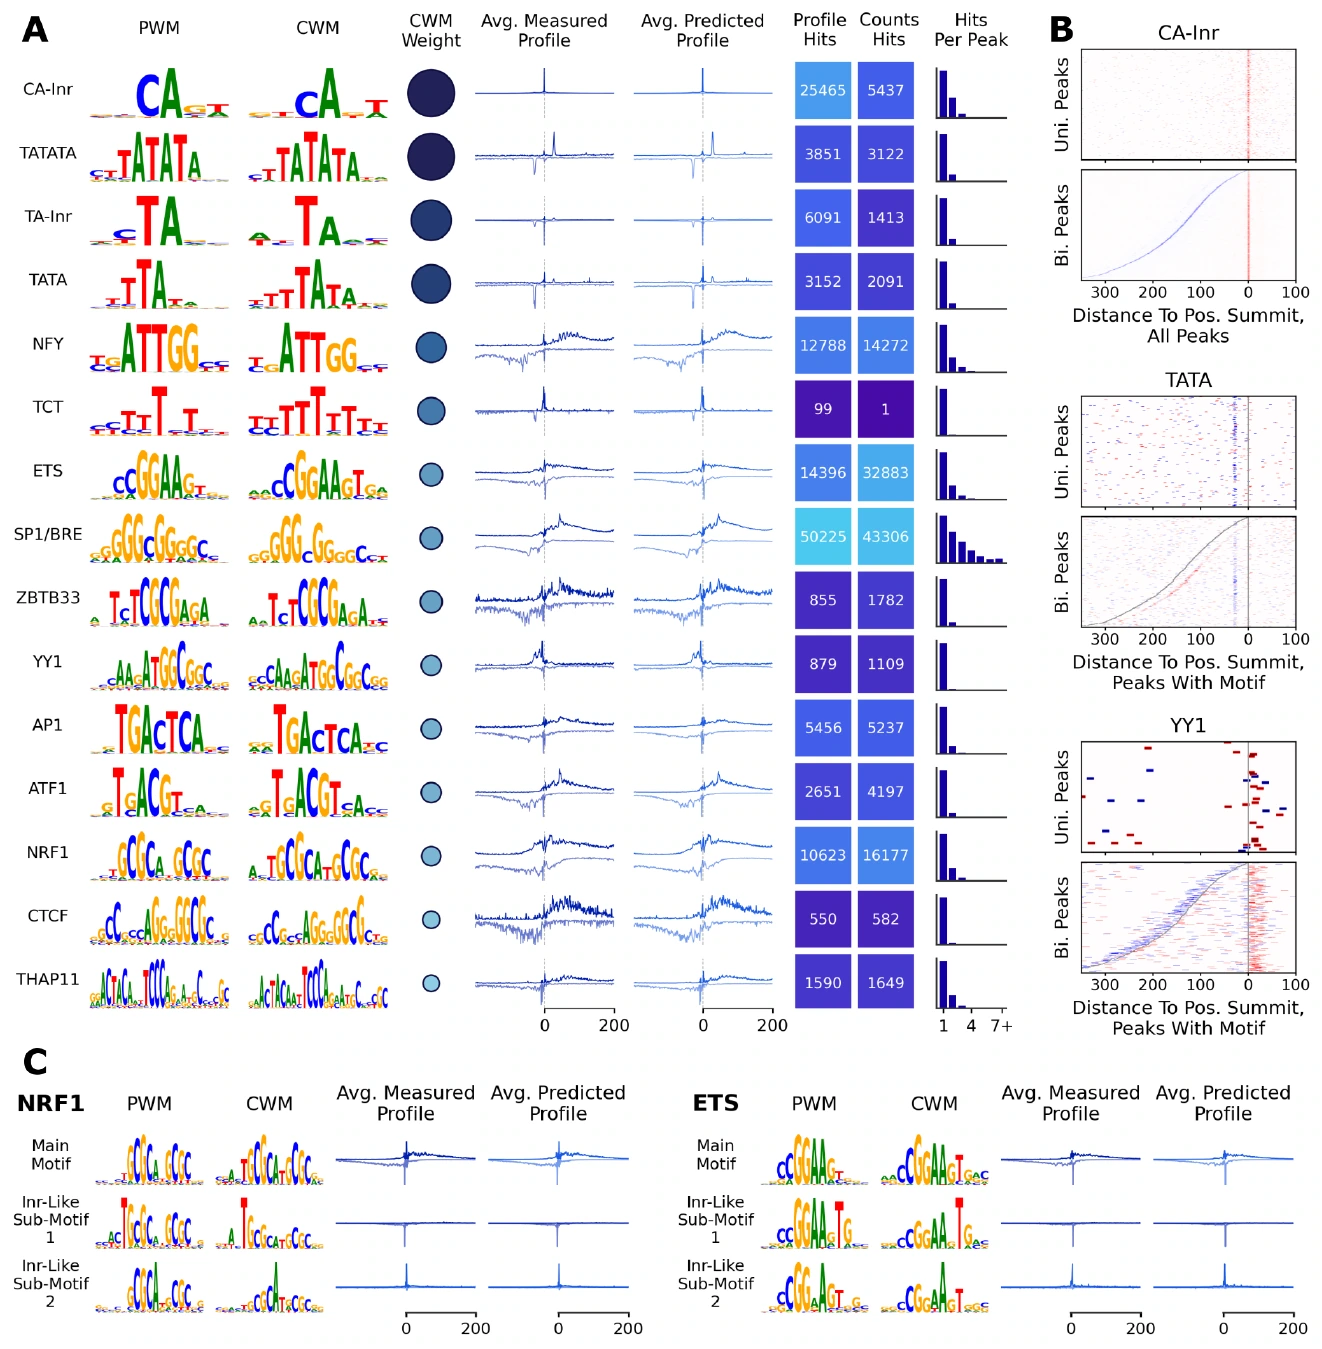
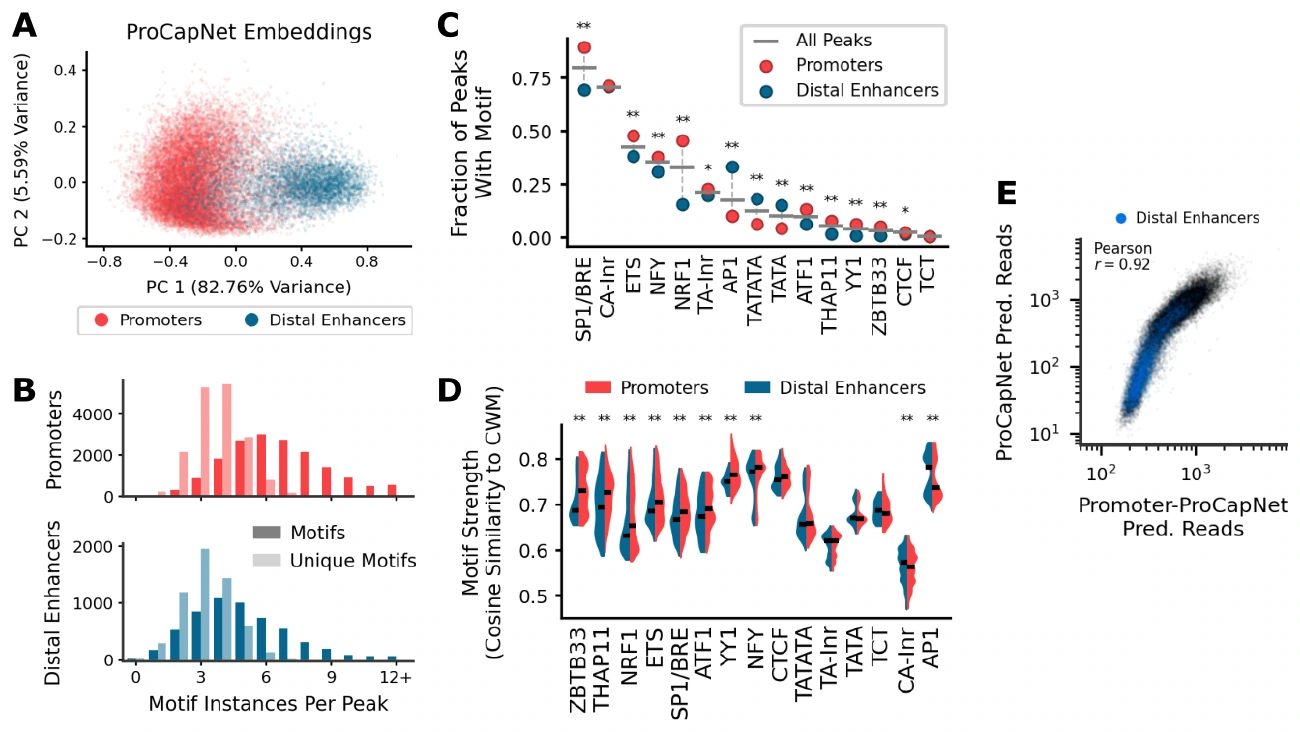
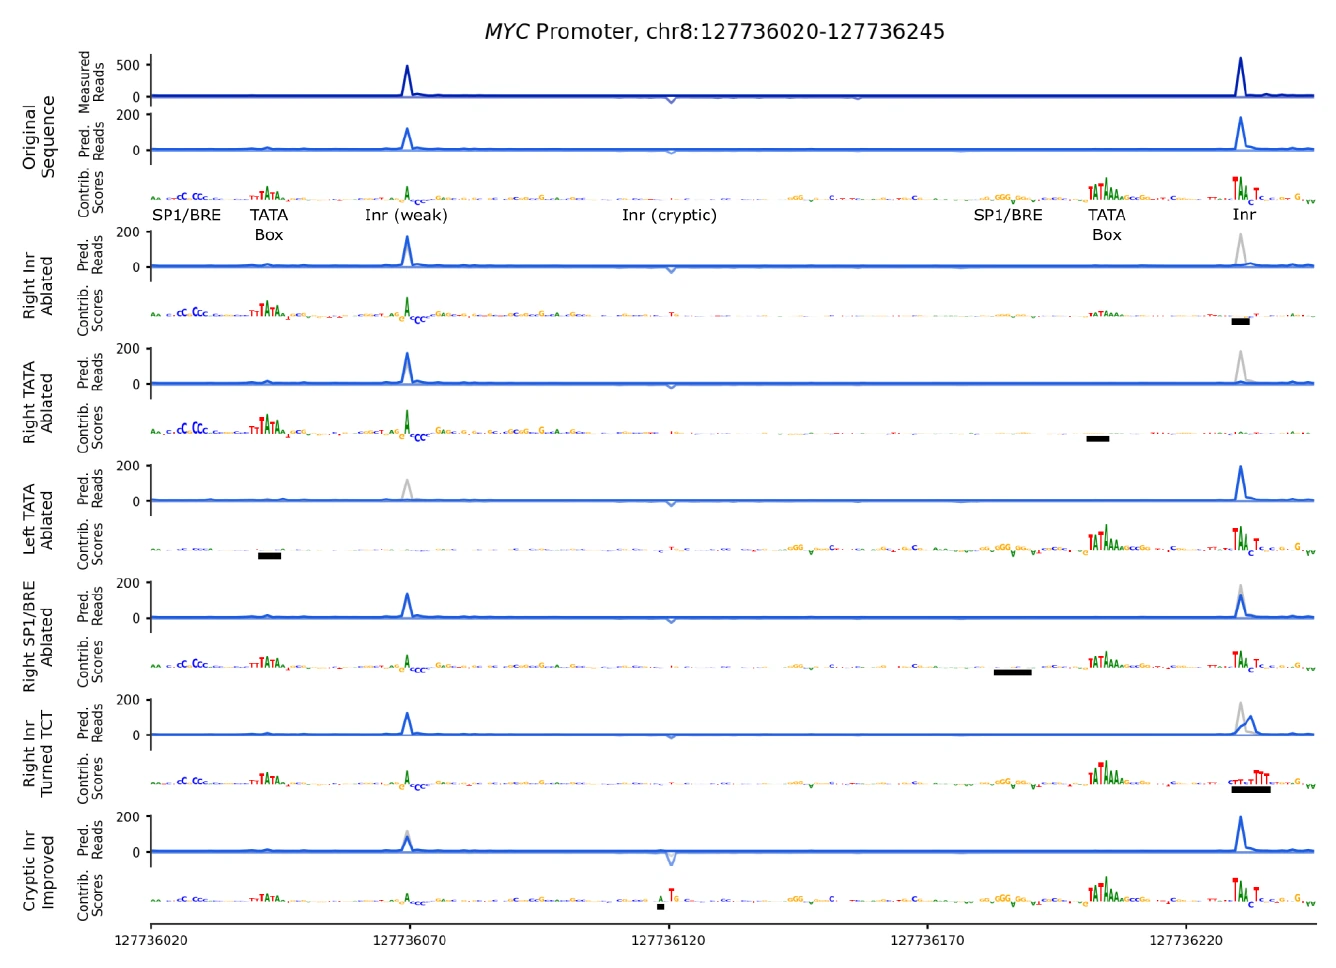
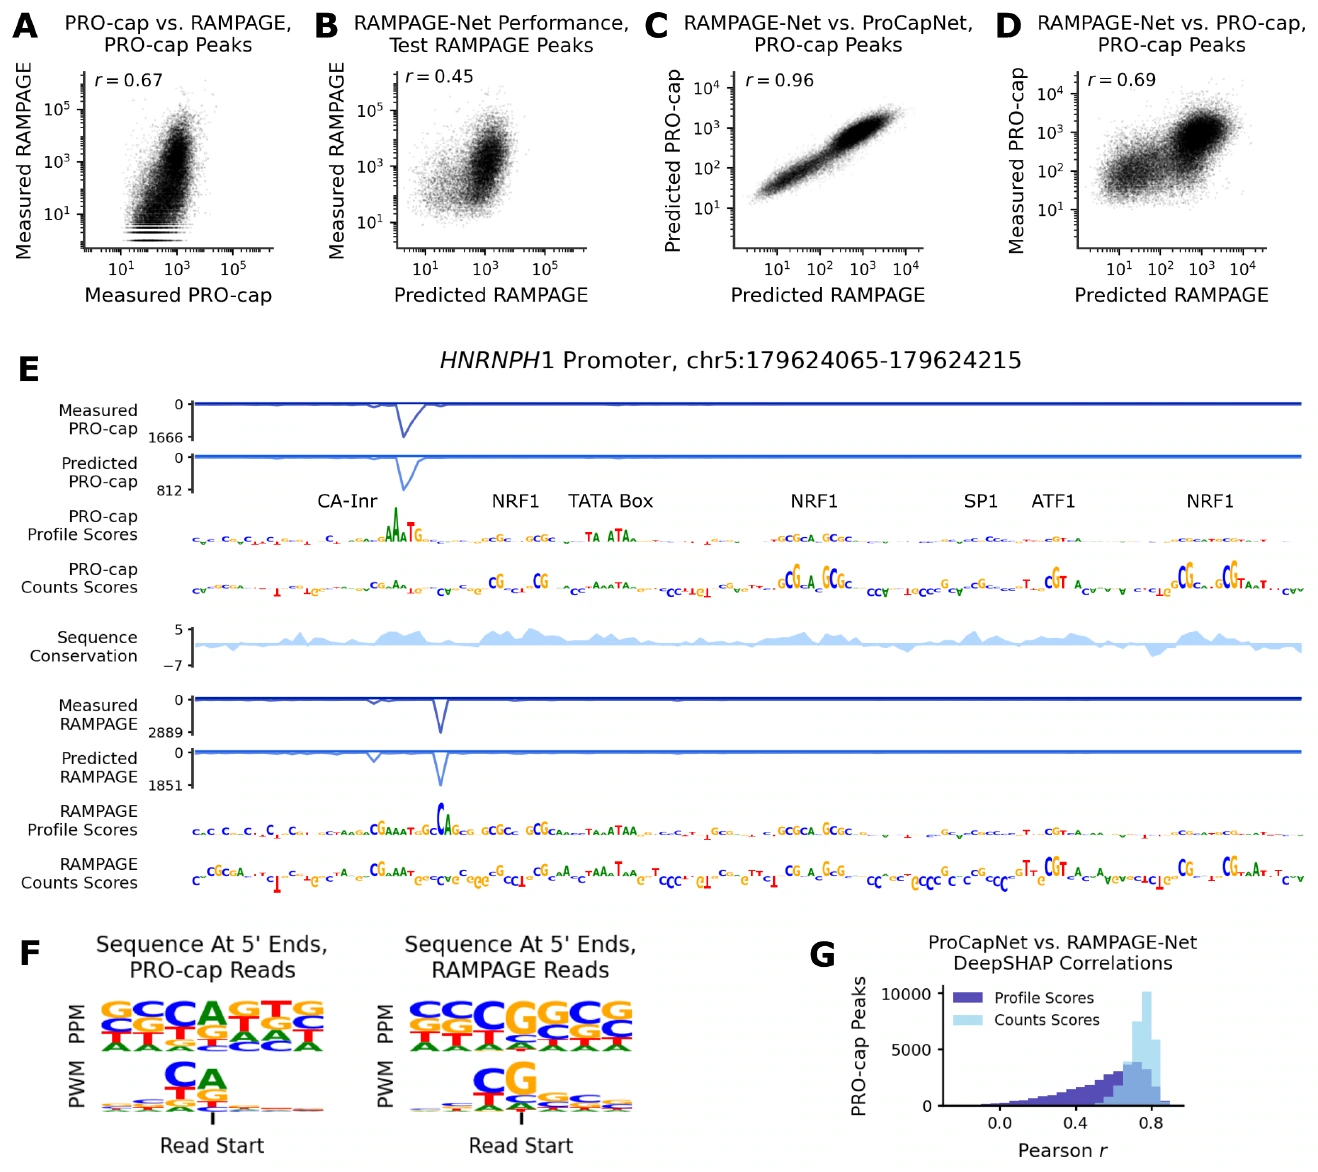
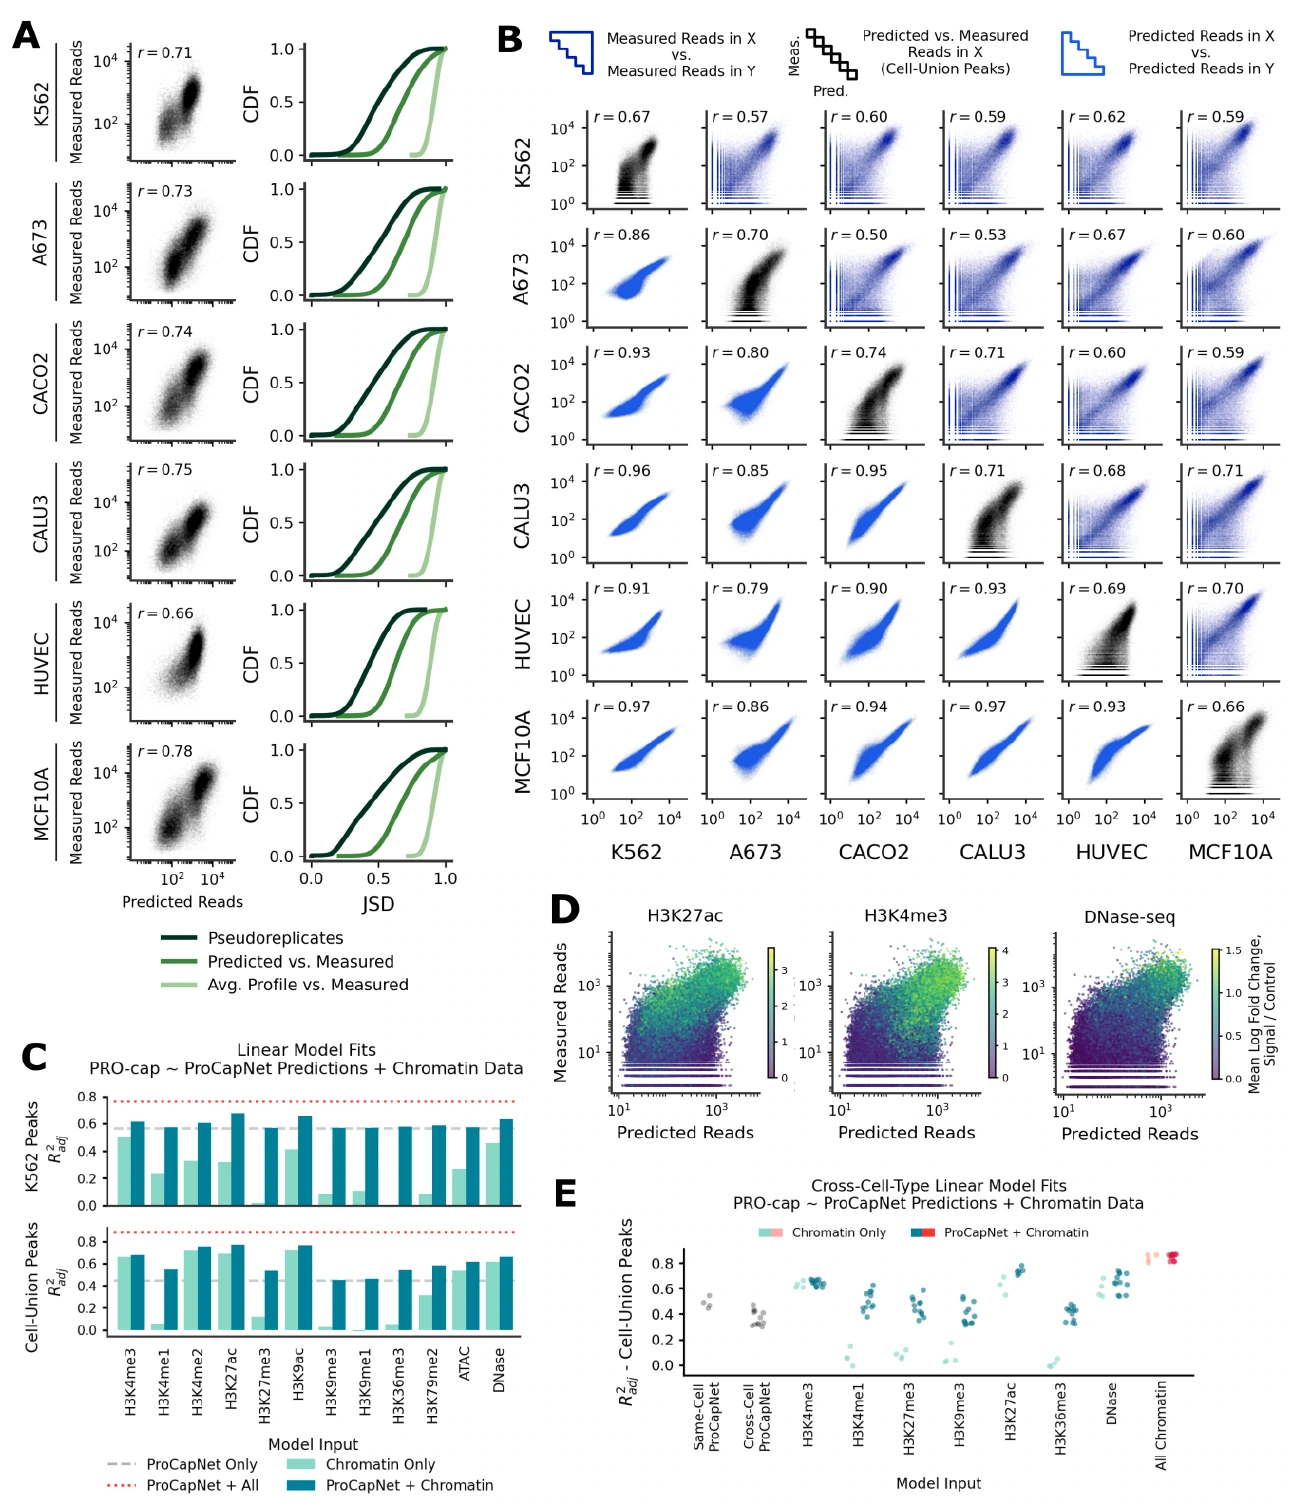
    <content type="html"><![CDATA[<!-- dl-literature-import:092 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Dissecting the cis-regulatory syntax of transcription initiation with deep learning</p><p><strong>期刊与年份：</strong> bioRxiv，2024。<a href="https://doi.org/10.1101/2024.05.28.596138">论文原文</a>。</p><p><strong>阅读版本：</strong> bioRxiv, 2024-11-21。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>研究问题：</strong> DNA 序列如何决定转录启动的强度与起始位点，并通过 motif 排列、竞争及染色质状态产生不同细胞中的启动模式？</p><h2 id="用更接近过程的读数，拆开表达的混合原因"><a href="#用更接近过程的读数，拆开表达的混合原因" class="headerlink" title="用更接近过程的读数，拆开表达的混合原因"></a>用更接近过程的读数，拆开表达的混合原因</h2><p>我对研究思路形成的推测是：直接预测稳态RNA虽然实用，却把转录启动、暂停、剪接和降解混在同一目标里，难以确认某个motif影响哪一步。作者选择PRO-cap这一新生RNA起点测量，把问题缩小为局部DNA怎样决定启动强度和起始位置。这是监督的序列到分子读数模型，疾病关联是后续应用方向，正文主图没有直接证明AD机制。</p><p>ProCapNet用2,114 bp DNA预测中央1 kb两条链的逐碱基概率及合计log计数。BPNet式八层扩张卷积、512通道提供非线性局部上下文；多项分布损失负责起点与方向，计数均方误差负责总量。两链共用一次softmax，使模型不仅选择链内位置，还能预测正负链间读段比例。窗口比输出宽避免边缘零填充伪特征。</p><p>训练使用PRO-cap峰和开放但缺乏启动的DNase背景，按染色体七折划分。这种负例针对性地要求模型区分开放与启动，而不是只学哪些区域开放。低可比对碱基在训练形状损失中屏蔽，评估却仍纳入；这对重复序列是实质边界。作者没有用本文疾病标签训练，也没有将后面的启动子&#x2F;增强子标签作为网络分类目标。</p><h2 id="Figure-1：以碱基分辨率预测转录起始"><a href="#Figure-1：以碱基分辨率预测转录起始" class="headerlink" title="Figure 1：以碱基分辨率预测转录起始"></a>Figure 1：以碱基分辨率预测转录起始</h2><p><a href="/img/dl-literature/092/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/092/figure-01.webp" alt="Figure 1" width="1300" height="1343" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 1。点击图片可查看原图。</em></p><p>A把强度与位置分别定义，B用启动子和附近增强子说明同一架构能处理两类元件，C&#x2F;D在未见染色体量化，而E检验成绩是否仅由某类强信号位点带动。实验重复提供可达到程度的参照，平均轨迹是较弱基线；模型与重复间仍有差距，局部序列不包含远端和细胞状态的全部信息。覆盖越低，测量分布越随机，E的逐例JSD归一化正是为降低这种混杂。归一化后不能将不同定义的JSD数值直接拼到其他论文排行榜。</p><table><thead><tr><th>子图</th><th>讲解</th></tr></thead><tbody><tr><td>A</td><td>ProCapNet 输入局部 DNA 序列，同时预测 PRO-cap 的总起始计数与逐碱基正&#x2F;负链分布；前者回答启动多强，后者回答在哪里、向哪个方向启动。</td></tr><tr><td>B</td><td>两个位点的实测 PRO-cap、预测轨迹及两项任务的序列贡献分数对照；预测能追踪峰的位置，贡献分数指向 Inr、TATA 和转录因子等候选序列元件。</td></tr><tr><td>C</td><td>七折留出染色体测试中总计数预测与实测的相关性，评估训练未见位点的起始强度泛化。</td></tr><tr><td>D</td><td>逐碱基分布预测的 JSD 累积分布，并与相关对照比较；JSD 越小越好，不能按相关系数“越大越好”的方向阅读。</td></tr><tr><td>E</td><td>按 ENCODE 调控元件类别分层的归一化 JSD，比较不同启动子&#x2F;增强子等位点的分布预测；归一化用于减少覆盖深度混杂，多数类别保持一定预测能力。</td></tr></tbody></table><h2 id="Figure-2：预测贡献识别启动-motif-及其定位规律"><a href="#Figure-2：预测贡献识别启动-motif-及其定位规律" class="headerlink" title="Figure 2：预测贡献识别启动 motif 及其定位规律"></a>Figure 2：预测贡献识别启动 motif 及其定位规律</h2><p><a href="/img/dl-literature/092/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/092/figure-02.webp" alt="Figure 2" width="1322" height="1349" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 6 页，Figure 2。点击图片可查看原图。</em></p><p>A的PWM、CWM、贡献幅度与起始轨迹分别回答序列长什么样、模型使用哪些碱基、贡献有多大、起点在哪里，不能只看等高的logo判断motif重要性。B按方向对齐后显示TATA约在起点上游、Inr更贴起点，C再揭示NRF1和ETS内部可能含隐蔽Inr。这说明同一TF样序列在不同上下文可承担不同功能。motif实例要求序列与归因双重匹配，过滤许多仅有序列相似的命中；高覆盖注释仍是模型支持，不是逐个位点已完成真实扰动。正文还发现与TE重叠的长模式中，较短子片段贡献突出，为重复副本功能分化提供候选线索。</p><table><thead><tr><th>子图</th><th>讲解</th></tr></thead><tbody><tr><td>A</td><td>TF-MODISCO 从高贡献片段提取重复 motif，综合展示 PWM、贡献加权 CWM、贡献幅度、平均起始轨迹及出现频率。序列匹配与实际模型贡献需要分开，模型在绝大多数活跃位点找到可预测 motif。</td></tr><tr><td>B</td><td>把各 motif 实例相对 PRO-cap 峰顶的位置按方向排列；TATA 与起始位点有偏移，Inr 更直接贴近起点，不同元件具有不同方向&#x2F;定位关系。</td></tr><tr><td>C</td><td>NRF1 与 ETS 的子模式中出现 Inr 样序列贡献，提示一个转录因子 motif 可同时包含影响起始定位的局部信息。</td></tr></tbody></table><h2 id="Figure-3：启动子和增强子的共同词汇与复杂度差异"><a href="#Figure-3：启动子和增强子的共同词汇与复杂度差异" class="headerlink" title="Figure 3：启动子和增强子的共同词汇与复杂度差异"></a>Figure 3：启动子和增强子的共同词汇与复杂度差异</h2><p><a href="/img/dl-literature/092/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/092/figure-03.webp" alt="Figure 3" width="1300" height="732" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 8 页，Figure 3。点击图片可查看原图。</em></p><p>A用监督模型学到的表示做PCA，再叠加元件标签；它没有直接用这些标签训练，却不能因此把整个ProCapNet称无监督模型。B&#x2F;C&#x2F;D从密度、种类和匹配强度解释分离，E用仅启动子训练再预测增强子检验共享语法的迁移。启动子与增强子可以共享词汇又有组成差别，并不矛盾。CWM余弦相似是作者采用的亲和力代理，不是实验结合常数。增强子端出现计数校准偏差，还说明预测排序一致与绝对强度可迁移是不同标准。</p><table><thead><tr><th>子图</th><th>讲解</th></tr></thead><tbody><tr><td>A</td><td>模型内部表示的 PCA 将启动子与远端增强子分开；说明网络即使没有直接训练这类标签，也学到了可区分两者的序列模式。</td></tr><tr><td>B</td><td>比较预测相关 motif 实例数，启动子总体比远端增强子含有更多起始相关元件。</td></tr><tr><td>C</td><td>比较各 motif 至少出现一次的比例；启动子偏富集 SP1&#x2F;BRE、ETS、NFY 等，增强子偏富集 AP1、TATA，显示共享词汇中的组成偏好。</td></tr><tr><td>D</td><td>比较 motif 实例与 CWM 的匹配强度，启动子通常更强；此为序列&#x2F;贡献匹配代理，不能当作直接实验测得的结合亲和力。</td></tr><tr><td>E</td><td>只用启动子训练的模型与全位点训练模型在留出位点的计数预测比较；两者高度一致，增强子区间有校准偏差，支持启动子学到的起始逻辑能够一定程度迁移到增强子。</td></tr></tbody></table><h2 id="Figure-4：MYC-启动子中逐元件虚拟修改与起点竞争"><a href="#Figure-4：MYC-启动子中逐元件虚拟修改与起点竞争" class="headerlink" title="Figure 4：MYC 启动子中逐元件虚拟修改与起点竞争"></a>Figure 4：MYC 启动子中逐元件虚拟修改与起点竞争</h2><p><a href="/img/dl-literature/092/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/092/figure-04.webp" alt="Figure 4" width="1336" height="968" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 10 页，Figure 4。点击图片可查看原图。</em></p><p>MYC实例把同一背景中的右Inr、左右TATA、SP1&#x2F;BRE、TCT替换和隐蔽反向Inr分别修改，统一纵轴避免缩放制造视觉效果。右起点被破坏时左起点预测增加，反向起点增强又压低左起点，提示非对称竞争。真正值得注意的是重算归因后邻近元件贡献也改变，模型表示的作用依赖其他元件。所有修改都是计算模拟，选择的替换序列还可能引入未识别新模式；因此应以多种替换和实测突变检验稳健性，不能仅凭单例宣称发现真实PIC竞争机制。</p><table><thead><tr><th>子图</th><th>讲解</th></tr></thead><tbody><tr><td>原始序列（无字母）</td><td>同一 MYC 启动子展示实测、模型预测和贡献轨迹，标出两个正向起点及隐蔽反向起点，作为所有序列修改的基线；纵轴尺度保持一致。</td></tr><tr><td>Right Inr Ablated</td><td>破坏下游右侧 Inr 后该起点预测信号下降，左侧起点增强；提示起始信号会在邻近位点间重新分配。</td></tr><tr><td>Right TATA Ablated</td><td>破坏右侧 TATA 也削弱下游起点并增强上游起点，与右侧 Inr 的计算破坏一起支持两起点竞争的模型解释。</td></tr><tr><td>Left TATA Ablated</td><td>破坏左侧 TATA 降低上游起点，但下游起点没有对称的同等变化；起点之间的影响具有方向不对称性。</td></tr><tr><td>Right SP1&#x2F;BRE Ablated</td><td>破坏右侧 SP1&#x2F;BRE 使右侧预测起始强度降低，显示除核心起始元件外，邻近转录因子相关元件也影响该位点活性。</td></tr><tr><td>Right Inr Turned TCT</td><td>把右侧 Inr 改为 TCT 模式，预测信号的位置&#x2F;强度随之改变；直接检验核心起始序列类型变化的影响。</td></tr><tr><td>Cryptic Inr Improved</td><td>增强隐蔽反向 Inr 后反向起始信号增加，上游正向起点减弱而下游正向起点基本不变；进一步展示邻近起点之间的竞争和重分配。</td></tr></tbody></table><h2 id="Figure-5：系统性-motif-破坏区分起始强度与位置作用"><a href="#Figure-5：系统性-motif-破坏区分起始强度与位置作用" class="headerlink" title="Figure 5：系统性 motif 破坏区分起始强度与位置作用"></a>Figure 5：系统性 motif 破坏区分起始强度与位置作用</h2><p><a href="/img/dl-literature/092/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/092/figure-05.webp" alt="Figure 5" width="1318" height="1389" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 11 页，Figure 5。点击图片可查看原图。</em></p><p>A&#x2F;B将单例扩展为全体motif实例，并用重复随机替换降低某个替换序列的偶然影响。C上方是含motif位点实测量，下方是破坏后的预测效应，两者排名不同，说明观察富集容易被启动子或增强子组成混杂。D比较归一化起点概率，某个位置丢失后概率必然分配到其他位置；这在数学上并不自动代表其他位置的绝对起始量增加，还需结合计数头。Inr&#x2F;TATA可能显著改变局部起点而对全窗口总量影响较小，表明只用gene-level RNA会漏掉调控形式变化。</p><table><thead><tr><th>子图</th><th>讲解</th></tr></thead><tbody><tr><td>A</td><td>在各位点逐个破坏 motif 实例，重复估计预测变化的计算实验流程；将单一 MYC 示例推广到全体 PRO-cap 峰。</td></tr><tr><td>B</td><td>代表性位点的破坏前后预测轨迹：Inr、YY1、CTCF 等元件造成的变化位置和重新分配模式不同，说明只看总信号会遗漏局部效应。</td></tr><tr><td>C</td><td>上方展示含有各 motif 位点的实测信号分布，下方展示破坏 motif 后预测总计数的倍数改变；二者区分观察关联与模型反事实效应。Inr&#x2F;TATA 等的局部起点效应可以很强，但总起始量中位数变化不一定大。</td></tr><tr><td>D</td><td>对所有 motif 实例汇总破坏前后的逐位置分布变化；定位 motif 更集中影响局部起点，部分激活因子对更广区域信号有影响。</td></tr></tbody></table><h2 id="Figure-6：稳态转录数据训练的模型学到了什么"><a href="#Figure-6：稳态转录数据训练的模型学到了什么" class="headerlink" title="Figure 6：稳态转录数据训练的模型学到了什么"></a>Figure 6：稳态转录数据训练的模型学到了什么</h2><p><a href="/img/dl-literature/092/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/092/figure-06.webp" alt="Figure 6" width="1318" height="1172" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 13 页，Figure 6。点击图片可查看原图。</em></p><p>A先展示PRO-cap与RAMPAGE测量有关但不相同，B–D再显示局部序列模型对二者作出比原始数据更相近的预测。E&#x2F;F&#x2F;G检验这种一致来自何处，同时暴露起点测量偏好不同；RAMPAGE的帽子与模板切换流程可能造成G起点偏好。作者据此推测局部模型主要提取启动成分，这是一种模型和测量共同支持的解释，不能称已经精确分离每条RNA的降解效应。对AD公共数据，可借稳态读数提出启动假说，但模型插补不等于目标脑细胞已经测到新生转录。</p><table><thead><tr><th>子图</th><th>讲解</th></tr></thead><tbody><tr><td>A</td><td>PRO-cap 起始信号与 RAMPAGE 稳态转录信号的实测总量相关；二者有共同信息，但并非同一测量，实际相关约 0.67。</td></tr><tr><td>B</td><td>仅用 RAMPAGE 训练的 RAMPAGE-Net 在留出峰上预测 RAMPAGE 计数的表现；稳态信号较难从局部序列完全解释。</td></tr><tr><td>C</td><td>两种模型在 PRO-cap 峰上的计数预测高度一致，相关约 0.96；暗示 RAMPAGE 模型更容易学到其中由局部序列决定的起始成分。</td></tr><tr><td>D</td><td>RAMPAGE-Net 预测与真实 PRO-cap 信号比较，仍有较高相关，支持其序列可解释成分与起始活动相联系。</td></tr><tr><td>E</td><td>一个启动子的两种实测信号、模型预测、贡献分数和保守性轨迹；模型解释比两种原始信号更相似，可定位共同的起始序列元件。</td></tr><tr><td>F</td><td>对 PRO-cap 和 RAMPAGE 检出的读段 5′ 端序列汇总 PPM&#x2F;PWM；比较两种实验识别起点的序列偏好及差异。</td></tr><tr><td>G</td><td>在所有 PRO-cap 峰的 1 kb 窗口内比较两模型贡献分数相关性，分别评估位置分布和总计数任务；检验共同序列规律是否广泛存在。</td></tr></tbody></table><h2 id="Figure-7：跨细胞起始规律与细胞特异染色质信息"><a href="#Figure-7：跨细胞起始规律与细胞特异染色质信息" class="headerlink" title="Figure 7：跨细胞起始规律与细胞特异染色质信息"></a>Figure 7：跨细胞起始规律与细胞特异染色质信息</h2><p><a href="/img/dl-literature/092/figure-07.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/092/figure-07.webp" alt="Figure 7" width="1294" height="1506" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 15 页，Figure 7。点击图片可查看原图。</em></p><p>A的本细胞测试与B的所有细胞峰并集测试回答不同问题：模型在本细胞活跃峰上很好，却可能在只于别的细胞活跃处仍预测启动。C&#x2F;D用目标细胞的染色质信息检验缺失的状态因素，E把参考细胞模型与目标细胞实测染色质组合。拟合采用留出染色体，并包含二阶交互项，不能只称简单单变量线性校准。染色质补充改善说明局部启动能力和实际细胞活性有区别；组蛋白与启动之间的关联还不能单凭拟合确定因果顺序。使用目标细胞实测状态后，也不能再宣称从DNA零样本获得完整细胞特异性。</p><table><thead><tr><th>子图</th><th>讲解</th></tr></thead><tbody><tr><td>A</td><td>在多个细胞类型分别训练&#x2F;测试模型，比较计数与位置分布表现；局部序列能够在不同细胞中支持起始预测。</td></tr><tr><td>B</td><td>上三角为细胞间实测信号相关，下三角为各细胞模型预测相关，对角线为本细胞预测与实测；模型预测跨细胞更相似，说明大量序列决定的信息相对通用，不能因此声称细胞差异不存在。</td></tr><tr><td>C</td><td>用 ProCapNet 预测加不同染色质测量拟合 K562 PRO-cap；加入组蛋白修饰或开放染色质等信息改善拟合，补充局部序列未解释的细胞背景。</td></tr><tr><td>D</td><td>在实测与预测的联合位点分布中叠加组蛋白&#x2F;DNase 信号；观察模型预测相近却实际活性不同的位点是否可由染色质状态区分。</td></tr><tr><td>E</td><td>用另一细胞模型的序列预测再结合目标细胞的染色质测量拟合目标 PRO-cap；支持通用序列规律与细胞特异染色质信息共同决定起始活性。</td></tr></tbody></table><h2 id="阅读提醒"><a href="#阅读提醒" class="headerlink" title="阅读提醒"></a>阅读提醒</h2><ul><li>来源为用户提供的 2024-11-21 bioRxiv 版本。Figure 4&#x2F;5 的 motif 修改均为计算模拟，显示模型学到的调控关系，需要与真实突变验证区分。</li></ul><h2 id="我会怎样将起点变化转成TE课题"><a href="#我会怎样将起点变化转成TE课题" class="headerlink" title="我会怎样将起点变化转成TE课题"></a>我会怎样将起点变化转成TE课题</h2><p>一个具体方向是检验TE副本附近变异是否主要改变转录起点选择，而不是总RNA量。先在有可信起点读数的公共数据建立基准，将TE副本与同家族、GC和可比对性相近的对照匹配，比较等位替换对正负链分配、起点位置和总量的三种影响，再用独立CAGE&#x2F;PRO-cap或等位数据验证。若脑细胞没有对应读数，只能把细胞系发现作为候选规则，不能直接称AD结果。</p><p>对有限显存，我会先用公开模型提取局部表示或进行等位前向推理，研究清楚一种细胞类型、一类TE家族，再决定训练。创新可落在“哪些副本保留祖先起始语法，哪些副本经变异改写起点，以及病理相关细胞环境是否允许它生效”，但演化年龄、拷贝同源性和可比对性必须分别控制。相似副本随机分到训练测试会造成同源泄漏，跨家族或跨染色体检验应作为独立挑战。</p><p>我的感悟是，模型的可解释性不只来自架构透明，还来自目标读数、负例和验证的设计。ProCapNet保留非线性，Puffin对motif作用加入结构约束，两者代表不同取舍；这里的比较带有作者方法视角，需要在统一细胞、数据和评价目标下判断，不能引用一句评论就宣布一种范式全面失效。对于自己的AD研究，最可迁移的是先找能够区分机制的中间读数，再选择允许该机制被检验的模型。</p>]]></content>
    
    
    <summary type="html">深入读懂ProCapNet：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>91.ChromBPNet：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad92005b/"/>
    <id>https://perry.apay.eu.cc/posts/ad92005b/</id>
    <published>2026-10-04T12:01:31.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
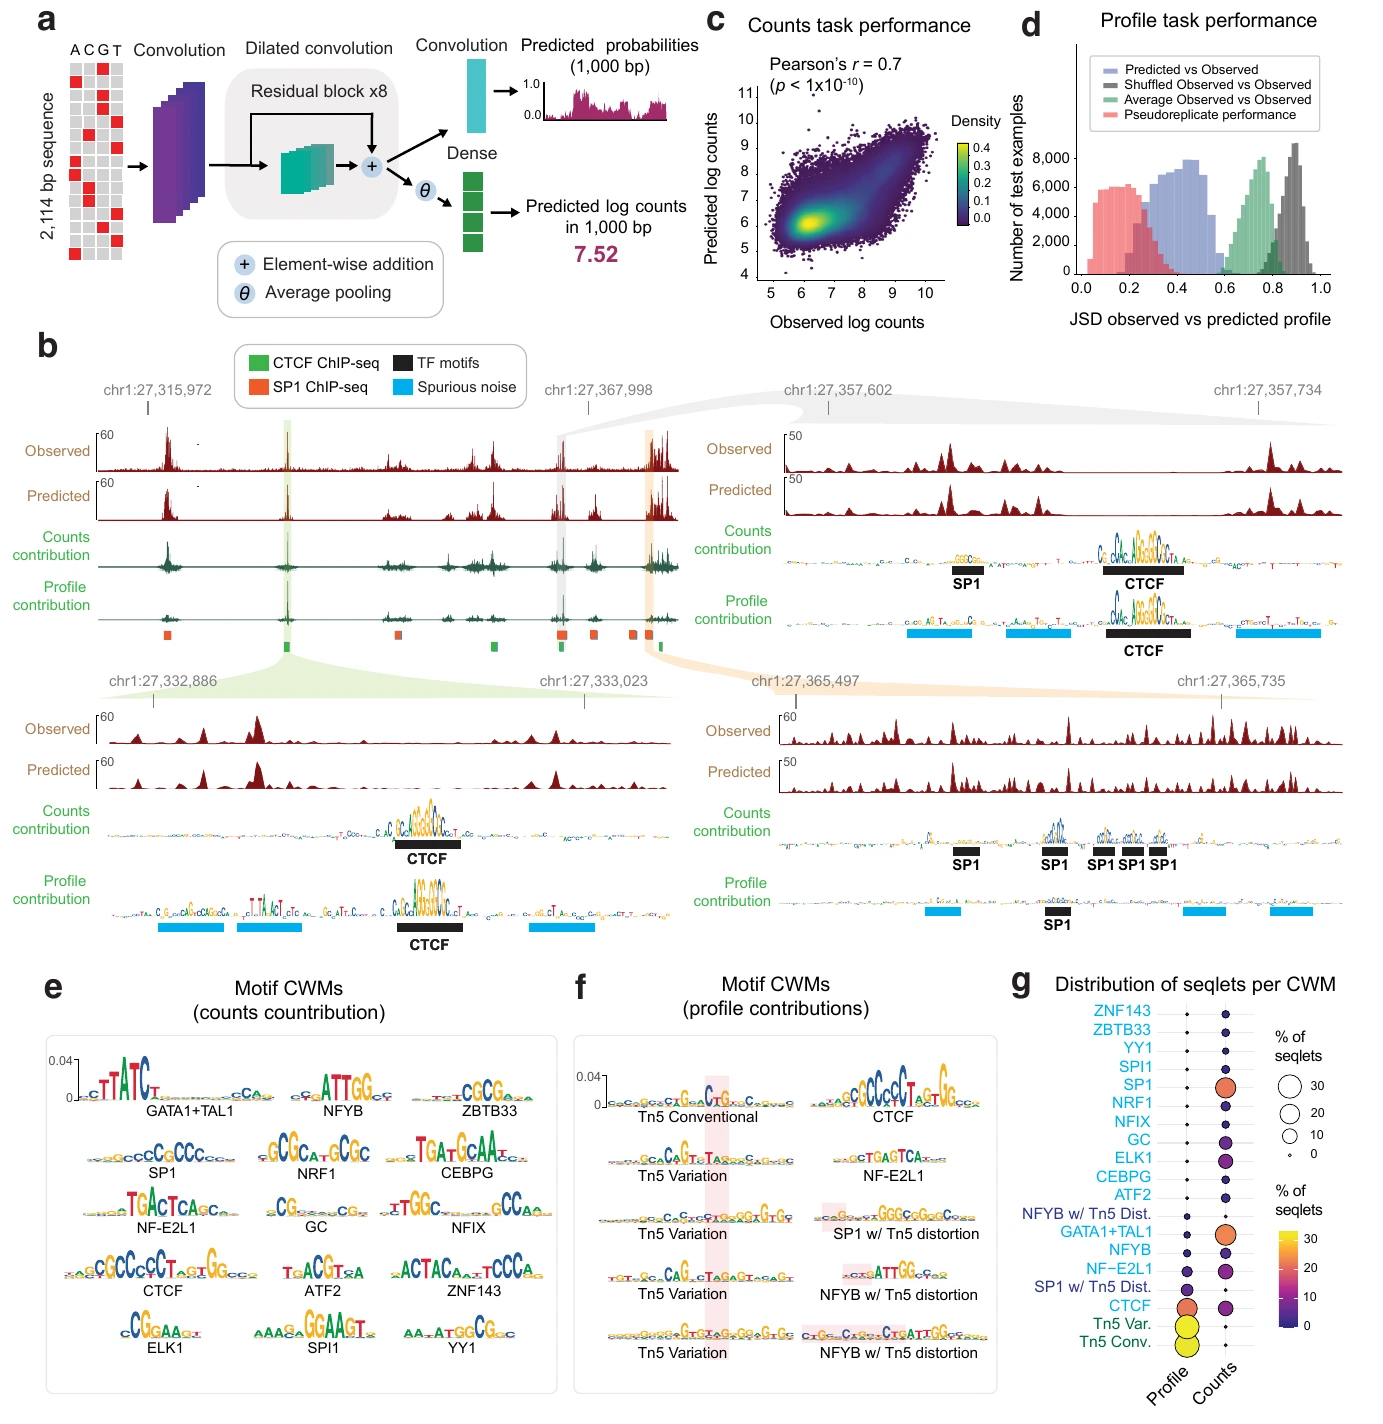
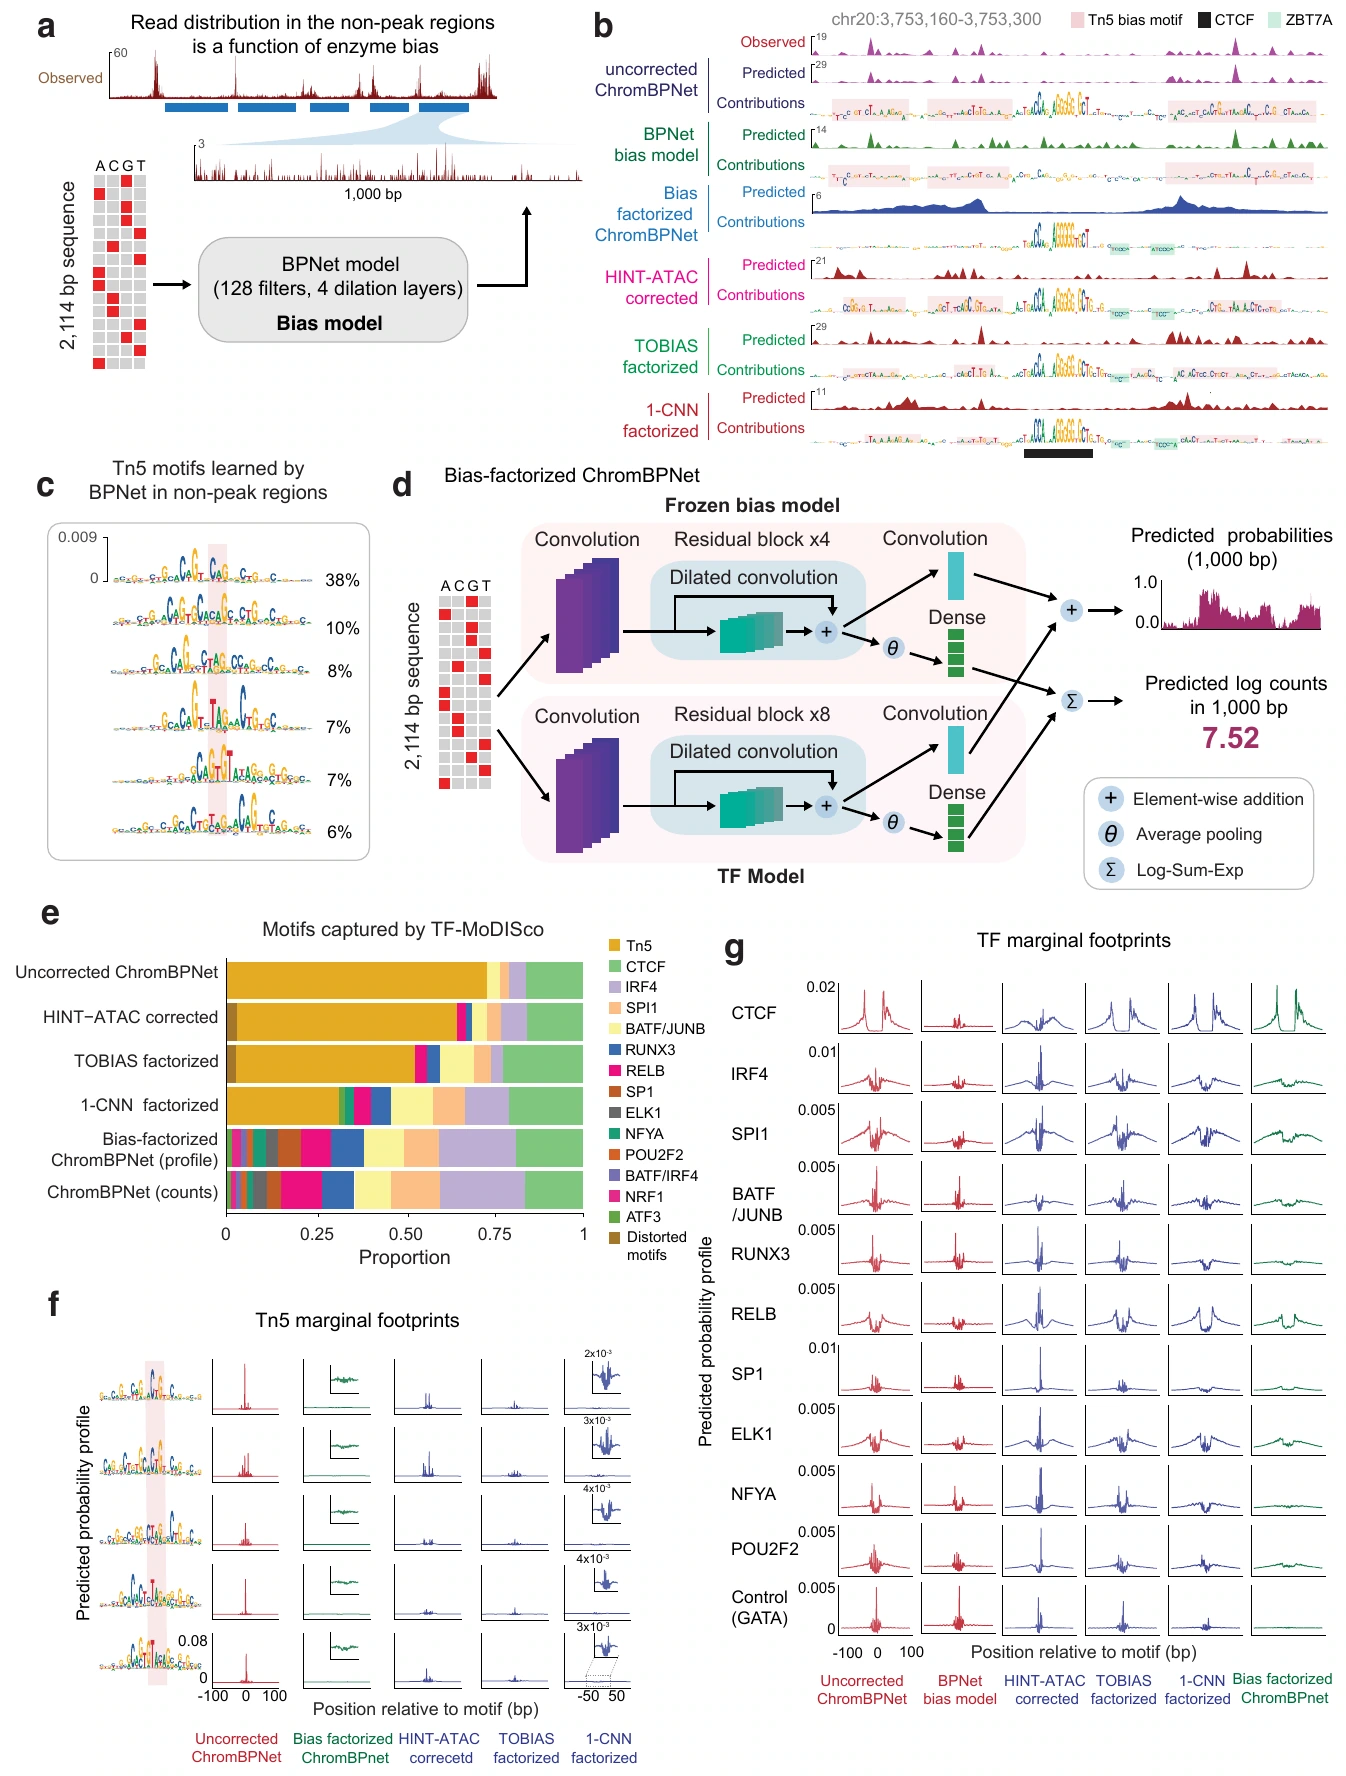
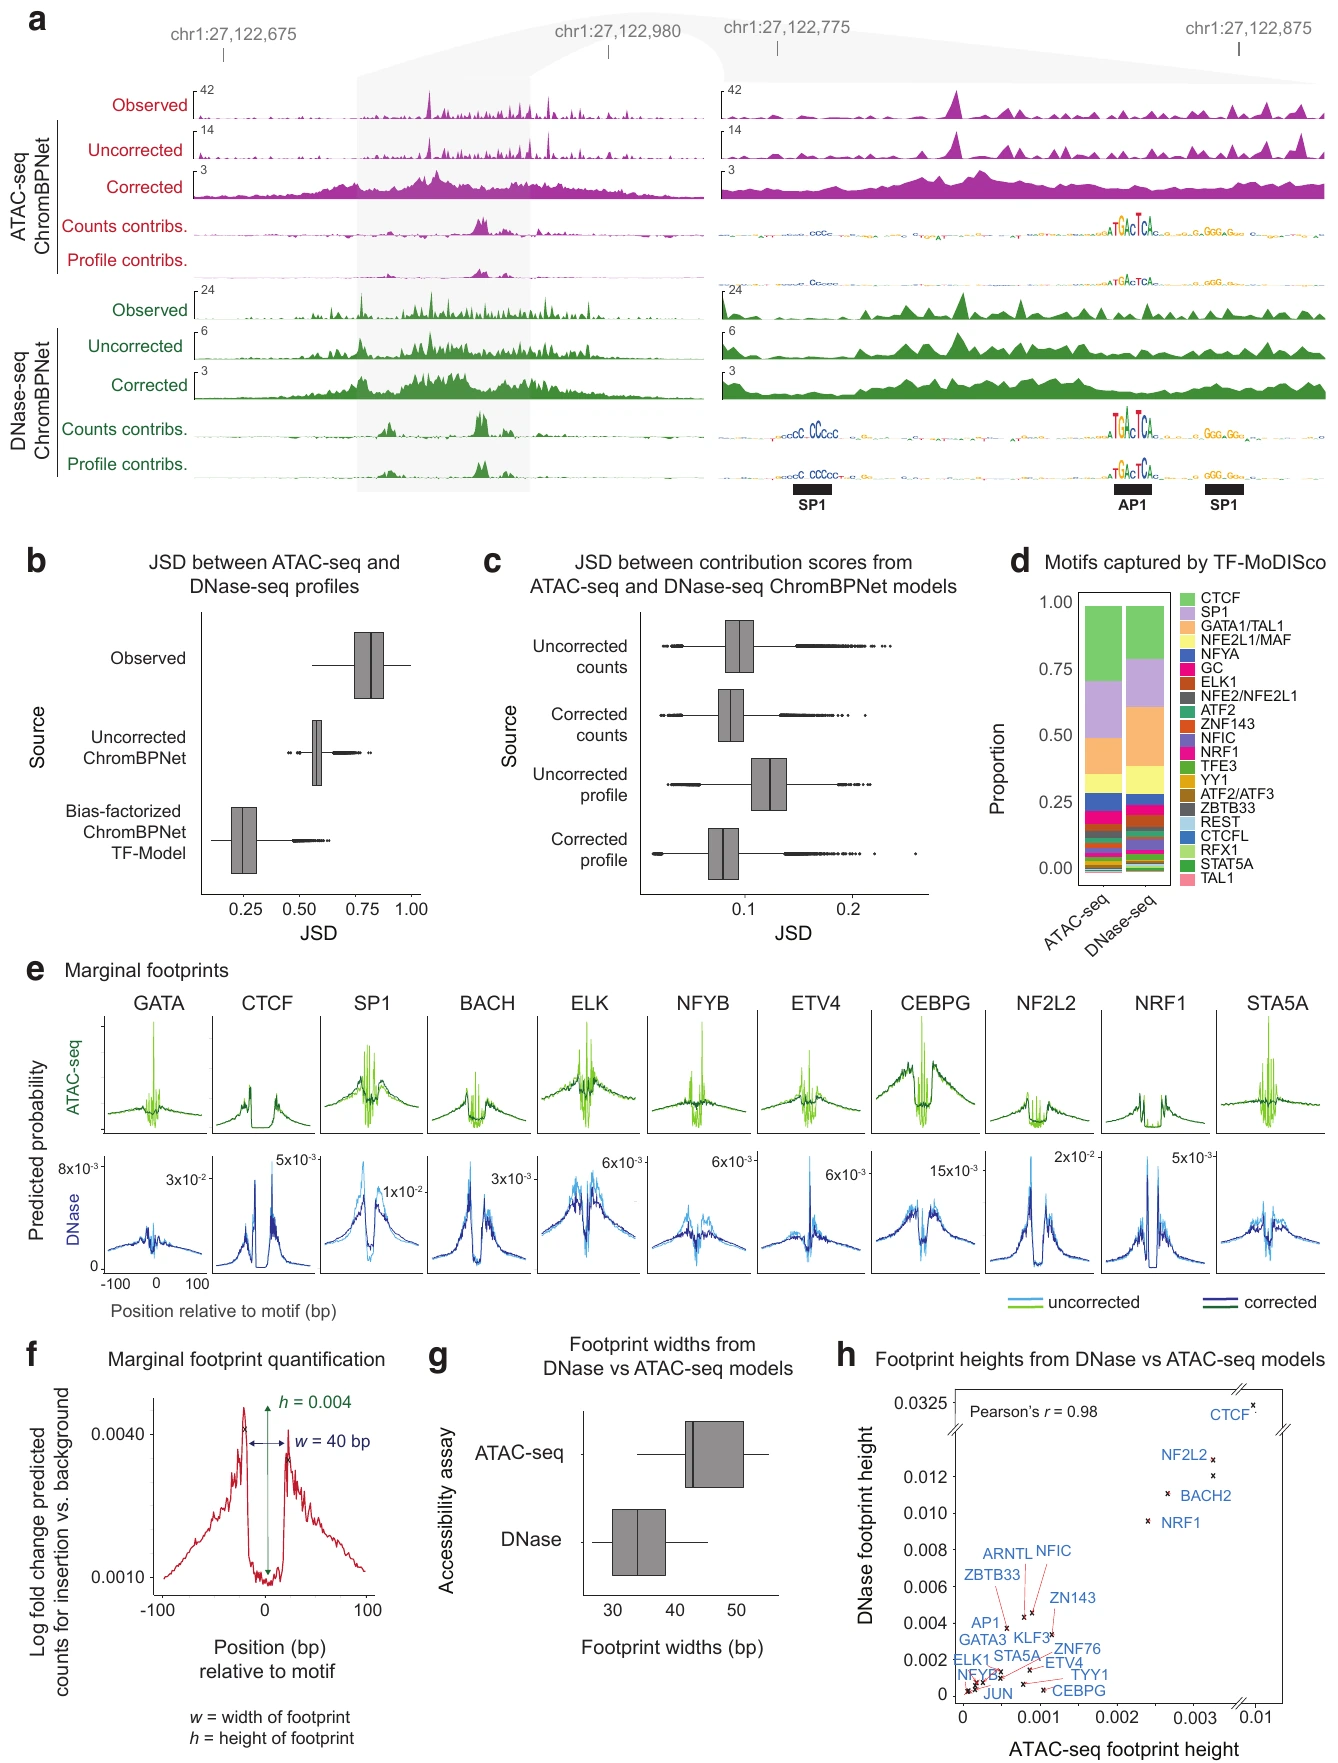
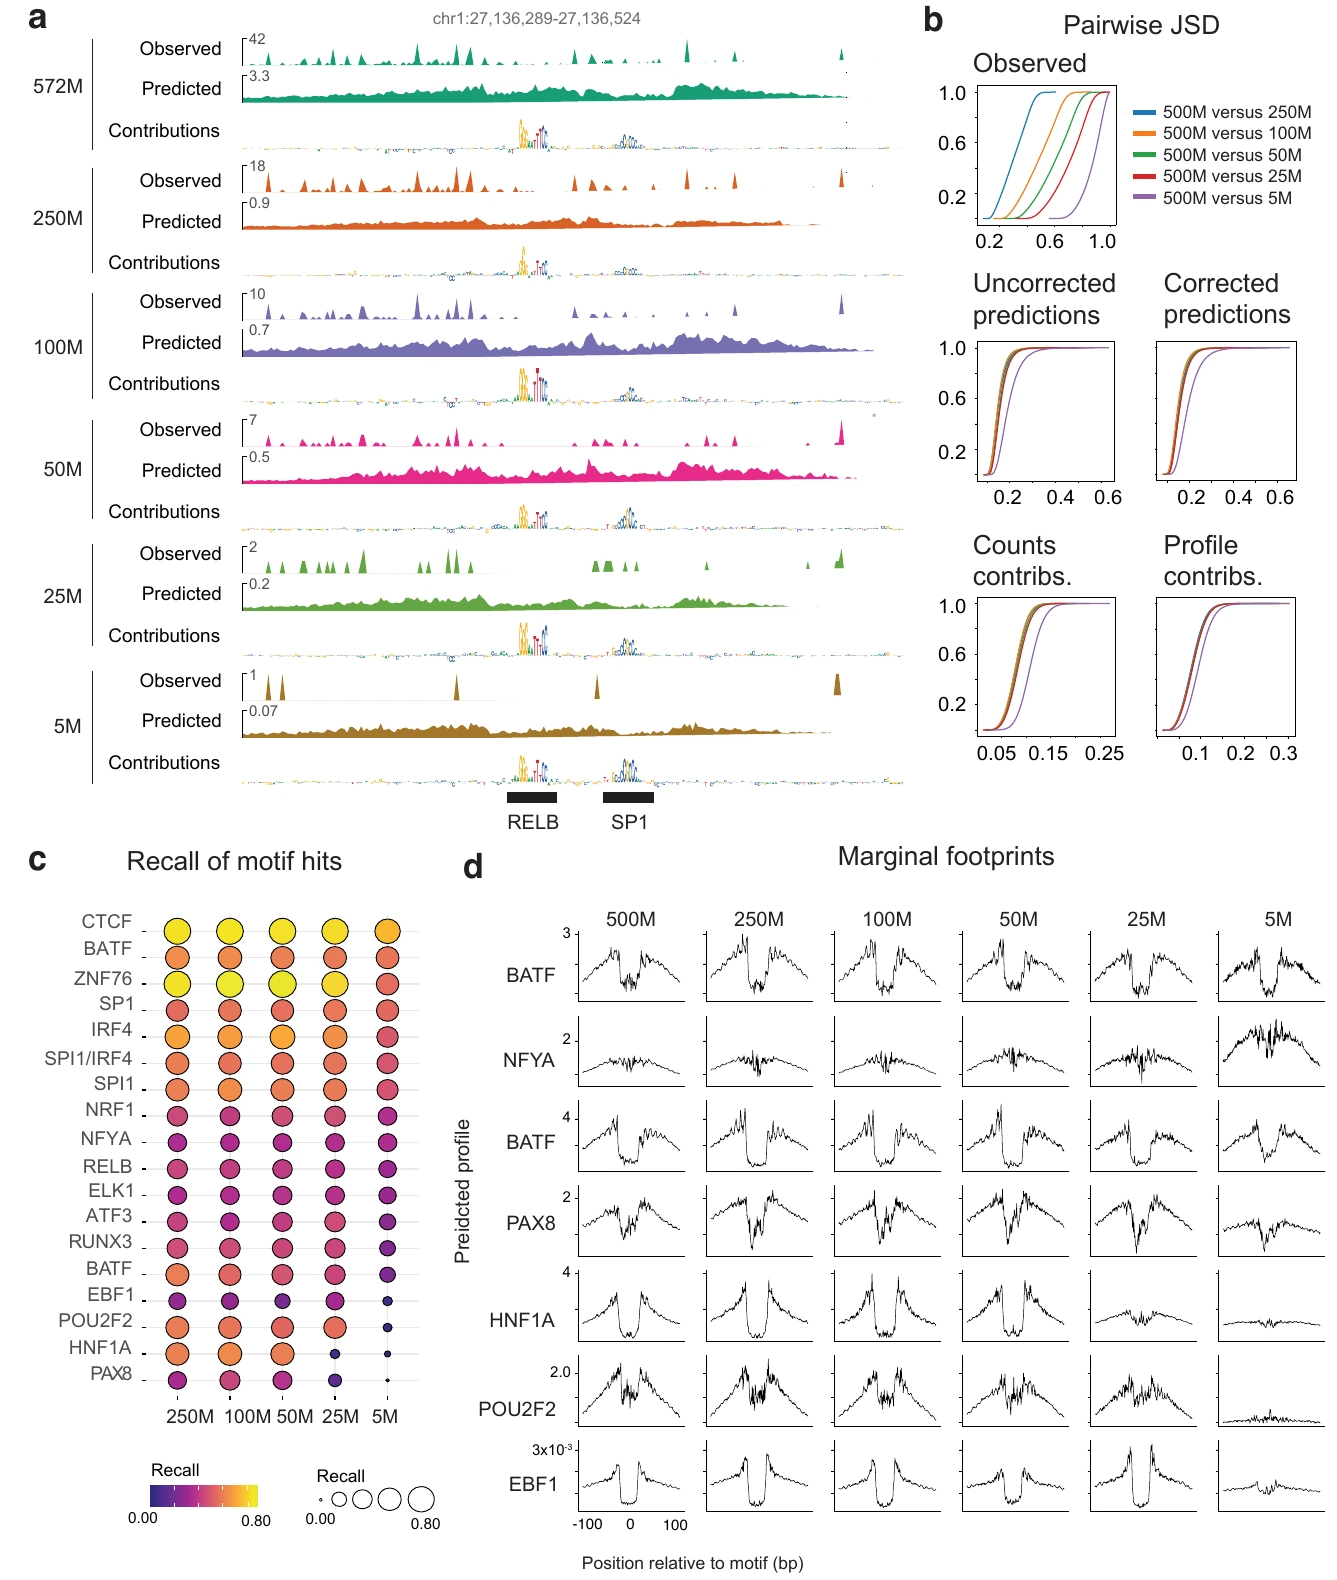
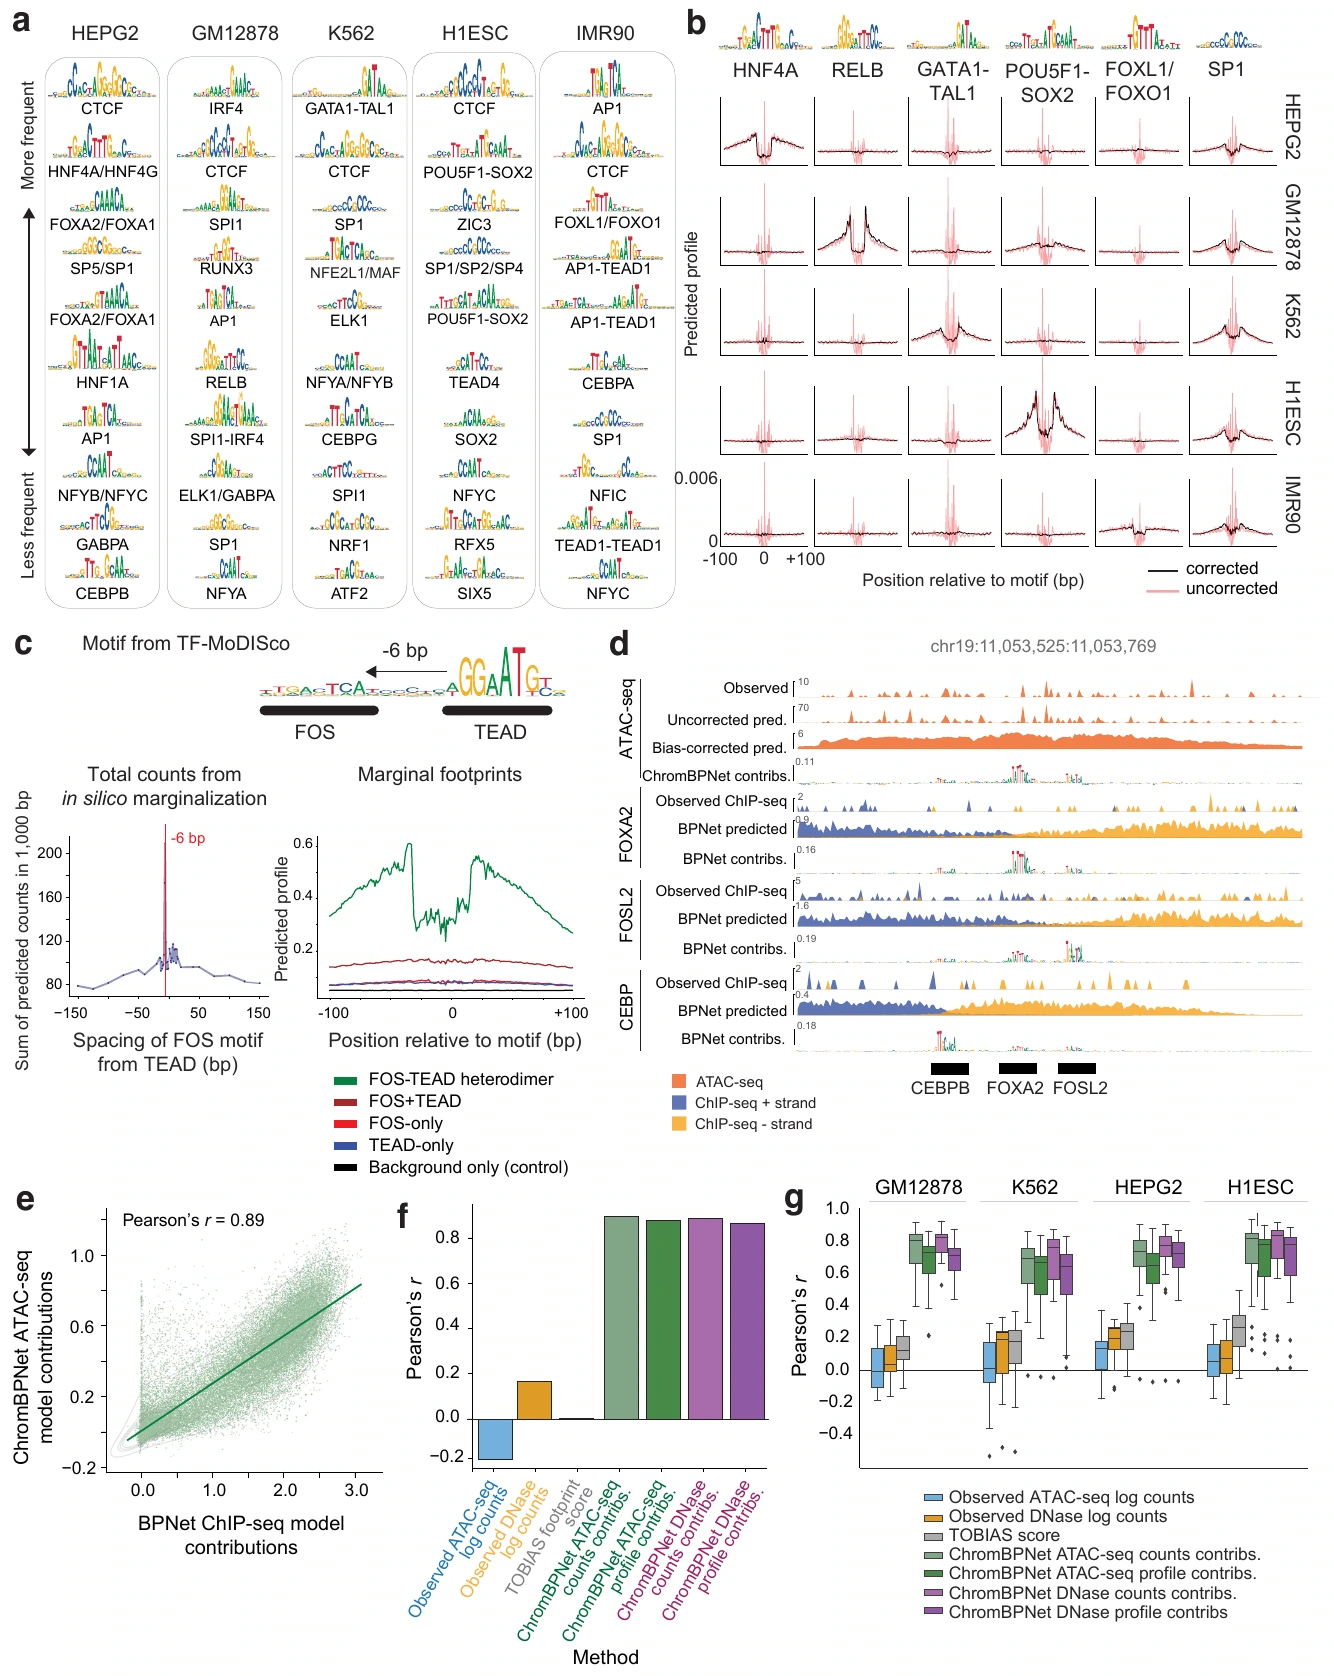
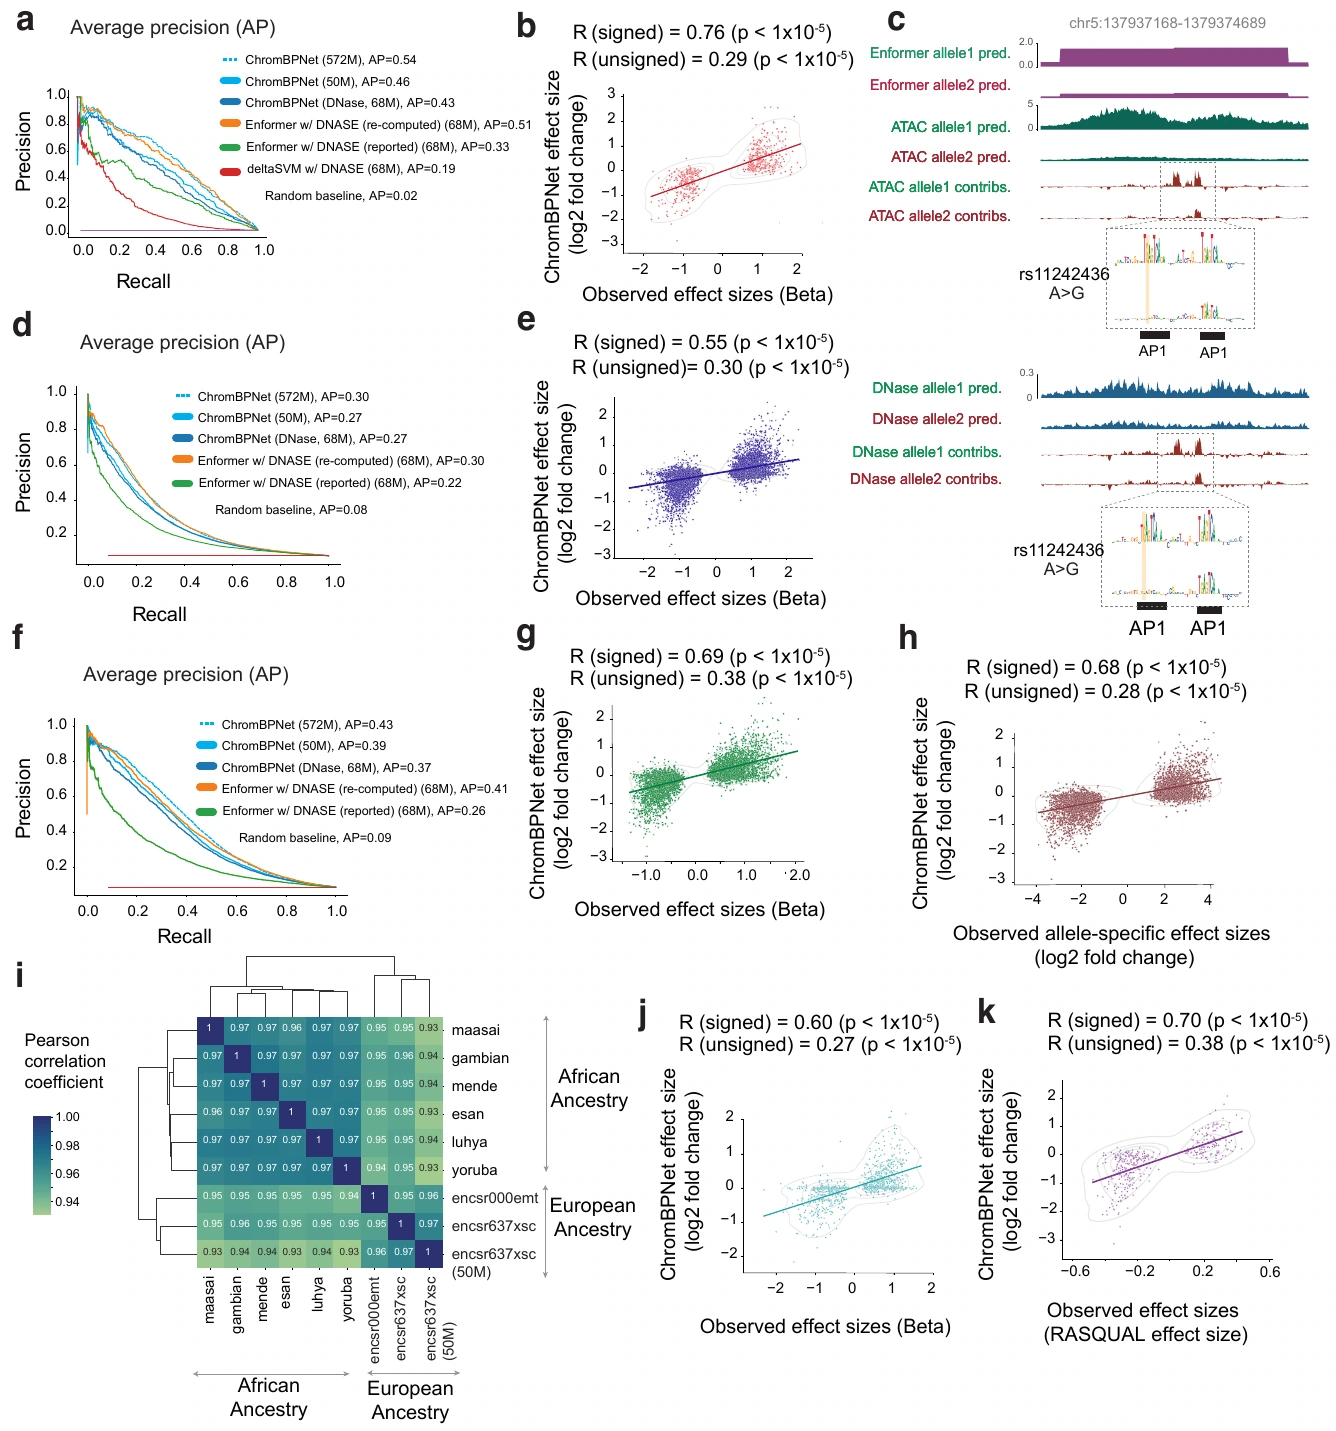
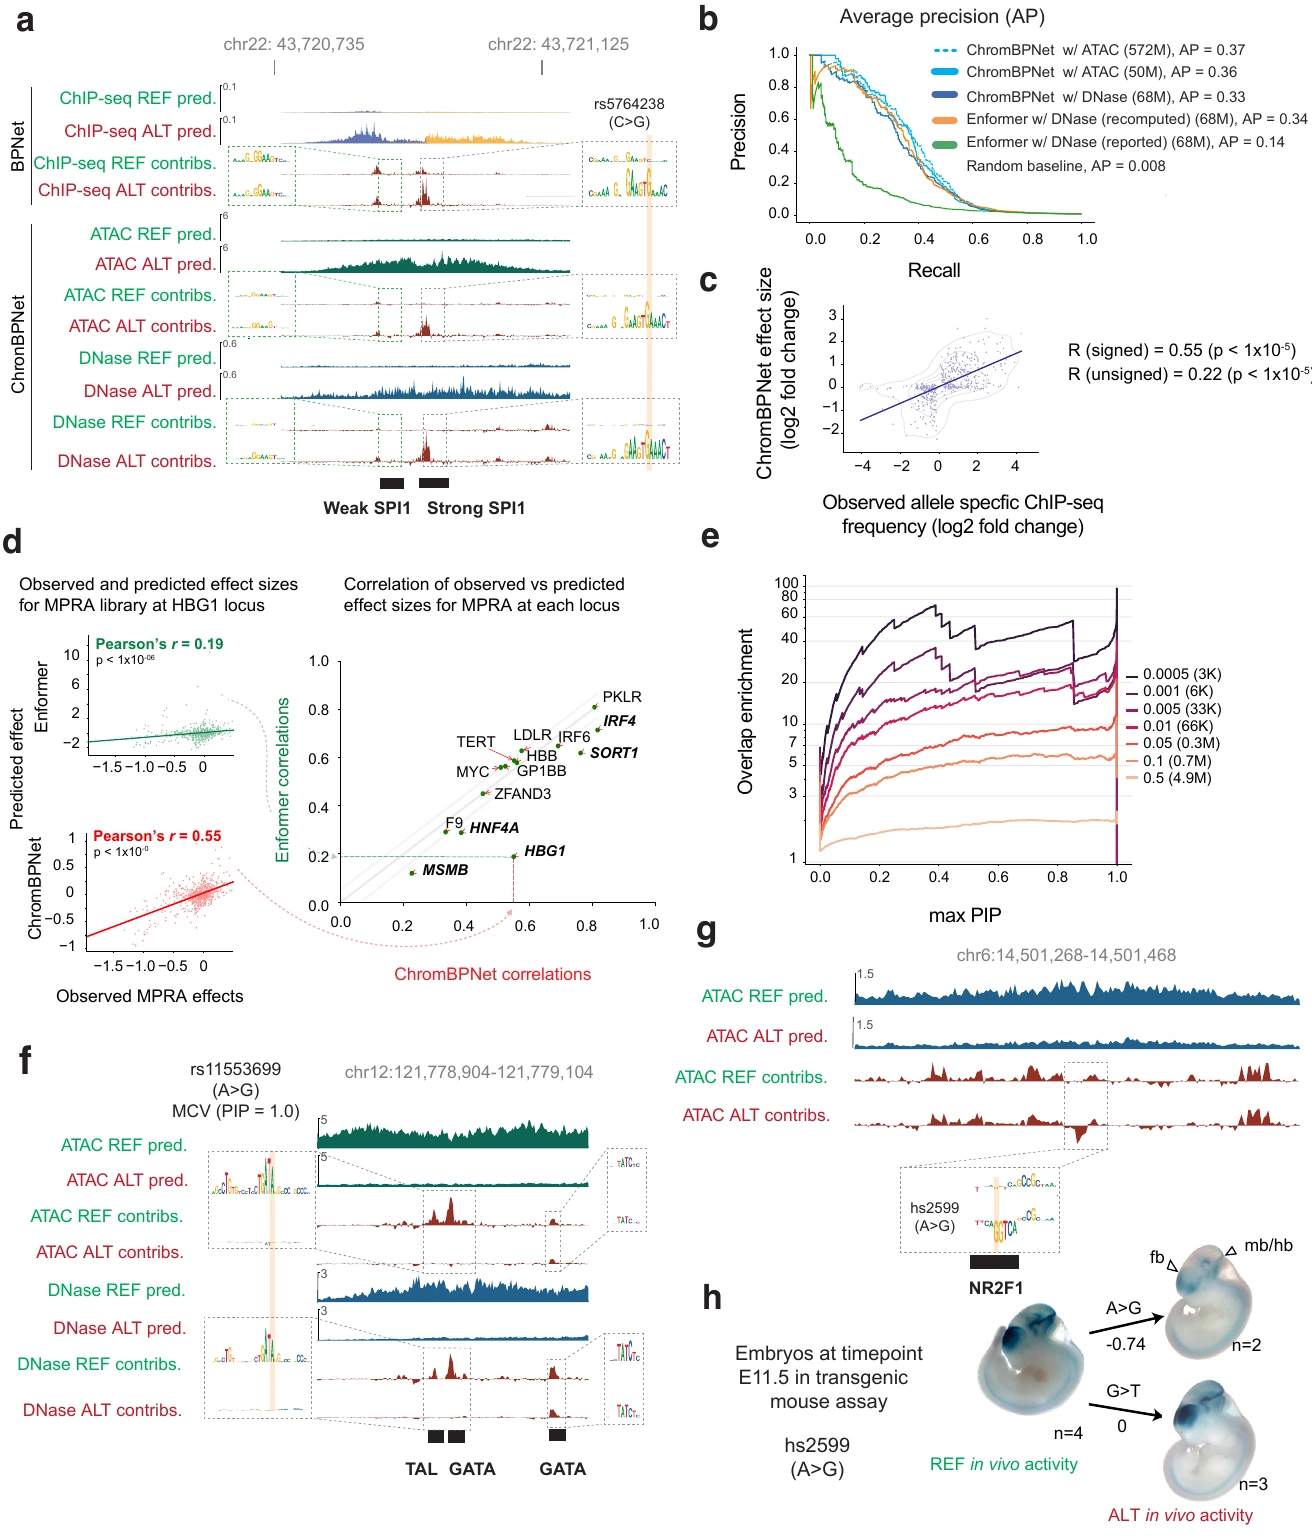
    <content type="html"><![CDATA[<!-- dl-literature-import:091 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> ChromBPNet: bias factorized, base-resolution deep learning models of chromatin accessibility reveal cis-regulatory sequence syntax, transcription factor footprints and regulatory variants</p><p><strong>期刊与年份：</strong> bioRxiv，2024。<a href="https://doi.org/10.1101/2024.12.25.630221">论文原文</a>。</p><p><strong>阅读版本：</strong> bioRxiv预印本，2025-01-08版本。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 分解测序酶偏差后能否恢复真实TF足迹、调控语法和变异效应？</p><h2 id="问题先来自解释失败，模型才围绕偏差重新设计"><a href="#问题先来自解释失败，模型才围绕偏差重新设计" class="headerlink" title="问题先来自解释失败，模型才围绕偏差重新设计"></a>问题先来自解释失败，模型才围绕偏差重新设计</h2><p>我对研究起点的推测是：如果一个ATAC模型能准确预测每个碱基的切割分布，却在归因中不断发现Tn5偏好，它可能擅长预测实验，而没有正确解释细胞调控。作者从计数头与形状头发现的motif差异出发，将技术偏差明确建成独立模块。这属于测量过程驱动的监督建模：训练标签是ATAC或DNase读段，不是疾病状态，也不是无监督疾病分型。</p><p>模型输入2,114 bp DNA，预测中央1 kb的无链方向逐碱基概率与总覆盖量。512通道扩张卷积让局部motif与附近组合共享表示，形状用多项负对数似然，总量用log计数均方误差；两种目标分别回答读段落在哪里、有多少。浅层128通道偏差模型先在低信号、GC匹配非峰区域学习，冻结后再训练调控分支。校正后的输出来自移除偏差分支，而不是把所有原始轨迹先平滑成一个新标签。</p><p>这套分解也有依赖条件：背景区域不能混入太多弱开放峰，否则会把真实TF规则交给偏差模型。作者用motif归因检查并逐步调整非峰覆盖阈值。方法采用ATAC正链+4、负链−4的切割位点处理，与常见+4&#x2F;−5设置不同；复现时不能无意混用两者。本解读基于2025年1月8日的预印本版本，证据强度按该份PDF评估。</p><h2 id="Figure-1：高分辨率开放度模型受到Tn5序列偏差干扰"><a href="#Figure-1：高分辨率开放度模型受到Tn5序列偏差干扰" class="headerlink" title="Figure 1：高分辨率开放度模型受到Tn5序列偏差干扰"></a>Figure 1：高分辨率开放度模型受到Tn5序列偏差干扰</h2><p><a href="/img/dl-literature/091/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/091/figure-01.webp" alt="Figure 1" width="1383" height="1424" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 25 页，Figure 1。点击图片可查看原图。</em></p><p>a先把总量与形状分开，是后续诊断成立的必要条件。b在同一未见位点同时展示实测、预测和两头归因，c&#x2F;d证明预测确实有能力，e&#x2F;f&#x2F;g再揭示能力背后的特征并不一致：计数主要对应TF，而形状显著携带Tn5偏好。关键结论不是模型整体无用，而是低JSD不能独自保证生物解释正确；测序酶可以提供很强的预测信号。对TE序列，这尤其重要，因为某类重复的碱基组成可能同时改变酶偏好和真实结合，直接将归因富集称为TE功能会混淆两者。</p><p>主图：PDF 第 25 页；完整图注：第 26 页。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>2114bp序列预测总计数和1kb逐碱基切割概率两种输出，定义计数头与形状头。</td></tr><tr><td>b</td><td>未见区域实测、预测及归因，计数归因突出TF而形状归因还包含Tn5偏好伪特征。</td></tr><tr><td>c</td><td>未见染色体K562峰计数预测对实测，验证总体开放量准确性。</td></tr><tr><td>d</td><td>预测与实测形状JSD对重复及随机／均值基线，展示较好形状预测不代表没有酶偏差。</td></tr><tr><td>e</td><td>计数头发现的主要模体匹配已知TF，显示其功能可解释性。</td></tr><tr><td>f</td><td>形状头模体常为Tn5偏好或扭曲TF模式，定位污染来源。</td></tr><tr><td>g</td><td>计数与形状归因seqlet频率比较，说明Tn5模式主导未经校正的形状解释。</td></tr></tbody></table><h2 id="Figure-2：分解酶偏差与真实TF代码"><a href="#Figure-2：分解酶偏差与真实TF代码" class="headerlink" title="Figure 2：分解酶偏差与真实TF代码"></a>Figure 2：分解酶偏差与真实TF代码</h2><p><a href="/img/dl-literature/091/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/091/figure-02.webp" alt="Figure 2" width="1346" height="1776" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 27 页，Figure 2。点击图片可查看原图。</em></p><p>a&#x2F;c先核对偏差模型究竟学到了什么，d给出冻结与残差学习，b&#x2F;e&#x2F;f&#x2F;g用实际轨迹、motif比例及边际足迹比较多种校正。只有去掉Tn5模式却保留TF模式，才能支持分解方向正确。边际足迹是把motif插入许多背景序列再平均预测，降低其他motif共现影响；它是计算反事实，不能写成直接测量的蛋白占位。CTCF与ZBTB7A等实例还提醒我们，增加某个motif未必都增加开放度。背景染色质偏差优于裸DNA偏差，也说明实验环境会改变测量过程，换协议后应重新做偏差诊断。</p><p>主图：PDF 第 27 页；完整图注：第 28 页。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>在无开放峰的背景染色质训练Tn5偏差模型，定义独立偏差学习。</td></tr><tr><td>b</td><td>同一区域不同校正方案的轨迹与归因，ChromBPNet配BPNet偏差模型产生清楚潜在足迹，并去掉伪Tn5特征。</td></tr><tr><td>c</td><td>背景模型发现的多种Tn5模体，证明它学习的是酶序列偏好。</td></tr><tr><td>d</td><td>冻结预训练偏差模型、训练残差TF子模型的结构，说明因子分解方式。</td></tr><tr><td>e</td><td>各校正方案的seqlet类型比较，完整BPNet偏差模型才能有效避免Tn5主导。</td></tr><tr><td>f</td><td>Tn5模体边际足迹在不同模型中的对照，检验酶偏差是否被消除。</td></tr><tr><td>g</td><td>真实TF模体边际足迹比较，校正后形状不再被Tn5偏好干扰。</td></tr></tbody></table><h2 id="Figure-3：校正后ATAC与DNase结果更加一致"><a href="#Figure-3：校正后ATAC与DNase结果更加一致" class="headerlink" title="Figure 3：校正后ATAC与DNase结果更加一致"></a>Figure 3：校正后ATAC与DNase结果更加一致</h2><p><a href="/img/dl-literature/091/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/091/figure-03.webp" alt="Figure 3" width="1338" height="1763" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 29 页，Figure 3。点击图片可查看原图。</em></p><p>a把同一位点的ATAC与DNase并排，b–d从单例扩展到轨迹、归因和motif实例的整体一致性，e–h再问校正有没有过度抹掉实验特征。两者足迹高度更一致，而DNase仍更窄，意味着方法尝试消除酶序列偏好，同时保留测量分辨率差异。这是比两条曲线看起来相似更严格的检验。不过相同序列、相近细胞状态和共同分析步骤也会增加一致性，它们不能替代真实结合扰动。</p><p>主图：PDF 第 29 页；完整图注：第 30 页。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>同一K562位点ATAC／DNase真实、预测和归因，校正后都突出AP1／SP1代码。</td></tr><tr><td>b</td><td>两实验轨迹间JSD分布，校正提高跨实验一致性。</td></tr><tr><td>c</td><td>不同计数／形状归因JSD，形状归因经校正明显更一致。</td></tr><tr><td>d</td><td>两实验的TF模体实例频率相似，说明共用调控代码被恢复。</td></tr><tr><td>e</td><td>模体足迹校正前后比较，展示酶差异去除后的TF形状。</td></tr><tr><td>f</td><td>边际足迹宽度和高度的定义，解释后续量化。</td></tr><tr><td>g</td><td>DNase足迹仍比ATAC窄，说明校正并不抹平两实验的真实分辨率差别。</td></tr><tr><td>h</td><td>两实验的足迹高度高度相关，支持共同的TF结合强度信息。</td></tr></tbody></table><h2 id="Figure-4：低覆盖数据中恢复足迹与模体"><a href="#Figure-4：低覆盖数据中恢复足迹与模体" class="headerlink" title="Figure 4：低覆盖数据中恢复足迹与模体"></a>Figure 4：低覆盖数据中恢复足迹与模体</h2><p><a href="/img/dl-literature/091/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/091/figure-04.webp" alt="Figure 4" width="1337" height="1580" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 31 页，Figure 4。点击图片可查看原图。</em></p><p>a–d是从同一572M读段实验降采样并分别训练，检验随着覆盖降低哪些信号先丢失。总体轨迹尚稳定时，稀有motif已可能召回下降，因此少量读段下得到清晰预测不代表稀有调控模式同样可靠。满深度模型是参照，不是无噪声真值，多个深度也不是独立生物队列。做AD罕见细胞或供体伪总体时，我会同时报告读段深度、motif稳定性和变异效应稳定性，不仅展示平滑轨迹；模型去噪产生的形状也不能伪装成该供体实际测到的足迹。</p><p>主图：PDF 第 31 页；完整图注：第 32 页。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>逐步降采样时实测轨迹变差，模型校正轨迹与归因仍较稳定，展示去噪能力。</td></tr><tr><td>b</td><td>满深度对降采样的JSD，25M读段仍接近，5M才明显下降。</td></tr><tr><td>c</td><td>相对满深度模体实例的召回，低深度仍保留多数模体但罕见模体在5M丢失。</td></tr><tr><td>d</td><td>不同深度的代表TF足迹，检查局部形状保持情况。</td></tr></tbody></table><h2 id="Figure-5：紧凑模体词典与协同组合"><a href="#Figure-5：紧凑模体词典与协同组合" class="headerlink" title="Figure 5：紧凑模体词典与协同组合"></a>Figure 5：紧凑模体词典与协同组合</h2><p><a href="/img/dl-literature/091/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/091/figure-05.webp" alt="Figure 5" width="1334" height="1676" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 33 页，Figure 5。点击图片可查看原图。</em></p><p>a&#x2F;b定义各细胞的紧凑motif词典，c通过组合、间距与方向扰动询问FOS–TEAD是否超出单motif效应相加，d–g再将可及性归因与TF ChIP模型归因联系起来。固定6 bp间距的协同主要来自模型反事实与独立ChIP建模支持，不能把每一种组合都写成已经完成CRISPR验证。d–g的参照是另一个由ChIP训练的BPNet归因，并非直接的结合常数；共享建模偏差仍需留意。对TE家族，可检验其共识序列是否保留特定间距组合，再看功能副本是否偏离共识，而不是只数motif出现次数。</p><p>主图：PDF 第 33 页；完整图注：第 34 页。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>不同细胞系最主要十个计数模体，展示细胞特异调控词典。</td></tr><tr><td>b</td><td>未经／经过偏差校正的足迹，后者显露细胞类型差异。</td></tr><tr><td>c</td><td>FOS-TEAD组合在固定6bp间距表现超加和协同，展示模型能发现精细模体语法。</td></tr><tr><td>d</td><td>HepG2 LDLR附近ATAC与多TF ChIP归因一致，连接开放预测与实际TF结合。</td></tr><tr><td>e</td><td>CTCF位点ATAC模型与CTCF ChIP模型归因相关，验证功能实例定位。</td></tr><tr><td>f</td><td>ChromBPNet归因比总体ATAC／DNase计数及TOBIAS分数更贴近CTCF ChIP归因。</td></tr><tr><td>g</td><td>多细胞、多TF重复f的比较，检验这种结合信息优势是否普遍。</td></tr></tbody></table><h2 id="Figure-6：跨实验、祖源与细胞类型的变异效应"><a href="#Figure-6：跨实验、祖源与细胞类型的变异效应" class="headerlink" title="Figure 6：跨实验、祖源与细胞类型的变异效应"></a>Figure 6：跨实验、祖源与细胞类型的变异效应</h2><p><a href="/img/dl-literature/091/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/091/figure-06.webp" alt="Figure 6" width="1336" height="1431" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 35 页，Figure 6。点击图片可查看原图。</em></p><p>a–k逐层增加外部检验：QTL分类、带符号效应、单例机制、欧洲与非洲数据、个体内等位偏倚、祖源模型一致性，最后到小胶质细胞和平滑肌。总量log倍数变化、形状JSD和活跃等位分位分别刻画方向、形状改变与背景可及性，合并分数的用途也要区分排序和定量。作者修正Enformer原来过大输出范围后，其局部QTL分类明显改善；因此不能概括成小模型在所有任务都击败大模型。h需考虑等位比对偏差，i是参考序列训练的群体模型之间比较，不能称为个人基因组已完全泛化。j支持脑细胞局部可及性预测，尚未建立AD发病或进展因果。</p><p>主图：PDF 第 35 页；完整图注：第 36 页。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>约鲁巴LCL dsQTL的精确率—召回率，ChromBPNet优于gkmSVM且接近Enformer。</td></tr><tr><td>b</td><td>dsQTL实测效应对预测log倍数变化，检验定量方向与强度。</td></tr><tr><td>c</td><td>rs11242436两等位轨迹及归因，显示AP1模体破坏及邻近AP1协同效应。</td></tr><tr><td>d</td><td>欧洲LCL caQTL的模型分类比较，检验跨祖源及ATAC应用。</td></tr><tr><td>e</td><td>欧洲caQTL实测对预测效应，验证效应量。</td></tr><tr><td>f</td><td>非洲LCL caQTL分类比较，检验另一祖源集合。</td></tr><tr><td>g</td><td>非洲caQTL实测对预测效应，验证量化一致性。</td></tr><tr><td>h</td><td>非洲杂合位点ATAC等位偏倚对预测效应，提供个体内等位比较。</td></tr><tr><td>i</td><td>不同祖源参考LCL训练模型的预测效应相关矩阵，检验调控效应跨背景稳定性。</td></tr><tr><td>j</td><td>小胶质细胞caQTL对单细胞伪总体训练模型预测，检查原代脑细胞应用。</td></tr><tr><td>k</td><td>冠状动脉平滑肌caQTL对匹配伪总体模型预测，检查另一原代环境。</td></tr></tbody></table><h2 id="Figure-7：TF结合、报告实验、复杂性状与罕见病变异"><a href="#Figure-7：TF结合、报告实验、复杂性状与罕见病变异" class="headerlink" title="Figure 7：TF结合、报告实验、复杂性状与罕见病变异"></a>Figure 7：TF结合、报告实验、复杂性状与罕见病变异</h2><p><a href="/img/dl-literature/091/figure-07.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/091/figure-07.webp" alt="Figure 7" width="1312" height="1540" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 37 页，Figure 7。点击图片可查看原图。</em></p><p>a–c用SPI1结合QTL问可及性效应能否反映先锋TF作用，d跨报告实验检验更直接的序列活动，e将效应排序与精细定位联系，f给血液性状实例，g&#x2F;h才走到罕见神经发育候选与小鼠胚胎报告。证据逐层增强，但报告系统的活性变化仍不等于人类内源靶基因、细胞功能和疾病表型全部成立。g中的NR2F1抑制解释及JARID2靶向关系应作为支持程度不同的机制假说。版本核对还有两处文字冲突：a正文一次写SP1而图注写SPI1，f正文使用K562而图注写GM12878；此处保留图示任务与候选机制，不能据冲突文字补造确定细胞证据。</p><p>主图：PDF 第 37 页；完整图注：第 38 页。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>rs5764238的G等位产生强SPI1模体，不同模型归因一致，解释先锋TF结合QTL。</td></tr><tr><td>b</td><td>SPI1 bQTL的分类曲线，比较ChromBPNet与Enformer。</td></tr><tr><td>c</td><td>SPI1等位ChIP效应对预测开放度效应，验证结合与开放的联系。</td></tr><tr><td>d</td><td>多增强子／启动子MPRA饱和突变效应及模型比较，ChromBPNet在IRF4、SORT1、HNF4A、MSMB、HBG1等更优。</td></tr><tr><td>e</td><td>高预测效应变异在红细胞GWAS精细定位候选中的富集，随PIP和效应阈值增加而增强。</td></tr><tr><td>f</td><td>红细胞体积关联rs11553699的G等位破坏GATA模体，提出具体调控机制。</td></tr><tr><td>g</td><td>神经发育障碍患者变异hs2599的G等位产生抑制NR2F1模体并预测降低开放度，给出疾病相关候选机制。</td></tr><tr><td>h</td><td>E11.5转基因小鼠A／G增强子报告实验，G等位在多个脑区活性降低，与g的预测一致。</td></tr></tbody></table><p>阅读说明：实际阅读版本为bioRxiv预印本，2025年1月8日，DOI 10.1101&#x2F;2024.12.25.630221；讲解依据这份PDF的正文7幅图。</p><h2 id="将创新放在测量与机制之间"><a href="#将创新放在测量与机制之间" class="headerlink" title="将创新放在测量与机制之间"></a>将创新放在测量与机制之间</h2><p>对AD的TE候选，我最愿意迁移的是两阶段流程：先用细胞类型伪总体建立并检验酶偏差分支，再训练调控模型，锁定后比较TE与匹配非TE变异的有符号局部效应。TE家族、GC、可比对性、峰强度和TSS距离都需要控制；无法唯一比对的副本不能因为模型预测漂亮就被计作实测支持。随后用独立caQTL、等位数据或MPRA验证方向，最后才连接靶基因与病理。</p><p>本模型是约600万参数的局部CNN，适合作为有限显存方案的候选，但实际5060 16 GB训练速度与batch仍应做小规模实测，不能从参数少直接承诺完整流程无障碍。小胶质细胞已有公共数据和本篇基准，可先复现一个细胞类型再展开。真正可发表的问题是某类TE背景是否系统性影响局部调控、或现有模型为何在这些背景失败，而不是简单把ChromBPNet换名字。</p><p>最深的感悟是，解释工具可以参与模型诊断，而不只是预测后的装饰。作者先发现归因中的测量混杂，再改变训练结构，并以第二种酶、QTL和报告实验检验；这个循环值得模仿。但它主要解释局部染色质规则，远端表达、病理环境和跨细胞状态仍是开放边界，不能靠扩大结论措辞跨过去。</p><p>局部效应验证时还需统一参考组装与等位方向，避免坐标转换使符号反转。</p>]]></content>
    
    
    <summary type="html">深入读懂ChromBPNet：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>90.PersonalExpressionFineTuning：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad92005a/"/>
    <id>https://perry.apay.eu.cc/posts/ad92005a/</id>
    <published>2026-10-04T12:01:30.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
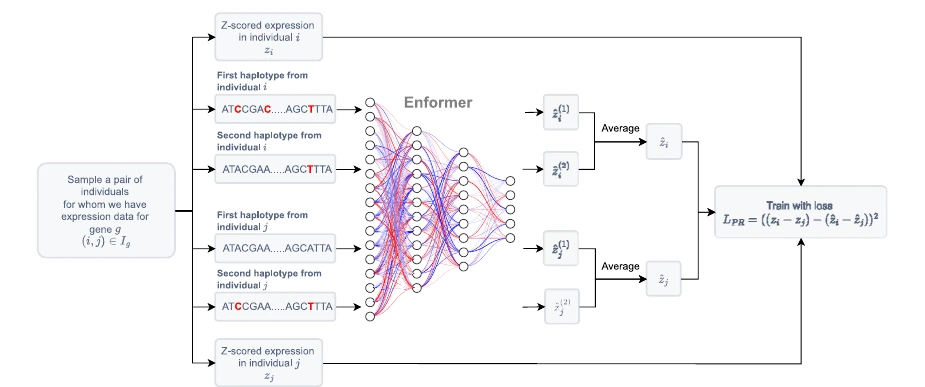
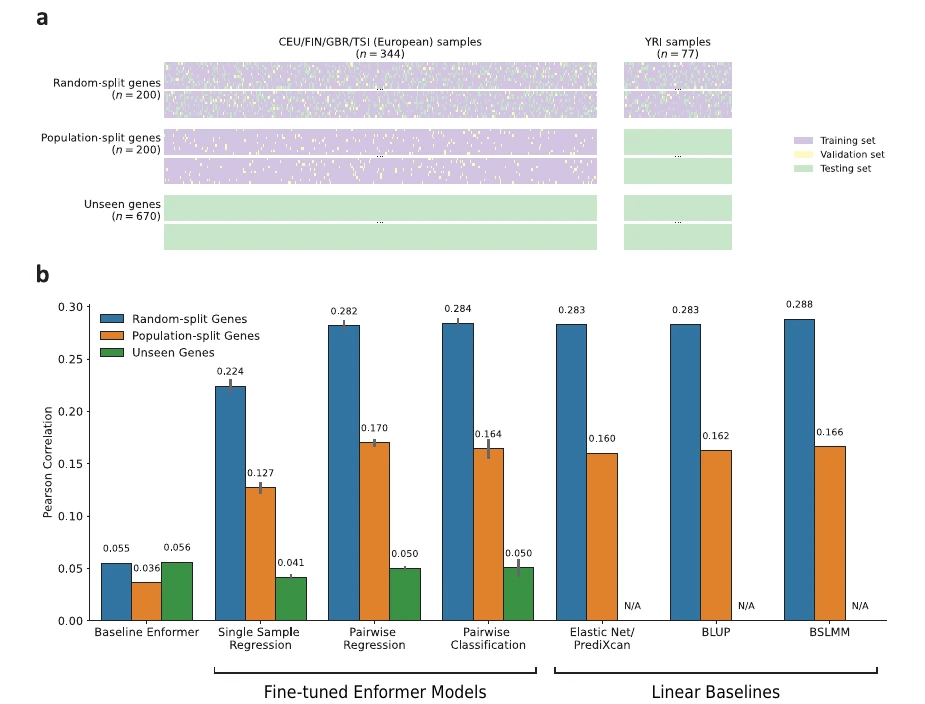
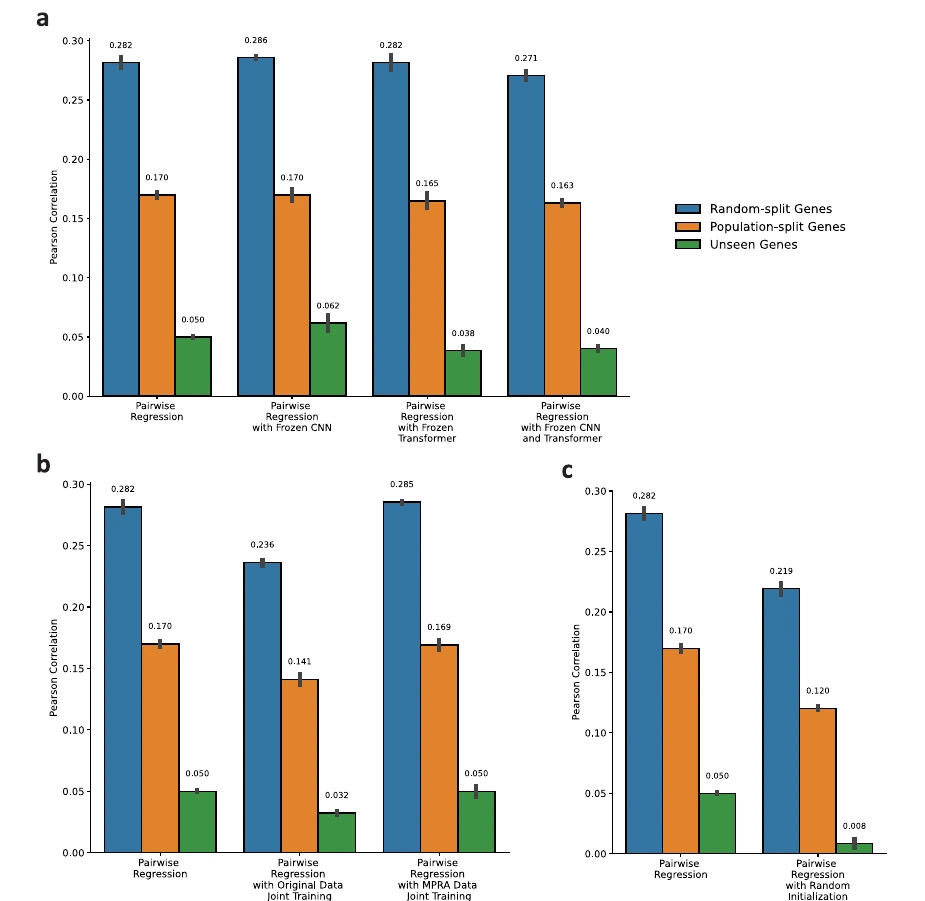
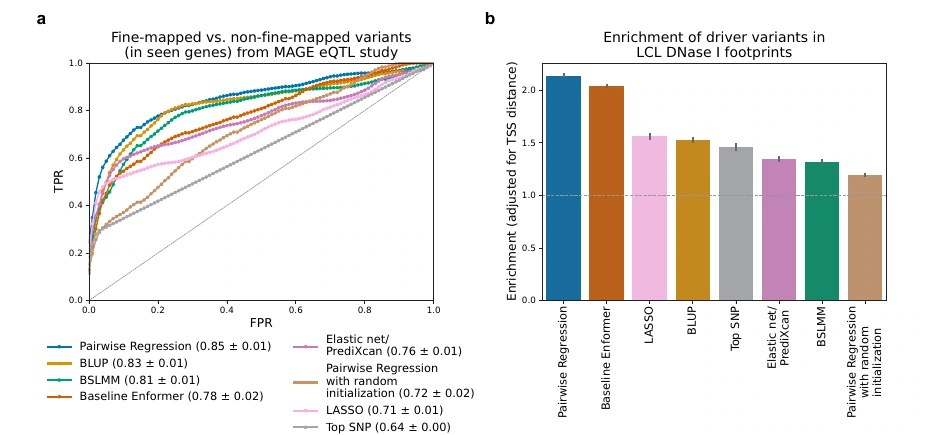
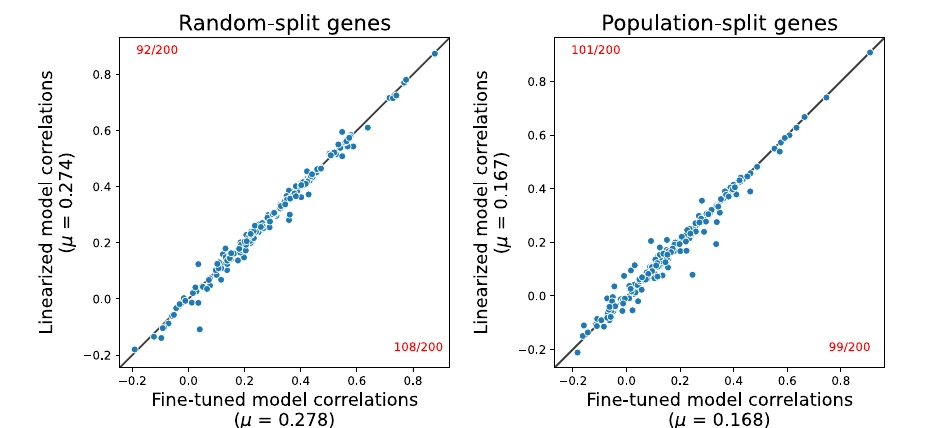
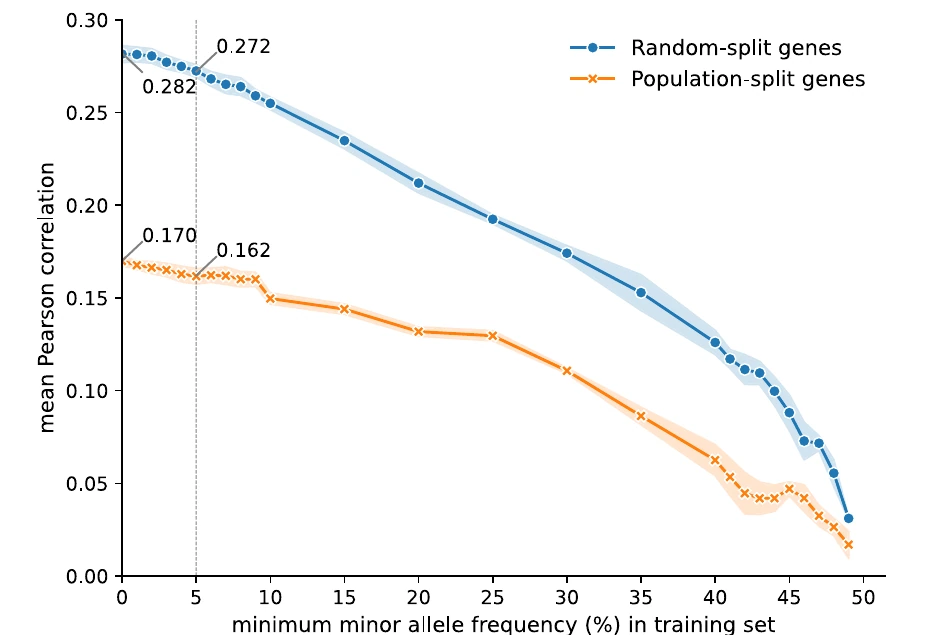
    <content type="html"><![CDATA[<!-- dl-literature-import:090 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Fine-tuning sequence-to-expression models on personal genome and transcriptome data</p><p><strong>期刊与年份：</strong> Genome Biology，2026。<a href="https://doi.org/10.1186/s13059-026-04091-1">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 个人基因组与表达数据微调能改善哪些泛化任务，仍有哪些限制？</p><h2 id="从失败基准走向“个人数据微调是否能补上缺口”"><a href="#从失败基准走向“个人数据微调是否能补上缺口”" class="headerlink" title="从失败基准走向“个人数据微调是否能补上缺口”"></a>从失败基准走向“个人数据微调是否能补上缺口”</h2><p>我对问题形成的推测是：前两篇基准指出参考序列模型常读错个人表达差异，最直接的修复想法就是让模型在训练时看到这些差异。本文将这一自然想法做成可检验研究，同时把“新的人”“新的人群”和“新基因”分开。最重要的结果不是微调后一个数字提高，而是提高发生在哪里、仍不能泛化到哪里。</p><p>作者用Geuvadis 421人的配对WGS与LCL RNA，微调Enformer。输入缩短为TSS周围49,152 bp，两单倍型生成个人预测；主模型随机选同一基因的两人，拟合标准化表达差值，损失为差值均方误差。它借用对比学习的思想，却仍是使用表达标签的监督学习，并非无监督训练。配对消除了同一基因的平均表达偏移，让梯度集中于个体差异；配对数增加也不等于独立供体变多。</p><p>输出通过中央十个bin的注意力池化与线性头汇总，全部模型权重默认参与微调。卷积与Transformer仍提供预训练的局部及远程表示，末端映射适配RNA任务。对照还包括单样本回归、配对分类、几种基因型线性模型和随机初始化。疾病或病理标签没有进入任务，讨论“个人转录组”也不意味着能预测AD进展。研究范式是冻结划分后的监督微调与泛化审计。</p><h2 id="Figure-1：以个人表达差值微调Enformer"><a href="#Figure-1：以个人表达差值微调Enformer" class="headerlink" title="Figure 1：以个人表达差值微调Enformer"></a>Figure 1：以个人表达差值微调Enformer</h2><p><a href="/img/dl-literature/090/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/090/figure-01.webp" alt="Figure 1" width="925" height="387" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 1。点击图片可查看原图。</em></p><p>无字母流程图的关键是先固定同一基因，再随机选两个人，而非比较两个基因平均表达。两人序列往往只差少量变异，差值目标因此鼓励网络利用这些位置。但个人表达还包含非遗传因素，目标不能被理解为纯粹遗传真值。基因间方差被标准化，避免少数高方差基因支配损失；这一处理需要在实际复现中记录，不能把标准化值当绝对RNA数量。</p><p>我认为图1是一项清楚的目标设计，而不是自动解决因果识别的方法。两人同时携带许多连锁变异，预测差值正确仍可能靠相关代理。要知道网络是否找到功能位点，必须看后续图4的独立线索与未见基因测试。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>全图（无字母）</td><td>同一基因随机取两个人的基因组和标准化表达，以预测表达差值的均方误差训练，直接让模型学习个体变异的作用。</td></tr></tbody></table><h2 id="Figure-2：已见基因、新人群与未见基因评估"><a href="#Figure-2：已见基因、新人群与未见基因评估" class="headerlink" title="Figure 2：已见基因、新人群与未见基因评估"></a>Figure 2：已见基因、新人群与未见基因评估</h2><p><a href="/img/dl-literature/090/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/090/figure-02.webp" alt="Figure 2" width="925" height="704" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 2。点击图片可查看原图。</em></p><p>a建立三个互不重叠基因组：200随机个体划分基因、200欧洲训练／Yoruba测试基因、670未见基因；还以不同染色体避免区域泄漏。b显示微调对已见基因的新供体明显改善，跨人群稍弱，未见基因未改善。这意味着模型更会解释已经见过的调控变化，并未形成普遍可迁移的新语法。</p><p>随机个体留出大多是已见常见变异的新组合，不是全部新变异测试。跨人群改变等位频率与LD，也改变可见变异，因此不能只称“同一任务换样本”。线性模型与微调在相同人数、输入范围和划分比较，使收益具有可解释对照。0.28和0.17是跨基因平均的个人相关，不能写成28%或17%的病例分类准确率。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>随机个体划分、人群划分及未见基因三套评估，严格区分新组合、未见祖源及全新序列任务。</td></tr><tr><td>b</td><td>微调模型对基线的平均个体间相关：随机划分约0.28、未见人群约0.17；对已见基因有提升，未见基因未改善。</td></tr></tbody></table><h2 id="Figure-3：冻结、混合训练与预训练消融"><a href="#Figure-3：冻结、混合训练与预训练消融" class="headerlink" title="Figure 3：冻结、混合训练与预训练消融"></a>Figure 3：冻结、混合训练与预训练消融</h2><p><a href="/img/dl-literature/090/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/090/figure-03.webp" alt="Figure 3" width="925" height="901" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 7 页，Figure 3。点击图片可查看原图。</em></p><p>a冻结CNN、Transformer或二者，性能只轻度变化，说明本数据下末端映射调整承担了相当部分收益；但冻结实验不能证明所有内部特征完全不变或无关。b同时加入原Enformer数据或MPRA没有明显改善，排查遗忘与序列多样性不足的简单解释。MPRA只有短片段且背景不同，结果不能扩展为“功能数据永远无用”。c随机初始化较差，说明预训练表示仍重要。整组消融告诉我们，利用已有语法和重新学会通用语法是两件事。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>冻结CNN、Transformer等组件后性能仅轻度下降，说明微调主要调整末端MLP映射。</td></tr><tr><td>b</td><td>个人数据与原Enformer或MPRA混合训练的表现，检验额外功能数据能否改善泛化。</td></tr><tr><td>c</td><td>从随机权重开始训练的表现较差，验证原预训练表示的作用。</td></tr></tbody></table><h2 id="Figure-4：因果变异优先级能力"><a href="#Figure-4：因果变异优先级能力" class="headerlink" title="Figure 4：因果变异优先级能力"></a>Figure 4：因果变异优先级能力</h2><p><a href="/img/dl-literature/090/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/090/figure-04.webp" alt="Figure 4" width="925" height="435" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 8 页，Figure 4。点击图片可查看原图。</em></p><p>a以MAGE统计精细定位的高PIP对低PIP位点比较，限定为各模型训练时都见过的变异，并在同一基因中选背景。因此它检验的是已见基因内的候选优先级，并未证明对未见罕见变异有同等能力。高PIP仍是统计证据，不是每个变异的实验因果确认。</p><p>b在DNase足迹中检查驱动变异富集，并控制TSS距离，因为模型偏向启动子、足迹也密集于启动子。去掉这一步会把位置偏差误当机制解释。足迹富集支持预训练的调控信息被利用；实际TF占据还受切割偏好及检测方法影响，不能把一个重叠点当直接结合验证。这里预训练模型本身也有较好富集，显示总体表达不准与找不到重要序列并不等价。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>用同一基因的高PIP（&gt;0.9）与低PIP（&lt;0.01）eQTL比较ROC，配对微调模型的AUROC最高（约0.85）。这里以统计精细定位作为参照，尚未逐个实验确认变异的因果作用。</td></tr><tr><td>b</td><td>控制TSS距离后的驱动变异DNase足迹富集，配对微调最高、原Enformer接近，支持预训练调控代码有用。</td></tr></tbody></table><h2 id="Figure-5：深度预测近似变异线性加和"><a href="#Figure-5：深度预测近似变异线性加和" class="headerlink" title="Figure 5：深度预测近似变异线性加和"></a>Figure 5：深度预测近似变异线性加和</h2><p><a href="/img/dl-literature/090/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/090/figure-05.webp" alt="Figure 5" width="925" height="428" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 10 页，Figure 5。点击图片可查看原图。</em></p><p>左右两图以ISM权重乘变异剂量近似深度网络，预测相关几乎相同，说明个人变异在本数据范围主要呈加和。它没有否定网络在motif内部学习非线性，也没有证明生物调控本质上线性。个人常见变异通常较稀疏，当前人数和读数可能不足以识别强交互。深度模型如果不能在相同测试上超过线性近似，研究就应解释它额外提供何种机制或新变异能力，而不只以模型复杂命名。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>左：随机划分基因</td><td>深度模型与用ISM作为权重的变异剂量线性近似相关几乎相同，说明个体变异作用主要可加。</td></tr><tr><td>右：人群划分基因</td><td>跨人群也表现接近，提示当前性能收益未明显依赖变异间强非线性交互。</td></tr></tbody></table><h2 id="Figure-6：常见与罕见变异的预测贡献"><a href="#Figure-6：常见与罕见变异的预测贡献" class="headerlink" title="Figure 6：常见与罕见变异的预测贡献"></a>Figure 6：常见与罕见变异的预测贡献</h2><p><a href="/img/dl-literature/090/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/090/figure-06.webp" alt="Figure 6" width="925" height="635" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 10 页，Figure 6。点击图片可查看原图。</em></p><p>逐步替换低频次要等位为主要等位，再观察预测下降，将输入中的遗传信息作有针对性的计算剥离。常见变异贡献最大，罕见变异少量补充，频率来自训练供体以避免偷看测试频率。删除某类等位同时改变真实单倍型，结果是模型依赖性实验，不等同于逐个罕见变异因果效应。对临床新发变异能力，仍需单独外部任务与足够可靠标签。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>全图（无字母）</td><td>逐步把低于MAF阈值的次要等位替为主要等位后，个体预测相关下降；常见变异贡献最大，稀有变异有少量额外贡献。</td></tr></tbody></table><h2 id="Figure-7：训练个体数量的缩放"><a href="#Figure-7：训练个体数量的缩放" class="headerlink" title="Figure 7：训练个体数量的缩放"></a>Figure 7：训练个体数量的缩放</h2><p><a href="/img/dl-literature/090/figure-07.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/090/figure-07.webp" alt="Figure 7" width="925" height="381" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 11 页，Figure 7。点击图片可查看原图。</em></p><p>配对模型与BLUP的训练人数缩放相近，已见基因随人数增长改善、未见基因不稳定改善。扩大供体能改善已见统计关系，却未自动跨越序列任务泛化瓶颈。误差来自重新抽样和模型重复，不是每个基因独立的个人置信区间。BLUP没有未见基因预测分支，图中空缺不应写成其在这项任务获得零分。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>左：配对微调</td><td>已见基因随训练人数增加而提高，未见基因表现不随人数稳定改善，显示泛化瓶颈。</td></tr><tr><td>右：BLUP</td><td>线性模型对已见基因的缩放与微调类似；该方法没有可应用于未见基因的对应预测。</td></tr></tbody></table><h2 id="对有限显存与AD课题的启发"><a href="#对有限显存与AD课题的启发" class="headerlink" title="对有限显存与AD课题的启发"></a>对有限显存与AD课题的启发</h2><p>本文主要实验用了八张A5000或TITAN RTX，不能直接承诺5060 16 GB可复现同等吞吐。但冻结主干的消融为小资源方案提供根据：预计算固定模型表示，训练较小输出头，再与全微调或线性剂量模型做明确比较。资源节省本身不是创新，目标是在独立脑数据和TE候选中得到更可信的方向或泛化。</p><p>我会先将任务限定为某一脑细胞类型、已见调控模块的新供体预测，再把未见TE家族或未见基因作为独立挑战。若疾病标签仅用于后验联系，应锁定模型后再分析，不能借病理调参又宣称无监督发现。所有个人两单倍型、配对样本与同一供体应整体划分，近邻TE副本还要考虑同源泄漏。</p><p>最深的启发是：微调可以修正预测，却不一定带来可迁移机制。只有当模型在此前没有见过的位点、变异或队列里仍能正确解释方向，才有理由说它学到了新的调控规律。这个开放缺口比简单模仿论文加一层网络更适合作为研究问题。</p><p>实际实施时还应保存每次供体划分和随机种子，用统一测试集比较所有消融，防止不同划分使架构改进与抽样运气混在一起。</p>]]></content>
    
    
    <summary type="html">深入读懂PersonalExpressionFineTuning：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="模型评估" scheme="https://perry.apay.eu.cc/tags/%E6%A8%A1%E5%9E%8B%E8%AF%84%E4%BC%B0/"/>
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="个人基因组" scheme="https://perry.apay.eu.cc/tags/%E4%B8%AA%E4%BA%BA%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="基因表达" scheme="https://perry.apay.eu.cc/tags/%E5%9F%BA%E5%9B%A0%E8%A1%A8%E8%BE%BE/"/>
    
  </entry>
  
  <entry>
    <title>89.SegmentNT-ContextBias：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920059/"/>
    <id>https://perry.apay.eu.cc/posts/ad920059/</id>
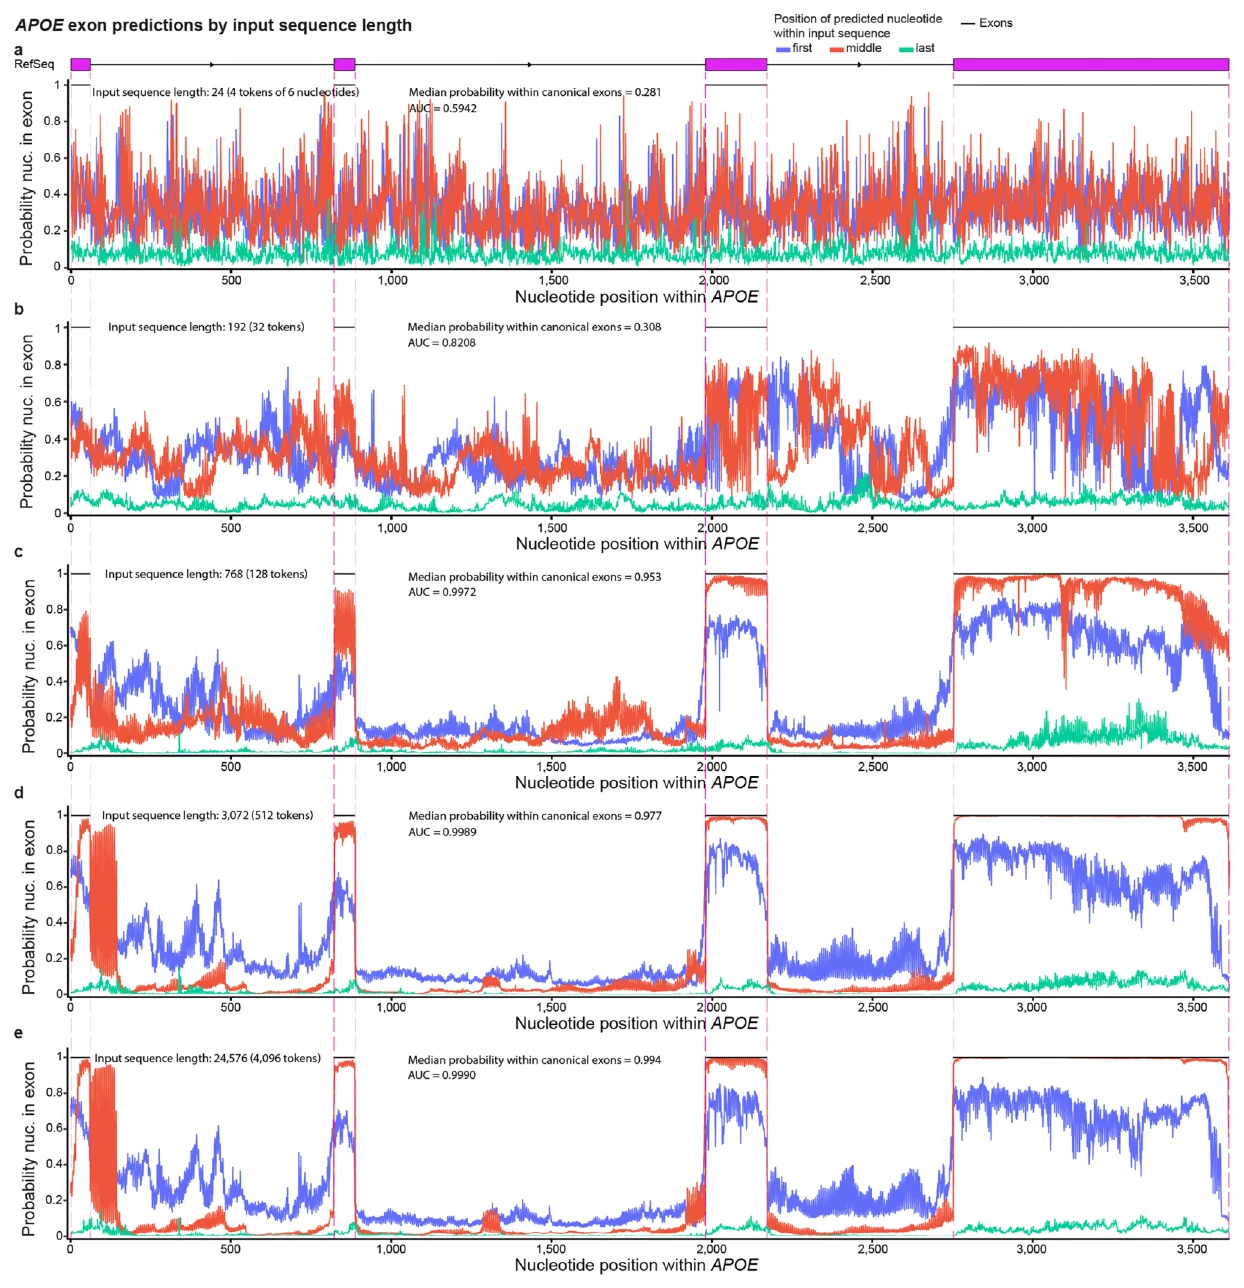
    <published>2026-10-04T12:01:29.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
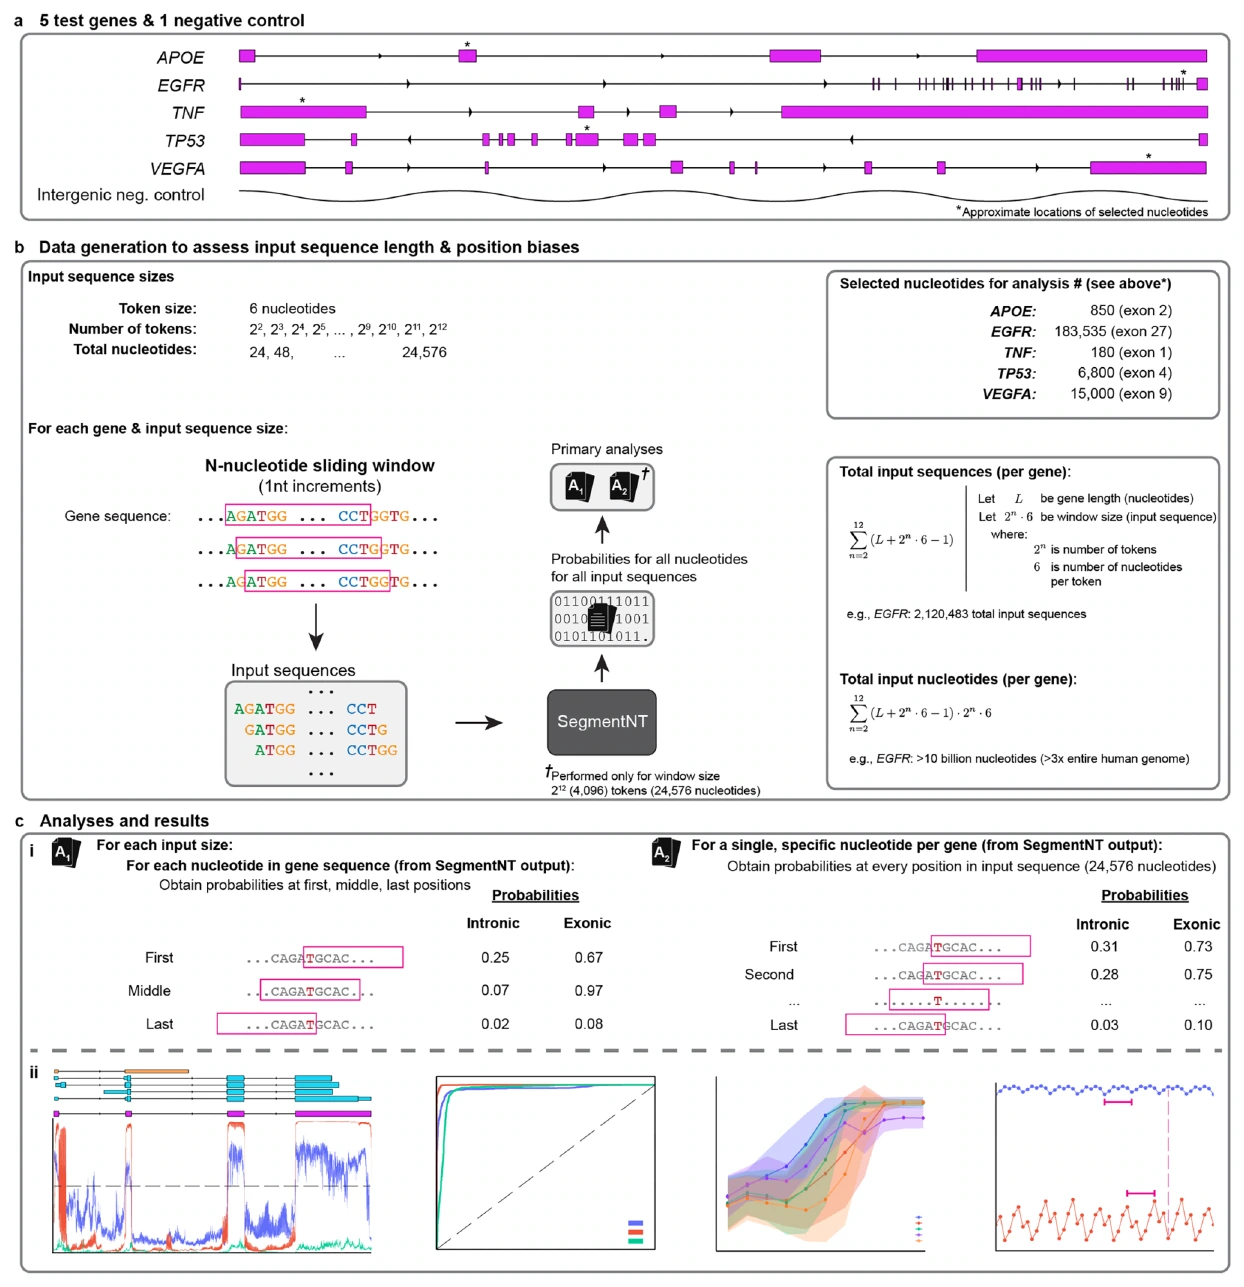
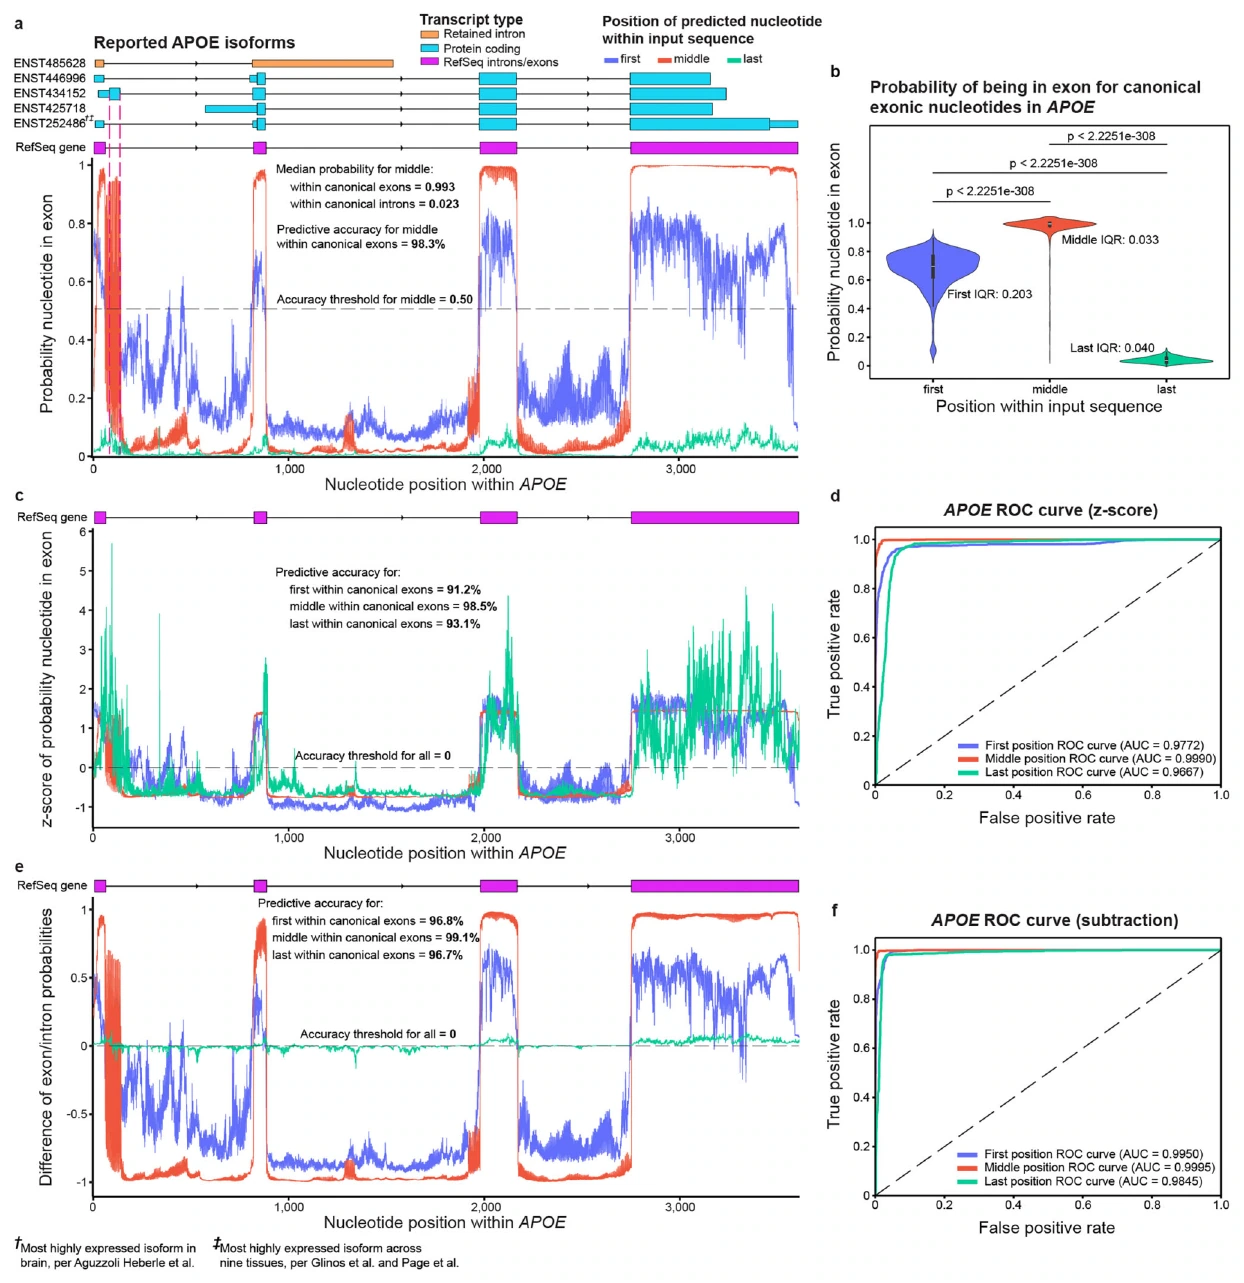
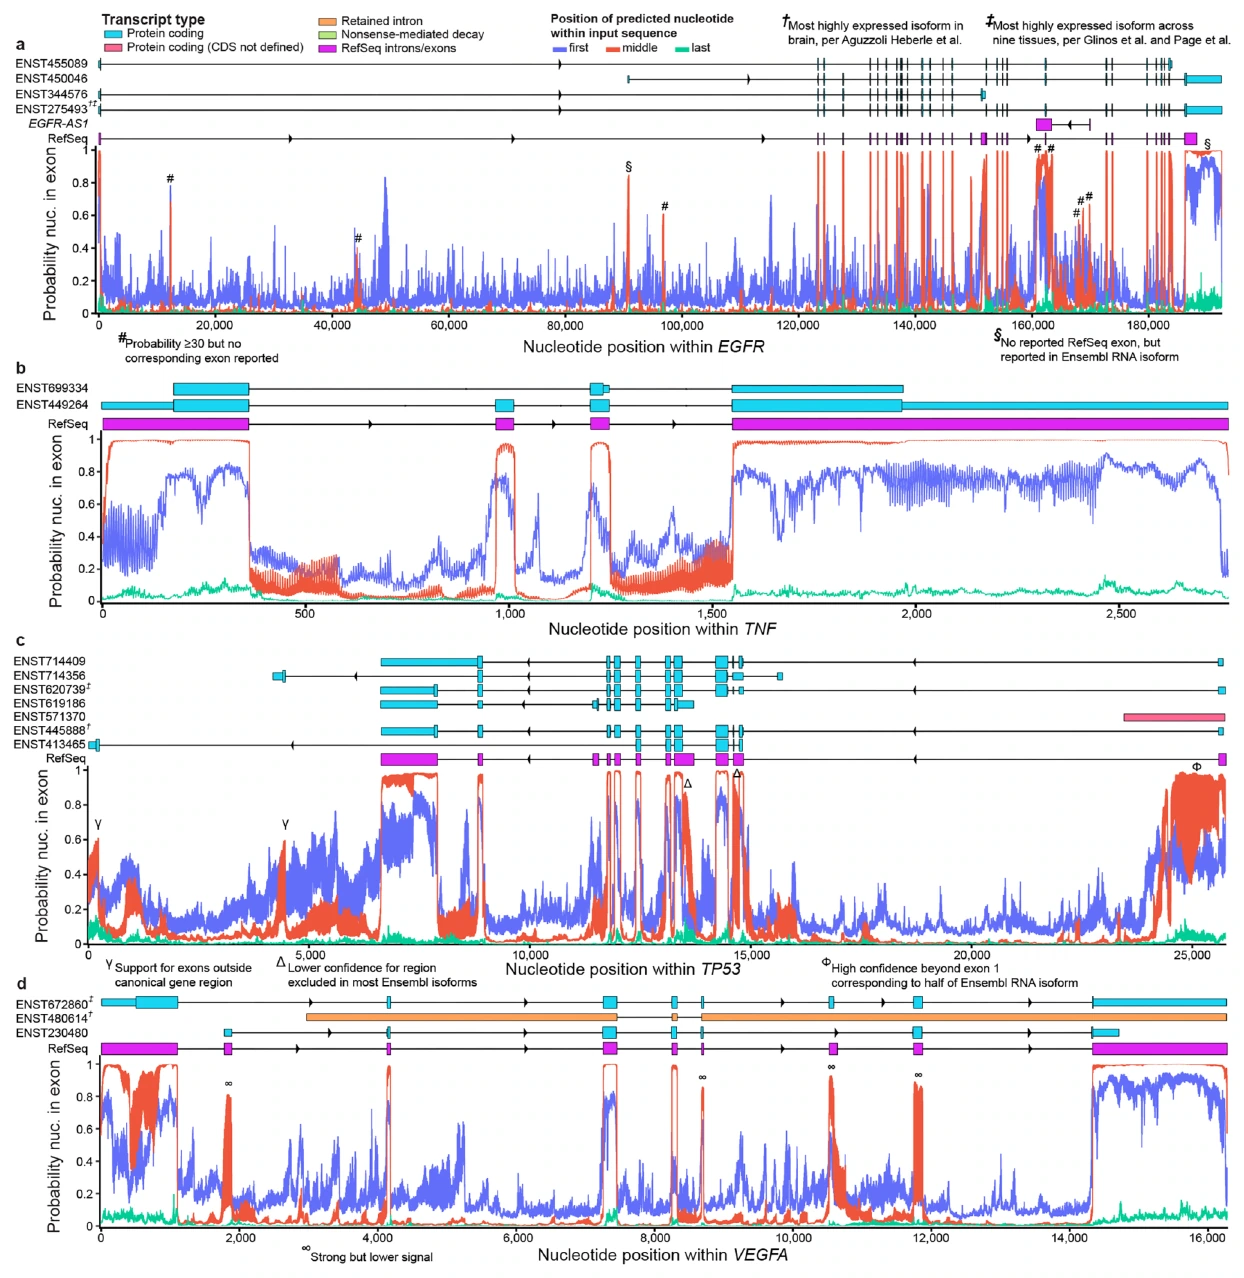
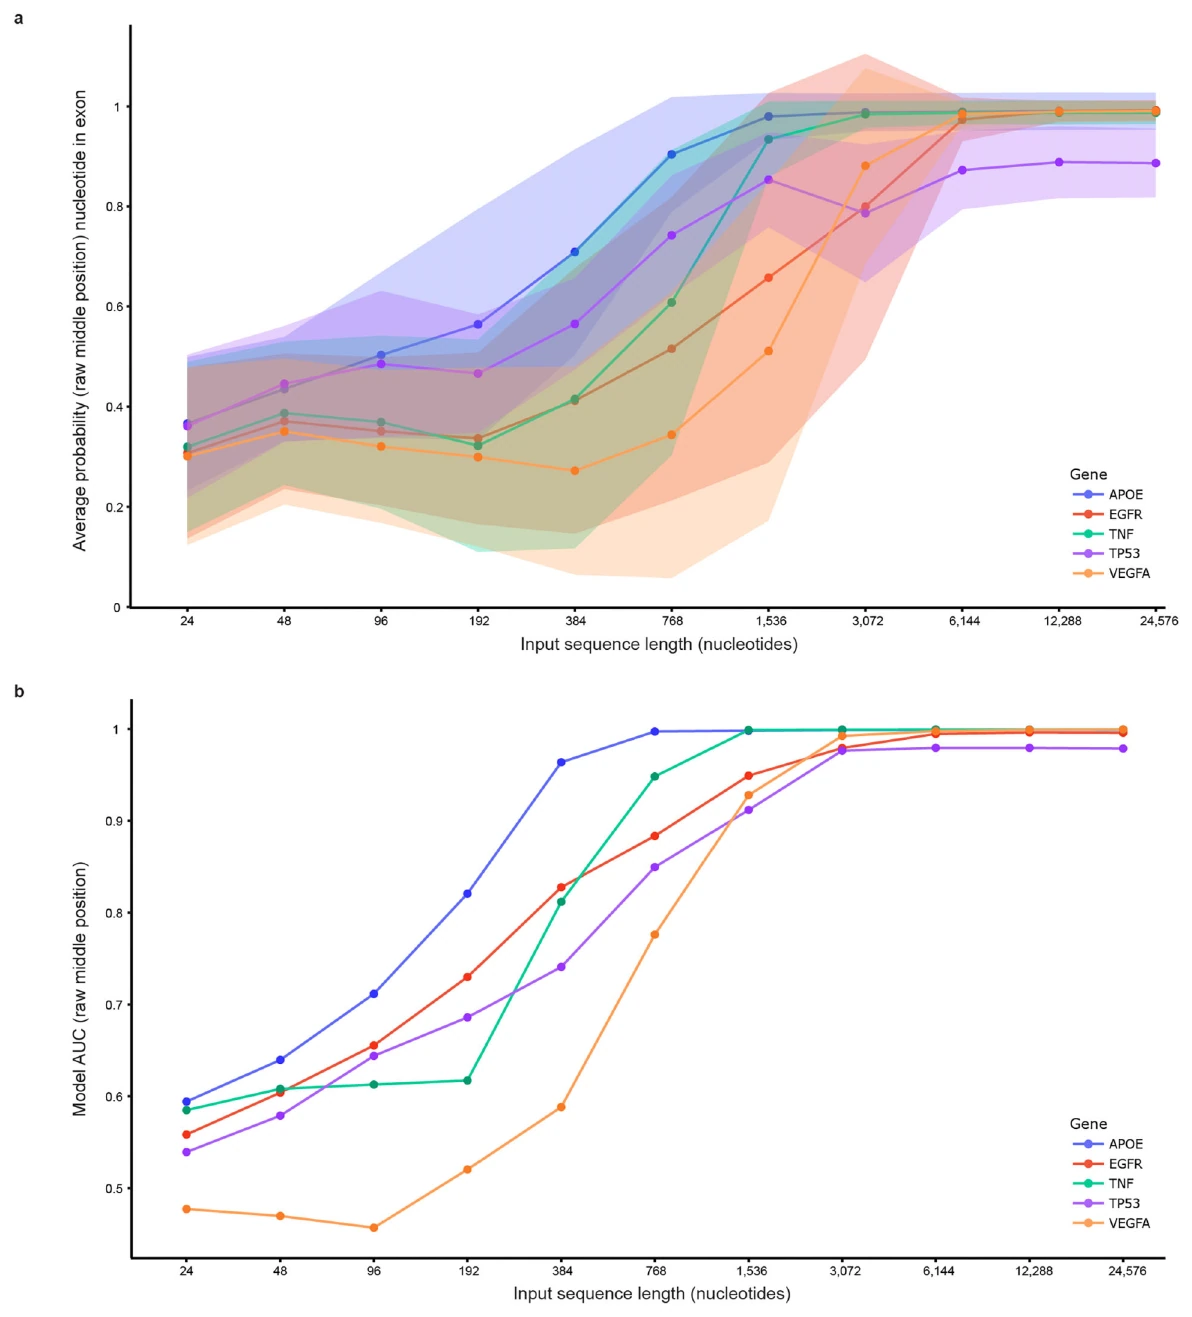
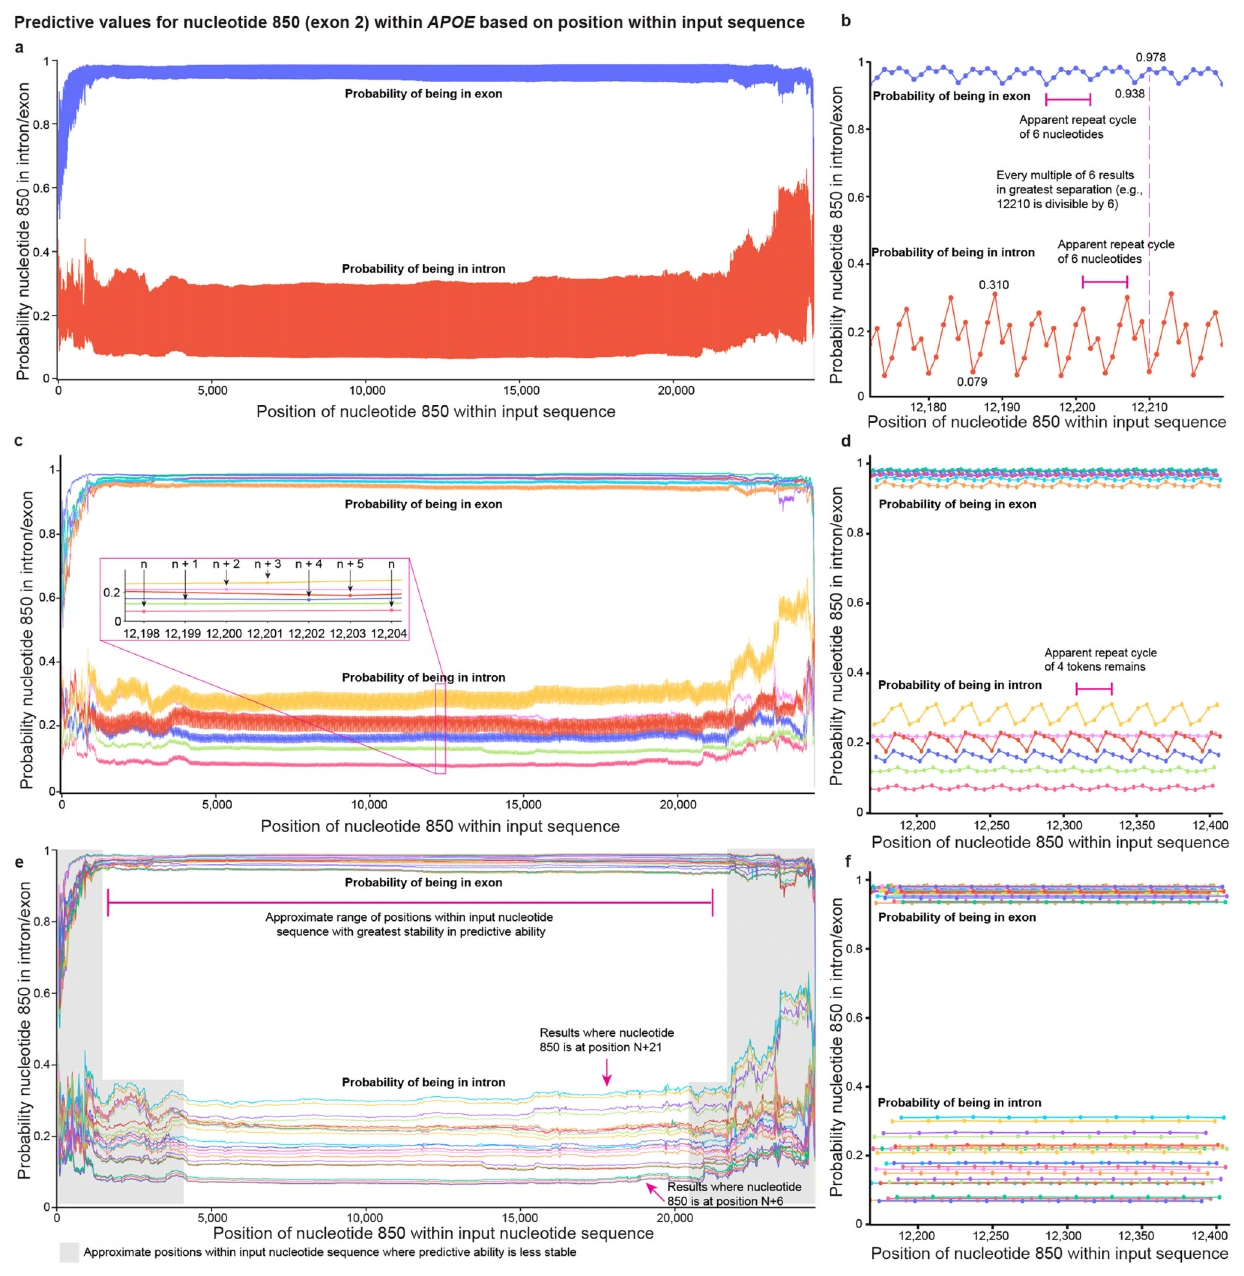
    <content type="html"><![CDATA[<!-- dl-literature-import:089 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Systematic contextual biases in SegmentNT potentially relevant to other nucleotide transformer models</p><p><strong>期刊与年份：</strong> Nucleic Acids Research，2026。<a href="https://doi.org/10.1093/nar/gkag704">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 输入长度和碱基在窗口中的位置会怎样系统影响SegmentNT输出？</p><h2 id="当输入切片本身可以改变同一个碱基的答案"><a href="#当输入切片本身可以改变同一个碱基的答案" class="headerlink" title="当输入切片本身可以改变同一个碱基的答案"></a>当输入切片本身可以改变同一个碱基的答案</h2><p>我对问题形成过程的推测是，作者把基础模型常见使用习惯转成了可实验的问题：从基因组切下一段序列，模型返回每个碱基的注释概率，这个概率是否会随窗口长短或碱基所处位置变化？如果同一DNA、同一碱基仅因切片偏移就出现差异，后续变异评分或新注释发现可能混入输入构造效应。论文重点是冻结SegmentNT进行上下文稳健性审计，并未训练一个新的AD模型。</p><p>SegmentNT以Nucleotide Transformer的6-mer表示和分割网络预测逐碱基、多标签基因组特征。本篇仅检查外显子和内含子两个输出，不是全部14类。它们分别预测，概率不必相加为1：一个位置可涉及重叠转录本，独立输出与互斥softmax的含义不同。作者对五个常见基因和一个基因间对照做详细扫描，再以五个额外基因及更多碱基验证，不能将其样本规模写成全基因组调查。</p><p>输入从24到24,576 nt，逐碱基滑动使同一位置处于首、中、末或全部窗口位置。评估真值采用RefSeq外显子注释，并与Ensembl异构体及实际长读RNA线索比较。参照注释有用，却不是组织特异实测剪接概率。尤其APOE出现只是作为与AD有关的代表位点；本文没有比较患者病理、AD病例对照或疾病变异效应。</p><h2 id="Figure-1：检验输入长度与碱基位置偏差的研究设计"><a href="#Figure-1：检验输入长度与碱基位置偏差的研究设计" class="headerlink" title="Figure 1：检验输入长度与碱基位置偏差的研究设计"></a>Figure 1：检验输入长度与碱基位置偏差的研究设计</h2><p><a href="/img/dl-literature/089/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/089/figure-01.webp" alt="Figure 1" width="1244" height="1287" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 1。点击图片可查看原图。</em></p><p>a界定测试基因与负对照，b通过同一序列的不同切法建立控制，c区分每个碱基首中末轨迹与少数固定碱基的全部位置扫描。这样可以把基因本身不同和输入位置不同分开。窗口偏移也会改变进入模型的远端上下文，因而边界恶化不能全部归于模型内部周期性；中心小幅周期与缺少侧翼的大尺度效应需分别看。基因间对照匹配APOE的大致长度与SINE比例，有助排查一般重复含量，却不代表已经检验各种TE家族。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>选择APOE、EGFR、TNF、TP53、VEGFA及基因间对照，定义五个代表位点而非全基因组调查。</td></tr><tr><td>b</td><td>11种输入长度以逐碱基滑动窗口生成概率，说明如何把相同碱基置于不同上下文位置。</td></tr><tr><td>c-i</td><td>分析首／中／末位置及五个单碱基在整个窗口的位置，区分两种位置评估。</td></tr><tr><td>c-ii</td><td>示意原始概率和性能的解释分析，连接上下文偏差与实际注释准确性。</td></tr></tbody></table><h2 id="Figure-2：APOE的预测取决于在窗口中的位置"><a href="#Figure-2：APOE的预测取决于在窗口中的位置" class="headerlink" title="Figure 2：APOE的预测取决于在窗口中的位置"></a>Figure 2：APOE的预测取决于在窗口中的位置</h2><p><a href="/img/dl-literature/089/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/089/figure-02.webp" alt="Figure 2" width="1244" height="1283" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 6 页，Figure 2。点击图片可查看原图。</em></p><p>a、b显示同一APOE外显子在窗口边缘与中心的原始概率分布不同。c、d通过Z标准化统一阈值解释，e、f再用外显子减内含子得分比较。重要的是，单调标准化不会凭空提高同一轨迹的排序AUC；它主要调整概率尺度和阈值解释。外显子减内含子则组合两种输出，可能改变排序。两者的作用不能混写成“校正后模型学会新生物学”。</p><p>98%以上的中心分类准确度是相对于这一个基因的注释与所用阈值，不能作为所有人类注释的准确率。某处概率与替代外显子重合可以提出假说，尚不能仅凭模型证明实际组织使用这个异构体。与注释冲突时需同时检查漏注、反链与预测错误。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>同一APOE碱基处于首、中、末位置时的外显子概率轨迹明显不同，中心较符合注释。</td></tr><tr><td>b</td><td>真实外显子概率分布比较，中心较高、末端较低，首端波动较大。</td></tr><tr><td>c</td><td>概率标准化后对实际注释的定位，中心准确率约98.5%，高于首末位置。</td></tr><tr><td>d</td><td>标准化概率ROC及AUC，检验位置差异对区分外显子／内含子的影响。</td></tr><tr><td>e</td><td>以外显子减内含子概率归一化的轨迹，检查另一校正方式。</td></tr><tr><td>f</td><td>对应减法模型ROC，比较概率解释方式。</td></tr></tbody></table><h2 id="Figure-3：四个额外基因的位置偏差"><a href="#Figure-3：四个额外基因的位置偏差" class="headerlink" title="Figure 3：四个额外基因的位置偏差"></a>Figure 3：四个额外基因的位置偏差</h2><p><a href="/img/dl-literature/089/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/089/figure-03.webp" alt="Figure 3" width="1244" height="1278" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 7 页，Figure 3。点击图片可查看原图。</em></p><p>a至d检验不同基因、链方向和异构体是否重复出现相同位置效应。EGFR附近一些峰对应负链EGFR-AS1，提示模型输出是基因组特征，并不天然限定于读者眼前的某个正链基因。TP53多异构体扩展超过经典边界，VEGFA的内含子保留与较低外显子概率又提示注释层次复杂。</p><p>这张图不能被读成模型已经发现新的组织特异剪接。作者给出的实际异构体表达资料是外部对照，模型没有接收该组织状态；外显子概率高低更不是该异构体在脑中使用比例。某些低概率原因尚不明确，这种保留未知比编造一个剪接机制更准确。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>EGFR概率和异构体注释，部分信号来自负链EGFR-AS1，说明不能只按单基因／单链解释。</td></tr><tr><td>b</td><td>TNF概率与两异构体，检验同样的位置偏差是否复现。</td></tr><tr><td>c</td><td>TP53负链基因及多异构体概率，展示基因边界之外的转录本也影响解释。</td></tr><tr><td>d</td><td>VEGFA多异构体及保留内含子注释，检查与表达主转录本不同的信号；部分外显子概率较低原因尚未明确。</td></tr></tbody></table><h2 id="Figure-4：上下文越长通常越准确，但收益饱和"><a href="#Figure-4：上下文越长通常越准确，但收益饱和" class="headerlink" title="Figure 4：上下文越长通常越准确，但收益饱和"></a>Figure 4：上下文越长通常越准确，但收益饱和</h2><p><a href="/img/dl-literature/089/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/089/figure-04.webp" alt="Figure 4" width="1244" height="1288" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 9 页，Figure 4。点击图片可查看原图。</em></p><p>a到e保持APOE任务，增加上下文长度，展示极短序列基本无区分、较长序列逐渐恢复外显子结构。它回答的是上下文对这两个注释任务是否有用，不能直接推出预测AD风险或远程增强子只需同样长度。输入更长不仅带来信息，也可能更接近训练分布，若要证明信息来源需要进一步删除或替换侧翼对照。</p><p>模型在替代外显子附近的波动仍存在，说明长度增长没有保证所有位置稳定。一个长窗口能够给整体分类很高AUC，同时在个别重要边界处产生不稳定；高总体成绩不能排除关键位点的技术敏感性。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>24nt输入的APOE概率近似无规律，难以区分外显子和内含子。</td></tr><tr><td>b</td><td>192nt输入开始有结构但仍不清楚，展示极短上下文不足。</td></tr><tr><td>c</td><td>768nt输入出现清楚区分，AUC达到约0.9972，显示主要改善。</td></tr><tr><td>d</td><td>3072nt概率更稳定，也保留可变剪接外显子信号。</td></tr><tr><td>e</td><td>24576nt的概率接近明确分类，展示长输入的精细稳定化收益。</td></tr></tbody></table><h2 id="Figure-5：长度收益的边际变化"><a href="#Figure-5：长度收益的边际变化" class="headerlink" title="Figure 5：长度收益的边际变化"></a>Figure 5：长度收益的边际变化</h2><p><a href="/img/dl-literature/089/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/089/figure-05.webp" alt="Figure 5" width="1192" height="1317" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 10 页，Figure 5。点击图片可查看原图。</em></p><p>a看平均外显子概率，b看排序分类能力。概率继续靠近1不等于分类改善等幅增加，这正是作者比较两种读数的原因。约3,072 nt后AUC收益较小，约6,144 nt后平均概率趋平台，二者不矛盾，因为衡量目标不同。</p><p>我会把3 kb视为值得测试的节省计算起点，而非通用最佳长度。它来自少数基因、外显子／内含子和固定模型版本；增强子、重复元件、长程相互作用可能需要不同范围。资源有限时先做长度消融，再以实际任务性能决定，比按模型最大输入直接训练更合理。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>五基因中心位置平均外显子概率随长度增加，约6144nt后趋平台。</td></tr><tr><td>b</td><td>中心位置AUC大部分改善约在3072nt完成，因此平均概率持续增加不代表分类能力同等改善。</td></tr></tbody></table><h2 id="Figure-6：同一碱基随输入偏移产生24nt周期"><a href="#Figure-6：同一碱基随输入偏移产生24nt周期" class="headerlink" title="Figure 6：同一碱基随输入偏移产生24nt周期"></a>Figure 6：同一碱基随输入偏移产生24nt周期</h2><p><a href="/img/dl-literature/089/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/089/figure-06.webp" alt="Figure 6" width="1244" height="1276" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 11 页，Figure 6。点击图片可查看原图。</em></p><p>a、b对固定碱基扫描全部窗口位置，先看到边缘不稳与中心振荡；c、d每隔6 nt取值仍残留四token周期，e、f每隔24 nt取值才使中心同相位轨迹近似平滑。这个逐层采样设计区分了6-mer分词与更长周期，说明简单固定6 nt对齐不足以完全消除输出波动。</p><p>24 nt周期与分词、U-Net、位置编码的关联属于作者提出的可能解释，尚未通过重新训练或模块消融确定起源。每隔24 nt画出的线平滑，也不意味着不同相位的预测已相同。选择“最好相位”再评价会引入选择偏差，应预先固定或平均相位并报告波动；窗口位移不是DNA变异，不能把其概率变化解释为生物效应。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>APOE第850碱基在24576nt窗口每个位置的外显子／内含子概率，中心较稳定但仍周期振荡，边缘更差。</td></tr><tr><td>b</td><td>局部放大看似6nt周期，展示token移位产生的概率波动。</td></tr><tr><td>c</td><td>每隔6nt取值仍有四token周期，说明并非单纯6nt模式。</td></tr><tr><td>d</td><td>c局部放大，清楚显示残余周期。</td></tr><tr><td>e</td><td>每隔24nt取值的全范围曲线，中心周期被消除但两端仍波动。</td></tr><tr><td>f</td><td>对应中心局部放大，验证24nt对齐使同组概率近似平滑；此偏差说明窗口选择本身能改变输出。</td></tr></tbody></table><h2 id="对TE与AD候选，先要求结果经得住切片改变"><a href="#对TE与AD候选，先要求结果经得住切片改变" class="headerlink" title="对TE与AD候选，先要求结果经得住切片改变"></a>对TE与AD候选，先要求结果经得住切片改变</h2><p>这篇给我的具体启发是，为变异评分加入一个小型稳健性基准：参考和替代等位使用完全相同长度、位置与侧翼，在多个预定偏移下成对计算差值，报告平均效应、方向一致性和范围。否则原始概率差可能主要由输入位置变化产生。要检查是否在重复序列和TE边界更明显，需另外设计家族与长度匹配的数据，本文不能直接回答。</p><p>一个可做的纯计算课题是比较不同小DNA表示模型在TE家族与非TE区域的切片稳定性，再与外部可及性或变异功能标签连接。创新不应止于发现周期，而应判断它是否改变候选排名、方向或模块归属，并证明一种修正方式在完全留出的区域减少错误而不损害真实信号。</p><p>我也会谨慎使用本篇极小P值：相邻碱基和相邻窗口高度依赖，海量窗口不是海量独立样本。概率分布差异可以很显著，却仍需效应幅度和跨区域复现来判断重要性。标准化是解释层面的工具，不是重新校准致病概率；多标签注释模型输出也不应在未经验证时被当作临床风险。</p><p>实际部署还应记录输入长度与偏移规则，以便他人复现同一个碱基的分数。默认参数变化若不记入元数据，后续比较不同模型或不同队列时就可能把切片差异误当成生物差异。</p>]]></content>
    
    
    <summary type="html">深入读懂SegmentNT-ContextBias：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="模型评估" scheme="https://perry.apay.eu.cc/tags/%E6%A8%A1%E5%9E%8B%E8%AF%84%E4%BC%B0/"/>
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
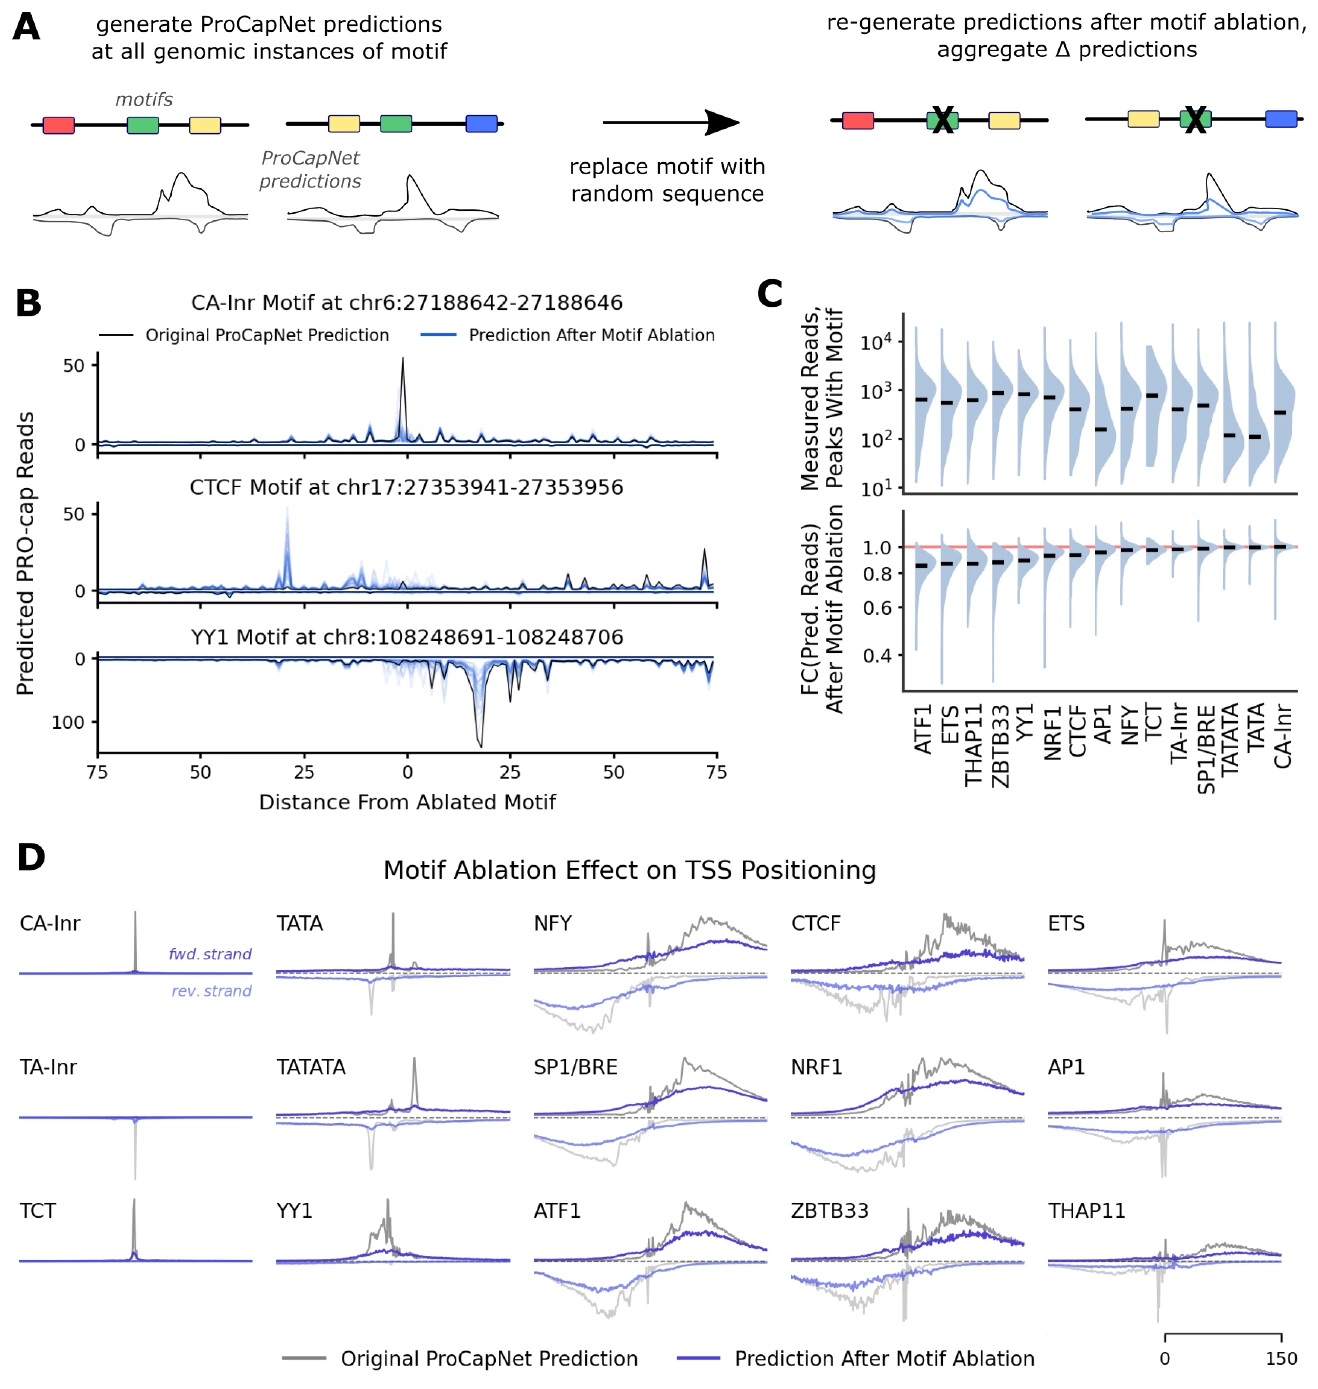
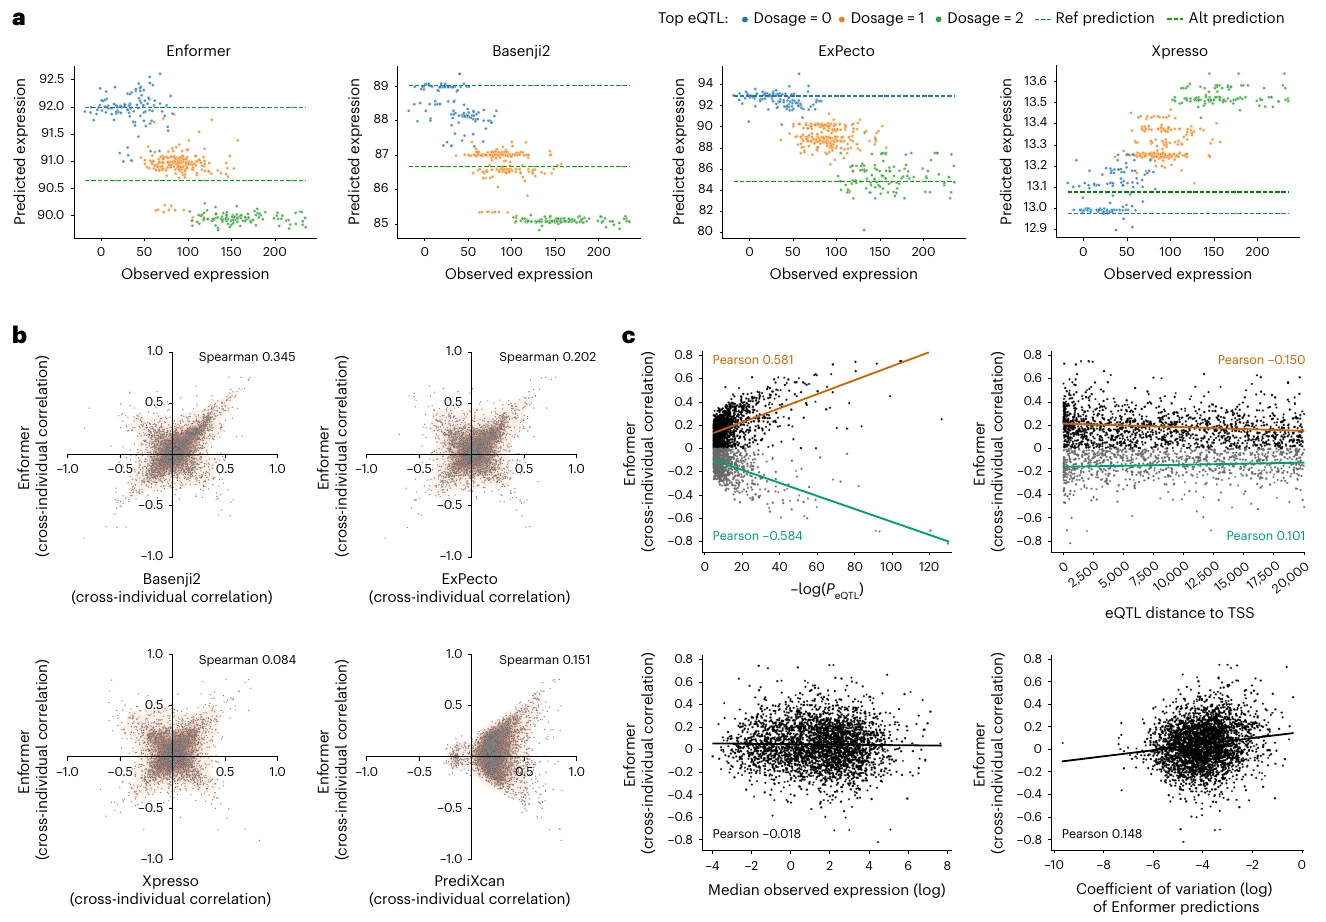
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>88.PersonalTranscriptome-Huang：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920058/"/>
    <id>https://perry.apay.eu.cc/posts/ad920058/</id>
    <published>2026-10-04T12:01:28.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
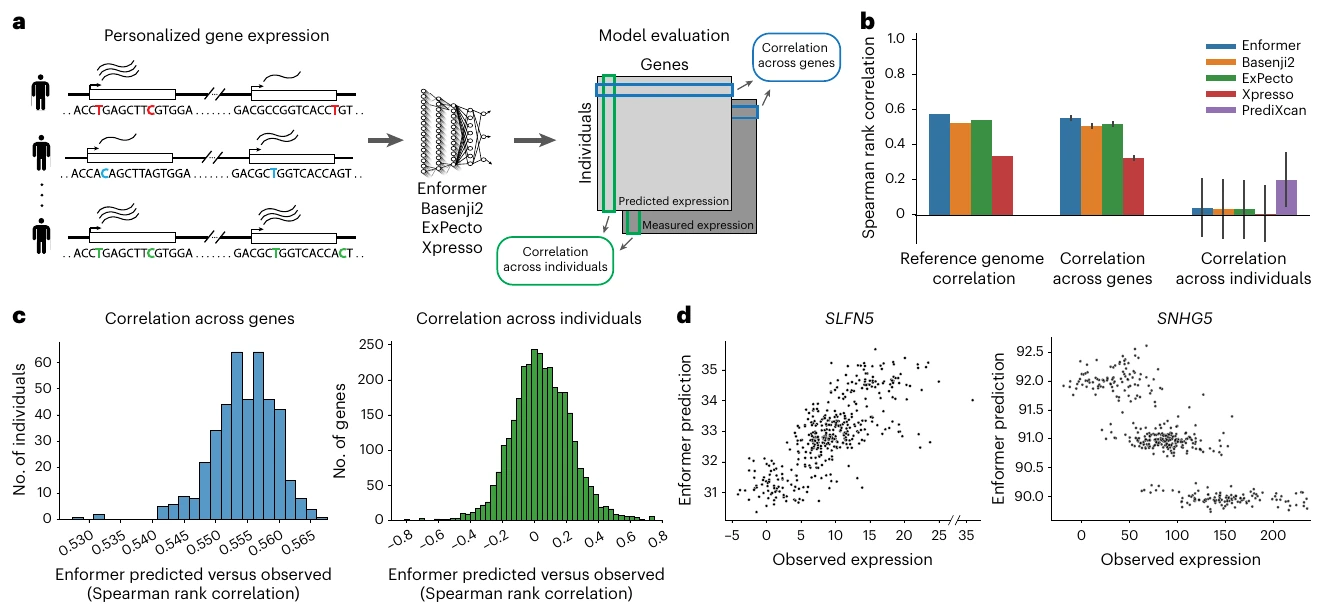
    <content type="html"><![CDATA[<!-- dl-literature-import:088 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Personal transcriptome variation is poorly explained by current genomic deep learning models</p><p><strong>期刊与年份：</strong> Nature Genetics，2023。<a href="https://doi.org/10.1038/s41588-023-01574-w">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 当前序列到表达模型的跨基因能力是否能够解释个人转录组变异？</p><h2 id="同一个问题，换队列与模型检验是否仍成立"><a href="#同一个问题，换队列与模型检验是否仍成立" class="headerlink" title="同一个问题，换队列与模型检验是否仍成立"></a>同一个问题，换队列与模型检验是否仍成立</h2><p>我对研究问题形成的推测是：序列到表达模型已经能解释参考基因组上不同基因的强弱，可这并不直接证明它读懂了个人遗传差异。作者选择有配对个人基因组和转录组的Geuvadis，把同一问题扩展到四个架构、不同输入范围和不同训练读数。这与ROSMAP皮层基准互补：若LCL中也出现相似落差，就不容易把失败仅归于老年脑组织或某一个模型。</p><p>本篇使用421位供体的分相WGS与淋巴母细胞系RNA，关注已具有显著cis-eQTL的3,259基因。每人两条单倍型分别替换SNV后输入，预测取平均，不包含indel。Enformer与Basenji2直接输出CAGE等多轨迹，ExPecto先预测染色质再线性映射到RNA，Xpresso是较短启动子上下文的CNN表达模型。它们都未以本文421人的个体表达重新训练，因而检验的是既有参考序列模型的迁移能力。</p><p>基准同时计算参考序列对跨基因中位表达、每人跨基因，以及每基因跨供体的相关。这样的设计把统计问题清楚分开。PrediXcan式弹性网在本文数据上按供体交叉验证训练，限制输入范围与Enformer相近，提供“这些DNA差异中至少有多少可预测信号”的对照；它不承担未见基因或任意新变异的泛化。论文不是新疾病分类网络，而是以任务对齐为核心的监督模型能力审计。</p><h2 id="Figure-1：跨基因与跨个体表达预测的落差"><a href="#Figure-1：跨基因与跨个体表达预测的落差" class="headerlink" title="Figure 1：跨基因与跨个体表达预测的落差"></a>Figure 1：跨基因与跨个体表达预测的落差</h2><p><a href="/img/dl-literature/088/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/088/figure-01.webp" alt="Figure 1" width="1325" height="610" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 2 页，Figure 1。点击图片可查看原图。</em></p><p>a用矩阵行列说明两个评估方向，是理解全部结果的前提。不同基因之间平均表达差距很大，模型只要学到启动子类别就可能获得良好跨基因相关；同一基因内供体差异较小，且由遗传、环境和测量混合影响，是另一项更细任务。b在相同队列比较四模型与线性基线，c展示相关分布，不只用均值遮住正负两端。跨个体均值接近零并不意味着每个基因都完全没有信号，但显著负向预测同样不能称“方向正确”。</p><p>d中的SLFN5与SNHG5分别展示成功与相反方向实例，避免只用成功案例替代总体基准。四个模型虽都含卷积，其训练RNA或CAGE读数、输入范围与输出汇总不同；读数匹配对照说明这些差异没有消除主要落差，却也不支持单凭绝对成绩归因某一个架构最差。图中误差线表示供体或基因集合上的分布，不是独立重复训练造成的不确定性，不能拿来当每个预测值的置信区间。</p><p>分析集合预先选择有显著eQTL的基因，相当于富集存在遗传表达信号的任务。因而即使在这样的有利集合表现有限，也构成有意义警示；但它不是全转录组任意基因的无偏总体平均。只把SNV纳入个人序列还意味着结构变异或indel贡献不在本次直接检验范围。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>同一人的不同基因对同一基因的不同个人评估，明确两种相关性回答不同问题。</td></tr><tr><td>b</td><td>四种深度模型的参考、跨基因、跨个体表现，以及PrediXcan个体预测，深度模型跨基因强但跨个体有限。</td></tr><tr><td>c</td><td>Enformer跨基因相关和跨个体相关分布，展示个体预测可接近零甚至为负。</td></tr><tr><td>d</td><td>SLFN5正相关与SNHG5负相关实例，说明不能只看相关绝对值判断变异效应正确。</td></tr></tbody></table><h2 id="Figure-2：模型之间及与实测的效应方向不一致"><a href="#Figure-2：模型之间及与实测的效应方向不一致" class="headerlink" title="Figure 2：模型之间及与实测的效应方向不一致"></a>Figure 2：模型之间及与实测的效应方向不一致</h2><p><a href="/img/dl-literature/088/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/088/figure-02.webp" alt="Figure 2" width="1326" height="922" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 2。点击图片可查看原图。</em></p><p>a按SNHG5主要eQTL剂量给个人点着色，并列四模型。三个模型给出与实测相反的趋势，Xpresso却为正，说明某个基因失败并不一定意味着它本身无法从序列预测。参考和替代等位的虚线又把个体预测压缩成具体遗传对照，但top eQTL可能与真正功能变异处于LD；这张图显示方向问题，并未逐一完成因果定位。</p><p>b看模型间逐基因相关，沿正对角与负对角都出现密集点。模型可能共同发现有遗传差异的基因，却对方向分歧。因此“多个模型都认为重要”可以帮助优先排序，却不能省略效应方向验证。平均模型只有轻微改善，也不表示再加入任意模型就能消除错误；相关模型的共享训练偏差可能一起保留。</p><p>c分别检查eQTL显著性、TSS距离、实际表达和预测变异幅度，排查失败是否只发生于弱遗传信号或低表达基因。强eQTL仍可能负相关，近端位点也有错误，意味着远程调控建模与方向正确是两个需要分别改进的问题。图里的趋势不足以证明失败源头完全是哪一个分子过程，作者将局部TF作用还是增强子到基因映射提出为后续可区分假说，而非已经确定结论。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>四模型对SNHG5的个人预测按主要eQTL剂量着色，三个模型方向与实测相反而Xpresso为正。</td></tr><tr><td>b</td><td>Enformer对其他模型的逐基因个体相关散点，既有同方向也有反方向模式，说明模型间并非一致。</td></tr><tr><td>c</td><td>Enformer相关与eQTL强度、TSS距离、实际表达及预测变异系数的四组关系，即使强eQTL基因也可能负相关。</td></tr></tbody></table><p>阅读说明：本篇正文仅Figure 1和Figure 2；全文出现的Extended Data Fig. 3&#x2F;4等不属于正文主图，候选自动提取中的3和4已排除。</p><h2 id="对我的研究：把错误分解到哪一层"><a href="#对我的研究：把错误分解到哪一层" class="headerlink" title="对我的研究：把错误分解到哪一层"></a>对我的研究：把错误分解到哪一层</h2><p>我会将这篇与ROSMAP基准并读，形成两步诊断。第一步，TE附近变异是否被模型预测为改变局部可及性或结合，而且方向被外部caQTL、等位数据或MPRA支持？第二步，这个局部变化是否能被正确映射到目标基因表达？若第一步好、第二步差，需要改进调控连线；若第一步也差，就不能只扩大远端上下文来解释失败。</p><p>这一分解可以转成纯计算课题：固定未见供体和未见基因组区域，分别比较TE与匹配非TE候选在局部效应方向和目标表达方向上的表现。匹配需包含家族、GC、距离、可及性及可比对性，且不应先看疾病关联再选最有利子集。结果若发现某类TE序列共享方向错误，可进一步以motif与上下文扰动定位计算失败来源；它首先是模型机制问题，只有经独立生物数据支持后才上升到AD调控机制。</p><p>公开Geuvadis可作为流程开发基准，但LCL中的规则不能原样称为脑细胞证据。论文按欧洲人群eQTL选基因，供体却覆盖欧洲及非洲背景；祖源、LD和细胞系状态可能影响泛化，迁移研究应分层核对。把同一供体的两个单倍型或相邻窗口随机切到训练与测试会泄漏个人与序列背景，不能用大批预测样本数掩盖只有数百独立供体的事实。</p><p>我的感悟是，基准论文的深度来自一个简单而必要的问题：模型的目标是否就是我们最终想解释的变化？对AD，我们也应区分遗传造成的风险、病理造成的表达改变，以及细胞比例变化。一个能够预测bulk表达的模型不一定解释病因，更不一定预测疾病进展；每跨一层都需要与该层对应的新证据。</p><p>关于研究资源，我会先下载作者公开的预测表与脚本复现评估，再选择少量基因做自己的前向推理，而不是一开始重复四模型全部大规模计算。核对TSS、链方向、参考组装和分相是第一步；Xpresso的非对称输入尤其需要按负链正确反向互补。公开结果可降低试验成本，但用于最终新模型评价时仍要明确哪些数据曾用于方法选择。</p><p>最后，方向错误并不能靠人为翻转所有负相关基因的模型输出来解决。那样已经使用实测表达挑选基因与符号，变成监督校准；若要提出校准方法，应在开发供体学习规则，在独立测试供体评估，并报告未见基因能否泛化。读者看到相关绝对值时需要知道其符号是否事后选择，这直接关系到模型有没有预测增减的实际能力。</p><p>另一个必要记录是每个基因实际可测表达的噪声上限，避免把不同读数可靠性的差别全归为模型失效。</p>]]></content>
    
    
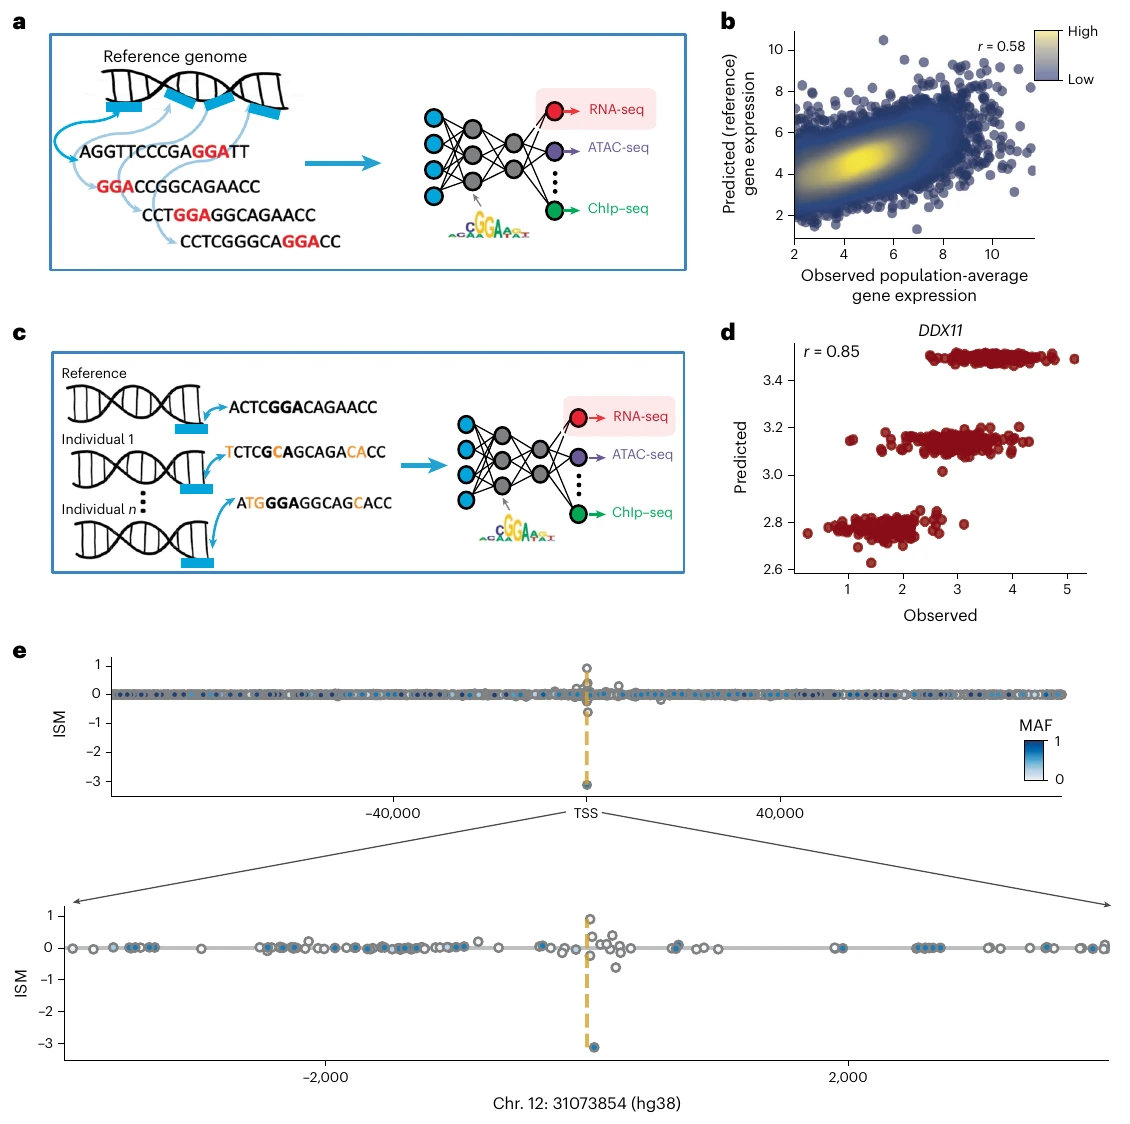
    <summary type="html">深入读懂PersonalTranscriptome-Huang：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="模型评估" scheme="https://perry.apay.eu.cc/tags/%E6%A8%A1%E5%9E%8B%E8%AF%84%E4%BC%B0/"/>
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="个人基因组" scheme="https://perry.apay.eu.cc/tags/%E4%B8%AA%E4%BA%BA%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="基因表达" scheme="https://perry.apay.eu.cc/tags/%E5%9F%BA%E5%9B%A0%E8%A1%A8%E8%BE%BE/"/>
    
  </entry>
  
  <entry>
    <title>87.PersonalExpressionBenchmark-Sasse：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920057/"/>
    <id>https://perry.apay.eu.cc/posts/ad920057/</id>
    <published>2026-10-04T12:01:27.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:087 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Benchmarking of deep neural networks for predicting personal gene expression from DNA sequence highlights shortcomings</p><p><strong>期刊与年份：</strong> Nature Genetics，2023。<a href="https://doi.org/10.1038/s41588-023-01524-6">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 参考基因组训练模型能否真正预测不同个人的表达差异及变异作用方向？</p><h2 id="从漂亮的跨基因预测里提出一个反问"><a href="#从漂亮的跨基因预测里提出一个反问" class="headerlink" title="从漂亮的跨基因预测里提出一个反问"></a>从漂亮的跨基因预测里提出一个反问</h2><p>我对研究思路形成的推测是：如果模型学到了调控逻辑，就应该能在固定基因处解释不同人的DNA为何造成表达差异；然而传统基准通常比较不同基因的平均表达。这两个任务看似都叫“预测表达”，实际变化来源完全不同。作者利用839位ROSMAP供体的配对WGS与皮层RNA，把测试单位从基因位置改成人。论文的贡献不是发布更大模型，而是设计直接挑战个体遗传解释能力的基准。</p><p>Enformer原本输入参考基因组附近长DNA，输出CAGE、ATAC等多种实验轨迹，利用基因组各位置之间的差异训练。本文将每位供体的两条分相序列分别输入，再平均表达预测。为适配皮层RNA-seq，作者还在预训练输出上训练弹性网映射，其标签来自GTEx的跨基因平均表达；这不是在839人WGS上微调整个Enformer。它可以改善读数匹配，却没有直接教网络同一位点的变异方向。</p><p>比较模型PrediXcan则用GTEx个体基因型与表达训练每个基因的弹性网。它只能处理训练中可用变异、缺乏任意新序列解释，却适合本项个体表达任务。这说明“泛用序列模型”与“针对个体变异模型”各有能力边界。基准范式是冻结已有模型、重新定义评估单位，再结合归因追查失败原因。数据来自AD研究队列，并不使这篇成为预测AD诊断或病理进展的模型；研究终点仍是个体间皮层表达。</p><h2 id="Figure-1：跨基因准确性不等于个人表达准确性"><a href="#Figure-1：跨基因准确性不等于个人表达准确性" class="headerlink" title="Figure 1：跨基因准确性不等于个人表达准确性"></a>Figure 1：跨基因准确性不等于个人表达准确性</h2><p><a href="/img/dl-literature/087/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/087/figure-01.webp" alt="Figure 1" width="1130" height="1124" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 2 页，Figure 1。点击图片可查看原图。</em></p><p>a与c是全篇最值得理解的对照：a比较不同基因组位置，c固定一个位置改变个体DNA。b中跨基因相关较高，可能反映网络能区分强与弱启动子等平均规律；它不能为c的个体变异任务提供直接保证。d以DDX11展示真实成功案例，839个点对应839人，说明模型在特定高遗传度位点确能捕获表达差异。e检查哪些变异驱动这一预测，并与精细定位的单个候选一致，把成功从散点关联推进到可解释遗传信号。</p><p>但DDX11不能代替全局评价。它的遗传度与较清晰单驱动结构有利于预测，选择这样的实例有助说明可能性，却不说明普遍性。e的ISM是在模型中改变一个碱基的输出差，不是实际编辑实验；“延伸抑制motif”仍是机制假说。两个等位序列取平均也默认一种汇总方式，未独立解决细胞组成、转录后加工、环境和疾病状态对bulk RNA的影响。</p><p>我认为这张图的教育作用在于先保留模型确实能做好的任务和位点，再提出更严格问题。它没有因为新的评估失败就否认参考基因组预测，而是要求每项能力在对应数据变化上被验证。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>参考基因组不同区域作为训练样本的示意，解释Enformer原任务。</td></tr><tr><td>b</td><td>ROSMAP皮层839人的平均表达对跨基因预测，检查传统总体性能。</td></tr><tr><td>c</td><td>固定一个位点、比较不同个人的评估示意，定义更直接的个体变异测试。</td></tr><tr><td>d</td><td>DDX11在839人中的预测对实际表达，提供个体层面实例。</td></tr><tr><td>e</td><td>DDX11附近个人SNV的ISM效应按等位频率着色，检查哪些变异主导表达预测。</td></tr></tbody></table><h2 id="Figure-2：个体间表达预测的方向与驱动变异"><a href="#Figure-2：个体间表达预测的方向与驱动变异" class="headerlink" title="Figure 2：个体间表达预测的方向与驱动变异"></a>Figure 2：个体间表达预测的方向与驱动变异</h2><p><a href="/img/dl-literature/087/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/087/figure-02.webp" alt="Figure 2" width="1325" height="835" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 2。点击图片可查看原图。</em></p><p>a将6,825基因逐个按人与人之间相关评价：平均相关约0.01，显著基因中有195个方向相反。显著负相关意味着模型输出稳定地沿错误方向变化，不是“也有预测能力，所以可以忽略符号”。b的GSTM3是这种失败的直观实例。c与个人遗传数据训练的PrediXcan对照，表明简单模型在合适任务上可以优于大型序列网络；比较集合受PrediXcan可用基因限制，不能把这一结果扩展为所有新变异或所有组织任务的排序。</p><p>d、e追踪方向错误。ISM与输入梯度先近似个人表达预测，再定位少数主驱动SNV；多数基因只由几个变异支配模型差异，错误方向因此可以传递到全基因表达。这里“驱动”严格指驱动模型输出，不自动指生物因果变异。与边际eQTL方向不一致是警示证据，边际eQTL本身受LD影响；反过来，边际效应很大的位点却没有模型效应，也不能单凭这一点判断网络错了。理想核对仍需精细定位或独立扰动。</p><p>f显示许多模型驱动靠近TSS。这提示长输入不等于学会使用远端调控，motif语法也可能未被充分学习。作者没有发现一种简单统一的错误motif，因此不能归纳成“模型把某一个TF全部读反”。敏感性分析涉及输出映射、移位与正反链平均、因果候选子集，降低了仅因轨迹选择或输入对齐出现结论的可能。研究给出了失败现象及证据链，而关于新的训练数据能否彻底解决，仍是后续待测假说。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>6825个基因的个体间相关对统计显著性，检查高平均表达预测是否转化为真实个体差异。</td></tr><tr><td>b</td><td>GSTM3个人表达预测对实测，展示可出现方向错误的强关联实例。</td></tr><tr><td>c</td><td>逐基因Enformer与PrediXcan相关比较，检验通用序列模型对个体训练线性模型的差异。</td></tr><tr><td>d</td><td>GSTM3所有SNV的ISM对eQTL效应，标出驱动SNV并检验符号一致性，解释错误方向来源。</td></tr><tr><td>e</td><td>支持方向的驱动SNV比例对模型个体间相关，连接逐变异错误与整基因表达错误。</td></tr><tr><td>f</td><td>正／负相关基因驱动SNV在TSS附近的数量与位置，检查模型的驱动定位偏好。</td></tr></tbody></table><h2 id="我对AD与TE模型的直接启发"><a href="#我对AD与TE模型的直接启发" class="headerlink" title="我对AD与TE模型的直接启发"></a>我对AD与TE模型的直接启发</h2><p>若想研究AD中TE附近WGS变异，这篇提醒我先确定最终问题是什么。预测一个TE所在峰比另一个峰更开放，与预测同一TE副本在不同供体中因等位差异而更开放，是两个任务。前者高相关不能替后者背书；更不能再跨一步宣称模型揭示病理进展。我们应同时报告跨位点性能、同位点跨供体性能，以及变异方向是否正确。</p><p>一个可执行的纯计算设计是冻结现有序列模型，对脑相关公共队列的候选位点比较个人等位预测与实际供体表达或可及性。只在有足够遗传变异和测量可靠性的位点做方向评估，并用匹配非TE背景、线性基因型模型和简单序列模型作基线。若数据权限尚未获得，不能把ROSMAP文件名或摘要中的人数当已经拥有的训练样本。外部MPRA可以核对局部方向，但其报告体系与内源个体表达仍需区分。</p><p>这篇也让我调整“创新”的标准：严谨揭示当前模型在一个生物学必要任务中的失效，本身可以形成重要研究；不一定要先堆更大模型。一个小网络若经过供体与基因组区域双重留出，在TE变异方向上稳定改善，并能解释改善来自何种上下文，比只在随机切分上提高几个百分点更有价值。</p><p>无监督路线同样要面对这个检验。发现TE调控模块后，应先锁定模块和特征，再在未参与训练的供体或独立队列中检验病理关联；不能利用AD标签反复选择潜空间，随后仍称疾病信号“完全无监督发现”。模块可能主要编码细胞组成、批次或参考序列规律，这些解释需要作为明确对照排查。论文没有证明无监督一定更好，它要求的是目标、划分和结论对齐。</p><p>在评估设计上，疾病队列里的bulk表达还会混入细胞组成与病理相关变化；基因型模型不应被要求解释所有非遗传方差，但也不能用这个理由忽略方向错误。应先以有可靠cis遗传度或精细定位信号的基因建立正对照，再分别检查神经元、胶质细胞和整体组织背景。遗传度估计与模型参数调优也应限于开发数据，最终测试只做一次锁定评价。这样才能分清数据没有足够遗传信号，还是模型把已有信号读错。变异方向的检验还应事先规定等位编码，避免正负号由参考／替代定义互换而产生假错误。</p>]]></content>
    
    
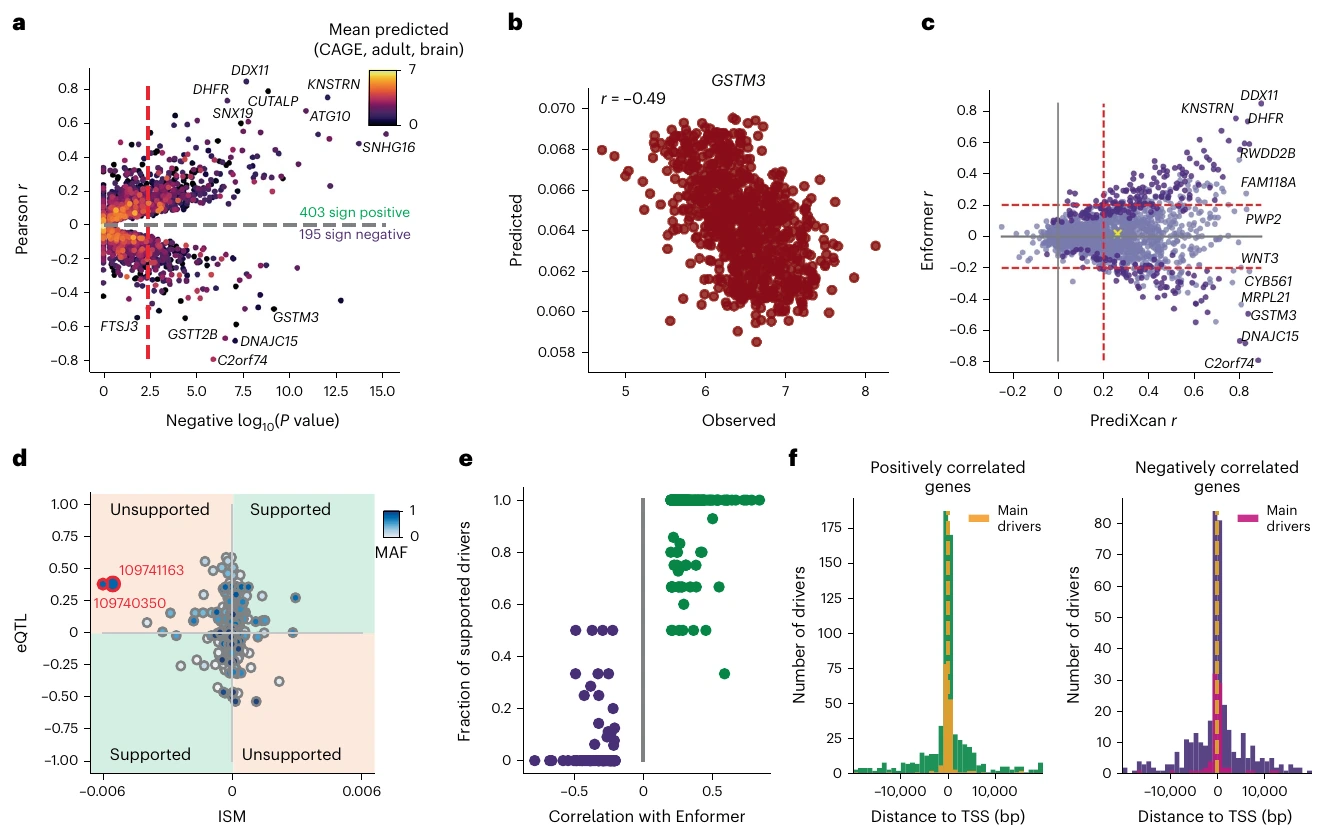
    <summary type="html">深入读懂PersonalExpressionBenchmark-Sasse：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="模型评估" scheme="https://perry.apay.eu.cc/tags/%E6%A8%A1%E5%9E%8B%E8%AF%84%E4%BC%B0/"/>
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="个人基因组" scheme="https://perry.apay.eu.cc/tags/%E4%B8%AA%E4%BA%BA%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="基因表达" scheme="https://perry.apay.eu.cc/tags/%E5%9F%BA%E5%9B%A0%E8%A1%A8%E8%BE%BE/"/>
    
  </entry>
  
  <entry>
    <title>86.inDelphi：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920056/"/>
    <id>https://perry.apay.eu.cc/posts/ad920056/</id>
    <published>2026-10-04T12:01:26.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
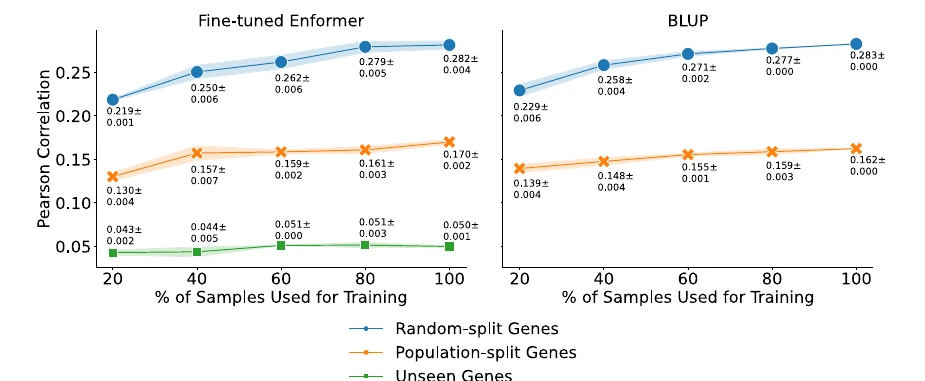
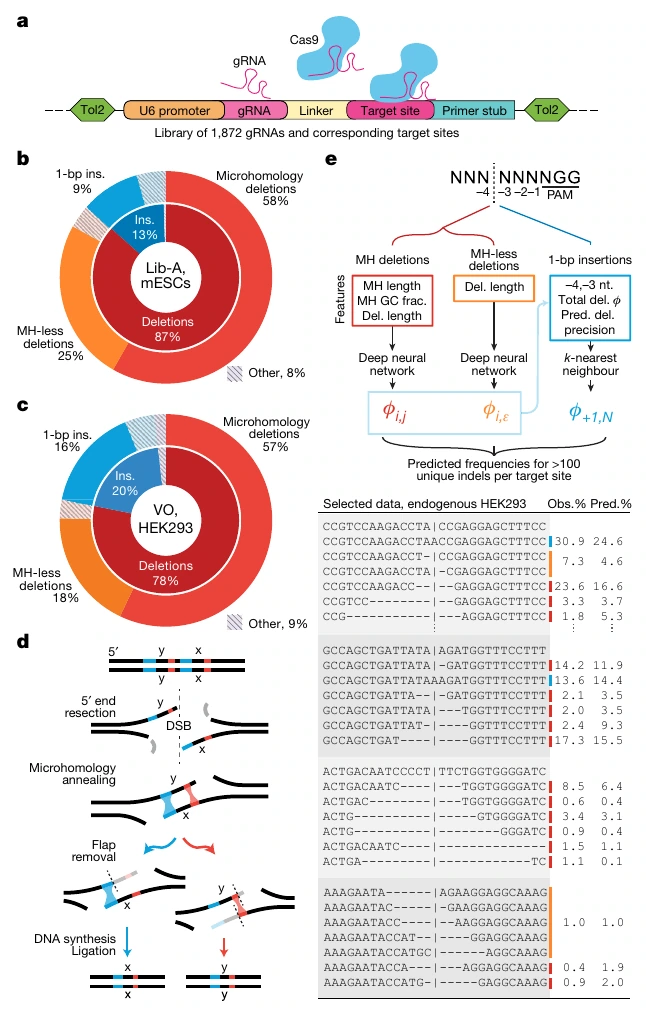
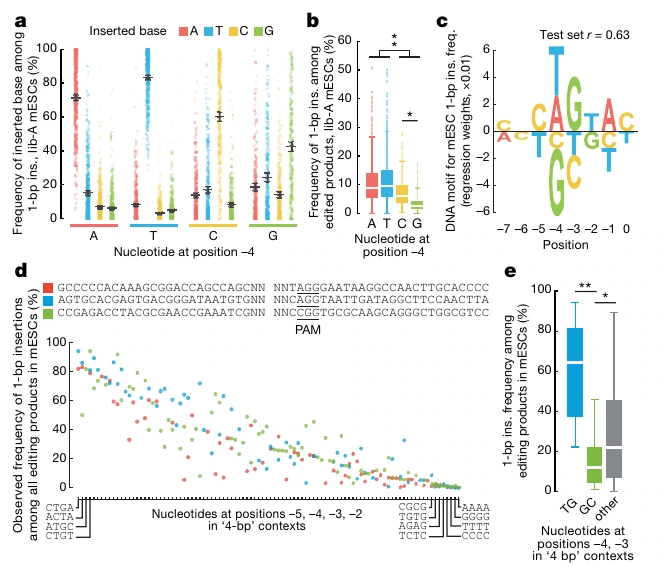
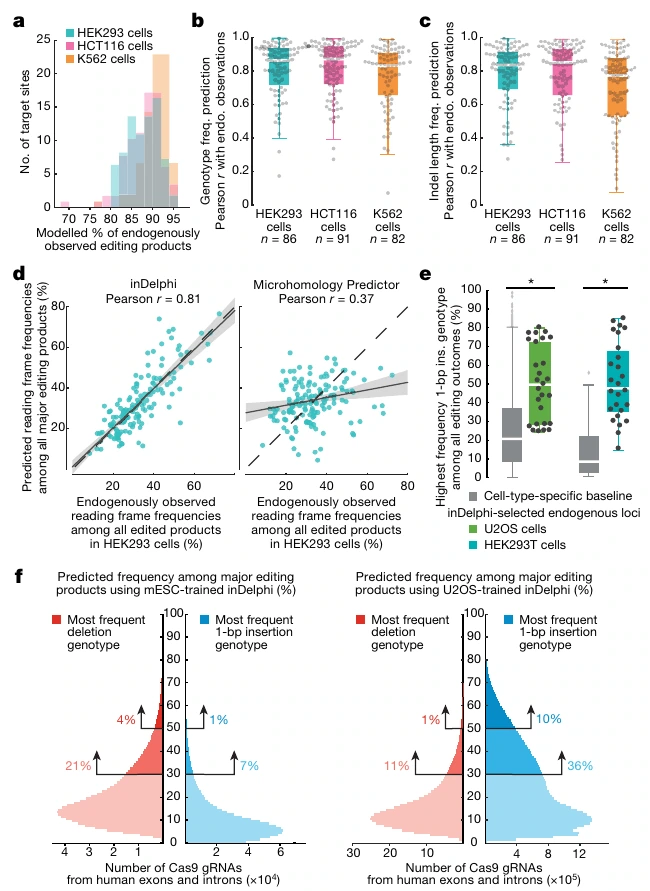
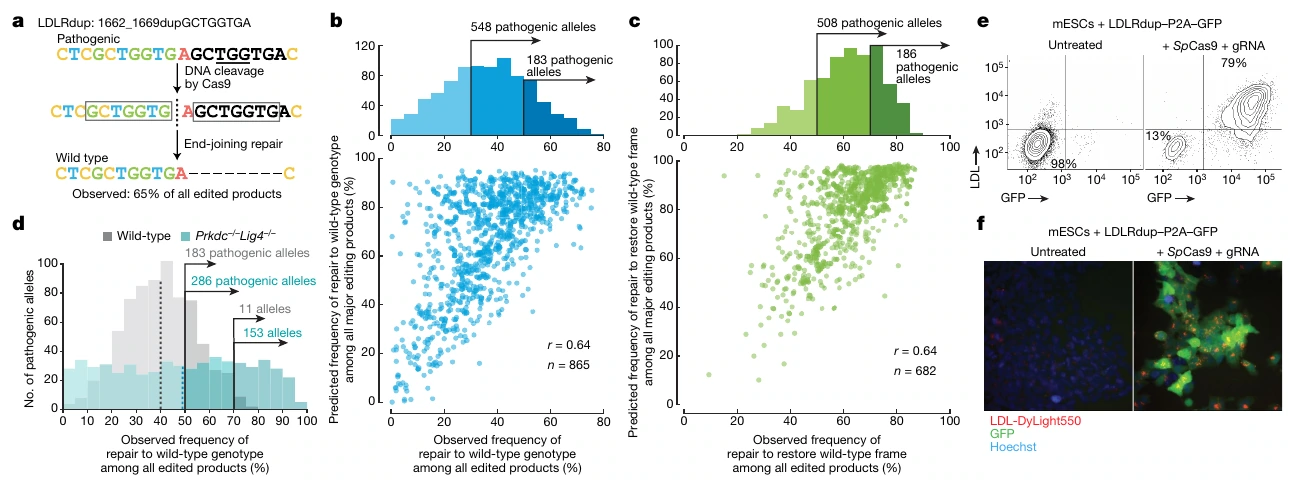
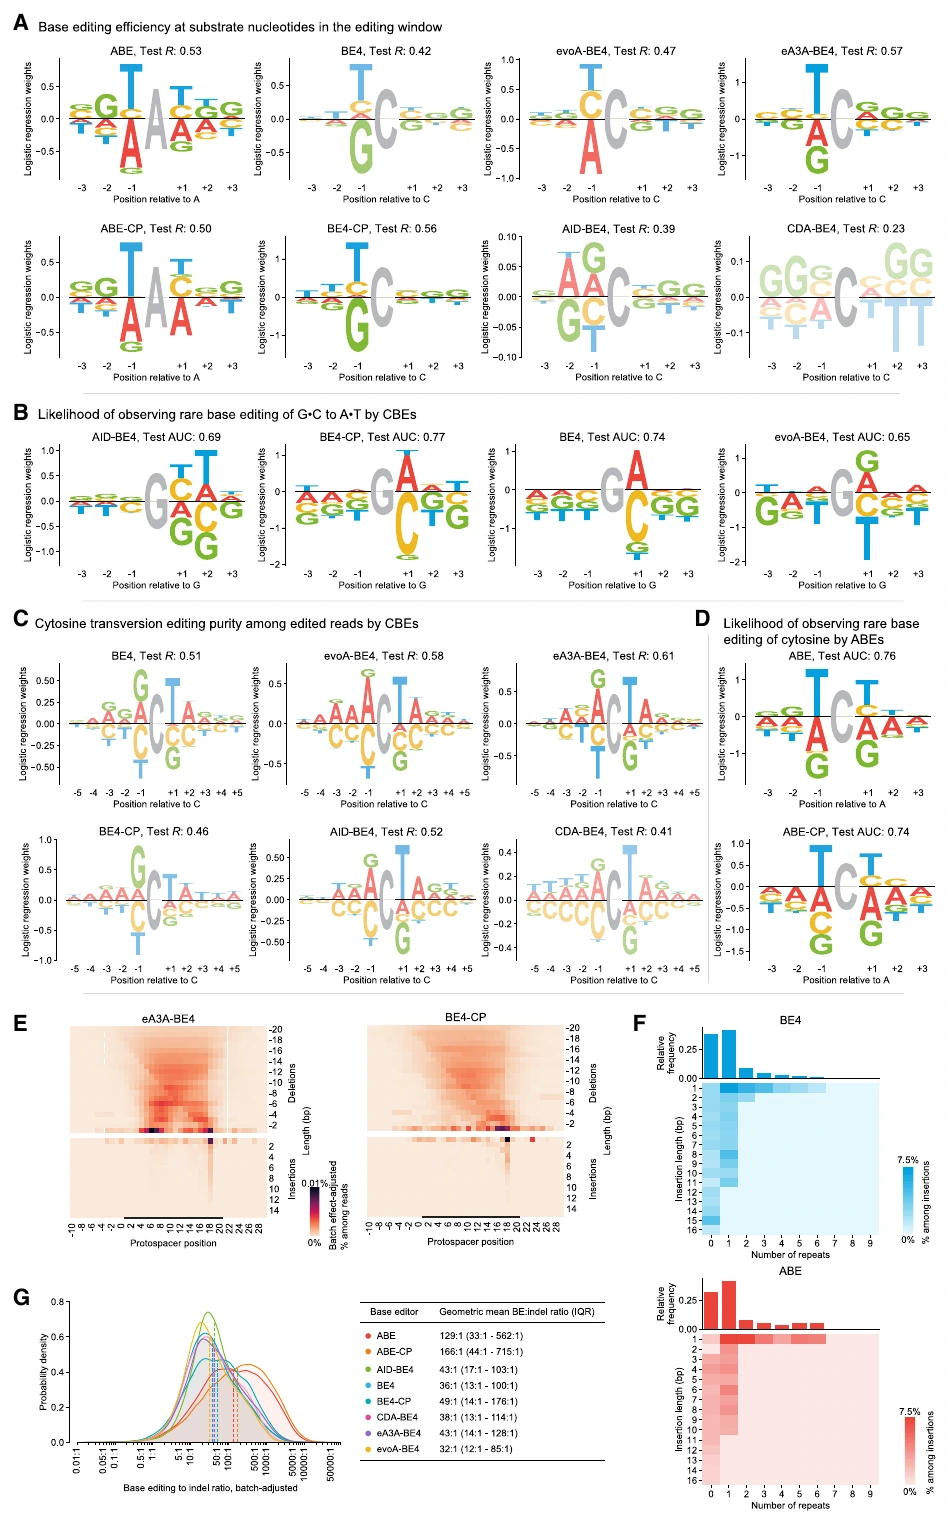
    <content type="html"><![CDATA[<!-- dl-literature-import:086 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Predictable and precise template-free CRISPR editing of pathogenic variants</p><p><strong>期刊与年份：</strong> Nature，2018。<a href="https://doi.org/10.1038/s41586-018-0686-x">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 无模板Cas9修复结果能否准确预测，并用于精确纠正致病变异？</p><h2 id="从“修复很随机”转向“预测分布是否偏向一个结果”"><a href="#从“修复很随机”转向“预测分布是否偏向一个结果”" class="headerlink" title="从“修复很随机”转向“预测分布是否偏向一个结果”"></a>从“修复很随机”转向“预测分布是否偏向一个结果”</h2><p>我的推测是，这篇的突破来自改变问题表述：Cas9后出现许多产物，并不意味着每种产物的概率不可预测；如果某段序列使一个修复结果占优势，就可以选择这段序列做精确编辑。作者因此没有要求神经网络把所有细胞变成同一结果，而是预测修复产物分布，并寻找天然序列所支持的高精确候选。疾病相关的微重复恰好为这种思路提供用途：删除额外重复的一份，可能恢复参考序列而不需要外加模板。</p><p>inDelphi是机制约束的混合模型。它列举微同源介导的候选删除，用微同源长度、GC与删除长度学习评分，再将竞争候选归一化；无微同源删除用另一神经模块按长度建模。单碱基插入则由k近邻模块结合切口碱基及删除倾向预测。神经网络并没有替代全部生物学流程，输出也不是任意长度、任意结构变异，而是主要切口附近+1至−60 bp产物。无微同源删除部分首先预测长度集合，不等于完全确定每一种位置的基因型。</p><p>监督来自整合sgRNA—靶序列文库的真实测序，删除模块联合学习删除长度与微同源基因型频率，插入与删除按竞争比例结合。局部序列决定相对偏好，细胞背景还影响总体插入／删除比例。研究范式是机制分解的监督预测加候选设计验证，与仅从motif推断修复结果的规则工具不同；也不是无监督模型。其问题意识值得借鉴：先定义可预测的局部任务，明确哪些复杂事件在任务范围外。</p><h2 id="Figure-1：DNA修复数据支持inDelphi设计"><a href="#Figure-1：DNA修复数据支持inDelphi设计" class="headerlink" title="Figure 1：DNA修复数据支持inDelphi设计"></a>Figure 1：DNA修复数据支持inDelphi设计</h2><p><a href="/img/dl-literature/086/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/086/figure-01.webp" alt="Figure 1" width="646" height="1014" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 2 页，Figure 1。点击图片可查看原图。</em></p><p>a把设计靶序列与对应向导绑定，提供可系统变化的训练实验。b与c比较文库和真实内源位点的修复组成，检验人为短序列背景是否仍覆盖主要事件。它们相近支持文库用途，却不能保证所有内源长程染色质和细胞状态均被保留。d的微同源修复过程解释为何模型列举候选并计算相对竞争，而不是只给每个motif独立分数。e将这一机制落实成三模块及可核对的产物表。</p><p>这里最值得读透的是“模型覆盖率”和“预测精度”必须分开。主要插缺覆盖多数测到事件，仍留下长插入、复杂事件和更大重排；即便范围内预测很准，也不能据此声称一次编辑所有风险都可预测。文库长度与测序方法共同限定了可见事件，超出窗口的损伤不会因为模型没列出就不存在。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>整合向导—靶序列文库测量Cas9修复产物，定义大规模训练实验。</td></tr><tr><td>b</td><td>小鼠胚胎干细胞文库产物的微同源删除、无微同源删除和插入比例，描述修复组成。</td></tr><tr><td>c</td><td>HEK293内源位点的对应组成，检验文库是否代表真实基因组。</td></tr><tr><td>d</td><td>微同源末端连接的切除、退火、去瓣和连接过程，解释删除的序列决定因素。</td></tr><tr><td>e</td><td>模型依据微同源、长度、GC和切口附近碱基预测每种+1到−60插缺频率，说明它预测分布而非单一结果。</td></tr></tbody></table><h2 id="Figure-2：单碱基插入的上下文规则"><a href="#Figure-2：单碱基插入的上下文规则" class="headerlink" title="Figure 2：单碱基插入的上下文规则"></a>Figure 2：单碱基插入的上下文规则</h2><p><a href="/img/dl-literature/086/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/086/figure-02.webp" alt="Figure 2" width="663" height="567" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 2。点击图片可查看原图。</em></p><p>a、b分别检验插入碱基是什么与插入发生多少，两者并非同一变量。经常复制PAM前−4位置的碱基提供局部模板线索，A或T背景还偏向较高插入频率。c以简单回归展示位置规律，目的是解释而非代替最终模型。d、e在几个固定低微同源背景中系统改变切口附近碱基，比全基因组统计关联更接近序列干预证据：其余背景保持，产物比例随局部变化而变。</p><p>但这种实验只覆盖特定短背景，不能把某个双碱基组合变成在任何染色质环境都成立的硬规则。低微同源条件也降低了删除竞争，所见插入高比例应连同背景一起解释。我认为这张图说明，合理的实验设计可以让小模型学到可验证的规律；数据变化的方式往往比网络深度更关键。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>插入碱基身份对PAM前第−4位碱基的关系，说明插入常复制局部序列信息。</td></tr><tr><td>b</td><td>不同−4位碱基的单碱基插入频率，检验碱基环境影响。</td></tr><tr><td>c</td><td>预测插入频率的序列logo，定位重要上下文碱基。</td></tr><tr><td>d</td><td>低微同源背景中系统改变−5到−2位的插入频率，直接验证邻近序列作用。</td></tr><tr><td>e</td><td>变化−4／−3位后的频率比较，检查特定双碱基组合规律。</td></tr></tbody></table><h2 id="Figure-3：内源编辑结果预测与高精确位点选择"><a href="#Figure-3：内源编辑结果预测与高精确位点选择" class="headerlink" title="Figure 3：内源编辑结果预测与高精确位点选择"></a>Figure 3：内源编辑结果预测与高精确位点选择</h2><p><a href="/img/dl-literature/086/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/086/figure-03.webp" alt="Figure 3" width="650" height="891" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 3。点击图片可查看原图。</em></p><p>a先量化内源事件是否落在模型输出空间，b再看基因型，c看长度，d看阅读框。这种由细到粗的评估避免只报一个总相关。预测长度准确不自动意味着恢复了完整参考序列；保持阅读框也不自动保证蛋白功能。d与已有微同源工具比较说明纳入插入与其他删除的重要性，e则验证模型选中的高插入位点优于背景，真正回答工具是否改善实验选择。</p><p>f的全基因组“precision-50”比例是基于模型与特定细胞背景的推算，并不是把全基因组所有位点逐个实验后的成功率。precision分母是主要编辑产物，没有纳入未编辑DNA和任务范围外事件。对疾病候选来说，它适合先筛选，再以实际位点测序确认；不能把这一分数直接称为治疗效率。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>HEK293、HCT116、K562中模型覆盖的修复产物比例，检验主要结果是否包含在任务内。</td></tr><tr><td>b</td><td>各位点具体基因型频率的预测相关，中位数约0.83–0.87，验证分布精度。</td></tr><tr><td>c</td><td>插缺长度频率相关，中位数约0.79–0.85，检验较粗粒度结果。</td></tr><tr><td>d</td><td>阅读框频率预测对实测，inDelphi较仅微同源方法更一致。</td></tr><tr><td>e</td><td>模型选择高单碱基插入位点在U2OS和HEK293T的实测频率超过对应基线，验证设计用途。</td></tr><tr><td>f</td><td>全人基因组向导最常见插入／删除的预测频率分布，估计可获得高单一产物精确度的位点数量。</td></tr></tbody></table><h2 id="Figure-4：无模板精确纠正致病变异"><a href="#Figure-4：无模板精确纠正致病变异" class="headerlink" title="Figure 4：无模板精确纠正致病变异"></a>Figure 4：无模板精确纠正致病变异</h2><p><a href="/img/dl-literature/086/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/086/figure-04.webp" alt="Figure 4" width="1296" height="485" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 5 页，Figure 4。点击图片可查看原图。</em></p><p>a利用重复序列给修复提供可恢复参考的删除路径；b比较精确基因型恢复，c比较阅读框恢复，明确两种终点。d通过修复基因缺失或抑制相关通路改变结果分配，为不同末端修复路径竞争提供干预支持，但在实验细胞提高精确度不等于在患者中同样操作已经安全。e、f进一步检查LDLR相关报告细胞的GFP与LDL摄取，使证据从序列正确推进到功能恢复。</p><p>LDLR功能实验使用导入的全长构建，不能与所有疾病位点的文库纠正混为相同强度。论文还在HPS1与ATP7A患者来源成纤维细胞内源位点得到序列纠正，这比合成文库更接近实际疾病背景，但并未成为全身疾病治疗或长期临床效果证据。每一个层次都各有意义；把它们分开反而能看出作者怎样逐步提高验证难度。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>LDLR重复变异通过Cas9末端修复回到野生型序列，示例实测为编辑产物中的65%。</td></tr><tr><td>b</td><td>致病等位序列预测／实测野生型基因型纠正频率，检验精确序列恢复。</td></tr><tr><td>c</td><td>野生型阅读框恢复频率预测／实测，区分恢复框架与恢复完整序列。</td></tr><tr><td>d</td><td>模型预测纠正≥50%的位点在不同修复基因背景的实测频率，检验高精确候选。</td></tr><tr><td>e</td><td>LDLR重复报告细胞编辑前后的流式GFP与LDL摄取，检查修复是否恢复功能。</td></tr><tr><td>f</td><td>对应显微荧光图，验证功能恢复；频率主要以已编辑产物为分母，不能直接理解为全部细胞的纠正率。</td></tr></tbody></table><h2 id="我会学它的机制分解，不把局部可预测误当全局可控制"><a href="#我会学它的机制分解，不把局部可预测误当全局可控制" class="headerlink" title="我会学它的机制分解，不把局部可预测误当全局可控制"></a>我会学它的机制分解，不把局部可预测误当全局可控制</h2><p>对AD的TE研究，可以借鉴“列举有生物学意义的候选状态，再学习竞争概率”。例如在同一家族TE副本中，先定义与调控相关的motif组合和细胞状态，再判断哪些背景影响其相对使用，而不是给所有重复片段一个泛化的异常分数。这需要明确可观察标签和独立验证；不能从TE序列有微同源就推断它导致AD。</p><p>更直接的用途在后续内源验证：如果要删去TE片段或修改附近候选变异，必须预先考虑真实修复产物分布。名义上的“删除一个元件”可能产生许多基因型，若只测向导丰度，不测实际产物，就容易把混合结果写成一个干净的因果干预。对大片段TE删除，这篇+1至−60 bp的模型范围尤其不足，需另行验证结构事件。</p><p>它也提供一个可在普通显存上工作的创新方向：用小网络结合机制特征建立一个狭窄而清楚的问题，并把新增数据用来挑战预测。真正有说服力的创新不一定是参数规模增长，而可以是把过去以为随机的现象变成可预注册、可复现的定量问题。原文实验未随机化或盲法，患者来源验证样本有限；这些局限不会抹去结果，但应保留在解释边界中，避免将方法研究写成普遍可用的治疗方案。</p><p>模型输出的是实验测得分布的近似，重复同一位点测序增加读深不会增加独立靶点数量。因此评估泛化时应留出靶点或序列背景，并把技术读段数、细胞数和独立实验次数分开报告。</p>]]></content>
    
    
    <summary type="html">深入读懂inDelphi：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="CRISPR" scheme="https://perry.apay.eu.cc/tags/CRISPR/"/>
    
    <category term="基因编辑" scheme="https://perry.apay.eu.cc/tags/%E5%9F%BA%E5%9B%A0%E7%BC%96%E8%BE%91/"/>
    
  </entry>
  
  <entry>
    <title>85.BE-Hive：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920055/"/>
    <id>https://perry.apay.eu.cc/posts/ad920055/</id>
    <published>2026-10-04T12:01:25.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
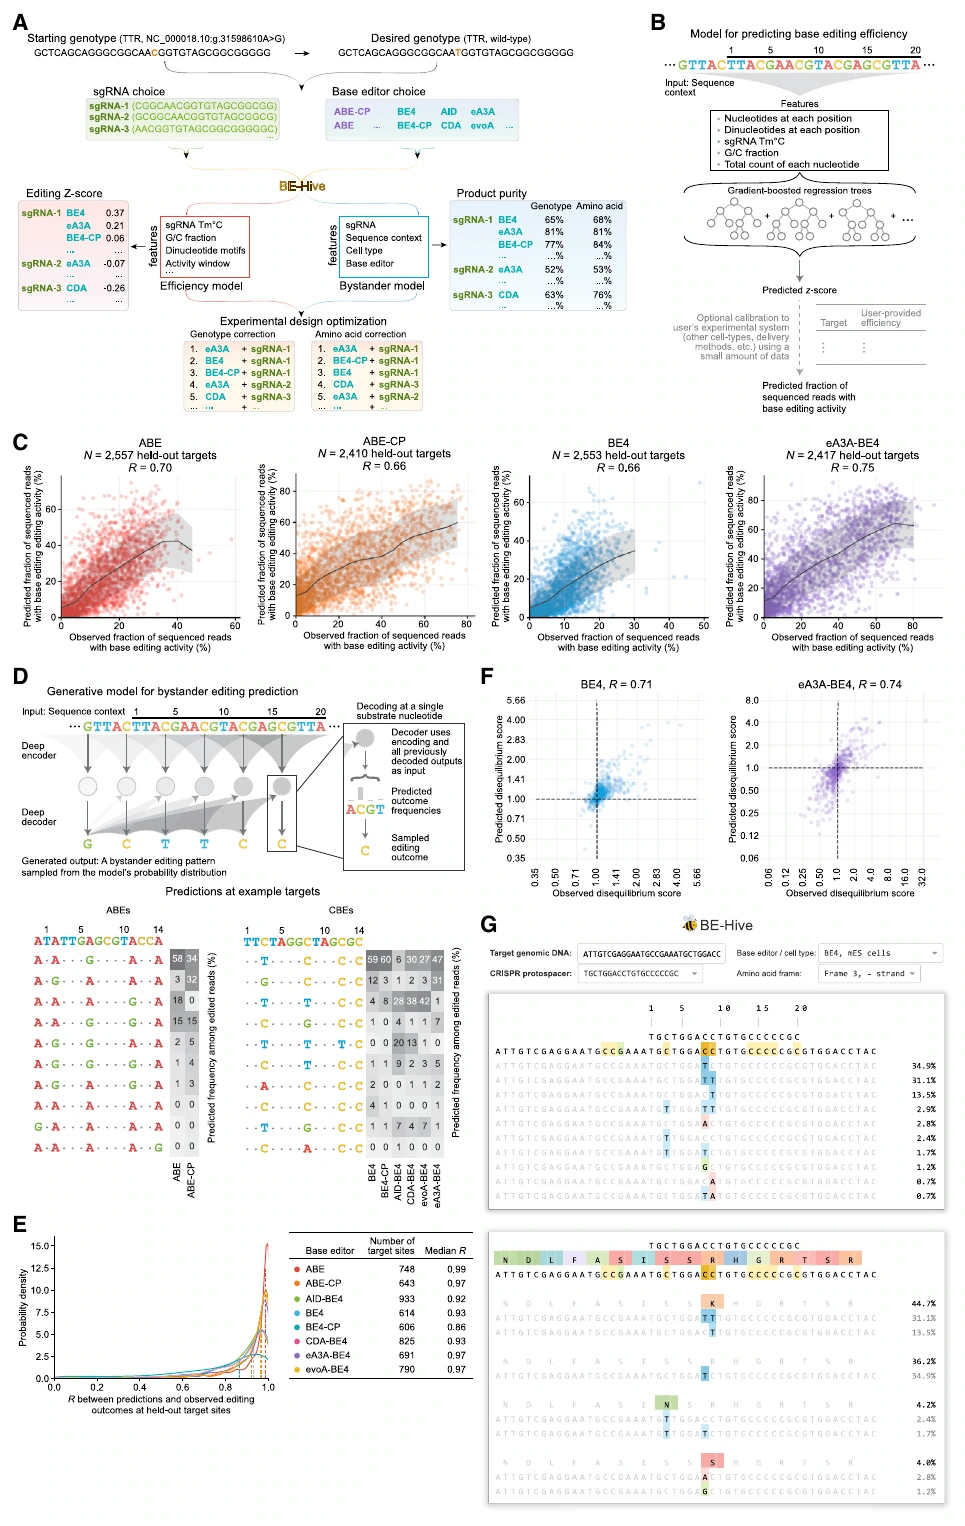
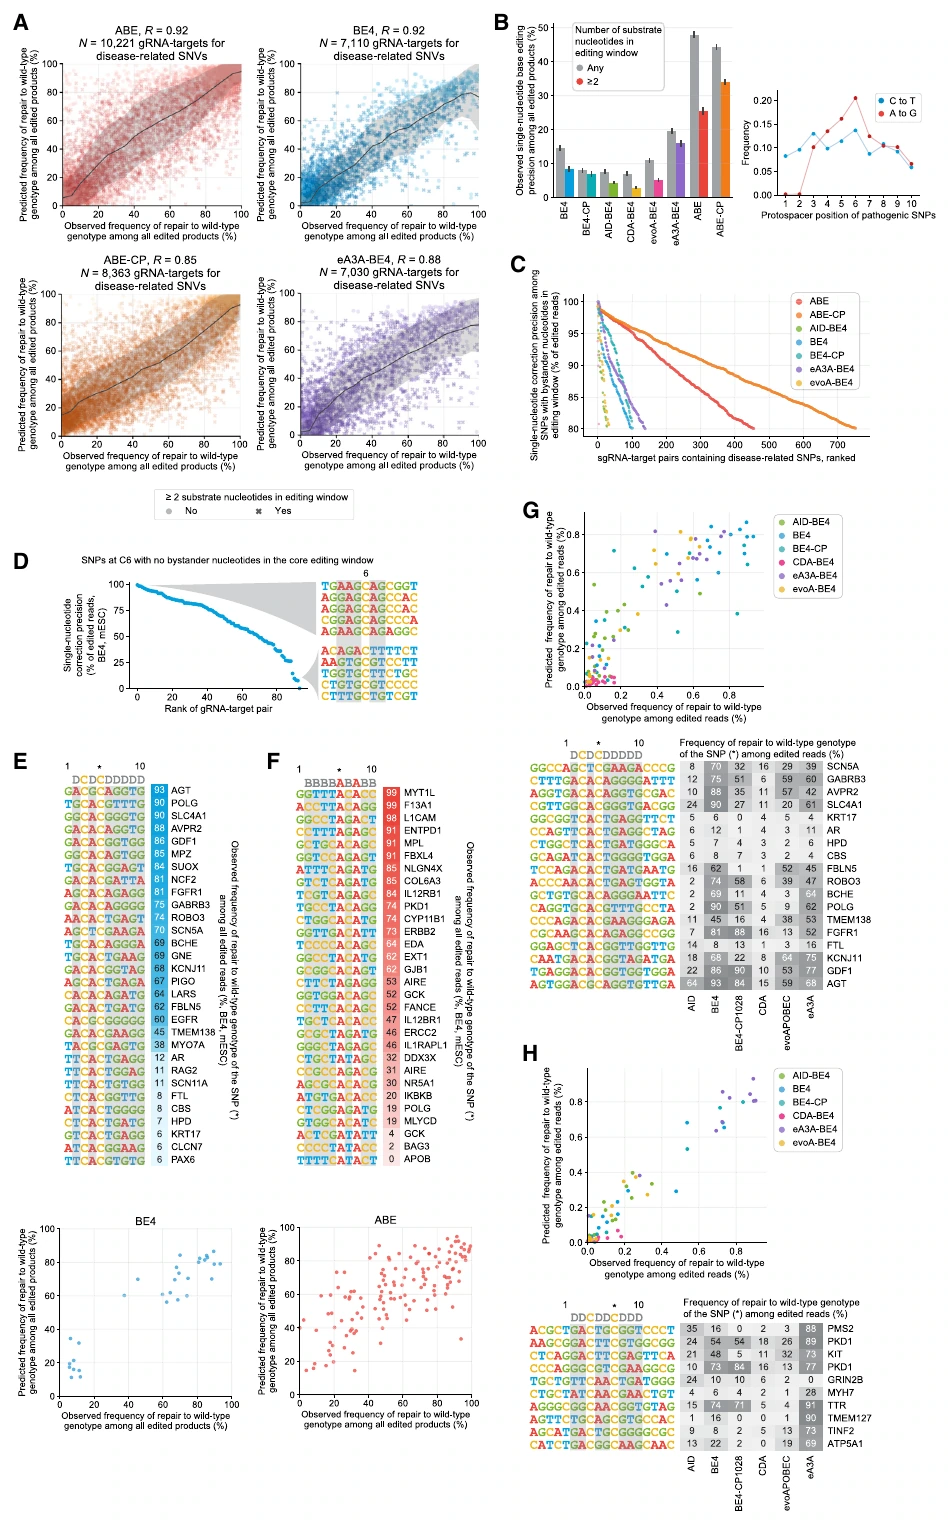
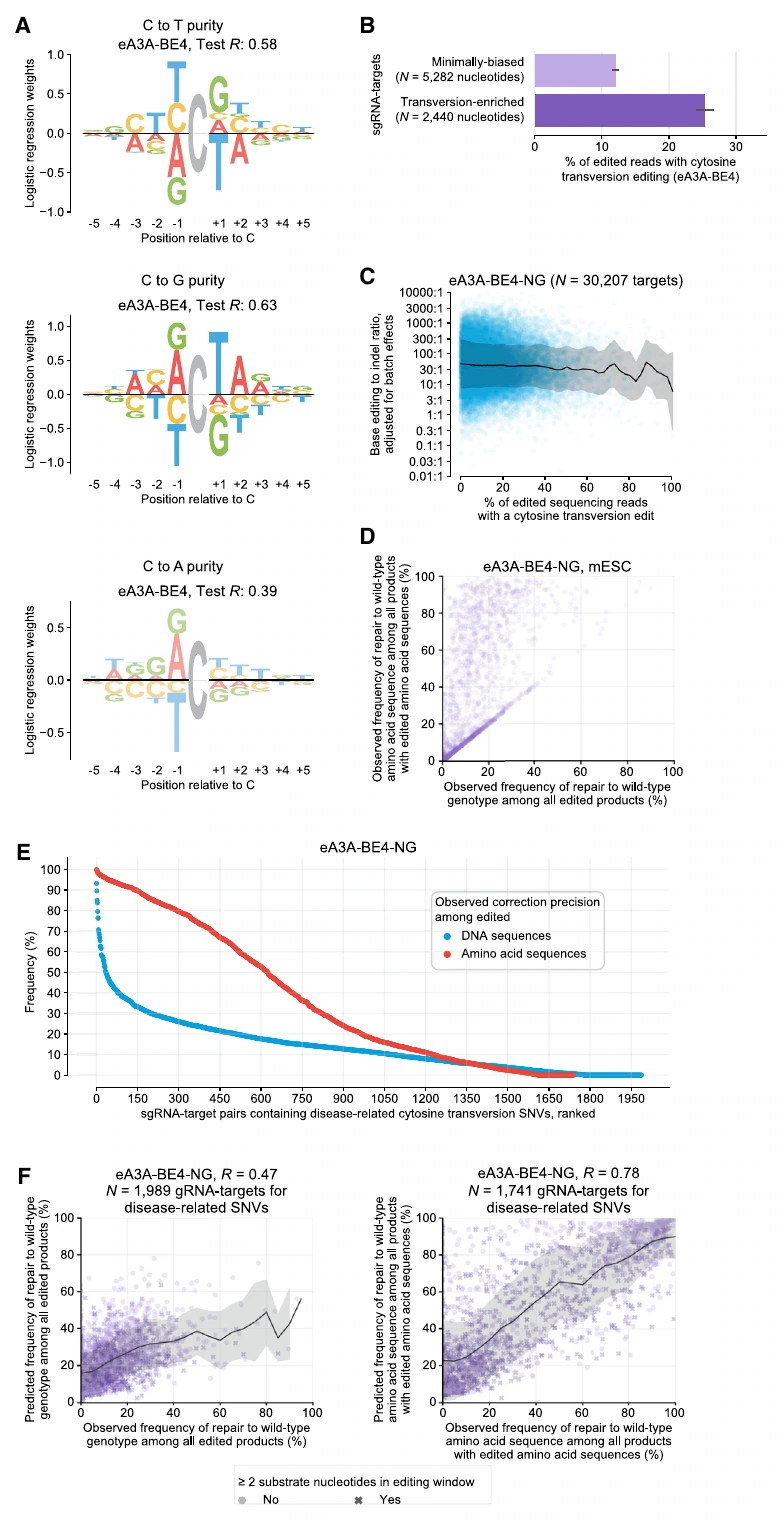
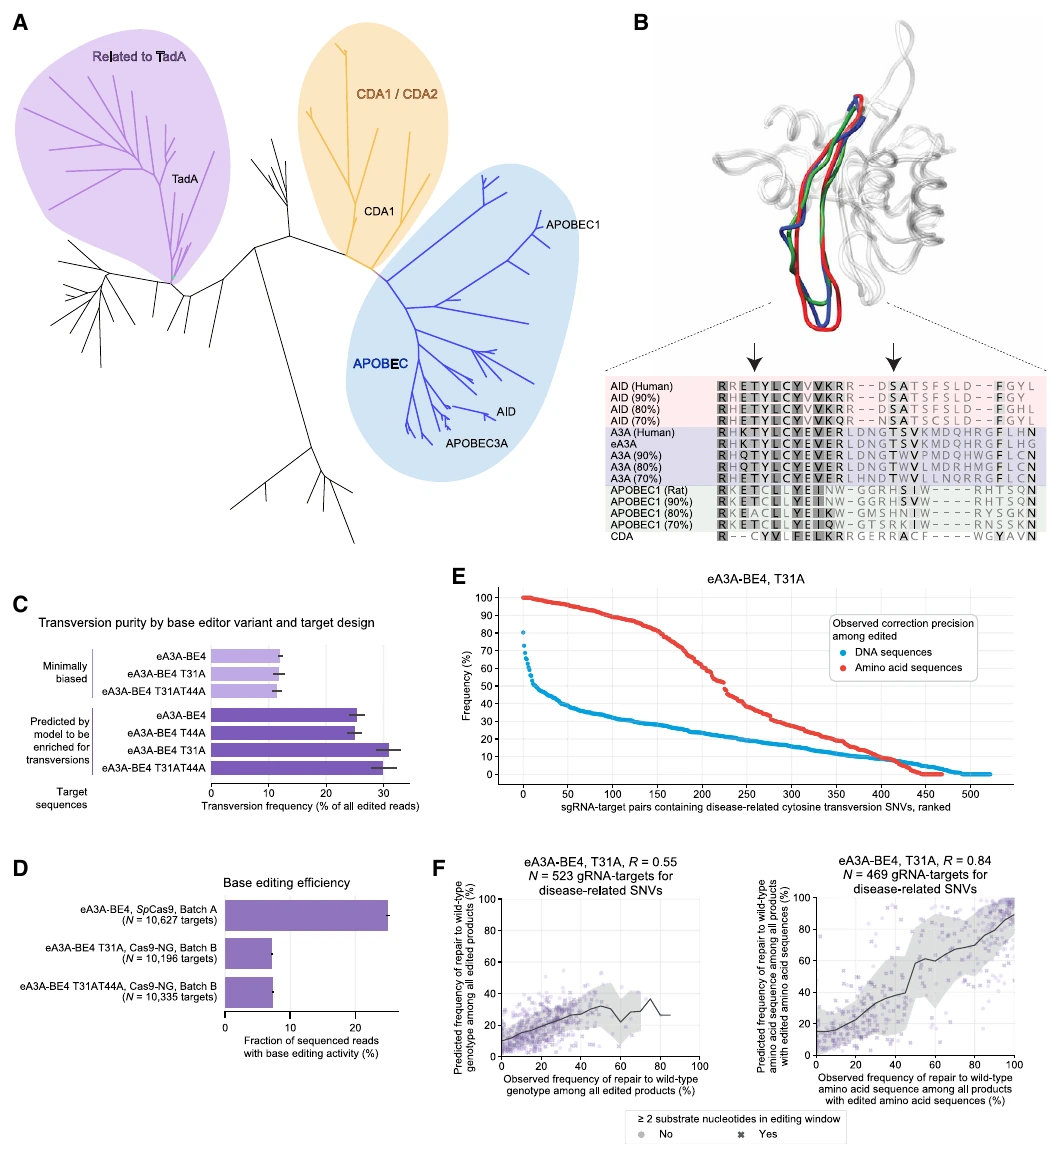
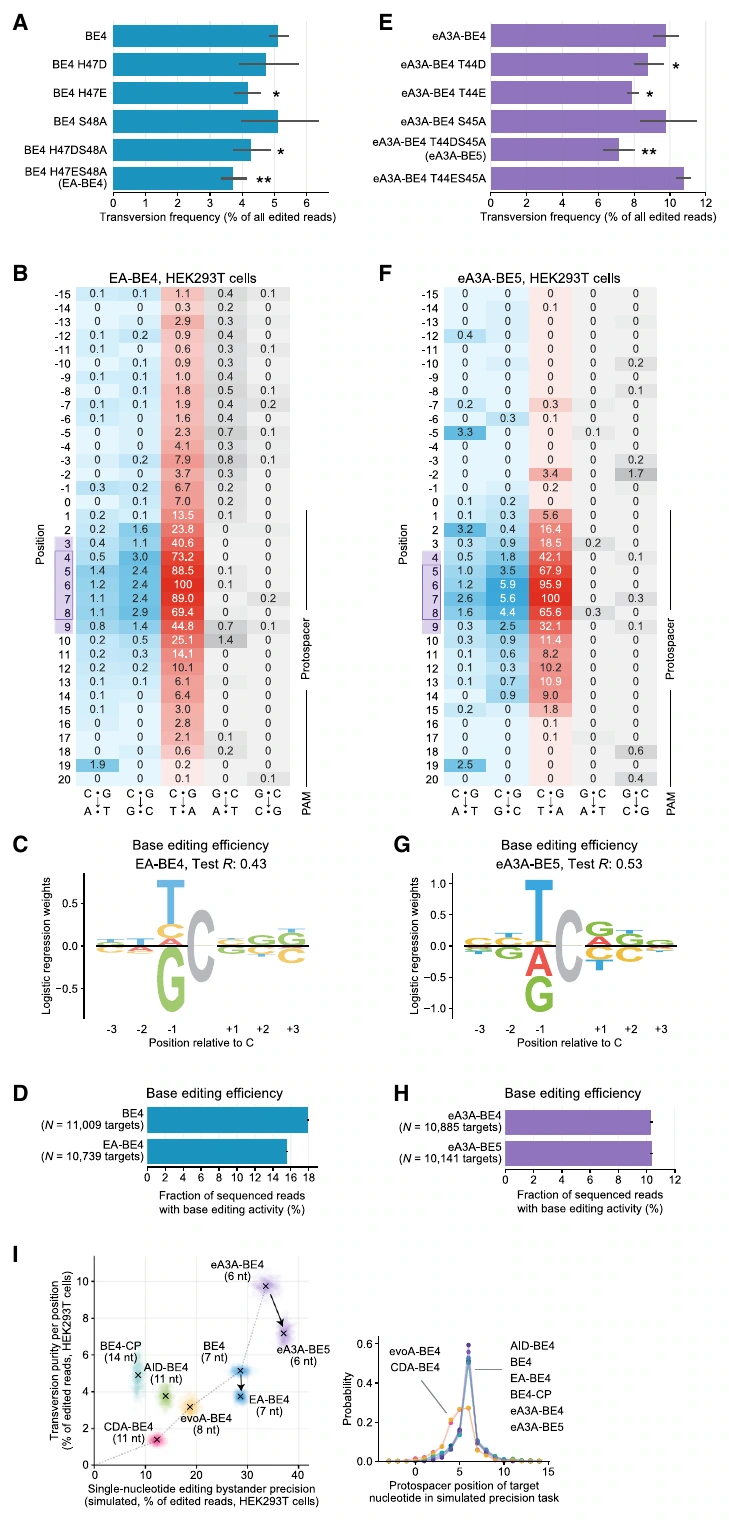
    <content type="html"><![CDATA[<!-- dl-literature-import:085 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Determinants of Base Editing Outcomes from Target Library Analysis and Machine Learning</p><p><strong>期刊与年份：</strong> Cell，2020。<a href="https://doi.org/10.1016/j.cell.2020.05.037">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 碱基编辑的效率、副产物和精确纠正结果能否由序列预测并通过工程改进？</p><h2 id="问题从实验失败的细节里长出来"><a href="#问题从实验失败的细节里长出来" class="headerlink" title="问题从实验失败的细节里长出来"></a>问题从实验失败的细节里长出来</h2><p>我的推测是，作者真正要解决的不是再提高一个编辑效率分数，而是实验人员的选择困境：目标碱基在典型窗口内，却可能产生邻近旁观者编辑；窗口较宽的编辑器反而可能在某些序列更精确；少见的颠换副产物也可能成为所需产物。仅用位置规则无法决定最佳编辑器与sgRNA。论文因此先设计覆盖丰富上下文的整合靶序列文库，再让模型学习结果分布，并利用这些规律改造蛋白。</p><p>BE-Hive并不是一个包办所有任务的深度网络。效率模型是梯度提升回归树，输入序列位置、二核苷酸、GC及熔解温度等特征，预测归一化编辑效率；旁观者模型才是深条件自回归网络。它先编码每个可编辑碱基及其左右局部序列，再按顺序预测各位置结果，条件包括前面已生成的编辑状态，用KL散度拟合实际结果分布。不同编辑器与细胞背景对应训练条件，不能假设一个任意新编辑器名称输入后就会可靠泛化。</p><p>这个结构适合组合输出：多个底物的状态可以依赖，独立单点概率相乘会漏掉共同编辑或互斥。模型同时把总编辑概率与编辑后条件产物概率分开，两者相乘才得到目标产物在全部读段中的预测比例。后者通常更稳定，前者还受递送、表达和实验批次影响。研究范式是高通量扰动数据驱动的监督概率建模，再以设计实验和蛋白工程闭环验证。疾病位点为应用对象，不是模型学习疾病致病机制的标签。</p><h2 id="Figure-1：大规模碱基编辑靶位点实验"><a href="#Figure-1：大规模碱基编辑靶位点实验" class="headerlink" title="Figure 1：大规模碱基编辑靶位点实验"></a>Figure 1：大规模碱基编辑靶位点实验</h2><p><a href="/img/dl-literature/085/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/085/figure-01.webp" alt="Figure 1" width="943" height="1525" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 1。点击图片可查看原图。</em></p><p>A先把sgRNA与对应靶序列配对整合，测序直接观察多种真实产物；这是预测模型可以成立的数据基础。整合文库控制了序列组合并扩大覆盖，不能完整保留每个原位基因组的染色质背景。B比较多种编辑器的位置谱，典型与非典型突变分开，显示“窗口”并不是硬开关。热图按每种活动的最大值归一化，颜色很深不一定表示该副产物在全部读段里占比很高。因而需要结合绝对效率和相同读数分母理解。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>把成千上万sgRNA—靶序列整合到细胞，编辑、选择并测序，定义高通量训练数据。</td></tr><tr><td>B</td><td>不同编辑器沿protospacer的典型与非典型突变活性热图，展示编辑窗口及副产物的位置依赖。</td></tr></tbody></table><h2 id="Figure-2：编辑结果的序列偏好与插缺"><a href="#Figure-2：编辑结果的序列偏好与插缺" class="headerlink" title="Figure 2：编辑结果的序列偏好与插缺"></a>Figure 2：编辑结果的序列偏好与插缺</h2><p><a href="/img/dl-literature/085/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/085/figure-02.webp" alt="Figure 2" width="948" height="1524" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 5 页，Figure 2。点击图片可查看原图。</em></p><p>A至D用简单回归权重表示局部序列偏好，适合解释上下文促进或抑制编辑，但逐位独立logo并不是最终自回归模型的全部规则。E、F讨论插缺位置、长度与重复来源，为副产物生成路径提供线索；G再比较编辑与插缺比。作者专门用未处理文库排查合成与PCR产生的一碱基错误，并对背景与批次作校正。若没有这些对照，罕见副产物很容易被技术噪声制造出来。高编辑／插缺比也不等于其他旁观者替换或脱靶都安全，这个指标的范围必须限定。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>典型C→T或A→G效率的序列logo，正负权重表示促进或降低编辑。</td></tr><tr><td>B</td><td>CBE引起G·C→A·T转换的序列偏好，检查不同底物环境。</td></tr><tr><td>C</td><td>CBE胞嘧啶颠换的序列偏好，定位非典型产物的上下文。</td></tr><tr><td>D</td><td>ABE意外胞嘧啶编辑的序列偏好，描述跨底物副作用。</td></tr><tr><td>E</td><td>插缺频率按位置和长度的热图，检查副产物的空间分布。</td></tr><tr><td>F</td><td>插入长度与重复次数热图，分析插入形成模式。</td></tr><tr><td>G</td><td>碱基编辑与插缺比率分布，比较编辑器的产物纯度。</td></tr></tbody></table><h2 id="Figure-3：BE-Hive效率与旁观者编辑模型"><a href="#Figure-3：BE-Hive效率与旁观者编辑模型" class="headerlink" title="Figure 3：BE-Hive效率与旁观者编辑模型"></a>Figure 3：BE-Hive效率与旁观者编辑模型</h2><p><a href="/img/dl-literature/085/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/085/figure-03.webp" alt="Figure 3" width="965" height="1526" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 7 页，Figure 3。点击图片可查看原图。</em></p><p>A把预测变成具体实验选择，B、C展示效率树模型的任务与泛化，D、E再展示条件产物分布的深度模型。两种相关系数服务不同问题，不应合称同一个“90%准确率”。F比较成对底物共同或分别编辑的失衡程度，检验自回归是否真正捕获联合依赖，而不只把每个碱基概率排对。失衡还受局部序列偏好影响，不能直接视为纯粹酶过程性测量。G展示DNA与氨基酸层面的结果，因为不同DNA组合有时翻译成同样蛋白序列；这为选择任务提供更贴近用途的终点。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>实验设计决策树，把编辑器及目标选择连接到所需结果。</td></tr><tr><td>B</td><td>预测编辑效率Z分数的模型结构，定义效率任务。</td></tr><tr><td>C</td><td>未见靶点的预测对实测效率，检验泛化。</td></tr><tr><td>D</td><td>条件自回归模型依据序列、向导、编辑器与细胞类型预测每一种旁观者编辑结果频率。</td></tr><tr><td>E</td><td>未见靶点旁观者结果频率的预测表现，验证不止能预测总体效率。</td></tr><tr><td>F</td><td>两底物一起或分别编辑的失衡评分预测对实测，检验模型学到联合编辑依赖。</td></tr><tr><td>G</td><td>BE-Hive网页DNA与氨基酸编辑结果展示，说明如何用预测支持实验选择。</td></tr></tbody></table><h2 id="Figure-4：致病等位基因的精确纠正"><a href="#Figure-4：致病等位基因的精确纠正" class="headerlink" title="Figure 4：致病等位基因的精确纠正"></a>Figure 4：致病等位基因的精确纠正</h2><p><a href="/img/dl-literature/085/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/085/figure-04.webp" alt="Figure 4" width="948" height="1524" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 9 页，Figure 4。点击图片可查看原图。</em></p><p>A将模型预测与新疾病位点文库实测精确度比较；B、C关注旁观者底物多时还能否精确纠正，D提供窗口内单一底物的参照。E、F固定部分底物位置与数量仍见结果差异，说明上下文信息提供了位置规则之外的贡献。G、H中最佳编辑器随目标位置和序列改变，支持逐位点优化，而非统一使用窗口最窄的工具。</p><p>关键分母是“已编辑读段”，不是所有细胞或所有DNA。文库中将致病等位恢复为参考序列也并未测得患者表型恢复。论文选择的疾病SNV注释来自当时数据库版本，在本篇应作为原始应用集合描述；不能把全部历史注释当成当前无争议临床结论。模型纠正序列的能力和疾病机制判断仍是两项工作。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>疾病SNV的预测对实测纠正精确度，验证模型选择能力。</td></tr><tr><td>B</td><td>不同编辑器对多底物及全部疾病位点的纠正频率，分析窗口位置及可用范围。</td></tr><tr><td>C</td><td>包含旁观者底物的疾病位点纠正频率，检验邻近可编辑碱基带来的挑战。</td></tr><tr><td>D</td><td>BE4在C6且无其他旁观者底物的位点结果，给出简单条件参照。</td></tr><tr><td>E</td><td>BE4纠正疾病SNV的结果及预测／真实精确度，检验CBE应用。</td></tr><tr><td>F</td><td>ABE对应疾病SNV纠正及精确度，检验另一编辑类别。</td></tr><tr><td>G</td><td>第5位疾病底物不同编辑器的纠正，观察位点偏好。</td></tr><tr><td>H</td><td>第7位的对应比较，说明最佳编辑器依赖底物位置与上下文。</td></tr></tbody></table><h2 id="Figure-5：用胞嘧啶颠换纠正变异"><a href="#Figure-5：用胞嘧啶颠换纠正变异" class="headerlink" title="Figure 5：用胞嘧啶颠换纠正变异"></a>Figure 5：用胞嘧啶颠换纠正变异</h2><p><a href="/img/dl-literature/085/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/085/figure-05.webp" alt="Figure 5" width="780" height="1520" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 12 页，Figure 5。点击图片可查看原图。</em></p><p>A提出不同C到A、G、T产物的上下文偏好，B用模型挑选富集颠换位点再实验，是从相关规律走向预测设计的验证。C检验颠换提高是否同时增加插缺，两者未表现明显关系，为产物分配而非简单提高损伤量的解释提供支持，但还不直接解析全部修复通路。D、E刻意区分DNA精确度与氨基酸精确度，F分别验证两种预测。蛋白精确度较高可能来自同义副产物归并；同义改变仍可能影响剪接或调控，不能因此一概称无害。此处高精确度属于特定选中靶点集合，不能代表任意颠换位点。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>C分别编辑到A、G、T的纯度序列logo，识别产物类型偏好。</td></tr><tr><td>B</td><td>普通靶点与BE-Hive挑选高颠换靶点的纯度比较，检验模型设计的实验收益。</td></tr><tr><td>C</td><td>碱基编辑／插缺比对颠换纯度，检查提高颠换是否伴随更多插缺。</td></tr><tr><td>D</td><td>DNA基因型精确度对氨基酸精确度，说明不同DNA副产物有时仍产生相同蛋白结果。</td></tr><tr><td>E</td><td>疾病颠换SNV的DNA和氨基酸纠正精确度，评估可用纠正范围。</td></tr><tr><td>F</td><td>颠换纠正预测对实测，分别以DNA及蛋白结果验证模型。</td></tr></tbody></table><h2 id="Figure-6：改造脱氨酶提高颠换纯度"><a href="#Figure-6：改造脱氨酶提高颠换纯度" class="headerlink" title="Figure 6：改造脱氨酶提高颠换纯度"></a>Figure 6：改造脱氨酶提高颠换纯度</h2><p><a href="/img/dl-literature/085/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/085/figure-06.webp" alt="Figure 6" width="1060" height="1157" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 14 页，Figure 6。点击图片可查看原图。</em></p><p>A、B利用酶家族保守位点与结构比对提出工程候选；C看产物纯度，D同时看总体效率，体现工程需要多终点比较。eA3A相关T31A变体提高部分目标的颠换纯度，却带来平均效率下降，若只看C会漏掉实际产量代价。E、F将工程产物放回疾病位点并比较预测与实测，闭合了“规则、改造、应用”链条。保守位点的功能推断因此有真实突变实验支持，但关于磷酸化及修复蛋白如何传递影响的完整机制，仍不能仅凭同源位置和产物变化全部确定。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>腺嘌呤／胞嘧啶脱氨酶家族树，为结构改造选择保守位点。</td></tr><tr><td>B</td><td>AID、A3A、APOBEC1结构比对标出同源T27／S38，定义突变位置。</td></tr><tr><td>C</td><td>eA3A-BE4及位点突变版本的颠换纯度，检验工程改造。</td></tr><tr><td>D</td><td>同一编辑器集合的总体效率，检查纯度改变是否损失活性。</td></tr><tr><td>E</td><td>改造编辑器纠正疾病颠换SNV的DNA／氨基酸精确度，验证应用效果。</td></tr><tr><td>F</td><td>对应预测对实测纠正精确度，检验工程编辑器的结果可预测性。</td></tr></tbody></table><h2 id="Figure-7：减少非期望颠换与编辑窗口权衡"><a href="#Figure-7：减少非期望颠换与编辑窗口权衡" class="headerlink" title="Figure 7：减少非期望颠换与编辑窗口权衡"></a>Figure 7：减少非期望颠换与编辑窗口权衡</h2><p><a href="/img/dl-literature/085/figure-07.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/085/figure-07.webp" alt="Figure 7" width="729" height="1520" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 15 页，Figure 7。点击图片可查看原图。</em></p><p>A至D改进BE4，E至H改进eA3A，分别检查颠换、位置谱、上下文偏好和效率，防止一个指标改善靠牺牲其他指标获得。I以Pareto前沿呈现编辑窗口与产物纯度的权衡：宽窗口可能提高可编辑范围，却增加旁观者；窄窗口不能保证所有位点最精确。图中的单碱基精确度含模拟任务结果，并非每一个候选都已经有相同体内干预。我的理解是，工程优劣必须与目标位点和所需产物一起评估；“最佳编辑器”本来就不是一个脱离任务的固定名称。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>BE4保守位点突变后的颠换频率，检验EA-BE4降低副产物。</td></tr><tr><td>B</td><td>EA-BE4与BE4在HEK293T的活性位置谱，检查编辑窗口。</td></tr><tr><td>C</td><td>EA-BE4效率序列偏好，说明改造后的上下文依赖。</td></tr><tr><td>D</td><td>EA-BE4与BE4总体效率比较，检查减少副产物的活性代价。</td></tr><tr><td>E</td><td>eA3A-BE5对eA3A-BE4颠换频率，检验另一改造方案。</td></tr><tr><td>F</td><td>两者HEK293T活性位置谱，比较窗口和副产物位置。</td></tr><tr><td>G</td><td>eA3A-BE5效率的序列偏好，描述编辑规律。</td></tr><tr><td>H</td><td>eA3A-BE5对eA3A-BE4效率，检查改造保持活性情况。</td></tr><tr><td>I</td><td>颠换纯度、窗口大小与模拟单碱基精确度的Pareto前沿，说明不存在对所有目标都最佳的编辑器。</td></tr></tbody></table><h2 id="可迁移的是任务分解与实验闭环"><a href="#可迁移的是任务分解与实验闭环" class="headerlink" title="可迁移的是任务分解与实验闭环"></a>可迁移的是任务分解与实验闭环</h2><p>这篇对AD研究最直接的用途在验证阶段：候选变异需要做内源编辑时，先用工具比较sgRNA和旁观者结果，减少“名义上改了一个位点，实际上改了一组位点”的解释困难。它不能从编辑容易与否推断一个变异是否导致AD。TE重复背景还可能带来向导多位点匹配，本文的局部产物模型并不负责完整基因组脱靶评估。</p><p>纯计算研究也可以借用任务分解：分别建模一个TE副本是否处于可及状态，以及条件于可及时的调控模式，再检查是否比直接预测疾病标签更可解释。但这种分解需数据支持其稳定性，不能只因论文采用就默认成立。另一个具体启发是，在生成模型里报告概率覆盖：BE-Hive只探索最可能的产物组合，并把未覆盖概率保守视为不利结果。对我们的候选排序，同样应记录不确定和未支持的部分，而不是把缺失证据自动当无风险。</p><p>这套旁观者网络并不巨大，文中还指出可变形状批次使GPU相对CPU提速有限。它提醒我，可行创新常来自准确的目标定义、控制数据噪声和可验证的输出结构；无需先拥有能容纳超大模型的显卡。</p>]]></content>
    
    
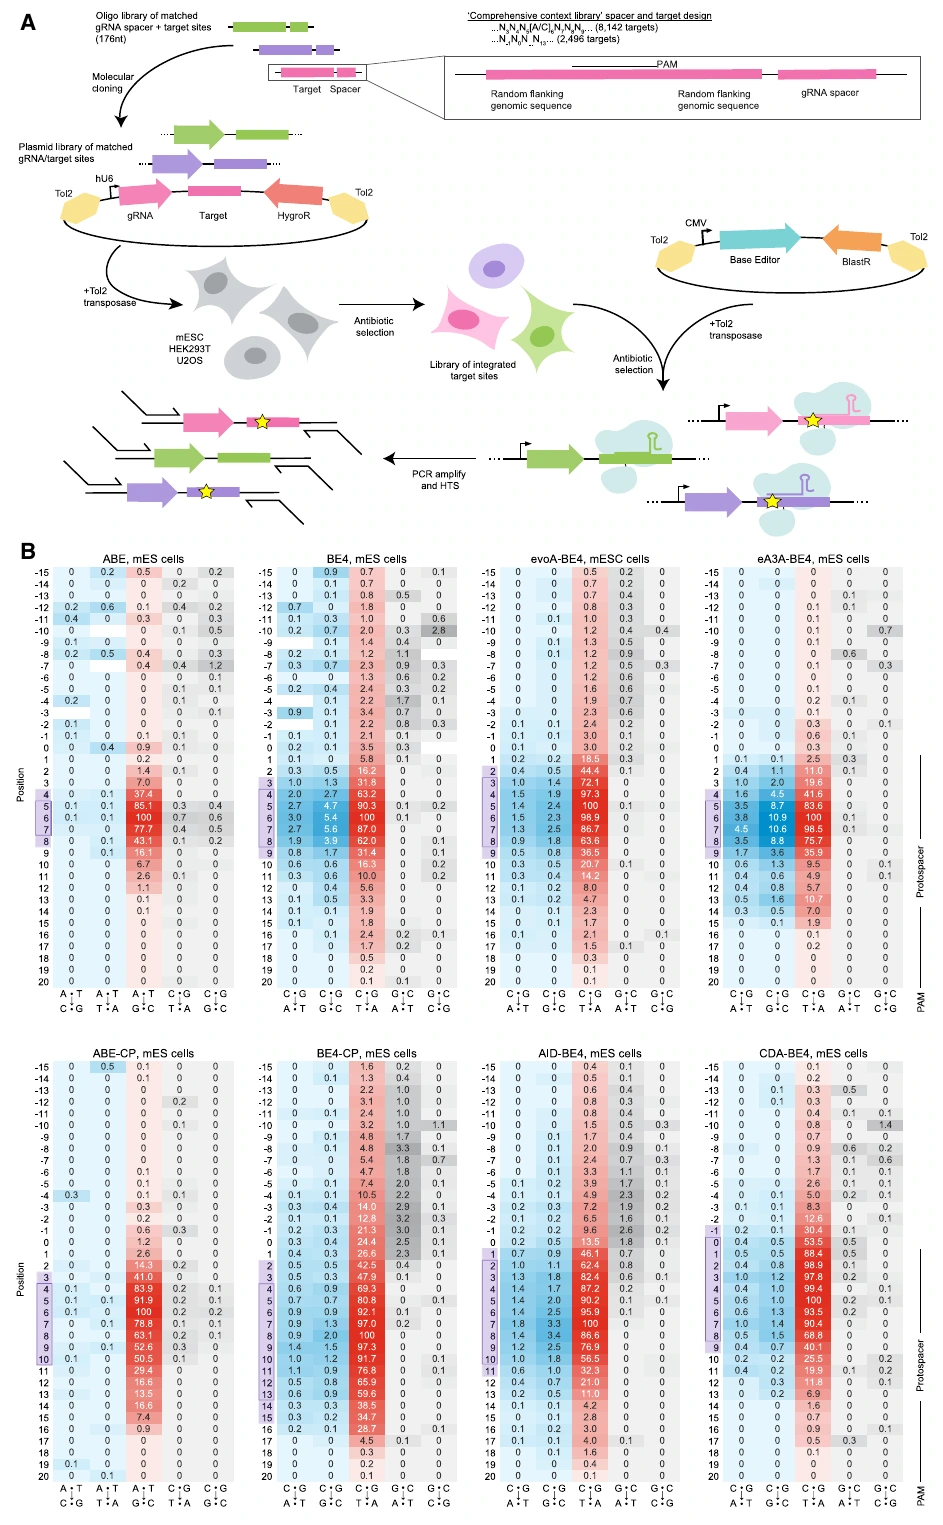
    <summary type="html">深入读懂BE-Hive：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="CRISPR" scheme="https://perry.apay.eu.cc/tags/CRISPR/"/>
    
    <category term="基因编辑" scheme="https://perry.apay.eu.cc/tags/%E5%9F%BA%E5%9B%A0%E7%BC%96%E8%BE%91/"/>
    
  </entry>
  
  <entry>
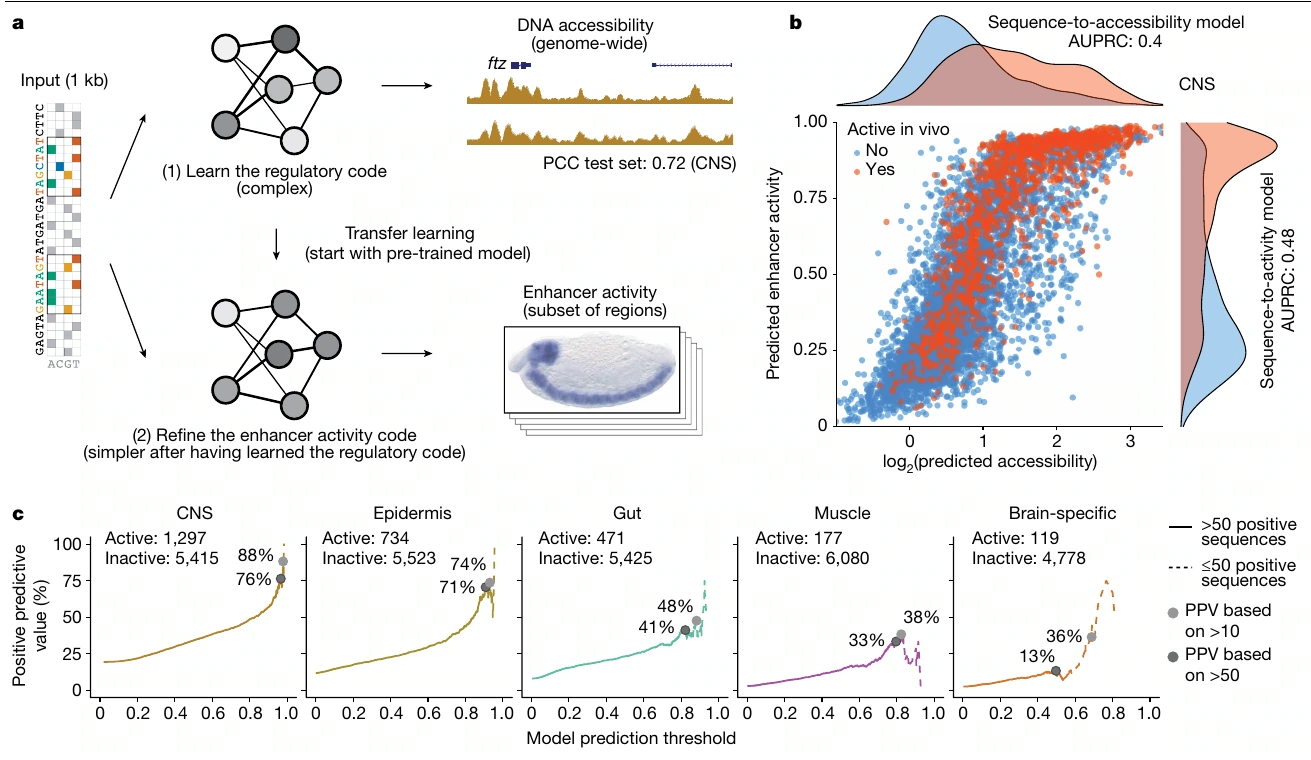
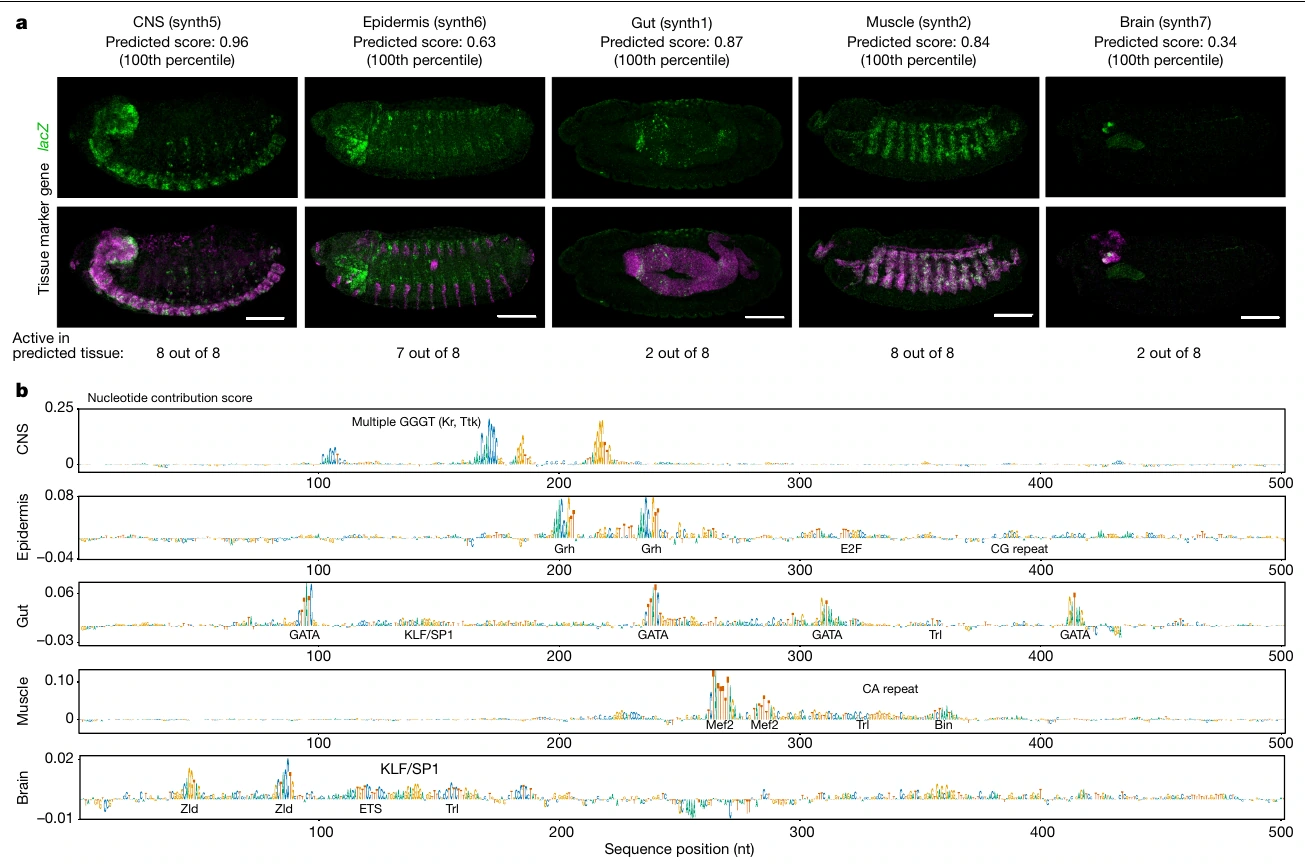
    <title>84.TissueEnhancerDesign：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920054/"/>
    <id>https://perry.apay.eu.cc/posts/ad920054/</id>
    <published>2026-10-04T12:01:24.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:084 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Targeted design of synthetic enhancers for selected tissues in the Drosophila embryo</p><p><strong>期刊与年份：</strong> Nature，2024。<a href="https://doi.org/10.1038/s41586-023-06905-9">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 从开放度迁移到体内活性模型能否设计指定果蝇胚胎组织的增强子？</p><h2 id="研究的真正瓶颈是功能标签，而不是DNA数量"><a href="#研究的真正瓶颈是功能标签，而不是DNA数量" class="headerlink" title="研究的真正瓶颈是功能标签，而不是DNA数量"></a>研究的真正瓶颈是功能标签，而不是DNA数量</h2><p>我的推测是，这项工作从一个实际矛盾出发：果蝇胚胎已经有全基因组、细胞类型分辨的开放染色质图谱，可是真正经过体内报告实验验证的增强子，每个组织只有有限数量。直接用少量阳性训练复杂模型容易学不稳；只用ATAC又把“开放”误当成“能驱动表达”。作者把两个数据层次连起来，先训练序列到可及性，再把同一网络微调成序列到体内活性的模型。创新在标签与任务的安排，而非设计全新大型架构。</p><p>第一阶段是DeepSTARR式四层卷积网络，输入1,001 bp one-hot DNA，预测中央区域的pseudo-bulk ATAC定量信号，损失为均方误差。第二阶段保留初始化权重，将输出变为组织活跃或不活跃的二分类概率，所有层继续训练，以较小学习率和交叉熵优化。选择二分类不是因为增强子只有两种强度，而是现有体内原位杂交标签本来就不定量。把概率0.9解释成某个精确表达倍数，超出了训练目标。</p><p>CNS、表皮、肠、肌肉与脑特异任务分别训练。脑特异要求脑活跃且腹神经索不活跃，因而比“神经系统活跃”更难；这是有明确反目标的设计问题。各阶段使用一致的染色体区域交叉验证划分，测试区域没有先进入可及性预训练再被用于活性测试。这样的划分是迁移学习的重要质量条件。归因得到motif后再选择不同组合的候选，可以增加设计多样性，但它本身仍不是对每个motif的扰动验证。</p><p>从预测走到设计，作者生成大量随机501 bp序列，添加侧翼以符合模型输入，筛选同时具有目标组织可及性和活性得分的候选，再检查侧翼变化的稳定性和motif构成，人工选出每组织八条。它属于预测器驱动的随机序列筛选，不是用扩散模型直接生成增强子，也不是所有高分序列自动进入实验。理解这一点才能正确评价计算成本和成功率。</p><h2 id="Figure-1：迁移学习设计果蝇胚胎组织特异增强子"><a href="#Figure-1：迁移学习设计果蝇胚胎组织特异增强子" class="headerlink" title="Figure 1：迁移学习设计果蝇胚胎组织特异增强子"></a>Figure 1：迁移学习设计果蝇胚胎组织特异增强子</h2><p><a href="/img/dl-literature/084/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/084/figure-01.webp" alt="Figure 1" width="1311" height="760" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 2 页，Figure 1。点击图片可查看原图。</em></p><p>a把大量可及性监督与少量功能监督放在一个流程里，并列出不同组织阳性样本数。真正的因果桥梁是第二阶段的体内活性标签；ATAC预训练提供可迁移表示，不能独自决定增强子功能。b把同一CNS序列的可及性预测与活性预测绘成散点：可及性较高但体内不活跃的区域说明两个任务并不等价。微调模型的AUPRC提高，有助于从候选空间中筛出更值得实验的序列；然而总体指标必须在相同正负集合比较，不能把全基因组预测相关系数与功能分类AUPRC互称“准确率”。</p><p>c问的是有限实验名额下的实际命中率，而不是单纯排名。提高阈值可能提高PPV，同时保留下来的候选减少，虚线段的估计更不稳定；某一组织中最高分样本的百分位很高，也不意味着不同组织的概率值已经同等校准。脑的有限阳性和高相似神经背景使任务困难。主文同时比较随机初始化、错误组织ATAC初始化与直接使用可及性模型，这些对照分别排查网络规模、泛化预训练和标签替代的解释。最有说服力的迁移主张应依赖这组对照，而非只展示一条相关曲线。</p><p>需要注意，阳性功能片段还要求与对应组织的可及性峰相交，评估以有原始实验的Vienna Tiles为基础。这提高了标签可信度，却限定了“活跃”的操作定义。模型性能并不自动覆盖所有闭合但可被激活的调控序列，也不自动等于在全基因组随机位置上的PPV。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>先用单细胞ATAC训练开放度模型，再用较少体内活性数据微调组织模型，说明两阶段策略。</td></tr><tr><td>b</td><td>CNS实际活性对开放度预测和微调活性预测，比较仅开放度与组织功能标签的辨别能力。</td></tr><tr><td>c</td><td>不同阈值的阳性预测值，帮助估计高分设计序列的体内成功率，虚线表示样本数较少。</td></tr></tbody></table><h2 id="Figure-2：五个组织的合成增强子体内验证"><a href="#Figure-2：五个组织的合成增强子体内验证" class="headerlink" title="Figure 2：五个组织的合成增强子体内验证"></a>Figure 2：五个组织的合成增强子体内验证</h2><p><a href="/img/dl-literature/084/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/084/figure-02.webp" alt="Figure 2" width="1307" height="868" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 2。点击图片可查看原图。</em></p><p>a将每条合成增强子接到相同hsp70最小启动子与lacZ报告基因，并放入同一基因组整合位置。固定位置和启动子控制了许多外部条件，因而观察到的表达差异主要可以归于候选序列。粉色内源组织标志与绿色lacZ的空间重合检验目标组织定位；单看lacZ有信号只能证明活性，不能证明特异性。图中展示每组织一个代表，成功数量来自完整测试集合，应避免用漂亮代表替代全部结果。</p><p>八条CNS和八条肌肉设计均在目标组织活跃，表皮七条，肠和脑各两条。这种差异比总体68%目标组织成功率更能说明方法局限。CNS的部分候选还有弱的外周神经活动；肠与脑的候选可能同时在其他组织表达。“在目标组织活跃”因此并不总等于“只在目标组织活跃”。作者的像素相关分析有助于量化空间重合，但相关较高仍可能包含额外表达。胚胎图的每个像素也不是独立生物学重复。</p><p>b把归因映射回已知组织motif，解释模型如何提出设计。肌肉的Mef2、Bin等组合相对易区分，肠的GATA因子同时服务多个组织，单靠GATA富集可能满足活性却不满足排他性。我的理解是，失败候选在这里提供了机制线索：当同一调控语言被多个细胞环境使用，设计目标必须加入显式反目标，而不是一味提高目标模型分数。图中的motif颜色是模型归因，并没有证明逐一破坏这些位点就会按预测改变体内表达。下一步最直接的验证是保持其余序列不变，只改候选的关键或反目标motif。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>CNS、表皮、肠、肌肉、脑的lacZ及组织标记双FISH，验证设计表达与指定组织重合，并给出成功序列数量。</td></tr><tr><td>b</td><td>各组织代表合成增强子的逐碱基贡献及已知TF模体，解释特异表达所依赖的代码。</td></tr></tbody></table><h2 id="可以迁移到AD，但需要把候选用途说清楚"><a href="#可以迁移到AD，但需要把候选用途说清楚" class="headerlink" title="可以迁移到AD，但需要把候选用途说清楚"></a>可以迁移到AD，但需要把候选用途说清楚</h2><p>这篇对有限显存项目很有启发：先做较小卷积网络，选择与最终任务相近的公共大数据预训练，再以少量可信功能数据修正目标，比从头训练通用基因组模型更现实。若研究AD中TE重叠调控元件，可以用相关脑细胞ATAC学习序列表示，随后利用独立、细胞背景明确的MPRA校准调控功能。若没有MPRA，就应把产出限定为可及性候选，不宜把模型改名成“致病增强子设计器”。</p><p>一个具体可做的研究是：同一TE家族成员中，哪些motif组合只提高小胶质细胞或某神经元亚型的预测活性，哪些会同时激活其他脑细胞？固定TE家族、长度、GC与基因组背景，用匹配的非TE序列和motif扰动作对照；在未见染色体或独立队列上评估目标与反目标差值。这样可以检验TE是否提供可利用的调控语法，而非因为它在基因组中多、容易与峰相交就推断特殊作用。</p><p>我也会保留本篇对“有限标签”的诚实处理：预训练不能制造实验真值，合成序列在固定报告位置成功也不直接证明可改写内源AD风险。若最后仅能纯计算，最强结果可能是发现可解释、可独立复现的候选规则，并提出数量有限、具体可实验的设计，而不是宣布治疗方案。论文证明的是条件受控的组织表达设计；迁移到疾病研究，还需要人类细胞背景、内源调控和疾病效应三条额外证据。</p>]]></content>
    
    
    <summary type="html">深入读懂TissueEnhancerDesign：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>83.DeepC：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920053/"/>
    <id>https://perry.apay.eu.cc/posts/ad920053/</id>
    <published>2026-10-04T12:01:23.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:083 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> DeepC: predicting 3D genome folding using megabase-scale transfer learning</p><p><strong>期刊与年份：</strong> Nature Methods，2020。<a href="https://doi.org/10.1038/s41592-020-0960-3">论文原文</a>。</p><p><strong>阅读版本：</strong> Europe PMC 作者接受稿（Author Manuscript），2021-04-16在PMC公开；正式发表为 Nature Methods 2020。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 兆碱基DNA序列能否预测三维折叠，并定位影响结构的调控变异？</p><h2 id="问题如何形成：局部碱基怎样影响远程结构"><a href="#问题如何形成：局部碱基怎样影响远程结构" class="headerlink" title="问题如何形成：局部碱基怎样影响远程结构"></a>问题如何形成：局部碱基怎样影响远程结构</h2><p>非编码变异常远离目标基因，因此只预测一个局部位点是否结合转录因子，并不能回答它会改变哪一个远程调控关系。我的推测是，作者把当时两类方法的缺口放在一起：逐碱基模型精细但看得近，大尺度结构模型看得远却把DNA简化成粗粒度特征。DeepC选择先学习局部调控语言，再把这些表示连成兆碱基范围的结构预测。这一推断来自引言提出的尺度冲突，不代表作者对研究过程的逐字回忆。</p><p>模型先用1 kb DNA预测936组染色质实验的峰标签，训练卷积模块；随后移除分类输出层，将卷积权重迁移到三维预测网络。第二阶段输入约1 Mb DNA，经池化、十层带门控的膨胀卷积和全连接层，输出中心附近的一列成对接触信息；滑动窗口再拼成矩阵。监督目标是按距离分层后的接触百分位编号，以均方误差学习，而不是未经处理的Hi-C原始读数。卷积识别局部motif，膨胀卷积整合远程背景，分别对应问题的两个空间尺度。</p><p>输入虽只有DNA，模型依然按细胞类型分别使用Hi-C监督训练。同一DNA在不同细胞中表现不同，靠的是不同模型权重，而不是一个DNA模型自动知道细胞状态。作者尝试多细胞联合模型，但其细胞特异模式不如分别训练。研究范式是有监督的多任务表示迁移，不是无监督发现三维结构。疾病链条应写成序列改变、预测结构改变、可能影响调控，再由独立数据验证，不宜跳过中间环节。</p><h2 id="Figure-1：由DNA预测三维接触的deepC"><a href="#Figure-1：由DNA预测三维接触的deepC" class="headerlink" title="Figure 1：由DNA预测三维接触的deepC"></a>Figure 1：由DNA预测三维接触的deepC</h2><p><a href="/img/dl-literature/083/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/083/figure-01.webp" alt="Figure 1" width="1273" height="1293" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 23 页，Figure 1。点击图片可查看原图。</em></p><p>a是“先学局部、再学远程”的路线图；b则明确输出到底是什么，避免误以为网络一次输出完整三维坐标。中心接触列覆盖不同距离，既便于训练，也让滑窗结果可重构为染色体接触图。c将原始Hi-C、百分位骨架与模型预测放在未见染色体同一区域，主要检验域结构和边界。距离归一化强化远距离对比，却改变了读数意义，因此预测色深不能直接等同于原始接触概率。</p><p>d按基因组距离分别计算相关，而不是让大量近距离强接触主导总分。平滑后的相关更高，说明目标数据的离散噪声会影响评估，但也意味着原始与平滑两种成绩不能混用。尤其需要理解“高分辨率”：输入可逐碱基修改，主要展示模型的Hi-C输出仍是5 kb分箱，二者不是同一种分辨率。学习后的图看起来平滑整齐，也不代表每个细小条纹都真实。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>先迁移学习序列表示再预测接触的网络与训练流程。</td></tr><tr><td>b</td><td>1Mb序列窗口对应Hi-C目标向量的编码，说明学习对象。</td></tr><tr><td>c</td><td>未见染色体约7Mb区域的Hi-C、简化骨架和deepC预测，检查域结构及边界。</td></tr><tr><td>d</td><td>全染色体交叉验证的距离分层相关，比较原始和滤波骨架目标，避免近距离主导评估。</td></tr></tbody></table><h2 id="Figure-2：独立三维实验验证"><a href="#Figure-2：独立三维实验验证" class="headerlink" title="Figure 2：独立三维实验验证"></a>Figure 2：独立三维实验验证</h2><p><a href="/img/dl-literature/083/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/083/figure-02.webp" alt="Figure 2" width="1248" height="1294" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 25 页，Figure 2。点击图片可查看原图。</em></p><p>这张图用独立测量检查网络是否只是复述Hi-C的处理方式。a以NG Capture-C的定点高深度接触轨迹分别测试CTCF位点与域内位点；将二者分开很重要，因为它们强调不同结构现象。模型对域内总体结构较好，对CTCF尖锐接触峰则弱于原始骨架。这个缺口提示DNA序列能够解释边界的一部分，却未必包含cohesin过程性、核内蛋白浓度等状态变量。</p><p>b围绕模型与实验调用的边界做平均轨迹，c再以Tiled-C检查未见染色体的具体区域。它们分别回答“总体是否存在边界”和“这个位置是否看得见”，不能互相替代。方法部分说明220个验证观测点有意选择预测与Hi-C细节不同或预测信号很弱的区域，这适合检验模型提出的结构假说，却不是全基因组随机抽样的无偏性能估计。实验技术重复被合并增加深度，也不能当作大量独立生物学重复。模型可能夸大域间条纹、低估隔离程度，阅读漂亮案例时应同时记住这一已报告偏差。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>NG Capture-C对骨架虚拟4C及预测虚拟4C的相关，分别在CTCF和域内观测点验证。</td></tr><tr><td>b</td><td>实际、骨架和预测边界周围的Capture-C平均轨迹，检验模型是否定位隔离边界。</td></tr><tr><td>c</td><td>未见chr17的Hi-C、预测、Tiled-C及边界对照，借高灵敏独立实验验证精细结构。</td></tr></tbody></table><h2 id="Figure-3：序列结构决定因素与遗传变异"><a href="#Figure-3：序列结构决定因素与遗传变异" class="headerlink" title="Figure 3：序列结构决定因素与遗传变异"></a>Figure 3：序列结构决定因素与遗传变异</h2><p><a href="/img/dl-literature/083/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/083/figure-03.webp" alt="Figure 3" width="1284" height="1050" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 27 页，Figure 3。点击图片可查看原图。</em></p><p>a与b分别提出序列重要性的两个计算证据：梯度归因寻找网络敏感位置，虚拟删除比较参考与改变后接触预测。CTCF、启动子和增强子附近信号更强，说明模型利用了这些模式；但梯度不是实际突变实验，删除后的预测差也不是已经测到的结构变化。虚拟删除还会改变序列距离与上下文，分析应区分motif丢失和结构长度改变的贡献。</p><p>c与真实约30 kb删除后的5C结果对照，是整篇从模型内部解释走向干预证据的重要一步。不过实验发生于HEK293相关细胞，展示使用GM12878模型，两种细胞并不相同；复现域融合支持跨背景的结构规律，却不能证明所有预测变异都具有同样准确度。d再将分析缩小到两个哮喘相关SNP：通过风险等位与非风险等位的差异、背景SNP分布和既有CTCF知识优先排序候选。它为ORMDL3调控提出机制路径，尚未独自完成变异、结合、接触、表达和疾病风险的全链条因果证明。一个预测排名很高的SNP仍需要控制连锁不平衡和细胞类型。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>不同调控注释区域的归因富集，识别模型认为影响结构的序列类别。</td></tr><tr><td>b</td><td>全基因组删除开放区、CTCF及随机对照后的预测变化，定量检验元件的结构影响。</td></tr><tr><td>c</td><td>删除含四个CTCF位点的约30kb片段后，预测与5C实测结构变化对照，验证大段删除效应。</td></tr><tr><td>d</td><td>两哮喘关联SNP的风险／非风险预测差异，定位ORMDL3／IKZF3附近接触变化；为候选机制，不能单凭预测认定因果。</td></tr></tbody></table><p>阅读说明：实际阅读版本为 Europe PMC 作者接受稿（Author Manuscript），页脚注明于2021年4月16日在PMC公开；正式发表记录为 Nature Methods 2020，17:1118–1124，DOI 10.1038&#x2F;s41592-020-0960-3。主图与图注按此份接受稿的PDF页码讲解。</p><h2 id="我自己的理解：先把结构读数做成可验证的中间层"><a href="#我自己的理解：先把结构读数做成可验证的中间层" class="headerlink" title="我自己的理解：先把结构读数做成可验证的中间层"></a>我自己的理解：先把结构读数做成可验证的中间层</h2><p>我最认可的是作者没有仅靠三维热图相似度结束工作，而是让边界预测面对另一种高灵敏实验。可以迁移的研究设计是：模型训练所用读数，与最终论断所需的证据尽量分开。例如研究TE重叠的AD候选变异，先问是否可能改变CTCF或调控元件及三维关系，再用脑相关细胞的实际接触、表达关联或已有扰动数据检查；不能用同一模型的归因图给自己的预测再次盖章。</p><p>纯计算时可以先用已公开的删除或结构变异集合做外部验证，把相似大小、相似距离、相似可及性的非TE区域作为背景。TE家族、位置和可比对性需匹配，避免重复序列在输入或实验标签中的技术困难被当作特有机制。若只有ATAC，没有脑Hi-C，就应先研究可及性与局部调控，三维模型只提供待验证的候选路径。</p><p>作者实际在12 GB Titan V上以batch size 1训练约6000万参数模型，这说明兆碱基任务不必全部依赖超大基础模型；但原文软件版本、训练目标与吞吐不能直接换算成5060的训练时间。可执行的起点是复用预训练卷积表示，先完成一个细胞背景、固定留出染色体的基准，再比较是否需要远程结构分支。特别注意，第二阶段测试染色体15在局部预训练阶段的划分有所不同；跨任务迁移的全部数据划分必须一起审计，不能只检查最后一层训练集合。最终创新应来自新的生物问题与独立检验，而非把网络输入延长。</p><p>另外，训练预处理把接触强度离散到不均匀百分位，高接触区得到较细分辨；这不是中性的文件转换，而是把模型容量优先分配给域边界的设计选择。迁移时应先确定自己最关注整体接触、尖锐环峰还是边界，而后选择目标表示。不同目标的数值成绩不能直接横向比较。</p>]]></content>
    
    
    <summary type="html">深入读懂DeepC：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>82.EvoSemanticDesign：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920052/"/>
    <id>https://perry.apay.eu.cc/posts/ad920052/</id>
    <published>2026-10-04T12:01:22.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:082 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Semantic design of functional de novo genes from a genomic language model</p><p><strong>期刊与年份：</strong> Nature，2026。<a href="https://doi.org/10.1038/s41586-025-09749-7">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 基因组功能上下文能否提示模型生成序列新颖但具有所需功能的基因？</p><h2 id="这项设计的起点：让基因组上下文承担功能提示"><a href="#这项设计的起点：让基因组上下文承担功能提示" class="headerlink" title="这项设计的起点：让基因组上下文承担功能提示"></a>这项设计的起点：让基因组上下文承担功能提示</h2><p>我对问题形成过程的推测是：Evo已经能生成像基因的DNA，但“像”并没有指定功能；原核基因常以操纵子相邻组织，一个已知基因周围的序列因而可能携带其伙伴的功能信息。作者把这种邻近关系变成提示方式，用天然毒素、抗毒素或抗CRISPR相关基因的DNA及其上下游序列引导续写。这里的“语义”是基因组关联所隐含的生物功能，并非给模型输入中文或英文指令。论文将关联学习转成设计，再通过实际功能筛选决定是否成功。</p><p>Evo 1.5延续Evo 1的原核、噬菌体和质粒DNA自回归预训练，输入已有DNA，目标仍是预测后续碱基，不额外以目标功能标签微调。它延长8,192碱基上下文模型的训练；主文概述约4500亿token，Methods给出训练至112,000步、累计4700亿token的细节，因此不宜把两个描述当完全一致的精确计数。生成后还要识别开放阅读框、去低复杂度、搜索同源，并用结构及相互作用预测挑选实验候选。“无需任务微调”并不意味着最终筛选流程没有结构先验或监督分类器。研究范式是自监督生成加计算筛选加功能验证，最有价值的证据集中在后两步的分工。</p><h2 id="Figure-1：基因组上下文驱动的语义设计"><a href="#Figure-1：基因组上下文驱动的语义设计" class="headerlink" title="Figure 1：基因组上下文驱动的语义设计"></a>Figure 1：基因组上下文驱动的语义设计</h2><p><a href="/img/dl-literature/082/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/082/figure-01.webp" alt="Figure 1" width="1325" height="885" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 2 页，Figure 1。点击图片可查看原图。</em></p><p>这张图先问提示能否传递局部功能关系，而不是直接宣布发现了新蛋白。a、b解释条件续写的逻辑；c从已有基因的一部分补全，比较版本和提示长度。补全准确说明模型学到了编码规律，却不能单独排除训练同源序列带来的帮助。d把任务推进到相邻基因，并同时检查正反向提示，检验的才是操纵子上下文信息是否被利用。此处结构相似度来自预测结构，不是测得的蛋白构象。</p><p>e在核苷酸与氨基酸两个层次比较位置熵：若同义位点变化较大而关键氨基酸保持，生成就有可能遵守编码约束，而不是简单逐字复制。这比只报低序列相似度更有说服力；但分析挑选了与参考蛋白相似度超过80%的生成物，不能据此概括所有生成DNA。我的理解是，这张图提供设计方法可工作的前提，真正的功能判定还要看后面的培养与救援实验。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>自然语言中同功能词共享邻词的类比，解释语义上下文概念。</td></tr><tr><td>b</td><td>基因组模型把相关功能基因放入相近语义空间，据此生成序列多样但功能相关的基因。</td></tr><tr><td>c</td><td>三个保守基因自动补全的恢复率比较，Evo1.5优于早期8k／131k模型。</td></tr><tr><td>d</td><td>正反链提示补全大肠杆菌trp操纵子，检查序列恢复与预测结构保守。</td></tr><tr><td>e</td><td>天然与生成modB的碱基／氨基酸位置熵，显示保留关键残基同时保持较高核苷酸多样性。</td></tr></tbody></table><h2 id="Figure-2：低序列相似度的功能毒素—抗毒素系统"><a href="#Figure-2：低序列相似度的功能毒素—抗毒素系统" class="headerlink" title="Figure 2：低序列相似度的功能毒素—抗毒素系统"></a>Figure 2：低序列相似度的功能毒素—抗毒素系统</h2><p><a href="/img/dl-literature/082/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/082/figure-02.webp" alt="Figure 2" width="1324" height="1234" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 2。点击图片可查看原图。</em></p><p>这一组把最关键的判定改成“生成物在细胞里做了什么”。a、b建立毒素和抗毒素的生长读数：表达毒素抑制细菌生长，加入候选抗毒素能否恢复生长；未诱导与阴性蛋白对照用于区分表达负担和特异救援。c、d显示经筛选的生成抗毒素可以救援，且不等同于天然抗毒素的交叉作用范围。e、f将结果与计算共折叠比较，目的在于考察结构预测能否解释功能配对。某些实际交叉救援并没有高置信度共折叠，因此“模型没有预测结合”并不等于“生物学没有作用”。生长恢复也尚未直接测得每一对的结合常数。</p><p>g、h的序列与结构搜索用于描述新颖程度，要分清远同源、混合来源和完全新机制。数据库无显著命中依赖搜索阈值和覆盖，不能自动推出全新折叠。i的生成毒素EvoT1具有生长抑制作用，j、k中的RNA抗毒素EvoAT6救援的是天然ToxN；论文没有证明EvoAT6能救援EvoT1，因此不能把两者合并成已经验证的全新匹配系统。还有一个实践细节：部分蛋白经宿主密码子优化后才实验表达，功能验证针对这一表达构建，不意味着未经处理的整段生成DNA可直接作为完整天然系统运行。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>先由基因组上下文生成毒素并测抑制，再以有效毒素生成配对抗毒素并测生长恢复。</td></tr><tr><td>b</td><td>II型蛋白抗毒素与III型RNA抗毒素的中和原理。</td></tr><tr><td>c</td><td>EvoRelE1与最近天然匹配的结构预测对照，检查毒素折叠。</td></tr><tr><td>d</td><td>诱导毒素后的细菌存活率，EvoAT1–4救援EvoRelE1、EvoAT6救援ToxN，直接验证配对功能。</td></tr><tr><td>e</td><td>EvoAT1–4氨基酸比对，展示离散保守区和整体多样性。</td></tr><tr><td>f</td><td>生成抗毒素对多种天然毒素的存活救援，EvoAT2／4具有跨毒素作用。</td></tr><tr><td>g</td><td>生成抗毒素与天然家族的序列／结构匹配数量，评估其新颖程度。</td></tr><tr><td>h</td><td>抗毒素—毒素复合结构及天然对照，展示低序列一致性下仍可能保持结合构型。</td></tr><tr><td>i</td><td>新毒性蛋白EvoT1的结构预测，展示无明显天然类似物候选。</td></tr><tr><td>j</td><td>EvoT1序列与结构相似性搜索，检验其不易归入已知天然蛋白。</td></tr><tr><td>k</td><td>EvoAT6的最低自由能RNA结构及序列，显示与ToxI抗毒素的共同结构特征。</td></tr></tbody></table><h2 id="Figure-3：语义生成抗CRISPR蛋白"><a href="#Figure-3：语义生成抗CRISPR蛋白" class="headerlink" title="Figure 3：语义生成抗CRISPR蛋白"></a>Figure 3：语义生成抗CRISPR蛋白</h2><p><a href="/img/dl-literature/082/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/082/figure-03.webp" alt="Figure 3" width="1316" height="1160" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 6 页，Figure 3。点击图片可查看原图。</em></p><p>抗CRISPR实验把“保护”设计成两个不同的可观测后果。a、b说明如何用相关基因上下文生成候选，并用PaCRISPR得分筛选；后者本身是监督分类模型，因此前段富集结果仍是计算预测。c展示候选多样性，为避免最终全是近似拷贝提供依据。d、e使用Cas9切割抗性质粒的生存读数，f、g再用噬菌斑检验能否抵消细胞的CRISPR防御。两种读数共享Cas9相关生物学，却改变了被保护对象和实验终点，相互支持比重复同一种得分更强。</p><p>h至k讨论五个有效候选与已知序列、结构的距离。低置信度预测结构不能承担“新折叠”的强结论；发现类似sigma因子的片段也只是机制线索。这里实验证明的是在所用菌株与表达条件下具有抗CRISPR作用，并没有逐个解析直接阻断Cas9结合、切割或表达的分子步骤。17%的实验有效率属于经过多级过滤后测试集合，不是所有随机续写的成功概率。若将这套思路迁移，实验候选数量、计算筛选率和最终有效率应分别报告，避免只保留最好的五个故事。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>抗CRISPR基因与相关aca基因的天然邻接背景，定义提示来源。</td></tr><tr><td>b</td><td>用已知Acr周围基因组上下文生成候选蛋白的流程。</td></tr><tr><td>c</td><td>PaCRISPR判断生成序列的Acr富集，检验提示导向性而非实验活性。</td></tr><tr><td>d</td><td>候选Acr序列一致性矩阵，展示生成集合的多样性。</td></tr><tr><td>e</td><td>Cas9切割抗性基因、Acr阻止切割从而恢复存活的实验流程。</td></tr><tr><td>f</td><td>EvoAcr1–5的细菌存活救援，EvoAcr3–5活性接近已知AcrIIA2，验证生成候选功能。</td></tr><tr><td>g</td><td>T4噬菌体噬斑保护实验，提供独立Acr活性读出。</td></tr><tr><td>h</td><td>EvoAcr1–2低置信度结构预测，说明不能据此强推稳定结构机制。</td></tr><tr><td>i</td><td>EvoAcr3与最近匹配蛋白结构，显示与sigma-70家族仅有限相似。</td></tr><tr><td>j</td><td>EvoAcr4–5与已知Acr对照结构，展示部分保留的形状。</td></tr><tr><td>k</td><td>BLAST与OpenGenome序列检索，区分无明显匹配、极低相似度和有限已知Acr相似的候选。</td></tr></tbody></table><h2 id="Figure-4：SynGenome生成数据的结构与功能关联"><a href="#Figure-4：SynGenome生成数据的结构与功能关联" class="headerlink" title="Figure 4：SynGenome生成数据的结构与功能关联"></a>Figure 4：SynGenome生成数据的结构与功能关联</h2><p><a href="/img/dl-literature/082/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/082/figure-04.webp" alt="Figure 4" width="1326" height="1224" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 8 页，Figure 4。点击图片可查看原图。</em></p><p>SynGenome将同一种条件生成扩大到数据库层面。a、b说明提示与生成数据规模；网站上的GO和InterPro检索首先关联的是提示来源注释，不能把这些词当成每条生成序列已经验证的功能标签。c的密码子使用、e的蛋白长度、f、g的结构域分布检查生成物是否保留总体生物学统计。它们能筛掉明显不合理的生成物，却不保证任一序列具有活性。d中主要由生成序列组成的聚类可能反映新组合，也可能反映模型偏差或采样条件，不能仅凭UMAP的分离宣布发现新功能类别。</p><p>h、i把提示结构域和响应结构域的共现变成假说图谱：一个未知功能域经常与某类已知域相邻续写，就得到可检验的功能线索。这仍然利用了训练世界中的基因邻近关系，不能把共现边直接解释为物理结合。j筛选潜在结构域融合，提出可供实验探索的组合，但没有为数据库里的融合蛋白逐一验证活性。我认为这张图的价值是生成候选与整理研究线索，而不是把数百亿碱基包装成同等强度的功能证据。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>从天然基因上下文提示生成并注释SynGenome的流程。</td></tr><tr><td>b</td><td>提示、生成序列数量及特征，说明1200亿碱基数据规模。</td></tr><tr><td>c</td><td>天然提示和生成ORF密码子偏好，检查模型保留组成特点。</td></tr><tr><td>d</td><td>主要嵌入聚类中天然／生成比例，检查生成覆盖哪些序列区域。</td></tr><tr><td>e</td><td>天然与生成ORF长度分布相近，验证基因长度结构。</td></tr><tr><td>f</td><td>两集合Pfam家族计数长尾分布，检查蛋白家族组成规律。</td></tr><tr><td>g</td><td>逐Pfam家族频率的相关，检验具体家族丰度是否保留。</td></tr><tr><td>h</td><td>提示Pfam与生成响应Pfam的富集连线，展示模型学到的功能邻接关系。</td></tr><tr><td>i</td><td>两个未知功能家族DUF的上下文关联，提出与既有假说相符的功能线索。</td></tr><tr><td>j</td><td>生成嵌合蛋白的新结构域融合例子，展示新组合候选，尚不等同已实验确认功能。</td></tr></tbody></table><h2 id="我会怎样迁移：保留条件关系，把每层结论分开"><a href="#我会怎样迁移：保留条件关系，把每层结论分开" class="headerlink" title="我会怎样迁移：保留条件关系，把每层结论分开"></a>我会怎样迁移：保留条件关系，把每层结论分开</h2><p>对AD或转座子研究，最值得迁移的是“用可解释的上下文提出候选，再用独立功能读数裁决”的组织方式，而不是直接使用原核Evo给人类序列贴病理标签。原核邻近基因的功能耦合很强，人类远程增强子、染色质状态和细胞类型依赖并不遵循相同的操纵子规律。可以先在人类模型中测试TE序列及其宿主邻域是否携带特定细胞调控信息，再让生成或变异评分服务于候选筛选；不能用模型认为自然，就替代ATAC、MPRA或疾病关联证据。</p><p>一个纯计算项目可以具体比较：相同TE家族与相近GC背景下，保留真实邻域是否改善对未见染色体调控状态的预测；将邻域交换、打乱或换成匹配非TE背景，观察信号是否消失。这样的反事实对照能够检查上下文贡献。至于生成新序列，至少分别记录序列新颖度、预测功能和已有独立实验数据支持，避免把三者写成同一结论。本篇最深的启发是：基础模型可以把自然界的关联变成候选空间，但“功能”这个词最终需要与实际测量逐一对齐。</p>]]></content>
    
    
    <summary type="html">深入读懂EvoSemanticDesign：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>81.Evo：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920051/"/>
    <id>https://perry.apay.eu.cc/posts/ad920051/</id>
    <published>2026-10-04T12:01:21.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:081 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Sequence modeling and design from molecular to genome scale with Evo</p><p><strong>期刊与年份：</strong> Science，2024。<a href="https://doi.org/10.1126/science.ado9336">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 基因组语言模型能否同时理解蛋白、RNA与DNA功能，并生成多组件生物系统？</p><h2 id="Evo-为什么把单位从分子改为基因组"><a href="#Evo-为什么把单位从分子改为基因组" class="headerlink" title="Evo 为什么把单位从分子改为基因组"></a>Evo 为什么把单位从分子改为基因组</h2><p>蛋白模型看氨基酸，RNA 模型看 RNA，调控模型看局部 DNA；但一个功能系统常由这些组分共同完成。Evo 把全部信息放在 DNA 的连续序列中，希望学习跨组分的共同变化。关于构思的推测是：原核基因常在附近排列，基因组上下文天然提供共演化线索，因此长序列模型可能比彼此分离的分子模型更适合研究系统层次的功能。这种设计在原核背景成立的条件，并不自动适用于人类复杂、远距且细胞依赖的调控结构。</p><p>模型以单碱基 token 自回归预测下一碱基，使用 70 亿参数 StripedHyena，将少数注意力层与长卷积算子组合，先以 8 kb、再以 131 kb 上下文预训练。数据是细菌、古菌、噬菌体与质粒，没有人类基因组功能标签。长卷积降低纯注意力在长序列中的计算负担，但训练仍是大规模集群工作，不能把架构高效理解成单卡可完整训练。</p><p>本文包含三类不同研究：零样本功能评分、加特定系统序列微调后的生成、长序列组织评价。它们各有独立的证据要求。语言概率描述自然序列的统计合理性，不直接等同于活性、必需性或可存活性；只有与真实实验比较或验证的部分，才进入相应功能结论。</p><h2 id="Figure-1：原核基因组基础模型预训练"><a href="#Figure-1：原核基因组基础模型预训练" class="headerlink" title="Figure 1：原核基因组基础模型预训练"></a>Figure 1：原核基因组基础模型预训练</h2><p><a href="/img/dl-literature/081/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/081/figure-01.webp" alt="Figure 1" width="1320" height="852" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 1。点击图片可查看原图。</em></p><p>A 是跨模态研究的愿景，B 是实现方式，C–E 则限定了模型真正见过的生物范围。分类群与基因组长度不均衡会影响学到的先验，所谓覆盖广不能解释为每类生物同样可靠。F、G 在相近计算预算下比较多种架构的困惑度缩放，支持 StripedHyena 的工程选择；这个胜出是给定数据、单碱基分辨率及预算下的结果，不证明它对所有监督 DNA 任务优于 Transformer。</p><p>困惑度降低说明下一碱基预测改善，是否增加功能信息，需要图 2 和图 5 另检验。参数与训练数据扩大会耗费不同资源，compute-optimal 曲线提醒我们，模型大小不应脱离训练 token 数讨论。个人项目可以借鉴这种预算意识，而不是把最大公开模型当作默认起点。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>DNA同时编码调控序列、蛋白和RNA及跨基因关系，说明基因组层级建模的目标。</td></tr><tr><td>B</td><td>自回归预测下一碱基的StripedHyena架构，结合注意力和长序列算子。</td></tr><tr><td>C</td><td>70亿参数Evo的细菌、古菌及病毒训练数据来源，定义模型见过的生物范围。</td></tr><tr><td>D</td><td>GTDB基因组长度分布，说明长上下文需求。</td></tr><tr><td>E</td><td>GTDB界与门的组成，展示训练分类群覆盖及不均衡。</td></tr><tr><td>F</td><td>模型规模增加时困惑度下降，比较不同架构的DNA预训练缩放规律。</td></tr><tr><td>G</td><td>在最优计算分配下比较架构缩放速度，用于选择Evo的结构和规模。</td></tr></tbody></table><h2 id="Figure-2：蛋白、非编码RNA和调控DNA的功能预测"><a href="#Figure-2：蛋白、非编码RNA和调控DNA的功能预测" class="headerlink" title="Figure 2：蛋白、非编码RNA和调控DNA的功能预测"></a>Figure 2：蛋白、非编码RNA和调控DNA的功能预测</h2><p><a href="/img/dl-literature/081/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/081/figure-02.webp" alt="Figure 2" width="1320" height="802" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 5 页，Figure 2。点击图片可查看原图。</em></p><p>A、C 定义突变扫描的实测功能读出，B、D 用多个蛋白和 ncRNA 数据集比较零样本概率排序。它们支持同一 DNA 模型包含多类功能信息，却主要来自原核系统；作者在人类蛋白 DMS 上表现有限，直接否定了“天然可用于所有人类疾病”的推论。概率与功能相关也并非功能校准，尤其不同研究的 fitness 含义不同。</p><p>E–G 必须区分直接似然和有标签训练的回归&#x2F;CNN。Evo 特征加 CNN 表现改善，说明表示有价值，不能把这部分称为零样本。启动子与 RBS 合并后蛋白表达排序更好，支持上下文互补；GC 等简单组成也具有不低相关，必须保留这些基线，才能判断模型新增的信息。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>蛋白深度突变扫描实测适应度对语言模型似然的评估流程。</td></tr><tr><td>B</td><td>九套原核蛋白DMS上的相关，比较DNA语言模型和蛋白模型的零样本功能预测。</td></tr><tr><td>C</td><td>非编码RNA突变功能预测的对应评估流程。</td></tr><tr><td>D</td><td>七套ncRNA DMS相关，检验同一DNA模型能否理解RNA功能。</td></tr><tr><td>E</td><td>调控序列对应mRNA／蛋白表达的评估流程。</td></tr><tr><td>F</td><td>四套启动子活性的零样本、GC和监督模型比较，检验Evo表示及直接似然的作用。</td></tr><tr><td>G</td><td>约12000个启动子—RBS组合的蛋白表达预测，联合提供两段序列时Evo表现更好。</td></tr></tbody></table><h2 id="Figure-3：生成CRISPR蛋白—RNA复合系统"><a href="#Figure-3：生成CRISPR蛋白—RNA复合系统" class="headerlink" title="Figure 3：生成CRISPR蛋白—RNA复合系统"></a>Figure 3：生成CRISPR蛋白—RNA复合系统</h2><p><a href="/img/dl-literature/081/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/081/figure-03.webp" alt="Figure 3" width="1320" height="798" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 6 页，Figure 3。点击图片可查看原图。</em></p><p>A、B 的生成任务在基因组底座上加入特定系统微调与条件 token，C 的类别控制证明提示能改变生成内容，D 的相似度体现多样性。低相似度不是可靠功能的保证。E–J 中真正的功能证据是 F 的体外切割与非靶向向导控制；G–J 的 RNA、蛋白和复合物结构是计算预测，增加合理性但不替代活性测量。</p><p>验证候选来自约两百万生成序列的多层筛选，最终测试 11 个系统，一个显示稳健活性。因此不能把 1&#x2F;11 解读为随机生成的原始成功率。筛选使用序列注释、结构置信及人工检查，说明生成模型之外的领域知识非常重要。体外目标上的活性也不等于细胞内编辑效率或全基因组脱靶安全性。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>共同生成Cas蛋白与非编码RNA的任务示意。</td></tr><tr><td>B</td><td>Evo用CRISPR基因组片段与Cas类型条件token微调，定义定向生成策略。</td></tr><tr><td>C</td><td>不同Cas提示生成的主要Cas类别，检验条件控制。</td></tr><tr><td>D</td><td>仅专用训练对基础模型微调的蛋白序列相似度分布，评估生成多样性。</td></tr><tr><td>E</td><td>EvoCas9-1生成位点的蛋白与RNA注释，显示系统组件共同出现。</td></tr><tr><td>F</td><td>EvoCas9-1和SpCas9体外切割时间曲线及不匹配向导对照，验证生成系统的活性和特异性。</td></tr><tr><td>G</td><td>生成sgRNA二级结构及与天然参考差异，展示RNA组件的结构。</td></tr><tr><td>H</td><td>生成Cas9蛋白结构预测与SpCas9晶体比对，检查折叠合理性。</td></tr><tr><td>I</td><td>生成sgRNA结构预测对天然晶体RNA，比较RNA几何构型。</td></tr><tr><td>J</td><td>生成Cas9与共同设计sgRNA的复合结构预测，展示组件配合；此处为计算预测。</td></tr></tbody></table><h2 id="Figure-4：生成转座蛋白、RNA和DNA末端系统"><a href="#Figure-4：生成转座蛋白、RNA和DNA末端系统" class="headerlink" title="Figure 4：生成转座蛋白、RNA和DNA末端系统"></a>Figure 4：生成转座蛋白、RNA和DNA末端系统</h2><p><a href="/img/dl-literature/081/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/081/figure-04.webp" alt="Figure 4" width="1320" height="1246" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 8 页，Figure 4。点击图片可查看原图。</em></p><p>A–C 解释为何移动元件是跨组分建模的合适案例：蛋白与两端 DNA 的匹配，部分系统还包含 RNA 组分。D 定义实验如何识别切出和插入产物，E&#x2F;F&#x2F;G 与 H&#x2F;I&#x2F;J 各组成一个设计—活性—产物序列的链条。催化位点失活和不同底物类型提供关键机制控制，纳米孔测得连接产物比仅看到一条凝胶带更具体。</p><p>验证主要支持 TnpA 与共同设计 DNA 末端的体外功能。更复杂元件中 TnpB、RNA 的序列或结构预测，没有因此全部完成各自功能验证。候选仍经过天然系统相似性和结构筛选，11&#x2F;24、3&#x2F;24 的成功比例属于筛选后的两组设计。这里研究细菌转座系统，不能直接把其活动机制转移到人类 LINE、SINE 或 LTR 对 AD 的调控影响。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>IS200／IS605的TnpA、末端发夹及可选TnpB-RNA组件，说明多模态设计任务。</td></tr><tr><td>B</td><td>使用天然IS200／IS605片段微调Evo的流程。</td></tr><tr><td>C</td><td>生成TnpA／TnpB与训练集最相近蛋白的序列一致性分布，检验新颖程度。</td></tr><tr><td>D</td><td>体外转座切出与插入产物PCR检测示意，定义实验读出。</td></tr><tr><td>E</td><td>ISEvo1生成元件的DNA与蛋白组成，展示设计实例。</td></tr><tr><td>F</td><td>ISEvo1凝胶证明单链DNA底物上的活性依赖催化Y124，双链底物活性较低。</td></tr><tr><td>G</td><td>ISEvo1产物的纳米孔读段，验证连接产物序列。</td></tr><tr><td>H</td><td>ISEvo2生成元件的DNA、RNA与蛋白组成，展示更复杂系统。</td></tr><tr><td>I</td><td>ISEvo2凝胶证明单链底物活性依赖Y125，检验另一生成实例。</td></tr><tr><td>J</td><td>ISEvo2产物纳米孔读段，确认转座相关连接结果。</td></tr></tbody></table><h2 id="Figure-5：全基因组突变评分预测基因必需性"><a href="#Figure-5：全基因组突变评分预测基因必需性" class="headerlink" title="Figure 5：全基因组突变评分预测基因必需性"></a>Figure 5：全基因组突变评分预测基因必需性</h2><p><a href="/img/dl-literature/081/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/081/figure-05.webp" alt="Figure 5" width="1320" height="502" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 9 页，Figure 5。点击图片可查看原图。</em></p><p>A 是继续训练后的上下文扩展，B 将提前终止引入基因，再比较变异与原序列概率；C 用真实必需基因标签评价，但这些标签没有参与该评分的训练。增加到 8 kb 后通常明显改善，继续到 66 kb 的平均收益有限、部分难例改善，说明“更长”不是每个任务都单调提升。</p><p>D 的两个具体物种表现较好，还需与 C 的全部研究分布一起读，不能只取最好案例。位置和保守性控制帮助排除简单替代解释，但长上下文收益可能含操纵子、功能类别与邻域组成，不足以声称模型已逐一识别所有基因相互作用。必需性依赖实验生长条件，原核结果也不是人类组织中的基因必需性或 AD 风险。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>从8k训练扩到131k上下文的阶段，说明基因组任务的长度适配。</td></tr><tr><td>B</td><td>对每个基因引入提前终止，用突变／原序列似然比预测必需性，定义筛选。</td></tr><tr><td>C</td><td>58套细菌／噬菌体实验的AUROC，加入8k基因组环境明显改善，66k在部分研究进一步提高。</td></tr><tr><td>D</td><td>λ噬菌体及铜绿假单胞菌必需／非必需基因评分分布，展示具体物种区分。</td></tr></tbody></table><h2 id="Figure-6：长生成序列的基因组结构合理性"><a href="#Figure-6：长生成序列的基因组结构合理性" class="headerlink" title="Figure 6：长生成序列的基因组结构合理性"></a>Figure 6：长生成序列的基因组结构合理性</h2><p><a href="/img/dl-literature/081/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/081/figure-06.webp" alt="Figure 6" width="1320" height="1028" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 10 页，Figure 6。点击图片可查看原图。</em></p><p>A 的物种提示来自训练时的分类条件，B、C 对比编码密度和同链成簇，D、E 为预测蛋白寻找结构与功能相似，F–H 检查组成和终止密码子规则。这些检查说明生成比均匀随机序列更像天然原核基因组；随机背景较容易区分，不能代替与更强生成或重排控制的比较。</p><p>关键限制在正文中很明确：生成序列缺失许多保守标记基因，rRNA 很少，许多结构预测置信度低，并未重建可存活的完整基因组。GO 类别来自预测结构与天然蛋白匹配，也不是逐个蛋白的实测功能。百万碱基生成超过上下文长度，模型需连续采样，局部语法可能正确而全局协调不足。图的精美组织外观不应遮住这个边界。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>用物种token生成约650kb序列的流程，定义长生成任务。</td></tr><tr><td>B</td><td>生成、天然及随机序列的编码密度分布，检查生成是否保留天然基因组织。</td></tr><tr><td>C</td><td>131kb区域的基因箭头方向，生成和天然序列都出现同链成簇的操纵子样结构。</td></tr><tr><td>D</td><td>约1Mb生成序列的基因布局，展示长距离组织。</td></tr><tr><td>E</td><td>生成蛋白结构预测及相似天然蛋白功能类别，检查候选基因的结构／功能合理性。</td></tr><tr><td>F</td><td>生成对天然基因组四核苷酸使用偏差TUD的相关，检验物种组成特点。</td></tr><tr><td>G</td><td>基于TUD的层次聚类，检查生成序列是否接近对应物种。</td></tr><tr><td>H</td><td>三种阅读框终止密码子使用比例，比较编码规则；这些结构分析本身不等于整段生成基因组已经可存活。</td></tr></tbody></table><h2 id="我会借鉴的部分与暂不适合照搬的部分"><a href="#我会借鉴的部分与暂不适合照搬的部分" class="headerlink" title="我会借鉴的部分与暂不适合照搬的部分"></a>我会借鉴的部分与暂不适合照搬的部分</h2><p>本文最值得迁移的是“共同上下文包含组分协调信息”的问题意识。研究 TE 调控时，可以同时描述元件自身序列与附近调控区，比较局部模型和带邻域模型对独立实验效应的增益，再追问增益来自哪一类关系。这样的消融能把长上下文从口号变成可检验假说。</p><p>对纯计算 AD 项目，优先使用经过人类数据验证的较小模型，Evo 可作为方法思想或原核模型对照，不能仅因它能生成转座系统就视为最佳 AD 底座。16 GB 显存也不支持原样重做这套训练；量化推理、冻结特征和小模型蒸馏都需要实际兼容性与任务验证。更现实的创新是证明一种 TE 内部或邻域的协调特征在独立供体中关联病理，并能解释 MPRA 的等位效应，而不是从“模型更大”推出“机制更深”。</p><p>这些层次在报告结论时应分别列出。</p>]]></content>
    
    
    <summary type="html">深入读懂Evo：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>80.GPN：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920050/"/>
    <id>https://perry.apay.eu.cc/posts/ad920050/</id>
    <published>2026-10-04T12:01:20.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:080 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> DNA language models are powerful predictors of genome-wide variant effects</p><p><strong>期刊与年份：</strong> PNAS，2023。<a href="https://doi.org/10.1073/pnas.2311219120">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 无需功能标签的DNA语言模型能否预测全基因组变异效应？</p><h2 id="不用功能标签，为什么仍可能知道变异有影响"><a href="#不用功能标签，为什么仍可能知道变异有影响" class="headerlink" title="不用功能标签，为什么仍可能知道变异有影响"></a>不用功能标签，为什么仍可能知道变异有影响</h2><p>如果一个序列位置在相似上下文中通常出现某种碱基，另一种碱基可能破坏被进化保留的模式。GPN 将这个直觉变成遮盖预测：不使用实验功能标签，单凭多个近缘物种未比对的参考基因组学习条件分布。本文主要证据来自拟南芥及七个近缘十字花目物种，没有直接验证人类 AD。对研究构思的推测是：蛋白语言模型已有无标签变异评分经验，作者试图将它扩展到全基因组、不同机制的变异，并摆脱非编码区多物种比对的覆盖限制。</p><p>GPN 输入 512 bp 的单碱基 token，以 25 层残差膨胀卷积生成每个位置的上下文表示，交叉熵学习被遮盖的 15% 碱基。评分时仅遮盖变异位置，计算 log P(ALT)&#x2F;P(REF)，越负表示替代等位更不符合学到的上下文。它并不直接拟合适应度、细胞类型或疾病风险，正值也不意味着有益。训练窗口偏重外显子与启动子，并对重复区损失降低权重，所以所谓无监督并不等于没有采样和生物学先验。</p><p>这是“自监督序列规律—零标签变异评分—独立群体&#x2F;关联证据检验”的范式。它与用自监督权重再加病理分类头不同，评价标签在本文主要用于检验评分，而非训练疾病预测器。卷积能高效整合短程序列，选择它也表明 DNA 语言模型不必等同于 Transformer。</p><h2 id="Figure-1：GPN遮盖碱基预测与变异评分"><a href="#Figure-1：GPN遮盖碱基预测与变异评分" class="headerlink" title="Figure 1：GPN遮盖碱基预测与变异评分"></a>Figure 1：GPN遮盖碱基预测与变异评分</h2><p><a href="/img/dl-literature/080/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/080/figure-01.webp" alt="Figure 1" width="630" height="773" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 2 页，Figure 1。点击图片可查看原图。</em></p><p>无字母的流程图同时定义训练与使用时的任务，二者都问给定背景下该出现哪个碱基。单碱基 token 让参考、替代概率的含义明确，避免重叠 k-mer 造成解释困难。预测分数具有跨注释类别排序的便利，但“同一数轴”不代表各类别分数同等校准为致病概率。局部序列统计受到突变偏好、重复复制和参考等位选择影响，功能约束只是来源之一。</p><p>训练时 A. thaliana 第四、第五染色体留作验证与测试，但近缘物种中的同源片段仍可能帮助预测，这是跨物种学习的设计。若要检验对完全新调控语法的发现，应另建按同源簇或家族留出的任务，而不是把染色体留出视为所有层次的独立性保证。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>全图（无字母）</td><td>512bp序列经卷积预测遮盖碱基概率，变异效应用替代／参考等位对数似然比，无需功能标签；本篇主要验证拟南芥模型。</td></tr></tbody></table><h2 id="Figure-2：无监督表示区分基因组区域"><a href="#Figure-2：无监督表示区分基因组区域" class="headerlink" title="Figure 2：无监督表示区分基因组区域"></a>Figure 2：无监督表示区分基因组区域</h2><p><a href="/img/dl-literature/080/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/080/figure-02.webp" alt="Figure 2" width="641" height="1146" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 2。点击图片可查看原图。</em></p><p>A 平均 100 bp 表示后用 UMAP，并根据已知注释着色；分离出编码、内含子等说明表示含有结构信息，不意味着模型自己命名了这些类别。B 加逻辑回归并按染色体验证，是有标签的下游探针，定量检验可读出的信息。它和自监督骨干的训练应清楚区分。</p><p>注释模糊的窗口被排除，重复区又作为特定类别分析，因此这个混淆矩阵反映较清楚区域上的判别。中间层分群可由 GC、三联体周期、长度和重复家族驱动，作者与 k-mer 基线比较是必要的一步。若把方法用到 AD 细胞状态，不能仅凭 UMAP 中病理颜色分离就宣称新机制；要检验供体、技术和家族组成能否同样解释这种结构。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>100bp区域嵌入UMAP按注释着色，检查无监督学习是否自动分离编码、内含子等区域。</td></tr><tr><td>B</td><td>嵌入加逻辑回归的区域分类混淆矩阵，并跨染色体验证，定量评估表示中的注释信息。</td></tr></tbody></table><h2 id="Figure-3：概率logo与启动子模体发现"><a href="#Figure-3：概率logo与启动子模体发现" class="headerlink" title="Figure 3：概率logo与启动子模体发现"></a>Figure 3：概率logo与启动子模体发现</h2><p><a href="/img/dl-literature/080/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/080/figure-03.webp" alt="Figure 3" width="966" height="905" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 3。点击图片可查看原图。</em></p><p>A 的概率 logo 是每个位置独立遮盖后得到的分布，高度反映确定性，不是传统物种频率 logo，也不是归因贡献。编码前两位与剪接端点通常更确定，符合功能约束的预期，但易预测的重复模式同样可以很确定。B 从启动子高置信区域寻找模体，再与数据库匹配，提供不依赖 TF 实验标签的候选发现方式。</p><p>模体发现过程过滤了重复与编码外显子，强调的是特定背景下的调控模式。未匹配的回文结构可提出 DNA&#x2F;RNA 二级结构假说，但尚未测得这种结构或功能。将它迁移到 TE 时不能照搬过滤再声称研究了 TE 语法，应重新定义家族内背景与去冗余策略，避免简单的复制保守性主导模体发现。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>浏览器中的逐碱基概率logo，高度反映预测确定性，展示剪接／编码等位置的上下文约束。</td></tr><tr><td>B</td><td>从高置信启动子片段发现的代表模体，展示已知匹配及候选新模式；仅凭模体发现不能证明新功能。</td></tr></tbody></table><h2 id="Figure-4：不同变异类型的预测效应"><a href="#Figure-4：不同变异类型的预测效应" class="headerlink" title="Figure 4：不同变异类型的预测效应"></a>Figure 4：不同变异类型的预测效应</h2><p><a href="/img/dl-literature/080/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/080/figure-04.webp" alt="Figure 4" width="641" height="689" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 5 页，Figure 4。点击图片可查看原图。</em></p><p>一段测试染色体中的全部可能 SNV 按注释比较，破坏剪接、终止与起始等类别低分，为评分的生物合理性提供检查。排序依据分布的低百分位，不是各类变异的临床敏感度。标签由基因注释推断，同一类内部效应仍不同；这张图也没有直接制造突变测量结果。</p><p>重复区是本图最有启发的例外：年轻家族的相似拷贝可能使模型过于确信共识序列，任何偏离都得到很低分，但偏离未必降低个体适应度。作者通过降低重复损失减少这种过度评分，并承认只是部分缓解。对用户的 TE 研究，这不是可以忽略的噪声，而是需要单独解释、建立外部功能评价的核心问题。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>全图（无字母）</td><td>1Mb区域全部可能SNV按类型展示分数分布，剪接、终止获得、起始丢失等通常更低，检验评分是否符合功能破坏的预期排序。</td></tr></tbody></table><h2 id="Figure-5：低分变异与群体稀有性的关系"><a href="#Figure-5：低分变异与群体稀有性的关系" class="headerlink" title="Figure 5：低分变异与群体稀有性的关系"></a>Figure 5：低分变异与群体稀有性的关系</h2><p><a href="/img/dl-literature/080/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/080/figure-05.webp" alt="Figure 5" width="804" height="699" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 5 页，Figure 5。点击图片可查看原图。</em></p><p>A–C 用自然群体中的罕见&#x2F;常见变异做独立检验，低分富集于罕见变异，与净化选择一致。这里“罕见”是单个纯合材料携带，“常见”是频率阈值，不能把植株群体定义直接换算成人类患者诊断。稀有性还受突变率、人口历史与检测影响，因此不是金标准有害标签。</p><p>D 与保守分数比较时先限制到共同可评分区域，减少覆盖差异的不公平；极端尾部优势较明显，在宽松阈值或不同注释类别中未必总胜出。分析把频率超过一半的替代等位转换为次要等位方向，说明参考碱基不一定是普遍或祖先状态。复用评分时应保留等位方向，避免将符号错读为固定参考有益、替代有害。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>1001基因组超过千万变异的GPN分布，大多数接近中性，负尾部为候选功能变异。</td></tr><tr><td>B</td><td>不同分数区间的平均等位频率，低分平均更罕见，符合净化选择预期。</td></tr><tr><td>C</td><td>低分候选在稀有对常见变异中的列联表和优势比，定量检验富集。</td></tr><tr><td>D</td><td>GPN与phyloP、phastCons的富集比较，检验模型相对传统保守分数的效果。</td></tr></tbody></table><h2 id="Figure-6：GPN结合连锁信息识别GWAS关联"><a href="#Figure-6：GPN结合连锁信息识别GWAS关联" class="headerlink" title="Figure 6：GPN结合连锁信息识别GWAS关联"></a>Figure 6：GPN结合连锁信息识别GWAS关联</h2><p><a href="/img/dl-literature/080/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/080/figure-06.webp" alt="Figure 6" width="942" height="890" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 6 页，Figure 6。点击图片可查看原图。</em></p><p>A–C 用 LD 加权后更容易覆盖 GWAS 命中，评价的是与关联信号的相符程度。GPN×LD 的实际计算为附近变异绝对分数乘 r² 再求和、加负号，信号会在连锁邻域传播；它不是把 LD 从每个变异中消除，也不是直接确定因果位点。高富集说明重要序列邻域更常有表型关联，不能把一个被传播到的高分标签 SNP 当成已精细定位的原因。</p><p>D 保留共同比对范围，E 扩展到所有可评分变异，分别回答排序能力和覆盖价值。未比对区的收益确实突出，但可能混合重排、局部适应与传统方法缺失等来源。只有在真实因果位点标签或精细定位的独立验证下，才能进一步证明同一关联区域内的排序更好。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>示例区域六个变异的关联及GPN×LD分数，展示连锁校正后能区分关联与非关联变异。</td></tr><tr><td>B</td><td>GPN和GPN×LD各分位的GWAS命中比例，检验使用LD的收益。</td></tr><tr><td>C</td><td>低分GPN×LD候选的GWAS富集列联表，量化关联识别。</td></tr><tr><td>D</td><td>可跨物种比对变异集合上不同方法的优势比，进行共同覆盖范围的比较。</td></tr><tr><td>E</td><td>完整变异集合的优势比，展示GPN还能覆盖传统保守评分无法比对的区域。</td></tr></tbody></table><h2 id="对转座子研究最直接的启发"><a href="#对转座子研究最直接的启发" class="headerlink" title="对转座子研究最直接的启发"></a>对转座子研究最直接的启发</h2><p>本文提供了一个具体、可检验的创新入口：比较 TE 家族及年龄分层的语言概率，判断模型究竟学习了复制共识还是功能选择，再使用独立开放度、等位偏倚或 MPRA 效应来区分。需要按家族&#x2F;同源簇留出，并与共识距离、GC、拷贝年龄和可比对性等简单基线比较。异常分数只有在预测真实调控效应时才有生物学价值，否则只是“长得不典型”。</p><p>对 AD，可先得到不含疾病标签的序列表征，随后冻结模型，检验候选 WGS 在相应细胞调控模块中的富集与功能方向。不能仅凭全基因组无监督评分和 AD GWAS 重叠就声称疾病机制。原始训练使用四张 80 GB A100，论文小于巨型蛋白模型的相对规模并不能证明本机原样训练可行；实际可行路径是预训练特征、小模型及严格留出验证。</p>]]></content>
    
    
    <summary type="html">深入读懂GPN：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>79.DNABERT：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad92004f/"/>
    <id>https://perry.apay.eu.cc/posts/ad92004f/</id>
    <published>2026-10-04T12:01:19.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:079 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> DNABERT: pre-trained Bidirectional Encoder Representations from Transformers model for DNA-language in genome</p><p><strong>期刊与年份：</strong> Bioinformatics，2021。<a href="https://doi.org/10.1093/bioinformatics/btab083">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> DNA语言预训练能否统一改善启动子、TF结合、剪接和功能变异识别？</p><h2 id="“DNA-语言”在本文中具体指什么"><a href="#“DNA-语言”在本文中具体指什么" class="headerlink" title="“DNA 语言”在本文中具体指什么"></a>“DNA 语言”在本文中具体指什么</h2><p>不同任务都需要识别局部模式及其上下文，标注数据却昂贵；DNABERT 尝试先从无标注基因组学习表示，再用较少功能标签微调。这是本文的核心研究范式。对 idea 的形成，我的推测是：自然语言的预训练成功启发作者把“先学序列统计、后学任务”的成本拆开，复用同一初始化。但 DNA 与语言的相似只是建模比喻，预测性能不能证明模型已经拥有对所有调控机制的“语义理解”。</p><p>DNA 被拆成重叠 k-mer，四个版本使用 3–6 mer，词表包含所有可能组合及特殊 token。12 层 Transformer 读取约 512 token 的上下文，通过遮盖连续 k 个 token、预测原 token 的交叉熵预训练。连续遮盖很重要：邻近重叠 k-mer 泄露同一碱基，单独遮盖一个 token 会使任务过于简单。启动子、结合、剪接各有自己的监督微调模型；共享的是预训练参数，不是一个未经修改的模型同时输出全部功能。</p><p>全局注意力仅覆盖输入窗口，本文的常规长度仍是数百碱基。DNABERT-XL 把长序列分块后拼接表示，不能直接等同于所有远距碱基之间都经完整注意力交互。原始预训练用了八张 2080Ti、约 25 天，个人设备更适合复用权重做小规模微调或冻结特征。</p><h2 id="Figure-1：DNABERT架构与预训练特点"><a href="#Figure-1：DNABERT架构与预训练特点" class="headerlink" title="Figure 1：DNABERT架构与预训练特点"></a>Figure 1：DNABERT架构与预训练特点</h2><p><a href="/img/dl-literature/079/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/079/figure-01.webp" alt="Figure 1" width="1240" height="680" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 2 页，Figure 1。点击图片可查看原图。</em></p><p>a 展示不同信息传播方式，作为选择 Transformer 的动机；卷积只能局部的概括并不适用于所有架构，因为膨胀卷积、深层叠加也能扩大感受野。b、c 的读出与训练任务要分别看：遮盖位置输出用于自监督词预测，CLS 用于微调后的序列分类。d 的多头关注相距较远区域，表明模型可建立输入内部依赖，但关注线不是 DNA 实际接触，也不是蛋白协同的直接证据。</p><p>重叠 token 会让一个碱基对应多个表示，因此所谓核苷酸级注意力是聚合后的解释。若用它定位功能位点，需说明聚合方法，并与替换后的输出变化或独立实验比较，不能仅凭高亮位置下机制结论。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>RNN、CNN与Transformer的上下文传播示意，解释全局注意力的建模方式。</td></tr><tr><td>b</td><td>k-mer及特殊token经过12层Transformer，分别执行整序列或遮盖token预测，定义架构。</td></tr><tr><td>c</td><td>通用DNA预训练再按任务微调，展示同一表示适配多任务。</td></tr><tr><td>d</td><td>12注意力头聚焦两个已知结合区的实例，展示模型能学到非局部序列关联。</td></tr></tbody></table><h2 id="Figure-2：启动子识别"><a href="#Figure-2：启动子识别" class="headerlink" title="Figure 2：启动子识别"></a>Figure 2：启动子识别</h2><p><a href="/img/dl-literature/079/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/079/figure-02.webp" alt="Figure 2" width="608" height="755" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 2。点击图片可查看原图。</em></p><p>a 将 TATA、非 TATA 与合并集合分开，检查网络是否只认最典型模体。b 转向扫描长区域，阳性稀少、背景更复杂，F1 和 MCC 比平衡分类准确率更接近应用难度。c–f 同时看 ROC 与 PR，g 再减少核心启动子的上下文，形成任务难度的递进。</p><p>数据构造决定结论边界：300 bp 非 TATA 阴性含二核苷酸打乱序列，区分真序列和打乱序列可能比区分真实基因组中的相似非启动子容易；长扫描按既定 TSS 距离和窗口重叠定义阳性。这里的领先支持这些基准上的启动子识别，不能直接等同于未注释启动子的体内活性确认，也不预测哪个细胞中会使用该启动子。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>TATA、非TATA和全部300bp启动子上的准确率、F1、MCC，比较模型。</td></tr><tr><td>b</td><td>不同扫描设置的F1和MCC，检验实际基因组启动子搜索。</td></tr><tr><td>c</td><td>TATA启动子ROC，比较阳性检出与误报。</td></tr><tr><td>d</td><td>非TATA启动子ROC，检验缺乏典型TATA代码时的识别。</td></tr><tr><td>e</td><td>TATA启动子精确率—召回率曲线，检查阳性预测质量。</td></tr><tr><td>f</td><td>非TATA启动子精确率—召回率曲线。</td></tr><tr><td>g</td><td>核心启动子子集的准确率、F1、MCC，评估更局部序列的识别。</td></tr></tbody></table><h2 id="Figure-3：690套TF结合数据的模型基准"><a href="#Figure-3：690套TF结合数据的模型基准" class="headerlink" title="Figure 3：690套TF结合数据的模型基准"></a>Figure 3：690套TF结合数据的模型基准</h2><p><a href="/img/dl-literature/079/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/079/figure-03.webp" alt="Figure 3" width="610" height="1038" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 3。点击图片可查看原图。</em></p><p>六个分布汇总 690 套 ChIP 数据，比只展示少数最优 TF 更有说服力。准确率、精确率、召回率、F1、MCC、AUC 回答不同问题；配对检验说明跨数据集的差异稳定，但极小 P 值主要来自大量比较对象，仍要看实际增益与难例分布。690 个实验也可能共享 TF、细胞或相近区域，并非 690 次完全独立的生物学机制验证。</p><p>每个任务需微调，标签是实验峰定义下的结合分类。对低质量 ChIP 的高分类性能，有时意味着恢复了标签中的统计规律，不自动证明模型比实验更接近真实结合。严格重做时应核查染色体或相近序列留出、负例构造以及与基线相同的数据处理；正文简述不够支持把这套结果推广为全基因组未知位点的统一准确率。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>左上准确率</td><td>690套ENCODE ChIP数据的准确率分布，比较整体分类正确率。</td></tr><tr><td>右上精确率</td><td>阳性预测中真实结合比例的分布，检验误报。</td></tr><tr><td>左中召回率</td><td>真实结合位点检出比例，检验漏报。</td></tr><tr><td>右中F1</td><td>精确率与召回率的综合表现。</td></tr><tr><td>左下MCC</td><td>在类别不均衡下更完整的分类相关指标。</td></tr><tr><td>右下AUC</td><td>跨阈值排序能力的分布；全图用配对统计比较模型，而非只选几个实例。</td></tr></tbody></table><h2 id="Figure-4：注意力与序列上下文解释"><a href="#Figure-4：注意力与序列上下文解释" class="headerlink" title="Figure 4：注意力与序列上下文解释"></a>Figure 4：注意力与序列上下文解释</h2><p><a href="/img/dl-literature/079/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/079/figure-04.webp" alt="Figure 4" width="1240" height="460" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 5 页，Figure 4。点击图片可查看原图。</em></p><p>a 的功能位点与不结合区、b 的典型启动子定位，使注意力有生物学参照。c、d 显示高质量数据的聚焦与疑虑数据的分散，提醒解释图也会受数据质量和位置偏好影响。d 只在开头集中注意力的现象尤其不能硬解释成一种新功能。e 的线将 CTT token 与其他位置相连，是网络内部加权关系；调节阈值只改变展示范围，不能产生更强的因果证据。</p><p>本文以注意力发现并匹配模体，能够提出候选区域，但注意力、特征贡献、实际干预效应并不相同。模型可用冗余特征、不同头可产生相似输出，高注意力也未必意味着删掉后损失最大。若要判断模体协同，应比较单点和双点替换的预测交互，再用实验检验，不能把图中的连线命名为真实调控连接。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>两个验证的TAp73-beta结合位点和不结合区的注意力，检查解释是否区分功能序列。</td></tr><tr><td>b</td><td>TATA及非TATA启动子的注意力景观，观察模型关注位置。</td></tr><tr><td>c</td><td>高质量CTCF数据的注意力景观，展示清楚的模式定位。</td></tr><tr><td>d</td><td>质量有疑虑的SMARCA4数据注意力，提醒数据质量会影响解释。</td></tr><tr><td>e</td><td>p53位点多头注意力及CTT token不同阈值联系，展示关键序列间上下文关系。</td></tr></tbody></table><h2 id="Figure-5：剪接位点识别"><a href="#Figure-5：剪接位点识别" class="headerlink" title="Figure 5：剪接位点识别"></a>Figure 5：剪接位点识别</h2><p><a href="/img/dl-literature/079/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/079/figure-05.webp" alt="Figure 5" width="610" height="693" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 6 页，Figure 5。点击图片可查看原图。</em></p><p>a–c 不满足于容易的初始剪接集合，而加入此前误分类的相似负例，检验模型是否识别了上下文而非只记 GT&#x2F;AG。这是很好的基准设计思路。结果支持剪接位点分类，却没有在图中量化患者变异引起的 PSI 或组织特异剪接，也没有恢复完整转录本结构。</p><p>循环引入难例还要求严守训练、开发与测试分工：如果根据测试错误持续改数据或调模型，最终指标会乐观。论文另报告留出的扫描序列，复现时仍要检查基因同源性和重叠窗口是否隔离。对于 AD，可借鉴“有典型模体但无功能”的难例控制，而不是直接把剪接分类分数差称为疾病效应。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>供体、受体的多类准确率、F1、MCC与多种传统方法比较。</td></tr><tr><td>b</td><td>供体ROC和精确率—召回率，检验跨阈值识别能力。</td></tr><tr><td>c</td><td>受体对应曲线，检查另一端剪接信号。</td></tr></tbody></table><h2 id="Figure-6：功能变异、预训练与跨物种迁移"><a href="#Figure-6：功能变异、预训练与跨物种迁移" class="headerlink" title="Figure 6：功能变异、预训练与跨物种迁移"></a>Figure 6：功能变异、预训练与跨物种迁移</h2><p><a href="/img/dl-literature/079/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/079/figure-06.webp" alt="Figure 6" width="1240" height="1343" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 7 页，Figure 6。点击图片可查看原图。</em></p><p>a–c 是疾病已知或关联变异上的模型解释个例。MYO7A 删除有已知 Usher 综合征背景，但作者明确说 CTCF 联系待确定；SUMF1 起始密码子变异有编码层机制，同时预测 YY1 位点改变，其调控后果未知。不能把既有疾病标签反过来证明 CTCF&#x2F;YY1 机制就是致病原因。XPC 的常见风险关联也还需排除连锁与其他作用。</p><p>d 比较相同超参数下的微调损失，支持预训练使优化更顺利；随机初始化未经过同等充分的独立调参时，不能据此证明只有预训练才能完成任务。e 的注意力逐渐聚焦是过程可视化。f 先用小鼠功能标签微调，再评估 78 套任务，所以跨物种结果是初始化迁移，而不是零标签跨物种功能预测。图中这些证据各自成立，却不能合并成一个模型已经证明了全部疾病变异因果。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>MYO7A内CTCF位点罕见删除的注意力、差值和logOR突变图，预测结合位点被破坏。</td></tr><tr><td>b</td><td>SUMF1起始密码子处SNV的突变图，展示同时破坏YY1位点的调控解释。</td></tr><tr><td>c</td><td>XPC内含子常见SNP削弱CTCF位点的突变图，连接疾病关联与候选机制。</td></tr><tr><td>d</td><td>预训练与随机初始化在两启动子任务的微调损失，检验预训练提高收敛和任务表现。</td></tr><tr><td>e</td><td>随机、预训练及微调模型的p53注意力，展示训练阶段如何形成有意义的聚焦。</td></tr><tr><td>f</td><td>78套小鼠ENCODE任务的平均准确率、F1、MCC、AUC，检验人序列预训练的跨物种应用。</td></tr></tbody></table><h2 id="怎样把预训练用于一个能检验的新问题"><a href="#怎样把预训练用于一个能检验的新问题" class="headerlink" title="怎样把预训练用于一个能检验的新问题"></a>怎样把预训练用于一个能检验的新问题</h2><p>对 TE&#x2F;AD，可冻结 DNA 表示，在不使用疾病标签的阶段寻找同家族拷贝的功能结构，再把模型固定后检验它是否解释独立的 ATAC 或 MPRA 差异。分类或异常分数只应作为候选排序；参考基因组、家族频率与重复程度都可能决定语言概率，低概率序列不等于有害变异。年轻 TE 的罕见性尤其不能被自动解释为致病。</p><p>我从本文借鉴的是训练任务的拆分与难例设计。需要明确自监督模型学到了什么：更好的下游样本效率、更可靠的变异方向，还是仅更易识别家族。如果简单 PWM、GC 或家族身份能取得相同表现，复杂表示就没有回答新问题。AD 进展相关的结果应采用供体留出和独立病理队列，而注意力图必须回到可干预的序列假说。</p>]]></content>
    
    
    <summary type="html">深入读懂DNABERT：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>78.DeepCpG：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad92004e/"/>
    <id>https://perry.apay.eu.cc/posts/ad92004e/</id>
    <published>2026-10-04T12:01:18.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:078 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> DeepCpG: accurate prediction of single-cell DNA methylation states using deep learning</p><p><strong>期刊与年份：</strong> Genome Biology，2017。<a href="https://doi.org/10.1186/s13059-017-1189-z">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> DNA与邻近CpG信息能否补全单细胞甲基化，并揭示表观异质性的序列基础？</p><h2 id="模型为何从“缺失值”出发"><a href="#模型为何从“缺失值”出发" class="headerlink" title="模型为何从“缺失值”出发"></a>模型为何从“缺失值”出发</h2><p>单细胞甲基化能看到细胞差异，却只能覆盖一部分 CpG。简单地把缺失填零，会把未测到误认为未甲基化；按全部细胞平均，又可能抹掉状态差异。DeepCpG 的问题因此是如何借用邻近位点与跨细胞信息，同时保留 DNA 序列提供的规律。对研究思路的重建属于我的推测：作者将数据来源拆开，分别学习空间邻域和序列，再融合，便于测试谁真正提供了预测信息，而不是让一个黑箱同时承担所有任务。</p><p>DNA 模块通常读取以目标 CpG 为中心的 1001 bp one-hot 序列。CpG 模块先把每个细胞左右各 25 个邻居的状态与距离压成向量，随后双向 GRU 扫描的是这些细胞向量；它不是沿 DNA 位点逐一循环。联合层为训练集合的各个细胞输出目标 CpG 的甲基化概率，以已观察到的二元状态计算负对数似然，缺失位置不计入损失。两个模块先独立训练并冻结，再训练联合层。这是监督插补范式，没有使用疾病标签，但不能因此称为纯无监督疾病发现。</p><h2 id="Figure-1：单细胞甲基化缺失值预测"><a href="#Figure-1：单细胞甲基化缺失值预测" class="headerlink" title="Figure 1：单细胞甲基化缺失值预测"></a>Figure 1：单细胞甲基化缺失值预测</h2><p><a href="/img/dl-literature/078/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/078/figure-01.webp" alt="Figure 1" width="1231" height="829" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 2 页，Figure 1。点击图片可查看原图。</em></p><p>a 最需要记住的区别是 0、1 与问号：前两者是经过读数处理的状态，问号表示没有证据。b 的模块化使作者可以用图 2 的消融分辨信息来源；不同细胞共享 DNA，却有不同邻域甲基化，所以序列不是唯一决定项。双向 GRU 可减弱特定扫描方向的影响，但一般双向循环并不在数学上保证任意细胞排列完全不变，复现时仍应检查顺序稳定性。</p><p>c 的平滑轨迹是补全结果，d 是从预测相关性中寻找候选序列规律，两者证据等级不同。插补可以支持下游分析，却不会自动增加独立样本数。原输出层与这组细胞对应，也不能把邻域模块可接收不同数量的输入，误解成整个训练模型可不经调整直接预测任意新细胞。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>单细胞CpG稀疏矩阵以0、1和未知表示，定义需要填补的缺失数据。</td></tr><tr><td>b</td><td>DNA卷积模块与CpG邻域模块联合预测；邻域先在每个细胞内汇总，再由双向GRU扫描不同细胞的摘要。</td></tr><tr><td>c</td><td>训练模型用于全基因组缺失CpG状态填补，展示主要应用。</td></tr><tr><td>d</td><td>从模型发现与平均甲基化及细胞间变异相关的模体，展示机制探索用途。</td></tr></tbody></table><h2 id="Figure-2：跨细胞、覆盖度和基因组环境的预测验证"><a href="#Figure-2：跨细胞、覆盖度和基因组环境的预测验证" class="headerlink" title="Figure 2：跨细胞、覆盖度和基因组环境的预测验证"></a>Figure 2：跨细胞、覆盖度和基因组环境的预测验证</h2><p><a href="/img/dl-literature/078/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/078/figure-02.webp" alt="Figure 2" width="1231" height="1080" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 2。点击图片可查看原图。</em></p><p>a–c 逐步比较全部模型、DNA&#x2F;CpG 单模块与覆盖分层，显示邻近甲基化信息通常比单独 DNA 更强，两者融合最好。这个结果很实在：局部状态相关性提供的插补优势，不应全部包装为网络发现了深层序列机制。d 在不同基因组环境比较，检查整体指标是否主要来自容易预测的 CpG 岛；低覆盖和高变异区域的增益更接近实际缺失数据问题。</p><p>e 展示不同细胞类型与测序技术上的适用性，但各数据集分别训练和选择模型，不能据此声称同一个模型在未见细胞类型中零样本泛化。评估按染色体留出，排除了目标位置的直接训练复现；同一组细胞的邻域信息仍参与预测，这是任务允许的条件输入，和留出全部供体的评价不是同一件事。已测位置上的留出准确率也不完全代表真正缺失区域，尤其 RRBS 对 GC 丰富区域有选择性，需考虑缺失机制。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>血清培养小鼠胚胎干细胞中的AUC与随机森林、窗口／细胞平均基线比较。</td></tr><tr><td>b</td><td>完整模型对DNA单模块、CpG单模块的性能，检验两类信息的互补。</td></tr><tr><td>c</td><td>按CpG覆盖细胞数分层的AUC，评估数据稀疏程度的影响。</td></tr><tr><td>d</td><td>不同基因组环境的AUC，检查CpG岛、启动子等区域的表现差异。</td></tr><tr><td>e</td><td>2i干细胞及不同测序方案的人肝癌、HepG2等数据上的性能，检验环境与技术泛化。</td></tr></tbody></table><h2 id="Figure-3：与甲基化相关的序列模体"><a href="#Figure-3：与甲基化相关的序列模体" class="headerlink" title="Figure 3：与甲基化相关的序列模体"></a>Figure 3：与甲基化相关的序列模体</h2><p><a href="/img/dl-literature/078/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/078/figure-03.webp" alt="Figure 3" width="1231" height="734" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 5 页，Figure 3。点击图片可查看原图。</em></p><p>这幅没有字母的总图将卷积模体的出现模式做 PCA，颜色表示与模型预测甲基化的关联，大小表示平均活跃程度。相近点说明模式常在相近序列环境出现，而不是两个 TF 已被证明直接相互作用。CG 丰富模体与低甲基化、AT 丰富模体与高甲基化吻合，也可能部分反映 CpG 岛、启动子等组成差异；要提出某个 TF 的直接作用，需要在匹配 GC、CpG 密度与注释后继续检验。</p><p>三角形是与数据库模体显著匹配，未匹配的圆点不是已发现的新蛋白。模体重要性在 Methods 中主要用活跃程度与预测值的相关衡量，不能称为真实 TF 去除后的甲基化效应。已知因子与甲基化酶的关联为机制提供背景支持，但并没有在这张图里完成因果干预。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>全图（无字母）</td><td>128个模体按出现模式PCA排列，颜色表示对甲基化的关联方向、大小表示活跃度、三角表示已知匹配；周围logo展示代表模体，区分与低或高甲基化相关的序列家族。</td></tr></tbody></table><h2 id="Figure-4：单碱基突变效应的距离依赖"><a href="#Figure-4：单碱基突变效应的距离依赖" class="headerlink" title="Figure 4：单碱基突变效应的距离依赖"></a>Figure 4：单碱基突变效应的距离依赖</h2><p><a href="/img/dl-literature/078/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/078/figure-04.webp" alt="Figure 4" width="1231" height="441" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 6 页，Figure 4。点击图片可查看原图。</em></p><p>曲线比较的是模型对序列变化的局部敏感度，Methods 使用一阶梯度近似，再取各替换的最大绝对效应。它没有实验制造这些突变，也不是逐个完整重跑后的全部非线性变异效应。靠近目标 CpG 的变化更大，说明模型依赖近邻序列；不同环境曲线不同，则说明敏感度依赖背景。</p><p>CpG 岛、启动子的低敏感度被作者解释为较稳健的甲基化环境，这是合理的候选解释，还可能受到输出概率接近边界、特征冗余等模型因素影响。要把“预测稳健”提升为“生物学抗突变能力”，应使用独立 mQTL、等位甲基化或编辑实验，并检查预测方向与校准。特别是突变改变 CpG 本身时，目标是否仍存在也要定义清楚，不能把缺少位点当作甲基化状态下降。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>全图（无字母）</td><td>各基因组环境的平均预测突变效应随距CpG位置变化，最近邻影响最大；CpG岛／启动子总体效应更小，表示不同序列环境的稳健性不同。</td></tr></tbody></table><h2 id="Figure-5：序列代码与细胞间甲基化差异"><a href="#Figure-5：序列代码与细胞间甲基化差异" class="headerlink" title="Figure 5：序列代码与细胞间甲基化差异"></a>Figure 5：序列代码与细胞间甲基化差异</h2><p><a href="/img/dl-literature/078/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/078/figure-05.webp" alt="Figure 5" width="1231" height="921" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 7 页，Figure 5。点击图片可查看原图。</em></p><p>a–c 明确试图区分平均甲基化与细胞间变异，避免所有中间甲基化水平都被自动命名为异质性机制。为此作者另训练 DNA 网络，复用并固定模体层，同时以均方误差预测多个窗口尺度的均值与方差。图中不是原联合插补器凭空输出“异质性因子”，而是一个新的监督任务。</p><p>d 在留出染色体上显示序列可以解释部分变异，但方差标签先由窗口内观测计算，包含技术噪声、覆盖和不同细胞状态混合的影响。对二元过程，均值与方差本来有关系，作者用两种相关的差来筛选更偏向方差的模体，能够缓解混淆却并未完全正交化。b 的保守性关联同样可能受启动子与增强子组成影响。预测变异与表达联系虽显著但很弱，不能只报告显著性而省略效应强度，更不能把这些序列规律称为疾病进展的直接驱动。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>模体对细胞间变异与平均甲基化的效应差，筛出主要关联异质性的模体。</td></tr><tr><td>b</td><td>模体活跃度对序列保守和细胞间变异的相关，检查进化约束与表观异质性关系。</td></tr><tr><td>c</td><td>选中模体logo，展示a、b中候选序列结构。</td></tr><tr><td>d</td><td>测试染色体不同环境的预测／真实细胞间变异及相关，检验仅序列能否解释部分异质性。</td></tr></tbody></table><h2 id="对-AD-无监督路线的具体启发"><a href="#对-AD-无监督路线的具体启发" class="headerlink" title="对 AD 无监督路线的具体启发"></a>对 AD 无监督路线的具体启发</h2><p>这篇提供了一种更细的问题定义：先预测正常情况下序列与邻域能解释的甲基化结构，再研究独立样本中偏离结构的部分。AD 项目可以把残差作为候选中间表型，检验它是否随病理负担改变；不过作者在本文仅提出残差研究方向，并没有完成这种疾病分析。训练、阈值选择与病理关联检验需要分开，模型也要按供体留出，防止邻域聚合将同一人的信息传到评价集合。</p><p>若研究 TE，可比较同家族拷贝的甲基化均值与异质性，匹配序列、可比对性和覆盖，再问差异是否聚焦于某细胞调控状态。首先要测出足够可靠的变异，再谈插补。填得更满可能改善可视化，却可能压低真实少数状态或将噪声传播成平滑结构。建议同时保留原始观测掩码，主结论在实测高覆盖子集复现，插补仅用于敏感性分析与候选排序。这样模型才是在补充证据，而不是制造证据。</p><p>疾病脑组织还有非CpG甲基化等其他现象，本文二元CpG任务没有覆盖这些内容，不能仅换一组脑数据就声称恢复完整神经元甲基化程序。模型迁移时应先定义实验分辨率和目标，再选择适当标签与损失。</p>]]></content>
    
    
    <summary type="html">深入读懂DeepCpG：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>77.DeepMEL2：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad92004d/"/>
    <id>https://perry.apay.eu.cc/posts/ad92004d/</id>
    <published>2026-10-04T12:01:17.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:077 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Interpretation of allele-specific chromatin accessibility using cell state-aware deep learning</p><p><strong>期刊与年份：</strong> Genome Research，2021。<a href="https://doi.org/10.1101/gr.260851.120">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 状态感知序列模型能否解释个人黑色素瘤基因组的等位特异开放度？</p><h2 id="从等位偏倚走向机制解释"><a href="#从等位偏倚走向机制解释" class="headerlink" title="从等位偏倚走向机制解释"></a>从等位偏倚走向机制解释</h2><p>等位特异 ATAC 有一个吸引人的优势：同一细胞里的两个单倍型共享大体相同的反式环境，因此比跨人的简单开放度比较更靠近顺式调控问题。但它仍只告诉我们哪个单倍型更开放，未必指出哪个变异导致差异。DeepMEL2 将分相 WGS、个人基因组比对、等位计数与状态匹配的序列模型连起来，试图补上机制这一环。下面关于 idea 的形成是我的推测：作者先看到通用模型擅长常见 AP-1 程序，却漏掉黑色素细胞特有代码，因此扩大相关样本并强化主题输出，而不是只继续扩大通用训练集。</p><p>网络输入 500 bp DNA，输出 47 个共开放主题；CNN 与双向 LSTM 分别提取局部模体和组合关系。300 个卷积核中 283 个以 JASPAR 模体初始化，再训练，既不是纯粹无先验发现，也不是固定 PWM 扫描。主题来自无监督 cisTopic，但网络本身是主题标签的监督分类。比较两个等位序列的输出差，再结合真实偏倚与独立 ChIP、报告实验解释功能。它是一条细胞状态匹配的功能证据链，而非直接预测黑色素瘤诊断、患者生存或变异致病概率。</p><h2 id="Figure-1：等位特异染色质开放度的识别"><a href="#Figure-1：等位特异染色质开放度的识别" class="headerlink" title="Figure 1：等位特异染色质开放度的识别"></a>Figure 1：等位特异染色质开放度的识别</h2><p><a href="/img/dl-literature/077/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/077/figure-01.webp" alt="Figure 1" width="1045" height="1396" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 1。点击图片可查看原图。</em></p><p>A–D 的核心不是最后得到多少 ASCAV，而是先把测量偏倚处理正确。个人二倍体参考减少参考等位更容易比对的问题，WGS 等位比例又校正肿瘤拷贝数造成的读数不平衡。若默认每个等位各占一半，许多拷贝数差异会伪装成开放偏倚。E 据突变拷贝数讨论相对复制事件的早晚，是在特定拷贝数背景下的时间推断，不是从模型直接测得癌症发生日期。</p><p>F 的 ATAC、H3K27ac 和 RNA 偏向同一单倍型，使 TYR 附近差异更像功能性顺式事件。不过同一个单倍型上可能有多个连锁变异，一个 ASCAV 既可能是原因，也可能只是标记。本文用不在 gnomAD 中作为“可能体细胞”的线索，作者也承认其中可能混入罕见生殖系变异与培养产生的变异，不能逐个写成已证实肿瘤突变。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>MM074基因组Circos概览，展示变异与等位事件的全局背景。</td></tr><tr><td>B</td><td>筛选流程中的变异数量Sankey，说明ASCAV识别的过滤步骤。</td></tr><tr><td>C</td><td>分相基因组联合功能组学识别等位偏倚的分析流程。</td></tr><tr><td>D</td><td>10个黑色素瘤个体化二倍体基因组及ATAC、RNA、ChIP整合，定义开放、表达、乙酰化和结合偏倚及模型解释。</td></tr><tr><td>E</td><td>MM074等位拷贝数对ASCAV突变拷贝数，推测变异发生时间并避免拷贝数背景混淆。</td></tr><tr><td>F</td><td>TYR附近同一单倍型偏向的ATAC、H3K27ac与RNA实例，展示跨模态一致的等位特异调控。</td></tr></tbody></table><h2 id="Figure-2：开放度偏倚相关的TF模体"><a href="#Figure-2：开放度偏倚相关的TF模体" class="headerlink" title="Figure 2：开放度偏倚相关的TF模体"></a>Figure 2：开放度偏倚相关的TF模体</h2><p><a href="/img/dl-literature/077/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/077/figure-02.webp" alt="Figure 2" width="1264" height="760" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 5 页，Figure 2。点击图片可查看原图。</em></p><p>A–D 将等位模型差值与无显著偏倚的控制变异比较，寻找统计富集的模体变化。47 家族不是 719 种不同独立机制，多个 PWM 描述相近结合偏好，合并能防止重复计数。AP-1 突出支持它在这些样本开放度变化中的作用，但一次模体得分变化不能指定 JUN、FOS 哪个成员真正结合。E 的家族表达与可解释变异比例相关，说明同一序列变异的功能可见性依赖状态；样本数少，这个相关不能证明表达升高导致更多突变。</p><p>F 在固定误报率下报告能覆盖的 ASCAV，便于和模型比较。“控制变异没有显著偏倚”也可能只是覆盖不足，而非真正零效应；因此这里的敏感度、误报率都是对该操作性标签而言，不是全人群临床诊断性能。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>ASCAV及对照变异的选择流程，定义模体关联比较。</td></tr><tr><td>B</td><td>719个富集模体聚为47家族的热图，归纳等位偏倚相关序列代码。</td></tr><tr><td>C</td><td>模体分数等位差异对显著性散点，识别改变开放度的候选家族。</td></tr><tr><td>D</td><td>各模体家族能解释的ASCAV数量，比较其覆盖度。</td></tr><tr><td>E</td><td>AP-1成员表达对AP-1位点ASCAV比例，检验细胞状态与调控变异可见性的关系。</td></tr><tr><td>F</td><td>不同误报率下能解释的ASCAV比例与打乱对照，检查模体分析的判别能力。</td></tr></tbody></table><h2 id="Figure-3：状态感知DeepMEL2解释调控变异"><a href="#Figure-3：状态感知DeepMEL2解释调控变异" class="headerlink" title="Figure 3：状态感知DeepMEL2解释调控变异"></a>Figure 3：状态感知DeepMEL2解释调控变异</h2><p><a href="/img/dl-literature/077/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/077/figure-03.webp" alt="Figure 3" width="1264" height="1257" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 6 页，Figure 3。点击图片可查看原图。</em></p><p>A、B 同时扩展训练样本、主题数、卷积核容量并加入模体先验，所以 C–G 的改善是组合改进的效果，不能将全部增益归给其中一个因素。C 中细胞系特异主题难预测，提示主题可能包含拷贝数等非序列可解释成分，不能把每个统计主题都命名为真实调控程序。D 的 IRF4 MPRA 则是独立实验读出；E、F 更明确展示 MEL、MES 输出与样本状态匹配时更有解释力。</p><p>这里“状态感知”主要指可选择状态对应输出，并非每个输入序列都额外附带患者状态向量。G 用相同 5% 误报率比较覆盖度，支持专业模型对训练中稀缺的黑色素细胞代码有优势；在 MES 背景通用模型仍可能表现好。Methods 给出 80&#x2F;10&#x2F;10 划分而未在这段声明严格染色体留出，复现实验应额外核查相邻区域与同源序列泄漏，不能把分类评估自动升级成供体外泛化。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>30个细胞系开放主题热图，区分通用、状态特异与细胞系特异区域。</td></tr><tr><td>B</td><td>DeepMEL2相对DeepMEL的结构改进，说明状态感知设计。</td></tr><tr><td>C</td><td>各主题auROC和auPR，评估不同目标的分类质量。</td></tr><tr><td>D</td><td>IRF4增强子变异效应预测的模型比较，提供独立功能实验基准。</td></tr><tr><td>E</td><td>MEL主题分数在不同细胞系解释ASCAV的曲线，检查状态匹配效果。</td></tr><tr><td>F</td><td>MES主题的对应曲线，比较另一状态。</td></tr><tr><td>G</td><td>固定5%误报率下DeepMEL2、DeepMEL、DeepSEA、Basset及PWM的解释比例，评估状态模型收益。</td></tr></tbody></table><h2 id="Figure-4：具体调控变异的模型机制与实验验证"><a href="#Figure-4：具体调控变异的模型机制与实验验证" class="headerlink" title="Figure 4：具体调控变异的模型机制与实验验证"></a>Figure 4：具体调控变异的模型机制与实验验证</h2><p><a href="/img/dl-literature/077/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/077/figure-04.webp" alt="Figure 4" width="1264" height="879" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 8 页，Figure 4。点击图片可查看原图。</em></p><p>A–C 把 ATAC 偏倚接到真实 JUN&#x2F;FOSL1 等位结合，证明部分 AP-1 解释不是 logo 看上去相似而已。模型对 ASCAV 的总体排序与对 AP-1 结合偏倚的排序，是两个不同评价任务，前者好并不保证后者好。D、E、F 各自的 I–IV 构成完整小链条：真实 ATAC→归因与虚拟替换→主题分数→两条单倍型的荧光素酶。AP-1 与 SOX10 两种机制并列，使解释不局限于一个家族。</p><p>主题分数被用来预测活性方向，不应直接标为实测增强子活性；真正的活性证据来自 IV。报告实验在质粒和所选细胞背景中支持序列造成的功能差异，但不是原位靶基因表达编辑实验。附近基因已有 ASE 使靶向假说合理，仍需排除连锁变异与其他调控元件，才能确立单个位点对内源基因的因果影响。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>SUMF1的rs2322683在ATAC及JUN／FOSL1 ChIP中的等位读段，验证开放与AP-1结合偏倚。</td></tr><tr><td>B</td><td>两单倍型归因及饱和突变显示C→T形成AP-1位点，解释MES活性提高。</td></tr><tr><td>C</td><td>按不同模型评分排序后回收真实JUN／FOSL1等位结合变异的数量，评估机制识别。</td></tr><tr><td>D.I</td><td>PEPD内含子C→T的ATAC读段在两个单倍型间不均衡，T等位对应的单倍型更开放；右侧放大直接显示变异处的等位偏倚。</td></tr><tr><td>D.II</td><td>两单倍型的归因与饱和突变显示C→T形成AP-1位点。参考序列中只有该位置变成T才明显提高MES增强子分数，定位了效应来源。</td></tr><tr><td>D.III</td><td>两单倍型的Topic-19（MES）预测分数比较，含T的单倍型分数更高，量化模型的主题分类分数变化；该分数并非直接测得的增强子活性。</td></tr><tr><td>D.IV</td><td>两单倍型的荧光素酶报告活性比较，含T的单倍型活性更强，与模型预测和开放偏倚方向一致。</td></tr><tr><td>E.I</td><td>MITF内含子C→T的ATAC轨迹及变异处放大图，显示T等位对应的单倍型更开放，是第二个AP-1位点获得的实例。</td></tr><tr><td>E.II</td><td>两单倍型归因及饱和突变把差异定位到新形成的AP-1模体，解释局部序列变化为何影响MES调控活性。</td></tr><tr><td>E.III</td><td>Topic-19分数在含T的单倍型更高，预测该AP-1位点获得会提高MES增强子活性。</td></tr><tr><td>E.IV</td><td>荧光素酶实验显示含T的单倍型活性更强，提供与开放度和模型分数一致的功能验证。</td></tr><tr><td>F.I</td><td>EVA1C内含子G→A的ATAC轨迹及变异处放大图，显示A等位对应的单倍型更开放。</td></tr><tr><td>F.II</td><td>两单倍型归因与饱和突变显示G→A形成SOX10结合位点，提供与D、E中的AP-1机制不同的MEL调控实例。</td></tr><tr><td>F.III</td><td>Topic-17（MEL）分数在含A的单倍型更高，量化SOX10位点获得对MEL增强子活性的预测效应。</td></tr><tr><td>F.IV</td><td>荧光素酶实验显示含A的单倍型活性更高，与ATAC等位偏倚及MEL主题分数的方向一致。</td></tr></tbody></table><h2 id="Figure-5：TERT启动子热点突变解释"><a href="#Figure-5：TERT启动子热点突变解释" class="headerlink" title="Figure 5：TERT启动子热点突变解释"></a>Figure 5：TERT启动子热点突变解释</h2><p><a href="/img/dl-literature/077/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/077/figure-05.webp" alt="Figure 5" width="1264" height="542" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 9 页，Figure 5。点击图片可查看原图。</em></p><p>这张图尤其值得细读失败再修正的逻辑。原版 DeepMEL2 对 TERT 启动子整体突变效果可以相关，却漏掉关键的 GABPA 热点获得；平均相关高并没有保护最重要的个别机制。B、C 通过加入真实 GABPA ChIP 标签作为第 48 类，重新训练后改善热点识别，说明一个对主题区分无用的模体可能对致癌事件非常关键。</p><p>A 的开放偏倚来自 A375，B、G 的既有饱和突变实验来自胶质母细胞瘤细胞，跨实验背景的吻合有价值，也不能忽略这种状态差异。D、E 中比热点分数更大的其他候选，只能进入优先验证清单，分数大小不等于比 TERT 更强的致癌能力。F、H 对同一序列选择不同输出归因，展示“解释什么”的选择改变看到的机制；不能把最大输出分数当成统一的生物学答案。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>A375 TERT热点T等位的ATAC独占读段，验证突变单倍型更开放。</td></tr><tr><td>B</td><td>不同模型对TERT饱和突变实测效应的预测性能，检验启动子建模。</td></tr><tr><td>C</td><td>逐变异实测对预测效应散点并标出两热点，检查获功能变异识别。</td></tr><tr><td>D</td><td>所有ASCAV的启动子主题对GABPA主题分数变化，筛选TERT和新GABPA获得候选。</td></tr><tr><td>E</td><td>TERT两单倍型各主题预测及差值，展示热点同时提高启动子和GABPA主题。</td></tr><tr><td>F</td><td>按启动子主题归因TERT单倍型，定位其整体调控代码。</td></tr><tr><td>G</td><td>TERT计算机内与体外饱和突变逐位置对照，验证单碱基效应。</td></tr><tr><td>H</td><td>按GABPA主题归因同一区域，定位热点形成的TF结合模式。</td></tr></tbody></table><h2 id="对-WGS-与-TE-项目的可迁移启发"><a href="#对-WGS-与-TE-项目的可迁移启发" class="headerlink" title="对 WGS 与 TE 项目的可迁移启发"></a>对 WGS 与 TE 项目的可迁移启发</h2><p>这条路线很适合把候选 WGS 从“落在哪个注释”推进到“改变了哪个状态中的哪种调控过程”。先用分相信息和可靠的等位计数定位功能偏倚，再由状态适配模型排序机制，最后用独立 MPRA 或结合数据验证。TE 位点更要检查多重比对、参考偏倚和拷贝差异，否则丰富的等位现象可能首先是映射问题。单倍型比较可以提高证据强度，但不能解决所有连锁混杂。</p><p>我最想借鉴的是 TERT 的教训：模型必须因任务缺失而修订，不能因平均指标漂亮而认为它理解了一切。AD 项目可在冻结模型后检查它是否漏掉某些细胞类型或 TE 家族的关键功能，再建立新的独立训练标签；若按待验证候选效果反复挑输出与阈值，应另留完全独立数据评价。公共数据做研究可以走到严谨的候选机制与多队列复现，但未有疾病终点证据时，应保留“调控功能变异”与“AD 致病变异”的区别。</p><p>等位分析也不能忽略检测功效差异：不同样本开放区覆盖和杂合位点数不同，能够检出的 ASCAV 数量不能直接解释为患者之间调控异常程度。复现时应报告可检验分母、匹配覆盖，并对无显著偏倚控制做高覆盖敏感性分析。对于多个连锁位点，可比较完整单倍型与逐一替换，明确预测是在解释一个局部序列还是一个独立变异。</p>]]></content>
    
    
    <summary type="html">深入读懂DeepMEL2：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>76.DeepMEL：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad92004c/"/>
    <id>https://perry.apay.eu.cc/posts/ad92004c/</id>
    <published>2026-10-04T12:01:16.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:076 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Cross-species analysis of enhancer logic using deep learning</p><p><strong>期刊与年份：</strong> Genome Research，2020。<a href="https://doi.org/10.1101/gr.260844.120">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 黑色素瘤增强子的细胞状态代码如何跨物种保守，又如何因突变而改变？</p><h2 id="物种比较怎样进入增强子研究"><a href="#物种比较怎样进入增强子研究" class="headerlink" title="物种比较怎样进入增强子研究"></a>物种比较怎样进入增强子研究</h2><p>黑色素瘤 MEL 与 MES 状态已经有表达和开放度的定义，真正未解的是：这些状态由怎样的增强子组合代码维持，这套代码是否跨物种保留？作者建立六物种 ATAC 比较，再训练 DeepMEL。对构思的重建属于我的推测：进化在不同序列中保留功能，也会改变模体，这相当于提供大量天然扰动；模型则帮助比较传统比对难以识别的功能组合。这不是把物种按某条“进步阶梯”排列，也没有研究 AD 的演化起源。</p><p>DeepMEL 输入 500 bp 的 DNA，预测 24 个共开放主题的多标签。主题由人类 bulk ATAC 重采样后经 cisTopic 得到；这是无监督构建标签、再进行监督序列分类的组合，不能把全部网络训练称为无监督。CNN 提取局部模体，双向 LSTM 整合模体关系，正反互补序列分别经过同一网络后平均输出，二元交叉熵训练。主题标签比每个细胞系的开放标签更接近共享调控程序，这是本文重要的设计选择；但模型输出仍是主题归属分数，既不是增强子活性值，也不是患者风险。</p><h2 id="Figure-1：跨物种保留的黑色素瘤两种细胞状态"><a href="#Figure-1：跨物种保留的黑色素瘤两种细胞状态" class="headerlink" title="Figure 1：跨物种保留的黑色素瘤两种细胞状态"></a>Figure 1：跨物种保留的黑色素瘤两种细胞状态</h2><p><a href="/img/dl-literature/076/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/076/figure-01.webp" alt="Figure 1" width="1264" height="759" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 1。点击图片可查看原图。</em></p><p>A–C 先区分“能映射到人类坐标”与“在对应位置也开放”。传统 liftOver 的覆盖条件和不同基因组质量会影响这个结果，不可比对不等于无功能。D 的主成分同时包含物种和细胞状态，说明进化与状态差异并存；把全部物种直接聚类，并不能自动发现一种普适疾病亚型。E 的 MLANA、MMP3 个例给分组提供生物学参照，但多数非人类样本处于 MEL，只有狗提供 MES 对照，跨物种两状态的支持并不均衡。开放只是候选调控证据：即使区域跨物种都开放，也尚未证明它们激活相同基因。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>六物种进化树及26个细胞系三个区域的ATAC，展示比较范围及跨物种开放差异。</td></tr><tr><td>B</td><td>人SOX10位点的MEL与MES开放轨迹，说明两种状态的典型差异。</td></tr><tr><td>C</td><td>每物种开放区能否比对及在人同源位置保持开放的数量，区分序列保留与功能保留。</td></tr><tr><td>D</td><td>29619个可比对区域开放度PCA，检查样本主要按物种还是细胞状态组织。</td></tr><tr><td>E</td><td>各物种MLANA和MMP3附近轨迹，提供MEL及MES状态保守的具体实例。</td></tr></tbody></table><h2 id="Figure-2：MEL和MES主调控模体的保守"><a href="#Figure-2：MEL和MES主调控模体的保守" class="headerlink" title="Figure 2：MEL和MES主调控模体的保守"></a>Figure 2：MEL和MES主调控模体的保守</h2><p><a href="/img/dl-literature/076/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/076/figure-02.webp" alt="Figure 2" width="1264" height="1127" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 2。点击图片可查看原图。</em></p><p>A、B 在人和狗各自比较 MEL&#x2F;MES，避免把物种差异误认为状态差异。C–E 用分支长度衡量模体在多个物种保留，并与打乱序列比较；它考察的是模体模式在预先筛选的保守开放区中是否突出，而非全基因组无偏的自然选择检验。保守区域中有大量启动子，SP&#x2F;KLF 等富集部分来自这个组成，作者另看远端区有助于拆开通用启动子与状态特异调控。模体家族相似还意味着 SOX、E-box 不直接指定 SOX10 或 MITF，具体命名要结合已知状态、表达及后续结合实验。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>人MEL／MES差异开放区热图与富集模体，识别状态相关TF家族。</td></tr><tr><td>B</td><td>狗MEL／MES差异区与模体，检验相同代码能否在另一物种发现。</td></tr><tr><td>C</td><td>用支系长度评分BLS衡量同源开放区模体保守的流程。</td></tr><tr><td>D</td><td>哺乳动物MEL同源开放区的模体BLS分布，标出最保守TF模式。</td></tr><tr><td>E</td><td>六物种共同开放区的BLS分布，检查更广进化跨度仍保留的模体。</td></tr></tbody></table><h2 id="Figure-3：DeepMEL增强子分类与变异解释"><a href="#Figure-3：DeepMEL增强子分类与变异解释" class="headerlink" title="Figure 3：DeepMEL增强子分类与变异解释"></a>Figure 3：DeepMEL增强子分类与变异解释</h2><p><a href="/img/dl-literature/076/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/076/figure-03.webp" alt="Figure 3" width="1194" height="1373" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 6 页，Figure 3。点击图片可查看原图。</em></p><p>A、B 的主题不是单细胞实测群体：作者从 bulk 中抽取 reads 构造模拟细胞，以捕获样本之间的共开放模式。这增加计算表征，不增加独立样本数。C–F 用二号染色体留出与打乱标签对照，证明网络能学到序列规律；ROC 与 PR 分别回答排序和稀少阳性检索问题，不能只读较漂亮的一项。G、H 把逐碱基归因与独立 IRF4 饱和突变 MPRA 比较，是本图最关键的桥梁：开放主题训练得到的序列特征，对这个增强子的报告活性也有信息。</p><p>I 的领先不能推广成所有增强子都优于通用模型：DeepMEL 专门学习黑色素瘤，而对照模型的任务与数据更广。另一个值得模仿的比较是主题训练与直接 ATAC 标签训练，但收益应在多条独立增强子上检验，单条 IRF4 仍可能偏向特定模体结构。分类分数差异的方向与报告活性变化一致时，才有更具体的变异功能证据。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>人细胞系cisTopic主题热图，定义共享和状态特异区域集合。</td></tr><tr><td>B</td><td>MIA附近MEL及SERPINE1附近MES主题区域的轨迹，展示主题的生物含义。</td></tr><tr><td>C</td><td>以24个开放主题训练多标签序列模型的流程，说明共开放主题分类目标；cisTopic 标签无监督获得，后续 DNA 网络为监督训练。</td></tr><tr><td>D</td><td>MEL／MES区域训练、测试与打乱对照的ROC，验证序列分类能力。</td></tr><tr><td>E</td><td>同一任务精确率—召回率，检验稀少阳性下的预测质量。</td></tr><tr><td>F</td><td>MEL和MES分类最重要卷积核，寻找各状态调控模体。</td></tr><tr><td>G</td><td>IRF4增强子双链归因、MPRA与计算机内逐碱基效应，检验关键碱基定位。</td></tr><tr><td>H</td><td>IRF4实测对预测突变效应相关，定量验证G。</td></tr><tr><td>I</td><td>主题训练、直接ATAC训练及其他模型的IRF4变异预测性能，评估训练目标选择。</td></tr></tbody></table><h2 id="Figure-4：人训练模型的跨物种应用"><a href="#Figure-4：人训练模型的跨物种应用" class="headerlink" title="Figure 4：人训练模型的跨物种应用"></a>Figure 4：人训练模型的跨物种应用</h2><p><a href="/img/dl-literature/076/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/076/figure-04.webp" alt="Figure 4" width="1264" height="1190" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 8 页，Figure 4。点击图片可查看原图。</em></p><p>A 用人训练、狗实测差异区评估，提供跨物种泛化的独立功能标签。B 将其他物种开放区按状态代码评分，显示相似程序可以存在于不同背景。C 利用中间层比较同源基因附近的增强子，D 的 ERBB3 个例说明功能相似模式有时比整段序列比对更稳定。然而邻近同源基因加表示相似，首先建立的是候选功能对应；它不足以独立证明增强子本身严格同源。趋同产生相似模体、同基因附近的冗余增强子，都可能造成这种相似。</p><p>尤其在斑马鱼两个候选区上，相近组合支持共同起源或复制的假说，但判定复制史还需要共线性、系统发育及更多物种，而不是由一个模型相关系数直接裁决。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>DeepMEL与模体扫描方法在人及狗MEL／MES分类的比较，检验迁移优势。</td></tr><tr><td>B</td><td>所有物种样本中MEL／MES预测区域比例，检查模型是否再现状态差异。</td></tr><tr><td>C</td><td>同源MEL基因附近增强子嵌入相关对非同源基因参照，检验调控表示的跨物种对应。</td></tr><tr><td>D-I</td><td>人与其他物种的支系距离，为跨物种结果提供进化尺度。</td></tr><tr><td>D-II</td><td>六物种ERBB3区域ATAC及模型预测增强子，标出传统liftOver找到或漏掉的区域。</td></tr><tr><td>D-III</td><td>同源ERBB3增强子的归因比对及点突变／插缺位置，展示功能代码在不同序列中仍可保留。</td></tr></tbody></table><h2 id="Figure-5：MEL增强子的核心调控组合"><a href="#Figure-5：MEL增强子的核心调控组合" class="headerlink" title="Figure 5：MEL增强子的核心调控组合"></a>Figure 5：MEL增强子的核心调控组合</h2><p><a href="/img/dl-literature/076/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/076/figure-05.webp" alt="Figure 5" width="1264" height="964" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 9 页，Figure 5。点击图片可查看原图。</em></p><p>A 将卷积匹配与归因结合，以过滤只像模体却对主题输出无贡献的位置。B、C 的八种组合说明代码在伙伴搭配上有弹性，D 的独立 ChIP 为预测位点增加实际结合证据，E、F 再考察狗中的对应。需要注意集合本身先经过模型 MEL 分数筛选，再用同一模型解释；所有候选都有 SOX 模体既反映真实规律，也受筛选机制影响。SOX10 敲低后的闭合比单纯“全部预测都有 SOX”更能支持必要性。</p><p>模体在同一区域共现，不等于四个 TF 总在同一分子上同时结合。ChIP 集合的共富集提供群体结合证据，所谓核心调控组合仍应按不同模态分别读，不能把八类组成压成一个固定四蛋白复合物。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>把卷积核匹配与归因结合打分模体的流程，减少仅序列匹配产生的候选。</td></tr><tr><td>B</td><td>MM001的3885个MEL区域中SOX、TFAP2A、MITF、RUNX模体数量热图。</td></tr><tr><td>C</td><td>同一集合二值化热图，展示模体的存在组合与区域分群。</td></tr><tr><td>D</td><td>各组合群的SOX10、MITF、TFAP2A ChIP信号，检查模体组合是否对应实际结合。</td></tr><tr><td>E</td><td>人区域组合Venn图及例子，描述核心模体共现。</td></tr><tr><td>F</td><td>狗区域组合Venn图及例子，与人比较跨物种组合代码。</td></tr></tbody></table><h2 id="Figure-6：SOX10与TFAP2A的空间定位"><a href="#Figure-6：SOX10与TFAP2A的空间定位" class="headerlink" title="Figure 6：SOX10与TFAP2A的空间定位"></a>Figure 6：SOX10与TFAP2A的空间定位</h2><p><a href="/img/dl-literature/076/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/076/figure-06.webp" alt="Figure 6" width="1264" height="872" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 10 页，Figure 6。点击图片可查看原图。</em></p><p>A 的真实敲低实验把 SOX10 与 TFAP2A 的作用区分开：一者去除使所示区域基本关闭，另一者降低开放度，支持开创与稳定的不同功能。B–E 的核小体位置则来自 DNA 序列预测工具，并非在这些细胞中直接测得的核小体定位。因此 TF 相对核小体边缘或中心的偏好，是与机制一致的线索，尚不足以证明蛋白在真实核小体上以该位置开始结合。敲低经过 72 小时，也可能包含状态转换的间接后果。</p><p>这组图的优点在于没有仅凭 logo 命名蛋白功能，而是把位置、独立敲低和开放变化接在一起。下一步若要更强因果结论，可用早期时间点、结合测量及局部模体编辑拆开直接开创作用与下游细胞状态效应。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>人增强子模体、核小体预测及两TF敲低ATAC，检查不同因子对开放结构的作用。</td></tr><tr><td>B</td><td>狗增强子的模体与核小体位置预测，检验结构规则跨物种是否对应。</td></tr><tr><td>C</td><td>核小体起始和中心位置示意，解释后续曲线坐标。</td></tr><tr><td>D</td><td>按开放峰顶或TF模体对齐的核小体起点，比较SOX10与TFAP2A位置偏好。</td></tr><tr><td>E</td><td>对应核小体中心分布，进一步判断模体相对核小体的定位。</td></tr></tbody></table><h2 id="Figure-7：解释跨物种增强子功能变化的突变"><a href="#Figure-7：解释跨物种增强子功能变化的突变" class="headerlink" title="Figure 7：解释跨物种增强子功能变化的突变"></a>Figure 7：解释跨物种增强子功能变化的突变</h2><p><a href="/img/dl-literature/076/figure-07.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/076/figure-07.webp" alt="Figure 7" width="1264" height="820" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 11 页，Figure 7。点击图片可查看原图。</em></p><p>A–C 的 APPL2 区域开放、报告活性和模型分数共同变化，定义了功能分歧；D、E 的逐个天然差异替换给出候选解释。但报告实验比较了整条人狗序列，没有逐一测完四个关键替换的必要性和充分性，所以不能把每个模型高影响突变都当成已验证的进化因果位点。F 固定其他三个模体数，再考察 SOX 获得&#x2F;丢失与开放变化，减少伙伴组成混杂，仍不是随机干预实验。</p><p>G 在同一个人类 MM001 细胞中比较六条人&#x2F;狗增强子的荧光素酶，较好地固定了反式背景，支持 DNA 本身携带部分活性差异；样本很少，MITF 的活性关联仍需更广泛设计。开放与活性有时不一致，恰好说明“开门”和“执行转录”应作为两类读出分别建模。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>狗APPL2上游区域开放而人同源区不开放，定义进化差异实例。</td></tr><tr><td>B</td><td>同一区域报告活性，验证开放差异对应功能变化。</td></tr><tr><td>C</td><td>人／狗序列24个主题分数，检查模型能否再现状态活性差异。</td></tr><tr><td>D</td><td>逐个模拟人狗差异碱基对狗MEL分数的影响，筛选可能导致功能丢失的突变。</td></tr><tr><td>E</td><td>人狗归因及全部单碱基效应，突出破坏SOX10、MITF、TFAP2A位点的四个差异。</td></tr><tr><td>F</td><td>SOX10位点获得／丢失数量对跨物种ATAC差异，检验该机制的总体关联。</td></tr><tr><td>G</td><td>六个人／狗增强子的荧光素酶及模体数，实验验证跨物种代码与活性关系。</td></tr></tbody></table><h2 id="我从这篇学到的研究策略"><a href="#我从这篇学到的研究策略" class="headerlink" title="我从这篇学到的研究策略"></a>我从这篇学到的研究策略</h2><p>对 AD 与 TE，可以先发现某细胞状态的共开放程序，再问它由哪些家族拷贝的模体结构承载，最后比较跨物种功能保留与人类特异获得。这里要同时保留三个坐标：历史同源关系、实测调控状态、模型学到的功能相似性；三者一致时证据更强，三者分离时反而可能产生有价值的问题。年轻 TE 往往无法进入严格多物种比对，不能把这类缺失简单编码成低功能。</p><p>资源方面，原文确实使用 16 GB P100 训练该较小网络；这提供了同级显存可行性的实证，仍需对本机软件、序列数量和 batch size 重新测量。可以借鉴问题分解与主题标签，不必照搬旧版 LSTM。真正需要新增的证据是：独立供体和独立报告实验表明，TE 内的特定组合解释了总开放度之外的变化；否则“跨物种加深度学习”只是工具叠加。</p>]]></content>
    
    
    <summary type="html">深入读懂DeepMEL：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>75.C-Origami：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad92004b/"/>
    <id>https://perry.apay.eu.cc/posts/ad92004b/</id>
    <published>2026-10-04T12:01:15.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:075 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Cell-type-specific prediction of 3D chromatin organization enables high-throughput in silico genetic screening</p><p><strong>期刊与年份：</strong> Nature Biotechnology，2023。<a href="https://doi.org/10.1038/s41587-022-01612-8">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 加入细胞状态数据能否预测细胞特异三维染色质及遗传扰动后的结构？</p><h2 id="为什么三维预测需要细胞状态输入"><a href="#为什么三维预测需要细胞状态输入" class="headerlink" title="为什么三维预测需要细胞状态输入"></a>为什么三维预测需要细胞状态输入</h2><p>同一份参考 DNA 在不同细胞中会形成不同的染色质接触。仅输入序列，模型可以学习某类细胞的结构平均规律，却没有信息说明这次要预测哪种细胞。C.Origami 因此把 CTCF ChIP-seq 与 ATAC-seq 作为状态条件，再用 Hi-C 监督。对研究构思的解释属于我的推测：作者并非先选 Transformer 再寻找应用，而是从“序列不够指定细胞状态”的缺口出发，选择兼顾结构边界与开放调控区的两类实验输入。</p><p>输入是约 2 Mb 的五通道 DNA 和两条连续实验信号；卷积编码器把长度压缩成 256 个位置，Transformer 交换远距信息，再把各位置两两拼接，交给二维膨胀卷积生成 256×256 接触矩阵。训练目标是处理后的 Hi-C 强度均方误差，输出约 8 kb 分辨率，不是逐碱基物理接触，也没有直接预测基因表达。研究范式是“条件预测—虚拟扰动筛选—实验与疾病背景核验”。它可以从一个细胞类型向新细胞推广，但新细胞仍需提供 CTCF 和 ATAC 测量，不能称为只用 DNA 的完全零数据预测。</p><h2 id="Figure-1：细胞类型特异三维染色质预测模型"><a href="#Figure-1：细胞类型特异三维染色质预测模型" class="headerlink" title="Figure 1：细胞类型特异三维染色质预测模型"></a>Figure 1：细胞类型特异三维染色质预测模型</h2><p><a href="/img/dl-literature/075/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/075/figure-01.webp" alt="Figure 1" width="1284" height="825" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 36 页，Figure 1。点击图片可查看原图。</em></p><p>a、b 用两套编码器解决信息尺度不同的问题：DNA 负责潜在结合语法，连续 CTCF 与 ATAC 指定哪些位置在目标细胞中实际呈现相应状态。二维解码器则适配接触矩阵，而不是把一维序列输出勉强当成相互作用。两两拼接是建立候选位置关系的计算操作，尚不证明每一对位置有真实接触。输入压缩能够降低远距建模成本，也意味着细小序列变化要经过多层汇总；读出分辨率限制了可验证问题的粒度。架构合理性最后仍需通过图 2 的输入消融确认。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>C.Origami网络结构，整合序列与细胞状态数据。</td></tr><tr><td>b</td><td>输入DNA、CTCF ChIP和ATAC，输出2Mb窗口Hi-C矩阵，说明细胞特异信息如何进入预测。</td></tr></tbody></table><h2 id="Figure-2：三维接触矩阵预测准确性"><a href="#Figure-2：三维接触矩阵预测准确性" class="headerlink" title="Figure 2：三维接触矩阵预测准确性"></a>Figure 2：三维接触矩阵预测准确性</h2><p><a href="/img/dl-literature/075/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/075/figure-02.webp" alt="Figure 2" width="1284" height="1023" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 37 页，Figure 2。点击图片可查看原图。</em></p><p>a 的全部输入组合训练提供比较干净的证据：序列、CTCF、开放度都对预测有贡献。b–f 从矩阵外观推进到绝缘曲线，并包含染色体留出，避免只在训练窗口里证明会重建。绝缘相关高主要支持边界结构恢复，不能替代所有增强子—启动子接触的准确率。g 把距离分层，防止普遍存在的近距高信号掩盖远距误差。h 的方法比较还需结合 Methods：不同模型的输出经过裁切、重采样和按距离调整到实验目标的均值、标准差。这是为了比较结构，但对强度误差的解读依赖该校准；它不是未经目标校准的绝对接触强度竞赛。</p><p>C.Origami 比序列模型多用了两类实验信息，因此胜出支持“这些条件信息有用”，不能单独证明网络架构本身更优秀。训练与评估细胞、输入长度及目标处理也应同时报告，才有机会复现公平的结论。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>不同输入组合的验证损失，检验序列、CTCF及开放度各自贡献。</td></tr><tr><td>b</td><td>IMR-90训练、验证、测试染色体的实测Hi-C矩阵，提供实验参照。</td></tr><tr><td>c</td><td>对应预测矩阵，检查未见染色体的边界及接触模式。</td></tr><tr><td>d</td><td>输入CTCF和ATAC轨迹，连接预测结构与细胞调控状态。</td></tr><tr><td>e</td><td>实测和预测绝缘分数及相关，评价TAD边界定位。</td></tr><tr><td>f</td><td>全部验证／测试窗口的绝缘Pearson与Spearman相关，检验整体表现。</td></tr><tr><td>g</td><td>按接触距离分层的相关，避免短距强接触掩盖长距误差。</td></tr><tr><td>h</td><td>与Akita、DeepC、Orca的绝缘相关比较，评估多输入模型的收益。</td></tr></tbody></table><h2 id="Figure-3：跨细胞类型从头预测"><a href="#Figure-3：跨细胞类型从头预测" class="headerlink" title="Figure 3：跨细胞类型从头预测"></a>Figure 3：跨细胞类型从头预测</h2><p><a href="/img/dl-literature/075/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/075/figure-03.webp" alt="Figure 3" width="1284" height="1069" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 38 页，Figure 3。点击图片可查看原图。</em></p><p>a–d 在同一基因组位置更换状态输入，检验的是真正的细胞差异而非不同位置的天然差异。e–h 还专门分析结构差异区域，因为大多数边界保守，简单全基因组高相关可能只反映共享骨架。此处差异区域由实测 Hi-C 识别，作用是评估模型能否恢复已知差异，不是一个无需目标 Hi-C 就能确定的临床筛查规则。预测与同细胞实验最相符，支持模型利用状态条件；不能推导其可以预测细胞命运或病理进展。</p><p>跨细胞成功还有适用边界：新的输入轨道要采用相近预处理和覆盖标准。如果 AD 公共数据只有 ATAC、缺少相应细胞 CTCF，直接把另一细胞的 CTCF 轨道补上会改变任务定义，应作为有缺失条件的模型另行验证。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>IMR-90与GM12878实测矩阵及差异，标出细胞特异接触。</td></tr><tr><td>b</td><td>预测矩阵与预测差异，检查模型能否再现细胞特异结构。</td></tr><tr><td>c</td><td>两细胞的CTCF／ATAC输入轨迹，解释差异的状态信息来源。</td></tr><tr><td>d</td><td>实测与预测绝缘曲线，检查边界差异。</td></tr><tr><td>e</td><td>不同细胞类型的绝缘相关，评估泛化。</td></tr><tr><td>f</td><td>GM12878从头预测的绝缘相关，与仅序列模型比较。</td></tr><tr><td>g</td><td>GM12878观测／期望矩阵相关，评价去除距离背景后的结构预测。</td></tr><tr><td>h</td><td>GM12878距离分层相关，进一步检验不同接触距离的性能。</td></tr></tbody></table><h2 id="Figure-4：易位和删除扰动后的三维结构"><a href="#Figure-4：易位和删除扰动后的三维结构" class="headerlink" title="Figure 4：易位和删除扰动后的三维结构"></a>Figure 4：易位和删除扰动后的三维结构</h2><p><a href="/img/dl-literature/075/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/075/figure-04.webp" alt="Figure 4" width="746" height="1286" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 39 页，Figure 4。点击图片可查看原图。</em></p><p>a–f 把参考顺序重组为易位染色体，检查模型对超出正常窗口关系的结构泛化。CUTLL1 的易位是杂合的，实验混有正常与易位等位基因，Methods 因而将两类预测平均再比较；不能把矩阵吻合解释成纯易位等位基因的直接精确测量。g–i 的 MYC 区域删除有既往实验结果作参照，比只有虚拟热图更有说服力。本 PDF 图注将 g&#x2F;h 的删除状态写反，与原图标签及正文不一致。视觉核对显示 g 标为 Prediction，是未删除基线；h 明确标为 Prediction with Deletion，是删除后预测，且相应 CTCF 轨道的尖峰被移除。本解读据原图标签与轨道修改解释，并保留图注冲突记录。</p><p>虚拟删除不仅移除 DNA，还同步处理相应状态轨道，并在末端补齐输入。它在问这一输入区域对模型预测有多重要；真实细胞删除后的 CTCF 重新分布、开放度反馈和代偿，并不会由这个操作自动模拟。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>CUTLL1中t(7;9)易位示意，定义重排。</td></tr><tr><td>b</td><td>按易位参考染色体映射的实测Hi-C，展示新接触域。</td></tr><tr><td>c</td><td>未易位染色体7的预测矩阵，提供重排前参照。</td></tr><tr><td>d</td><td>未易位染色体9的预测矩阵，提供另一侧参照。</td></tr><tr><td>e</td><td>易位后的预测矩阵呈现neo-TAD和条带，检验重排结构预测。</td></tr><tr><td>f</td><td>易位位点实测对预测的log倍数差异，展示剩余误差。</td></tr><tr><td>g</td><td>MYC位点未删除基线预测矩阵。原图标为 Prediction；本 PDF 图注对 g&#x2F;h 状态写反，此处以原图与正文为准。</td></tr><tr><td>h</td><td>删除500bp CTCF结合区后的预测矩阵。原图标为 Prediction with Deletion，CTCF轨道相应尖峰消失；本 PDF 图注对 g&#x2F;h 状态写反。</td></tr><tr><td>i</td><td>两矩阵差值及虚拟4C，定位删除导致的特定环化变化。</td></tr></tbody></table><h2 id="Figure-5：计算机内遗传筛选发现结构元件"><a href="#Figure-5：计算机内遗传筛选发现结构元件" class="headerlink" title="Figure 5：计算机内遗传筛选发现结构元件"></a>Figure 5：计算机内遗传筛选发现结构元件</h2><p><a href="/img/dl-literature/075/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/075/figure-05.webp" alt="Figure 5" width="1088" height="1285" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 41 页，Figure 5。点击图片可查看原图。</em></p><p>a–c 比较梯度、注意力和删区后的矩阵变化，强调“关注某位置”与“改掉该位置会怎样”是不同的问题。impact score 是两张预测的平均绝对差，越大只说明模型结构输出越敏感，既不携带变化方向，也不是致病概率。d–g 再把高分元件按 CTCF 与开放度分组，寻找结构调控模式。所谓全基因组 1 kb 筛选，Methods 实际采样了十条染色体代表基因组；约前 1% 的阈值是筛选规则，不能说整个基因组只有这些必需结构元件。</p><p>非 CTCF 开放元件及 MAZ 富集提出了额外结构机制的候选。富集建立的是统计关联，而且部分输入正是 CTCF 和 ATAC；重现这些信号本身有一定预期。要确认一种新结构蛋白，应依赖独立结合数据和扰动，而不是把四组热图中的富集直接写成必要性。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>删除候选元件并计算预测接触变化，定义impact score。</td></tr><tr><td>b</td><td>高通量ISGS扫描流程，说明如何遍历顺式调控元件。</td></tr><tr><td>c</td><td>GRAM、注意力与删除影响评分的归因比较，展示三种定位方式。</td></tr><tr><td>d</td><td>删除筛选分数分布，定义强影响元件的范围。</td></tr><tr><td>e</td><td>高影响1kb元件中心附近热图按评分排序，展示典型轨迹组织。</td></tr><tr><td>f</td><td>四类元件的ATAC及多种ChIP富集，并按影响强弱分层，寻找结构调控蛋白。</td></tr><tr><td>g</td><td>筛选元件的基因组注释分布，描述其与已知功能区域的关系。</td></tr></tbody></table><h2 id="Figure-6：细胞特异结构元件与反式调控因子"><a href="#Figure-6：细胞特异结构元件与反式调控因子" class="headerlink" title="Figure 6：细胞特异结构元件与反式调控因子"></a>Figure 6：细胞特异结构元件与反式调控因子</h2><p><a href="/img/dl-literature/075/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/075/figure-06.webp" alt="Figure 6" width="910" height="1286" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 43 页，Figure 6。点击图片可查看原图。</em></p><p>a、b 是真实的染色质调控基因 CRISPR 筛选，gRNA 随增殖改变，证明 CHD4 等基因影响白血病细胞生长。c–f 将 CHD4 周围的虚拟删区、CTCF 缺失、实验接触和表达升高连起来，提供可检验的局部调控假说。然而敲除 CHD4 基因与敲除 CHD4-insu 元件是两种实验，前者并没有证明后者通过这个接触链促进增殖。本文这里更稳妥的结论是证据相互吻合、提示失去绝缘可能增加表达。</p><p>g–i 用筛选区域与 ReMap 结合谱的重叠寻找反式因子，再把 CDK7 与 NOTCH1 的相对排名拿到 j、k 的抑制实验中核验。CDK7 抑制影响更多 TAD，支持其较广泛的结构作用，但药物效应还可能包含转录和细胞状态的间接变化。因子富集排序不等于每个候选都是直接结构蛋白，治疗靶点仍要逐一验证。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>CUTLL1、Jurkat染色质调控基因CRISPR筛选火山图，gRNA丰度变化反映靶向后增殖效应。</td></tr><tr><td>b</td><td>两细胞筛选命中重叠，区分共享与细胞特异依赖。</td></tr><tr><td>c</td><td>CHD4位点影响评分、CTCF、ATAC及虚拟4C，标出T细胞特异CHD4-insu元件。</td></tr><tr><td>d</td><td>不同细胞中删除CHD4-insu后的预测矩阵及差异，展示细胞特异结构作用。</td></tr><tr><td>e</td><td>CUTLL1与T细胞实测Hi-C，为CHD4局部结构提供实验参照。</td></tr><tr><td>f</td><td>CHD4表达分布，连接结构状态与基因表达背景。</td></tr><tr><td>g</td><td>各细胞反式因子富集热图，寻找与高影响元件对应的调控蛋白。</td></tr><tr><td>h</td><td>CUTLL1反式因子排名的肘部图，突出CDK7与NOTCH1。</td></tr><tr><td>i</td><td>Jurkat的对应排名，检验两细胞共享候选因子。</td></tr><tr><td>j</td><td>抑制CDK7后3672个TAD的结构变化火山图，验证候选反式因子的作用。</td></tr><tr><td>k</td><td>抑制NOTCH1后的结构变化火山图，检验另一候选因子。</td></tr></tbody></table><h2 id="可以怎样借鉴到-DNA-与疾病研究"><a href="#可以怎样借鉴到-DNA-与疾病研究" class="headerlink" title="可以怎样借鉴到 DNA 与疾病研究"></a>可以怎样借鉴到 DNA 与疾病研究</h2><p>这篇最有启发的地方是明确了虚拟扰动的读出：删掉元件后，具体哪类接触改变，而不是只得到一个抽象的重要性分数。对于 TE 重叠变异，可以先提出“这个家族在某细胞中承担边界或接触锚点”的问题，按家族、可比对性、开放度和 CTCF 信号匹配非候选拷贝，再比较结构敏感性。候选排序之后需用独立 Hi-C、QTL 或扰动数据检验；模型敏感性不能代替变异的临床致病证据。</p><p>另外，输入包含实测细胞状态的优势，也是因果解释的限制。若风险变异通过改变开放度影响接触，保持 ATAC 不变只是在条件固定下估计序列直接效应；同时删除 ATAC 则模拟了另一种假设。研究前必须声明要问哪一种。原训练使用四张 V100，轻量设备快速推理的结果不代表单张 16 GB 能原样训练。计算资源有限时，先用预训练模型验证候选机制和读出增益，比重新训练整套三维网络更实际。</p>]]></content>
    
    
    <summary type="html">深入读懂C-Origami：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>74.seq2PRINT：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad92004a/"/>
    <id>https://perry.apay.eu.cc/posts/ad92004a/</id>
    <published>2026-10-04T12:01:14.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:074 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Multiscale footprints reveal the organization of cis-regulatory elements</p><p><strong>期刊与年份：</strong> Nature，2025。<a href="https://doi.org/10.1038/s41586-024-08443-4">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 多尺度染色质足迹能否解析调控区内部结构及其分化和衰老动态？</p><h2 id="这篇研究的问题从哪里来"><a href="#这篇研究的问题从哪里来" class="headerlink" title="这篇研究的问题从哪里来"></a>这篇研究的问题从哪里来</h2><p>ATAC-seq 常被压缩成“某段 DNA 开放了多少”。但同样的总读数，可以来自不同 TF 的保护、不同核小体位置以及不同的局部排列。作者把问题推进为：能否从同一次实验中同时读出这些尺度不同的组织变化？这是测量解释的问题，疾病分类并不是本文的训练任务。下面对研究构思的重建属于我的推测：单尺度足迹易漏掉弱保护的 TF，简单总量又丢掉位置关系，因此先校准测量过程、再让序列模型学习多尺度结构，是比直接扩大分类模型更自然的选择。</p><p>PRINT 与 seq2PRINT 需要分开理解。PRINT 用插入计数、Tn5 序列偏好和局部覆盖建立统计足迹；seq2PRINT 用 one-hot DNA 预测这种足迹，是监督学习。网络首先提取模体，再经残差膨胀卷积整合约 ±920 bp 的上下文，输出各尺度、各位置的足迹。训练计算 z 统计量并用均方误差拟合；另有插入总量输出，但它的梯度在共享卷积之前截断，所以骨干主要学习足迹结构。TF 身份还需要另一个以 ChIP 标签训练的分类器，不能看到保护凹口就声称知道哪个蛋白在那里。</p><p>从范式上看，这是“校准实验观测—学习序列组织规则—解释细胞状态变化”。它兼有物理测量模型和神经网络，最值得模仿的是把两者职责分清。LoRA 利用共享序列规律为大量细胞状态建立适配器，减少逐个训练的成本；这支持节省参数，却不能直接推导全部分析在 16 GB 显存上可跑。</p><h2 id="Figure-1：多尺度足迹检测蛋白—DNA组织"><a href="#Figure-1：多尺度足迹检测蛋白—DNA组织" class="headerlink" title="Figure 1：多尺度足迹检测蛋白—DNA组织"></a>Figure 1：多尺度足迹检测蛋白—DNA组织</h2><p><a href="/img/dl-literature/074/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/074/figure-01.webp" alt="Figure 1" width="1329" height="1326" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 1。点击图片可查看原图。</em></p><p>这张图先解决“看到的凹口是否来自蛋白保护”，才谈预测能力。a、b 把酶的序列偏好放在分析入口；c–g 的裸 BAC DNA、不同浓度重组蛋白和其他足迹方法，是排除酶切假象的关键控制。这里更重要的对照是同一 DNA 在没有蛋白和加入蛋白后的变化，相关系数高只是偏好模型的拟合证据。h、i 把不同大小的保护映射到核小体与 TF，说明多尺度表征为何必要，但也暴露部分 TF 的直接足迹很弱。弱足迹并不证明它不结合，显著足迹也不是无需校准的直接占据量。左、右局部背景都参与检验，可减少单侧开放差异误判成保护；覆盖不足仍会影响统计功效。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>从偏差校正ATAC插入构建不同空间尺度的足迹，说明PRINT测量原理。</td></tr><tr><td>b</td><td>不同Tn5偏差校正模型性能，检验足迹前处理是否可靠。</td></tr><tr><td>c</td><td>加入或不加入MYC&#x2F;MAX的BAC区域插入信号及多尺度足迹，直接验证蛋白结合导致的保护模式。</td></tr><tr><td>d</td><td>所有MYC&#x2F;MAX模体的平均足迹，对比蛋白加入前后。</td></tr><tr><td>e</td><td>PRINT模体足迹分数的浓度条件比较，检验结合检测。</td></tr><tr><td>f</td><td>TOBIAS对应评分与e比较，评价不同方法对该实验的识别。</td></tr><tr><td>g</td><td>两相邻MYC&#x2F;MAX位点在三种浓度的足迹，展示多尺度方法分离邻近结合和浓度效应。</td></tr><tr><td>h</td><td>HepG2一个候选调控区足迹对组蛋白ChIP轨迹，连接足迹与染色质环境。</td></tr><tr><td>i</td><td>AR、CREB1、TFE3、NFIA等平均足迹，展示不同因子的空间形状差异。</td></tr></tbody></table><h2 id="Figure-2：从DNA序列解码调控区内部结构"><a href="#Figure-2：从DNA序列解码调控区内部结构" class="headerlink" title="Figure 2：从DNA序列解码调控区内部结构"></a>Figure 2：从DNA序列解码调控区内部结构</h2><p><a href="/img/dl-literature/074/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/074/figure-02.webp" alt="Figure 2" width="1329" height="1152" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 4 页，Figure 2。点击图片可查看原图。</em></p><p>a–c 的顺序是先预测结构，再选择结构区域做归因，因此不同尺度的归因可以指向自身模体或邻近协作因子。不能把 β、δ 指向邻近模体解释成已经测得蛋白相互作用。d、e 的 TF 分数使用 ChIP 监督的下游模型，比较时采用相同候选模体位点；结果支持这一组合比单纯足迹计分更擅长排序结合位点，尤其能利用弱足迹周围的组织信息。f 的真实 CTCF degron 与模型中打乱 DNA 模体，是方向相近但性质不同的干预：去除蛋白可能产生全局后果，修改模体只改变局部序列。两者吻合为解释增加可信度，却不能把所有 g 的虚拟打乱都升级成实验结论。h 的未知模体是待解释的序列规律，不等于发现了一个新 TF。</p><p>核小体预测也有单独证据来源：足迹到核小体的回归器使用酵母化学定位数据训练，再评价位置恢复。因此“跨尺度识别”并不是一个无标签网络自动命名所有结构，而是数个有不同监督来源的模型共同组成证据链。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>足迹到对象模型及seq2PRINT流程，说明如何从测量与序列预测组织状态。</td></tr><tr><td>b</td><td>代表区域真实与预测多尺度足迹，检查定位及尺度。</td></tr><tr><td>c</td><td>全区域与单个足迹的序列归因，定位驱动不同结构的碱基。</td></tr><tr><td>d</td><td>不同方法TF结合预测的中位精确率，比较足迹解释能力。</td></tr><tr><td>e</td><td>按TF簇分层的精确率比较，检查模型对不同因子是否均有效。</td></tr><tr><td>f</td><td>实际降解CTCF与计算机内破坏CTCF模体后的足迹变化对照，验证因果扰动方向。</td></tr><tr><td>g</td><td>不同TF模体消融的预测足迹变化及聚类，划分调控结构功能类型。</td></tr><tr><td>h</td><td>新发现模体及其消融效应，展示序列归因可揭示新的组织代码。</td></tr></tbody></table><h2 id="Figure-3：人造血分化中的调控区内部动态"><a href="#Figure-3：人造血分化中的调控区内部动态" class="headerlink" title="Figure 3：人造血分化中的调控区内部动态"></a>Figure 3：人造血分化中的调控区内部动态</h2><p><a href="/img/dl-literature/074/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/074/figure-03.webp" alt="Figure 3" width="1336" height="954" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 5 页，Figure 3。点击图片可查看原图。</em></p><p>a、b 用骨髓细胞说明总开放度相似时，预测 TF 结合结构仍能区分状态。这里有七位人类供体，却形成 1,000 个近邻 pseudo-bulk；这些群体存在重叠，绝不是 1,000 份独立生物学重复。c 所谓复杂度是解释 98% 变异所需的主成分数量，它量化跨细胞类型的空间变化，不能直接读成某增强子有多少协作蛋白。d–f 把 HBB 附近调控区沿拟时序排列，展示中心先出现 GATA&#x2F;TAL、边缘后出现其他因子的组织变化。拟时序重建来自横截面细胞，不是追踪同一细胞的真实时间；位点距离与出现时间的关系支持“组织次序”假说，但 g 的中心向边缘模型还需要定点干预验证。</p><p>Methods 对动态图还筛选了与拟时序相关的基因、开放区及结合位点，所以这里描述的是筛选后的发育相关调控集合。把它迁移到疾病进展时，不能先按病理相关性选好峰，再声称模型独立发现了病理轨迹。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>骨髓SHARE-seq UMAP展示分化细胞群。</td></tr><tr><td>b</td><td>SPI1启动子各伪总体ATAC与逐碱基结合分数，观察总体开放相近时内部结合仍可改变。</td></tr><tr><td>c</td><td>用解释98%变异所需主成分数量度量调控区结合复杂性，展示内部结构并非单一开放度变量。</td></tr><tr><td>d</td><td>沿红系分化HS3增强子结合、核小体足迹、ATAC与HBB表达变化，连接结构与功能。</td></tr><tr><td>e</td><td>代表TF结合分数随伪时间变化，识别相继参与的因子。</td></tr><tr><td>f</td><td>结合出现时间相对开放增加时间，以及位点距区中心的关系，分析TF结合时序和空间位置。</td></tr><tr><td>g</td><td>TF依次结合与调控区逐步扩宽的概念图，汇总观察到的分化过程。</td></tr></tbody></table><h2 id="Figure-4：衰老造血干细胞的内部染色质重组"><a href="#Figure-4：衰老造血干细胞的内部染色质重组" class="headerlink" title="Figure 4：衰老造血干细胞的内部染色质重组"></a>Figure 4：衰老造血干细胞的内部染色质重组</h2><p><a href="/img/dl-literature/074/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/074/figure-04.webp" alt="Figure 4" width="1327" height="1051" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 7 页，Figure 4。点击图片可查看原图。</em></p><p>a–f 把衰老变化拆为细胞状态构成与同一状态内的调控变化。这一点比单纯老年轻差异更重要，因为混合比例改变也能产生看似分子重编程的信号。g 是 chromVAR 模体相关开放度，不是直接测量 TF 蛋白数量或 ChIP 结合。h 的已知结构与 AlphaFold3 预测为 ETS&#x2F;Runx 复合模体提供物理可行性，预测结构本身没有证明这些复合物在老年 HSC 中真实形成。i、j 显示一批核小体足迹改变而总 ATAC 未显著改变的区域，说明总量指标可能遗漏组织信息；这不能被改写成整个基因组的组蛋白普遍减少。k 的 Wasl 个例将 RNA、总量、足迹和预测结合连起来，是候选机制的可视化，列中心化后的负值也不代表“负的蛋白结合”。</p><p>实验来自年轻与老年雄性小鼠，分选时同年龄细胞合并，100 个 HSC pseudo-bulk 更不能代替独立动物重复。因此关于年龄的统计关联应连同这种采样限制阅读。l 给出整合解释，能够提出待验证机制，但本文没有直接建立 AD 的病理因果关系。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>a</td><td>年轻／老年小鼠数据采集和分析流程，定义衰老比较。</td></tr><tr><td>b</td><td>HSC及祖细胞UMAP展示群体结构。</td></tr><tr><td>c</td><td>HSC UMAP按鼠年龄着色，观察年龄关联状态分布。</td></tr><tr><td>d</td><td>同一空间的衰老基因签名活性，检验转录层面的状态变化。</td></tr><tr><td>e</td><td>五种主要HSC亚群，定义后续比较分层。</td></tr><tr><td>f</td><td>100个HSC伪总体表达程序的聚类热图，支持五种亚群划分。</td></tr><tr><td>g</td><td>已知和新发现模体按老／年轻chromVAR差异排序，筛选年龄相关调控模式。</td></tr><tr><td>h</td><td>Ets同／异二聚体组合模体与蛋白结构，展示新序列模式的结构合理性。</td></tr><tr><td>i</td><td>年龄差异核小体区域与差异开放区域重叠及火山图，说明内部核小体变化可超出总体开放变化。</td></tr><tr><td>j</td><td>衰老失去核小体足迹区域的TF模体富集，提出结构重组相关因子。</td></tr><tr><td>k</td><td>Wasl启动子年轻／老年HSC的核小体、TF结合、ATAC与RNA对照，提供局部重组实例。</td></tr><tr><td>l</td><td>衰老导致调控区内部组织改变的示意，连接这些多层观察。</td></tr></tbody></table><h2 id="我的理解与可以迁移的启发"><a href="#我的理解与可以迁移的启发" class="headerlink" title="我的理解与可以迁移的启发"></a>我的理解与可以迁移的启发</h2><p>对 AD&#x2F;转座子项目，最有价值的研究问题是：同一 TE 家族或同一开放水平下，内部保护结构是否随细胞状态和病理负担改变？这比再做一次 TE 重叠 peak 差异分析更具体。第一步要确认公共数据有可用的 fragments 或切点以及足够覆盖；随后按供体聚合、匹配插入深度和可比对性，以独立供体检验结构变化。TE 重复可能复制固定间距，必须与同家族、相近序列和覆盖的背景比较，才有机会区分祖先序列结构与新的调控重组。</p><p>我更看重本文改变了“监督标签”的定义：不必总是预测疾病，也可以预测经测量校准的中间表型，再让病理标签留在模型冻结后的检验阶段。这仍不自动成为完全无监督研究，但更便于限制标签泄漏。真实的创新需要证明中间表型增加了超出总开放度的信息，而不是只展示更漂亮的轨迹或更精细的热图。</p><p>另一个需要认真控制的环节是 pseudo-bulk 的重叠：相邻群体共享细胞会使预测轨迹格外平滑，也可能低估统计不确定性。可视化时可以使用这种聚合改善覆盖，但疾病关联的显著性与泛化评价应回到独立供体或独立样本。对于脑组织，死后间隔、样本保存、细胞比例和文库批次同样会改变插入分布，解释到具体 TF 前应逐项排除这些替代来源。</p>]]></content>
    
    
    <summary type="html">深入读懂seq2PRINT：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
  <entry>
    <title>73.Puffin：原图、模型逻辑与研究范式</title>
    <link href="https://perry.apay.eu.cc/posts/ad920049/"/>
    <id>https://perry.apay.eu.cc/posts/ad920049/</id>
    <published>2026-10-04T12:01:13.000Z</published>
    <updated>2026-10-05T11:41:38.000Z</updated>
    
    <content type="html"><![CDATA[<!-- dl-literature-import:073 --><style>#article-container td,#article-container th{white-space:normal;overflow-wrap:anywhere}#article-container td:first-child,#article-container th:first-child{width:22%}</style><p><strong>论文题名：</strong> Sequence basis of transcription initiation in the human genome</p><p><strong>期刊与年份：</strong> Science，2024。<a href="https://doi.org/10.1126/science.adj0116">论文原文</a>。</p><p>范围为正文全部编号主图及其子图，包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。</p><p><a href="/series/dl-disease-dna-92/">返回专题总目录</a></p><p><strong>本篇问题：</strong> 启动子序列怎样决定转录起始位置、方向性和跨环境表达选择性？</p><h2 id="用两种模型回答两层问题"><a href="#用两种模型回答两层问题" class="headerlink" title="用两种模型回答两层问题"></a>用两种模型回答两层问题</h2><p>Puffin 的目标不是只提高表达预测，而是理解启动子 DNA 怎样决定起始位置和方向。作者先训练看 100 kb 的 Puffin-D，再根据它揭示的局部依赖设计更简单的 Puffin。前者强调准确预测，后者把计算拆成序列模式及其位置效应，便于逐项解释。这种‘复杂模型探索—简单模型总结—独立实验核验’的范式尤其值得借鉴。</p><p>我的推测是，选题由一个知识缺口形成：许多人类启动子没有经典 TATA 元件，却仍形成清楚的 TSS 分布，单个共识模体不足以解释它们。作者因而把输出设为双链逐碱基起始信号，而非整段是否启动，再问能否用少量规则重建这个分布。这是我的论证重建。模型学习的模体并非预先指定，它们从多种起始测量和 DNA 中获得；名称在训练后结合已知知识赋予。</p><p>Puffin 有模式激活层和位置效应层，模体、起始子与三核苷酸各采用适合的范围，效应在对数尺度相加。训练主要用归一化的 KL 散度重视形状，辅以弱的幅值损失。因此它首先解释哪里开始转录，整体丰度仍可能受远端影响。训练信号按实验技术合并多个细胞，提供的是核心规则，而非每个细胞实时状态；CAGE&#x2F;RAMPAGE 的成熟转录本与 GRO&#x2F;PRO-cap 的新生转录本也具有不同含义。</p><h2 id="Figure-1：预测型与解释型转录起始模型"><a href="#Figure-1：预测型与解释型转录起始模型" class="headerlink" title="Figure 1：预测型与解释型转录起始模型"></a>Figure 1：预测型与解释型转录起始模型</h2><p><a href="/img/dl-literature/073/figure-01.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/073/figure-01.webp" alt="Figure 1" width="1308" height="1325" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 3 页，Figure 1。点击图片可查看原图。</em></p><p>A 区分两种模型的角色，B 把 Puffin 的每一步拆成可查看的量。模体匹配激活和‘在距模体多少碱基处影响起始’是两套权重，使同一模体可以对不同相对位置产生不同作用。可解释性来自受约束的计算结构，而不是训练后只附一张注意力图。</p><p>C、D 用留出染色体上的实际启动子检查逐碱基形状。覆盖较低时实验本身也不稳定，作者将不同 CAGE 技术相关作参照。模型有时比两种技术之间更相关，不能解释成它超过真实生物学：汇总、平滑、实验偏好和高可信启动子的选择都影响测量。正文的性能主要基于跨技术形状一致的启动子，不能无条件推广到所有弱或异常疾病启动子。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>Puffin-D用于高精度预测，Puffin用于解析启动子代码，两者连接模体、方向性及跨物种研究。</td></tr><tr><td>B</td><td>序列模式激活、位置效应和加总预测的计算流程，说明Puffin如何产生可解释的逐碱基贡献。</td></tr><tr><td>C</td><td>未见染色体启动子的双链起始信号对预测，检查位置及峰形。</td></tr><tr><td>D</td><td>不同测序覆盖组的逐碱基相关，并用两套CAGE实验相关作参照，说明低覆盖对评估的限制。</td></tr></tbody></table><h2 id="Figure-2：序列模式的特定位置效应"><a href="#Figure-2：序列模式的特定位置效应" class="headerlink" title="Figure 2：序列模式的特定位置效应"></a>Figure 2：序列模式的特定位置效应</h2><p><a href="/img/dl-literature/073/figure-02.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/073/figure-02.webp" alt="Figure 2" width="1308" height="1282" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 5 页，Figure 2。点击图片可查看原图。</em></p><p>A–C 比较三个模式层级：模体提供广域驱动，起始子偏好精调局部位置，三核苷酸承接剩余序列依赖。模型的简洁不是说转录只有九种蛋白参与，而是这些模式足以解释训练测量中的主要局部变化；一个 SP 或 ETS 模式也可能对应多个家族蛋白。</p><p>D 的横轴相对模体中心，而后来保守性图相对 TSS，两者有镜像坐标关系，读图必须先确定参照点。E、F 显示已知模式与 Long Inr 的局部结构。U1 的影响主要出现在成熟转录本测量中，说明它可以影响起始后的延伸和转录本存续，不能把所有模型预测峰都视为初始起始机制。NFY 的周期位置效应提供物理机制线索，但周期本身尚未确定具体分子接触。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>展示模型学习的模体、起始子和三核苷酸三类模式，说明表达预测的组成。</td></tr><tr><td>B</td><td>最强4万个启动子的平均位置效应，比较三类模式在TSS周围的分工。</td></tr><tr><td>C</td><td>不同转录起始强度下的TSS模式效应，检验序列贡献与表达强度关系。</td></tr><tr><td>D</td><td>每种模体正反方向的位置效应，区分双向与单向代码；U1效应主要作用于起始后的成熟过程。</td></tr><tr><td>E</td><td>模型学到的常规转录起始模体及命名，定位已知和新模式。</td></tr><tr><td>F</td><td>Long Inr等起始子模式与已有核心启动子模体的重叠，展示细致的TSS序列规则。</td></tr></tbody></table><h2 id="Figure-3：TF去除和模体编辑的实验验证"><a href="#Figure-3：TF去除和模体编辑的实验验证" class="headerlink" title="Figure 3：TF去除和模体编辑的实验验证"></a>Figure 3：TF去除和模体编辑的实验验证</h2><p><a href="/img/dl-literature/073/figure-03.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/073/figure-03.webp" alt="Figure 3" width="1308" height="1365" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 7 页，Figure 3。点击图片可查看原图。</em></p><p>A 将对应模体激活归零，是模型内部对‘移除这个序列规则’的近似。B、C 用实际 NFYA 敲低和 YY1 急性去除后的起始相关测量检查预测位置变化，并且这些实验在小鼠细胞进行，构成跨物种验证。真正 TF 去除可能有间接网络反应，不能与模型关掉一个通道严格等价；一致性说明其捕获了一部分直接局部效应。</p><p>D 将高贡献与低贡献启动子并列，检验模型不只是挑到一个好案例；E 则通过 TATA&#x2F;NFY 插入、删除报告实验具体改变 DNA，包括 LTR12 来源启动子。所有轨道在实例中缩放后比较，主要支持位置与相对形状，不能由图中高度直接比较绝对表达倍数。正文另有原位 CRISPR-Cap 验证，但那部分位于补充资料，不应冒充主图 E 的报告实验已经在原位完成。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>把对应模体激活设零模拟TF去除，说明计算机内敲除方法。</td></tr><tr><td>B</td><td>NFY模拟去除后的TSS变化与NFYA敲低Start-seq对照，检验位置迁移预测。</td></tr><tr><td>C</td><td>YY1模拟去除对mNET-seq实测变化，验证另一TF的起始调节。</td></tr><tr><td>D</td><td>高NFY或YY1贡献的启动子更受相应TF去除影响，支持贡献分数的功能意义。</td></tr><tr><td>E</td><td>TATA／NFY位点插入或删除的预测与实测信号，验证改变具体模体可改变起始位置和强度。</td></tr></tbody></table><h2 id="Figure-4：模体组成与启动子表达选择性"><a href="#Figure-4：模体组成与启动子表达选择性" class="headerlink" title="Figure 4：模体组成与启动子表达选择性"></a>Figure 4：模体组成与启动子表达选择性</h2><p><a href="/img/dl-literature/073/figure-04.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/073/figure-04.webp" alt="Figure 4" width="1308" height="1395" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 8 页，Figure 4。点击图片可查看原图。</em></p><p>A、B 把每个启动子的模式贡献按明确窗口汇总，显示不同组合都可以实现起始，没有单一模体适用于全部。C、D 将模式组合与 FANTOM 跨细胞表达离散度联系起来，例如高 TATA 贡献更常伴随选择性表达。它们首先是关联，不能宣称某一个模体单独决定组织身份。</p><p>E–G 的虚拟插入改用 Puffin-D，将同一个 600 bp 启动子放进许多不同长程背景，询问它对外界调控环境的响应。这里是计算替换筛选，不是实际完成全部四万乘三千五百次基因组插入；插入目标还来自一个固定区域，未覆盖所有染色质环境。H 将这种背景选择性与真实跨细胞离散度关联，支持一种机制假说：启动子代码调节对外部激活的响应曲线。作者仍将这一解释称作推断，不能写成已经完全证明的细胞特异机制。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>用TSS附近预测加权平均定义模体贡献分数，并展示高表达启动子实例。</td></tr><tr><td>B</td><td>4万个启动子按主要贡献模体排列，显示不同模体组合形成的启动子类别。</td></tr><tr><td>C</td><td>平均表达对跨细胞／组织离散度按模体贡献着色，检验模体组成与表达特异性关系。</td></tr><tr><td>D</td><td>不同启动子类别的FANTOM表达热图，展示对应的组织表达模式。</td></tr><tr><td>E</td><td>把600bp启动子虚拟插入3500个基因组环境，用Puffin-D评价对远端上下文的选择性。</td></tr><tr><td>F</td><td>不同主导模体的启动子能在多大比例环境达到高表达，比较上下文敏感性。</td></tr><tr><td>G</td><td>预测表达对插入环境活性排序的响应曲线，展示不同代码对外部激活信号的响应差异。</td></tr><tr><td>H</td><td>虚拟插入选择性及序列模体选择性对实际跨细胞表达离散度，连接基因组上下文与组织特异性。</td></tr></tbody></table><h2 id="Figure-5：双向转录起始的共同序列基础"><a href="#Figure-5：双向转录起始的共同序列基础" class="headerlink" title="Figure 5：双向转录起始的共同序列基础"></a>Figure 5：双向转录起始的共同序列基础</h2><p><a href="/img/dl-literature/073/figure-05.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/073/figure-05.webp" alt="Figure 5" width="1308" height="1375" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 10 页，Figure 5。点击图片可查看原图。</em></p><p>A 提醒我们，新生转录的双向起始与成熟 RNA 的方向性可以同时成立。双向模体可向两个方向驱动起始，U1 等规则影响后续成熟结果，二者并不矛盾。B 的逐模式贡献让我们看到两个方向是否使用同一段序列，而不只是看到两条相邻峰。</p><p>C 的八千余个双向启动子提供系统比较，D 显示近距离 TSS 更常共享贡献，距离增大后共享下降。这里比较的是模型中的碱基贡献相关，不能等同于两个方向具有同一调控蛋白组成或相同稳定转录本功能。对 TE 衍生启动子，可分别检测正反链新生与成熟信号，避免把反向微弱 RNA 全部当成新的稳定基因表达。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>双向模体驱动两条链起始，单向模体与U1等共同影响方向，区分新生与成熟转录本的方向性。</td></tr><tr><td>B</td><td>代表启动子双链预测／实测及逐模体贡献，展示两方向是否共享驱动序列。</td></tr><tr><td>C</td><td>8216个双向启动子按反向TSS排序，对照实测、预测和贡献热图，系统检查共享序列代码。</td></tr><tr><td>D</td><td>两方向贡献相关对TSS间距，近距离TSS通常共享较多贡献序列，远距离共享较弱。</td></tr></tbody></table><h2 id="Figure-6：哺乳动物间的规则泛化与保守"><a href="#Figure-6：哺乳动物间的规则泛化与保守" class="headerlink" title="Figure 6：哺乳动物间的规则泛化与保守"></a>Figure 6：哺乳动物间的规则泛化与保守</h2><p><a href="/img/dl-literature/073/figure-06.webp" style="display:block;text-decoration:none"><img class="nolazyload" src="/img/dl-literature/073/figure-06.webp" alt="Figure 6" width="1308" height="1035" style="display:block;max-width:100%;width:auto;height:auto;object-fit:contain;margin:0 auto" loading="lazy" decoding="async"></a></p><p><em>原图来源：所用 PDF 文件第 11 页，Figure 6。点击图片可查看原图。</em></p><p>A、B 用人鼠模型互相预测，实际标签支持核心规则可迁移。作者通过人鼠对应位置的拆分避免近同源测试序列落在人模型训练范围，比较比单纯换一个物种更严格。C–E 进一步用 241 哺乳动物的比对保守性检验位置规则，TATA、YY1 和 NFY 的效应位置与保守位置趋势相符。</p><p>这两条证据的强度不同：鼠有实际起始数据，大多数其他物种主要提供序列保守性，而非全部获得起始测量。序列身份分数还经过物种间尺度归一化，不能把跨物种曲线直接当作同尺度自然选择系数。保守性支持功能约束与模型解释一致，仍不能推出每个物种的表达和疾病后果已经验证。</p><table><thead><tr><th>子图</th><th>讲的是什么，以及如何理解</th></tr></thead><tbody><tr><td>A</td><td>人／鼠模型跨物种测试的流程及实例，定义序列规则迁移比较。</td></tr><tr><td>B</td><td>两模型在小鼠未见启动子的预测高度相似、性能接近，说明核心规则可跨物种复用。</td></tr><tr><td>C</td><td>241种哺乳动物的模体贡献与序列保守性比较流程。</td></tr><tr><td>D</td><td>从人TSS看各模体位置特异PhyloP，保守性模式与预测位置效应相符。</td></tr><tr><td>E</td><td>从其他物种看位置保守性，贡献分数能预测各物种序列保守程度，支持规则的广泛保留。</td></tr></tbody></table><h2 id="我的理解：让解释成为可操作的模型"><a href="#我的理解：让解释成为可操作的模型" class="headerlink" title="我的理解：让解释成为可操作的模型"></a>我的理解：让解释成为可操作的模型</h2><p>最可迁移的启发是，解释不必停在黑箱归因；可以把复杂模型学到的关系压缩成有明确位置、方向和模式分工的模型，再设计会失败的验证。对 TE–AD 问题，可以先问某些拷贝是否形成替代起始、双向起始或与常规启动子不同的背景敏感性，而不是直接追求一个 AD 分类分数。</p><p>如果使用公共数据，尤其要把新生与成熟 RNA、局部启动子与远端环境分开。单细胞 RNA 表达不能完整替代逐碱基 TSS 数据，ATAC 开放也不能直接确定从哪个位置起始。可以先用现成 Puffin 计算局部规则，再用脑细胞 CAGE、长读长或公开转录本证据核对候选；异常起始到 AD 病理仍需要独立队列联系。</p><p>这篇论文没有证明所有调控都可加性描述。对数可加是模型选择，在任务范围内有效，但真正 TF 竞争、染色质与远端增强子可能需要更复杂项。个人显卡上可优先使用简单 Puffin 的已有权重或针对少量相关输出的小模型；不能因 Puffin 解释简单就默认 100 kb Puffin-D 全训练也有相同成本。研究价值来自找准可检验的序列规则和证据层，而非把两种模型的能力混在一起。</p>]]></content>
    
    
    <summary type="html">深入读懂Puffin：正文原图与全部子图、模型输入输出、研究思路、验证证据和阅读启发。</summary>


    <category term="文章研读" scheme="https://perry.apay.eu.cc/categories/%E6%96%87%E7%AB%A0%E7%A0%94%E8%AF%BB/"/>
    
    
    <category term="文献阅读" scheme="https://perry.apay.eu.cc/tags/%E6%96%87%E7%8C%AE%E9%98%85%E8%AF%BB/"/>
    
    <category term="深度学习" scheme="https://perry.apay.eu.cc/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="逐图解读" scheme="https://perry.apay.eu.cc/tags/%E9%80%90%E5%9B%BE%E8%A7%A3%E8%AF%BB/"/>
    
    <category term="调控基因组" scheme="https://perry.apay.eu.cc/tags/%E8%B0%83%E6%8E%A7%E5%9F%BA%E5%9B%A0%E7%BB%84/"/>
    
    <category term="DNA序列模型" scheme="https://perry.apay.eu.cc/tags/DNA%E5%BA%8F%E5%88%97%E6%A8%A1%E5%9E%8B/"/>
    
  </entry>
  
</feed>