3.ExPecto:原图、模型逻辑与研究范式

3.ExPecto:原图、模型逻辑与研究范式
Perry论文题名: Deep learning sequence-based ab initio prediction of variant effects on expression and disease risk
期刊与年份: Nature Genetics,2018。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: 当前 PDF 为 Nature Genetics 2018 论文的作者手稿;主图与图注位于文末,多处续页。
研究瓶颈怎样转化为问题
eQTL 需要在人群中观察到变异,还需要匹配相关组织表达,因此对极罕见或从未出现的突变存在天然空白。ExPecto 的问题是:能否先学会序列怎样形成调控特征、调控特征怎样决定表达,再为任意序列变化估计组织特异的表达后果?根据研究设计推断,这个 idea 是把难以直接训练的‘稀有变异→表达’拆为两个具有大量参考基因组标签的任务。它还进一步问:相同的表达增减,对不同基因为何可能有相反的有害方向?
输入、目标与模型结构
框架首先用卷积网络预测 2,002 个 TF、染色质标记和可及性特征,再把 TSS 周围 40 kb 的空间模式转换为较低维特征,最后以 L2 正则化线性模型预测 218 种组织/细胞的表达。卷积层适合识别可复用局部序列,空间转换保留相对 TSS 的距离与方向,组织线性头控制参数规模并让同一调控表征服务多个组织。训练不使用变异效应,但仍使用参考序列上的实验调控与表达标签,因此 ab initio 不表示无监督。
证据链从留出基因表达、eQTL 方向、GWAS 位点和报告基因,延伸到突变空间的方向不对称与进化约束。这里每一步增加不同证据,不能把起点的高表达相关性当作终点疾病风险的准确率。
Figure 1:ExPecto 的表达预测
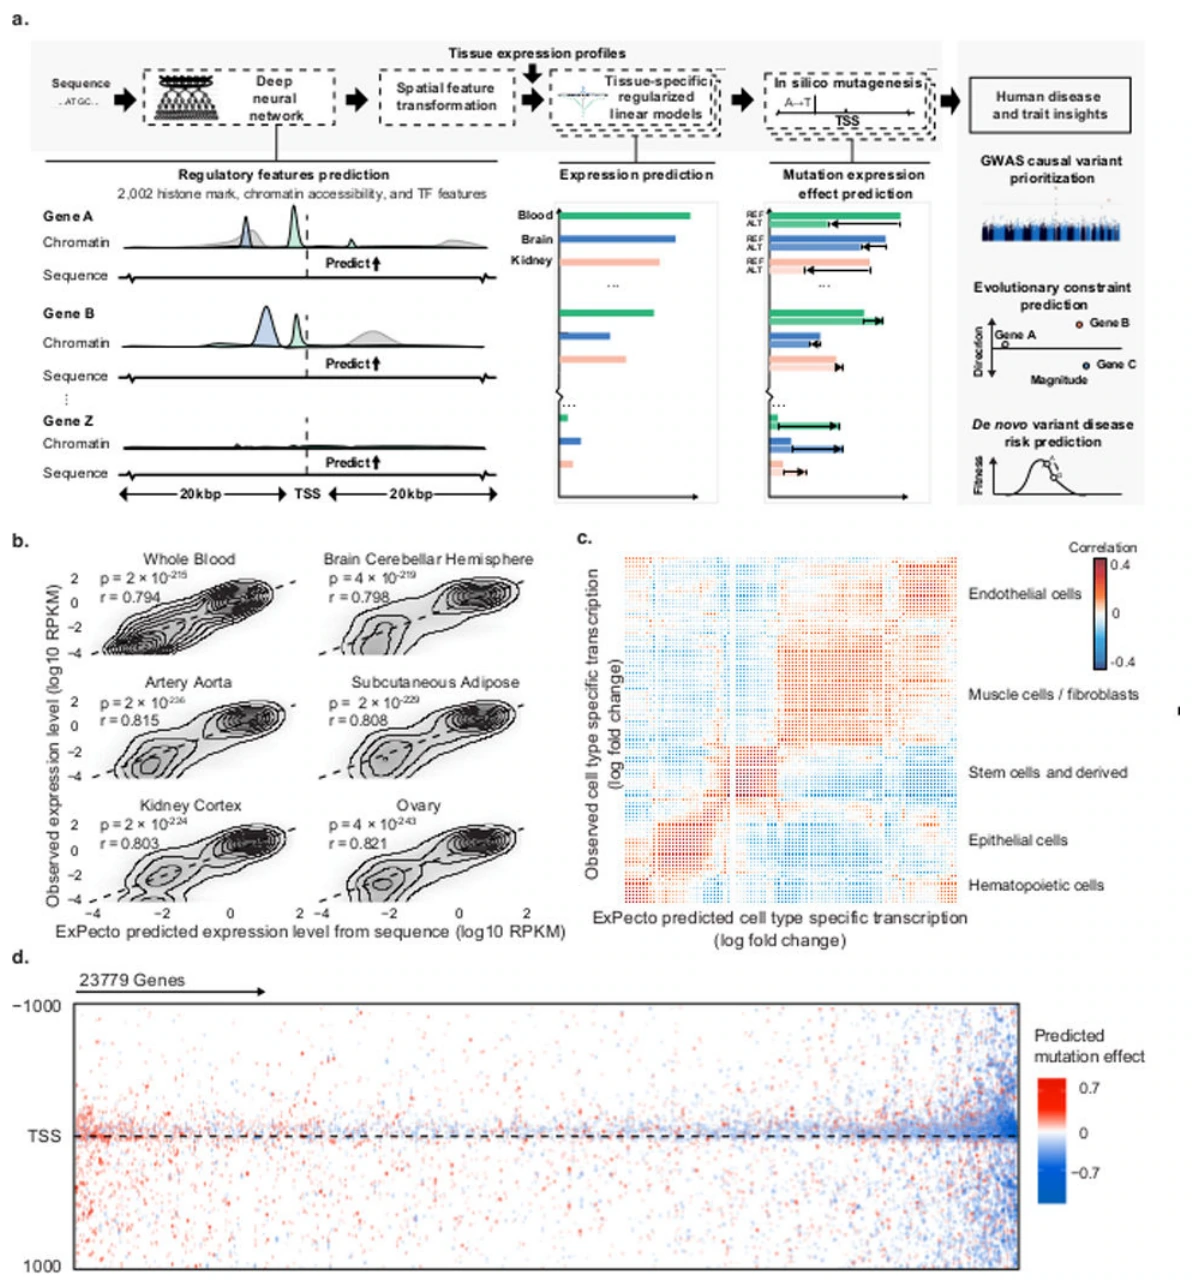
原图来源:所用 PDF 文件第 19 页,Figure 1。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 卷积网络把序列转为染色质调控特征,空间转换整合基因周围的信息,线性模型输出组织特异表达;三个模块连接序列与表达。 |
| b | 在留出染色体的 990 个基因上,比较预测 log RPKM 与 RNA-seq;跨组织的相关性评估未训练基因上的泛化。 |
| c | 热图比较预测与实测相对各组织均值的表达变化相关性;考察模型是否能恢复组织特异表达,而非只学到基因普遍高低表达。 |
| d | 对 23,779 个基因 TSS 附近进行计算突变,热图显示平均预测表达效应及敏感位置;不同基因的调控序列敏感性明显不同。 |
a 给出模块化思想,b 验证未训练基因的整体表达,c 单独检查组织差异,d 才将模型用于未观察突变。这样设计是因为一个只会区分普遍高表达和低表达基因的模型,也能获得很好跨基因相关性,却未必会预测组织特异变异。c 的均值校正检验缓解了这一问题。d 的敏感位置是模型在现有序列上的局部响应,不能直接解释为每个位置都有实测 enhancer 功能;40 kb 窗口以外的远端调控和转录后影响也可能遗漏。正文中 0.819 的中位 Spearman 是参考表达预测,并非 Δexpression 的效应量校准。
Figure 2:表达变异预测的可信度
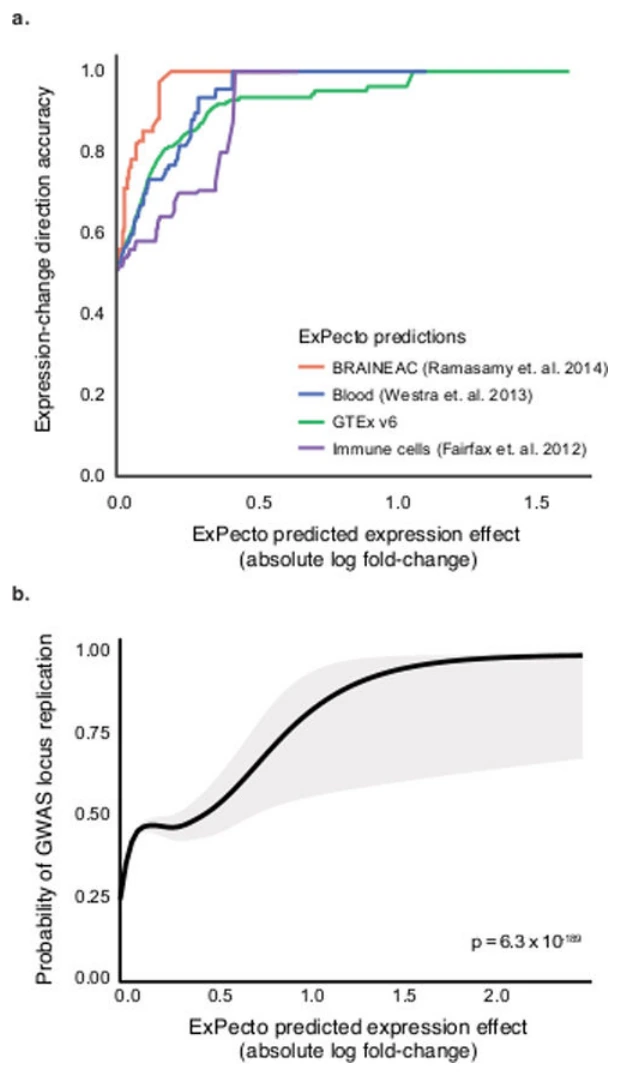
原图来源:所用 PDF 文件第 21 页,Figure 2。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 提高预测绝对 log fold-change 阈值,检查各 eQTL 研究的表达变化方向准确率;强效应预测通常方向更可靠。 |
| b | 横轴是 GWAS 区域内最大的预测表达效应,纵轴是独立研究重复该位点的概率;平滑曲线及置信区间显示更强预测效应与更高重复概率相关。 |
a 用逐渐提高的效应阈值检验方向可靠性,实质是准确率与覆盖率的权衡:模型对很小变化容易被观测误差和 eQTL 连锁掩盖,强预测子集更可验证。eQTL 中关联 SNP 不必是因果 SNP,因此无法把所有方向不一致都归为模型错误,也不能把这种不确定性当作模型必然正确。b 关注独立 GWAS 重复,是疾病关联层的辅助支持;重复概率还受样本量、等位频率和研究设计影响,不能等同功能因果概率。
Figure 3:GWAS 候选因果变异及报告基因验证
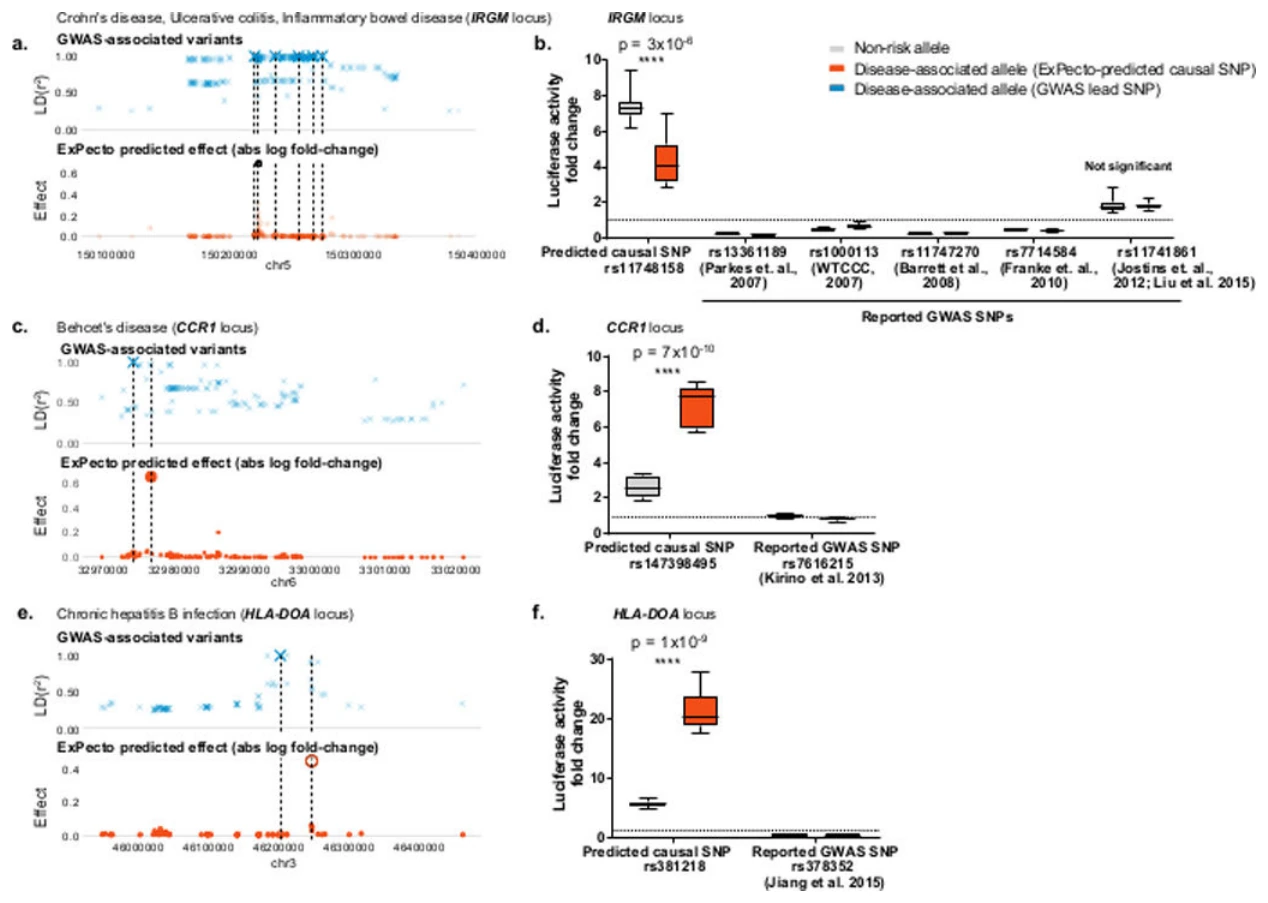
原图来源:所用 PDF 文件第 22 页,Figure 3。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 炎症性肠病位点:上方显示与 GWAS 报告 SNP 的连锁不平衡,下方显示各变异的预测表达效应;计算优先变异可能与统计领头 SNP 不同。 |
| b | 在 IRGM 附近比较优先变异两种等位基因的荧光素酶活性;预测候选显示方向一致的调控差异,原 GWAS 领头变异未显示相应差异。 |
| c | Behçet 病位点重复 LD 与预测效应比较,为该区域的功能候选排序。 |
| d | 对 CCR1 附近候选作荧光素酶检验;候选等位基因的调控活性差异支持预测优先级。 |
| e | 慢性乙肝感染位点展示 LD 与预测表达效应,定位 HLA-DOA 附近候选。 |
| f | 在 HLA-DOA 区域验证两等位基因活性;预测优先变异比报告 SNP 更有功能效应证据。 |
三组‘LD 与预测→双等位报告基因’是这幅图的共同实验逻辑:统计领头 SNP 与功能最强 SNP 可以不同,预测应在同一关联区域内提出额外分辨率。报告实验同时检验候选和领头 SNP,避免只验证最有利的序列。等位活性差异支持局部 cis 调控能力,但载体片段不包含原生染色质、全部远端连接或真实组织复杂性;指定 IRGM、CCR1、HLA-DOA 等基因还需内源表达或 enhancer–gene 联系支持。免疫疾病中的成功也不能直接当作神经细胞中同等精度的证明。
Figure 4:变异潜能与进化约束
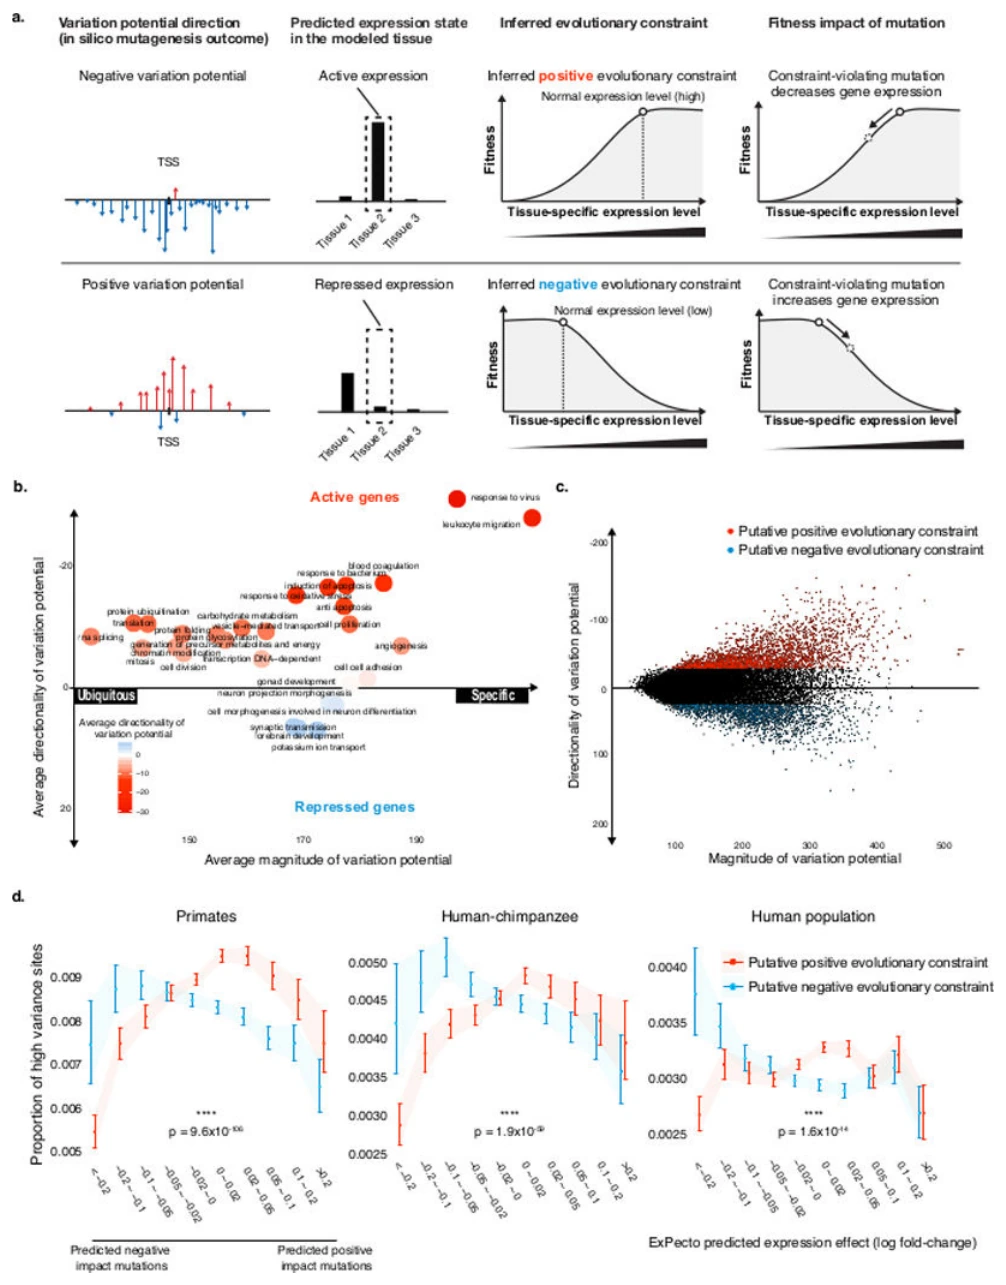
原图来源:所用 PDF 文件第 24 页,Figure 4。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 说明全局计算突变的效应总量和方向构成 variation potential,进而联系表达状态及进化约束。 |
| b | 按基因集合汇总突变效应绝对值及带符号效应;组织特异性和表达激活状态对应不同变异潜能,说明序列可反映表达调控倾向。 |
| c | 每点一个基因,横、纵轴累加提高/降低表达突变的效应;效应不对称用于推断基因表达需要维持偏高或偏低的约束。 |
| d | 左、中、右依次以灵长类加速位点、人类—黑猩猩分化、常见人群变异评估选择压力;违背推断表达方向约束的变异在不同时间尺度下受到不同选择,支持约束解释。 |
variation potential 来自 TSS 附近所有可能单碱基改变的累积效应。若大量改变都更容易降低表达,可以推断现有序列可能处于维持较高表达的状态;反向亦然。这是从模型突变景观提出选择假说,而不是直接测得历史祖先的表达。b、c 先检查该方向与基因表达属性,d 再借不同进化时间尺度和人群变异作正交约束检验。常见变异缺失符合负选择,但可突变性、基因组组成和预测误差亦须控制;个别变异的祖先状态不能由 REF/ALT 标签代替。
Figure 5:识别疾病风险等位基因
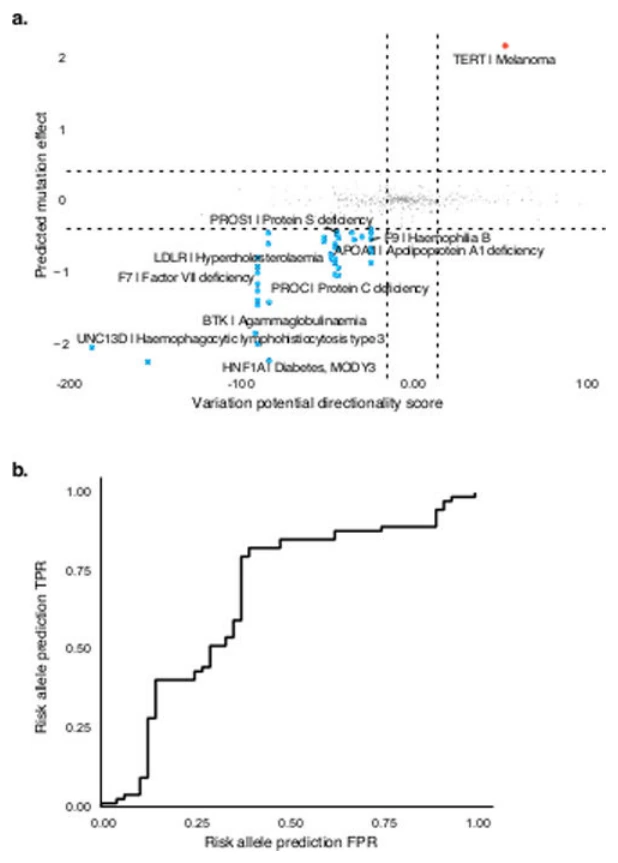
原图来源:所用 PDF 文件第 26 页,Figure 5。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 把 HGMD 调控突变预测表达效应与基因方向约束对应;降低应保持高表达基因、提高应保持低表达基因的突变属于约束违背,致病突变集中于这些方向。 |
| b | 以“变异表达效应 × 变异潜能方向”构成约束违背分数,ROC 检验它对参考或替代等位基因哪一个为风险等位基因的区分能力。 |
把变异表达方向乘以基因的调控方向约束,试图区分‘有功能’与‘有害’:同样提高表达,对应保持高表达和应保持低表达基因,含义不同。a 以 HGMD 调控突变检查这种方向对应,b 检验风险等位基因排序。其关键假设是从参考突变景观推断的稳态方向具有疾病相关性;该假设在所测疾病集合受到支持,仍不应推广为所有组织和年龄阶段都需要同一表达水平。HGMD 对强效、已知基因的选择也限制了对常见复杂病弱效变异的外推。
我的理解与可迁移设计
这篇最可借鉴的创新不只是增加模型深度,而是把‘序列→功能变化’与‘功能变化→有害方向’明确分开。对 AD,模型可以先预测等位变化影响哪些调控特征和表达,再用细胞类型、遗传关联及真实 MPRA 判定是否与疾病机制一致。进化层可以作为约束假说,但人类参考序列、祖先序列或跨物种背景的计算替换都是模型预测,不能冒充跨物种实验标签。首轮小规模设计可冻结调控模型、验证一个细胞背景的方向,再逐步加入基因和进化信息,避免同时把多个未经检验环节串成因果结论。
