53.PerturbationLinearBaselines:原图、模型逻辑与研究范式

53.PerturbationLinearBaselines:原图、模型逻辑与研究范式
Perry论文题名: Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselines
期刊与年份: Nature Methods,2025。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: 单/双基因扰动表达预测中的复杂模型,是否真正超过加性、平均和线性预测基线?
研究难点与构思
扰动预测的吸引力是把尚未做的实验变成可计算的表达响应,但“预测得像”可能来自细胞共有的背景而非被扰动基因的作用。双扰动更困难:有两个单基因结果,并不表示模型能识别协同或缓冲。我的推测是,论文构思来自把这一承诺拆成不同泛化任务,再用刻意简单但匹配任务的基线要求复杂模型承担证明责任。简单不等于弱:若大多数响应可相加,知道两个单扰动的加法模型拥有强而合理的信息。
一个清楚的基准还要写出什么信息可以提前知道。双扰动的两个单效应是训练资料,直接相加合法;未见单扰动则不能把目标基因的响应用于构造其输入。基础嵌入可以携带外部知识,但来源与重叠要说明。若这些条件没有统一,模型胜出可能仅因多用了目标资料,模型失败也可能因为对手拿到了它没有的可用信息。
论文进一步提示输出收缩的问题。许多预测对不同扰动变化不足,接近同一个背景;对总体表达误差这是低风险策略,对发现条件差异则是失败。应检验预测方差、扰动间距离和少数强响应的恢复,而不只看平均误差。反过来,输出幅度变大也不是改善:噪声会制造极端协同候选,因此必须结合方向、真值与假发现控制。这个约束直接关联实验选择,错误挑选极端候选会浪费后续实验资源。
输入、输出与模型比较
双扰动使用Norman的K562 CRISPR激活数据,训练包含全部100个单扰动及62个双扰动,测试另外62个双扰动,重复五种划分。预测目标是基因表达或相对对照的变化,不是直接预测疾病治疗收益。加法基线将两个单扰动的对数倍数变化相加,不需要双扰动训练结果。这个任务检验已知单扰动的组合泛化,不能说模型完全没见过涉及的基因。
单扰动测试则在Replogle K562、RPE1及Adamson数据中留出扰动条件,检验未见干预。线性基线把读出基因表示为G、扰动表示为P,以低维矩阵W映射,近似Y≈GWPᵀ+b,其中b为每基因均值。G与P可以来自训练数据降维,也可用预训练嵌入。这个接口把表征价值和复杂解码器价值分开:相同嵌入用线性模型已达到或超过原模型时,不能把原网络的性能全归给深架构。
受评模型中的基础预训练通常是自监督,扰动响应训练与微调却使用实际干预后的表达标签。因此这里评价的是监督预测及迁移,不能称为纯无监督模型。部分模型并非为每种任务设计,论文没有把不支持未见单扰动的CPA硬塞进相应测试,也没有把缺失所需基因的scFoundation作为有效单扰动比较。
这些信息边界应在评价开始前固定并公开。
评价为什么容易误读
绝对表达由共同背景占很大部分,因而预测与真实值有高相关,不一定恢复扰动差异。论文还专门从加法期望扣除残差,评价真正非加性的遗传互作。这里潜在的困难是稀有信号:被识别为互作的读出基因—组合只占小部分,多数近似相加。若模型主要趋向平均或无变化,它可能在总体误差上尚可,却错过最需要预测的协同响应。
这些任务仍受数据条件限制。使用的四个数据集来自癌细胞系,不能直接代表原代脑组织;作者也没有重新排除所有没有成功改变靶基因的扰动。负结果限定于所测版本、任务和评估,并非数学上否定非线性。最有建设性的理解是,现有证据没有证明复杂系统稳定优于信息匹配的简单方法,下一轮方法应先改变这个事实再扩大宣称。
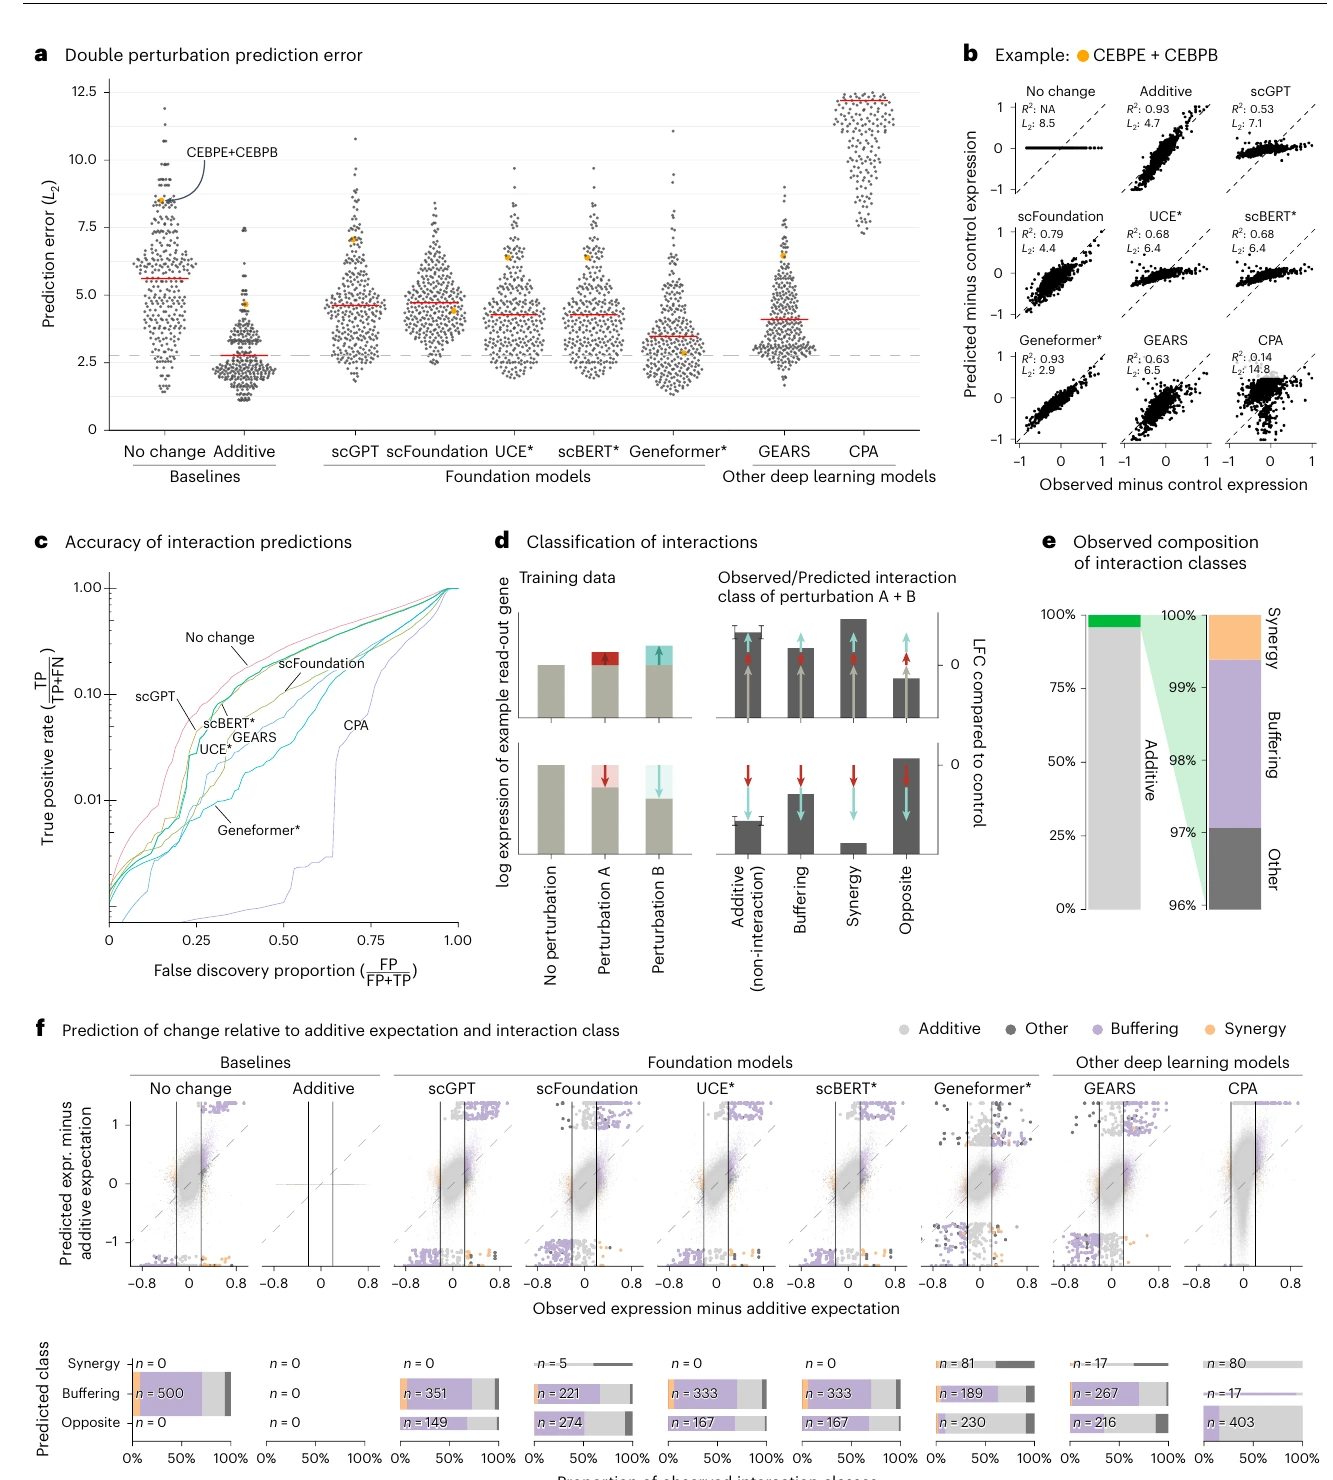
Figure 1|双扰动与遗传互作预测
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
a先比较整体表达预测,b用CEBPE与CEBPB展示加法为何能形成强基线。c转向互作检出,横轴是假发现比例而不是普通分类错误率;在可接受假发现下,模型需恢复真正非加性响应。d、e说明缓冲、协同、反向的定义及其稀少程度,f扣除加法期望并看极端预测的真实类别。多数模型倾向缓冲,不能由“预测有残差”推出发现了可靠协同。
这个图把两个问题分开:组合的总表达是否准,组合超出单效应之和的部分是否准。加法基线无法主动预测互作,但可以很好地预测总体,这一点不是自相矛盾。相反,模型若把输出压回未扰动状态,会造成相对加法的负残差,看起来像缓冲;这种结构性偏差必须被c和f的真值检验识别。用于选择组合药物或基因靶点时,互作准确性比单个漂亮病例的高相关更重要。
| 子图 | 讲解 |
|---|---|
| a | 62 个留出双扰动、五个随机划分的表达 L2 误差;加性基线优于所测深度模型,说明组合预测不能只与弱基线比较。 |
| b | 一个双扰动的实测–预测表达散点,配 L2 和 Pearson delta,展示各模型误差及看似高相关的局限。 |
| c | 互作召回率对假发现比例曲线;所测模型没有超过 no-change 基线,检验非加性信号比整体表达更严格。 |
| d | 以双扰动偏离加性期望定义 buffering、synergistic、opposite 等互作类别,说明分类规则。 |
| e | 真实数据中各互作类别比例,给后续预测组成提供参考。 |
| f | 上图比较预测及实测偏离加性期望的量,下图看最极端预测的真实类别;模型大偏离并不可靠等同真实协同或反向互作。 |
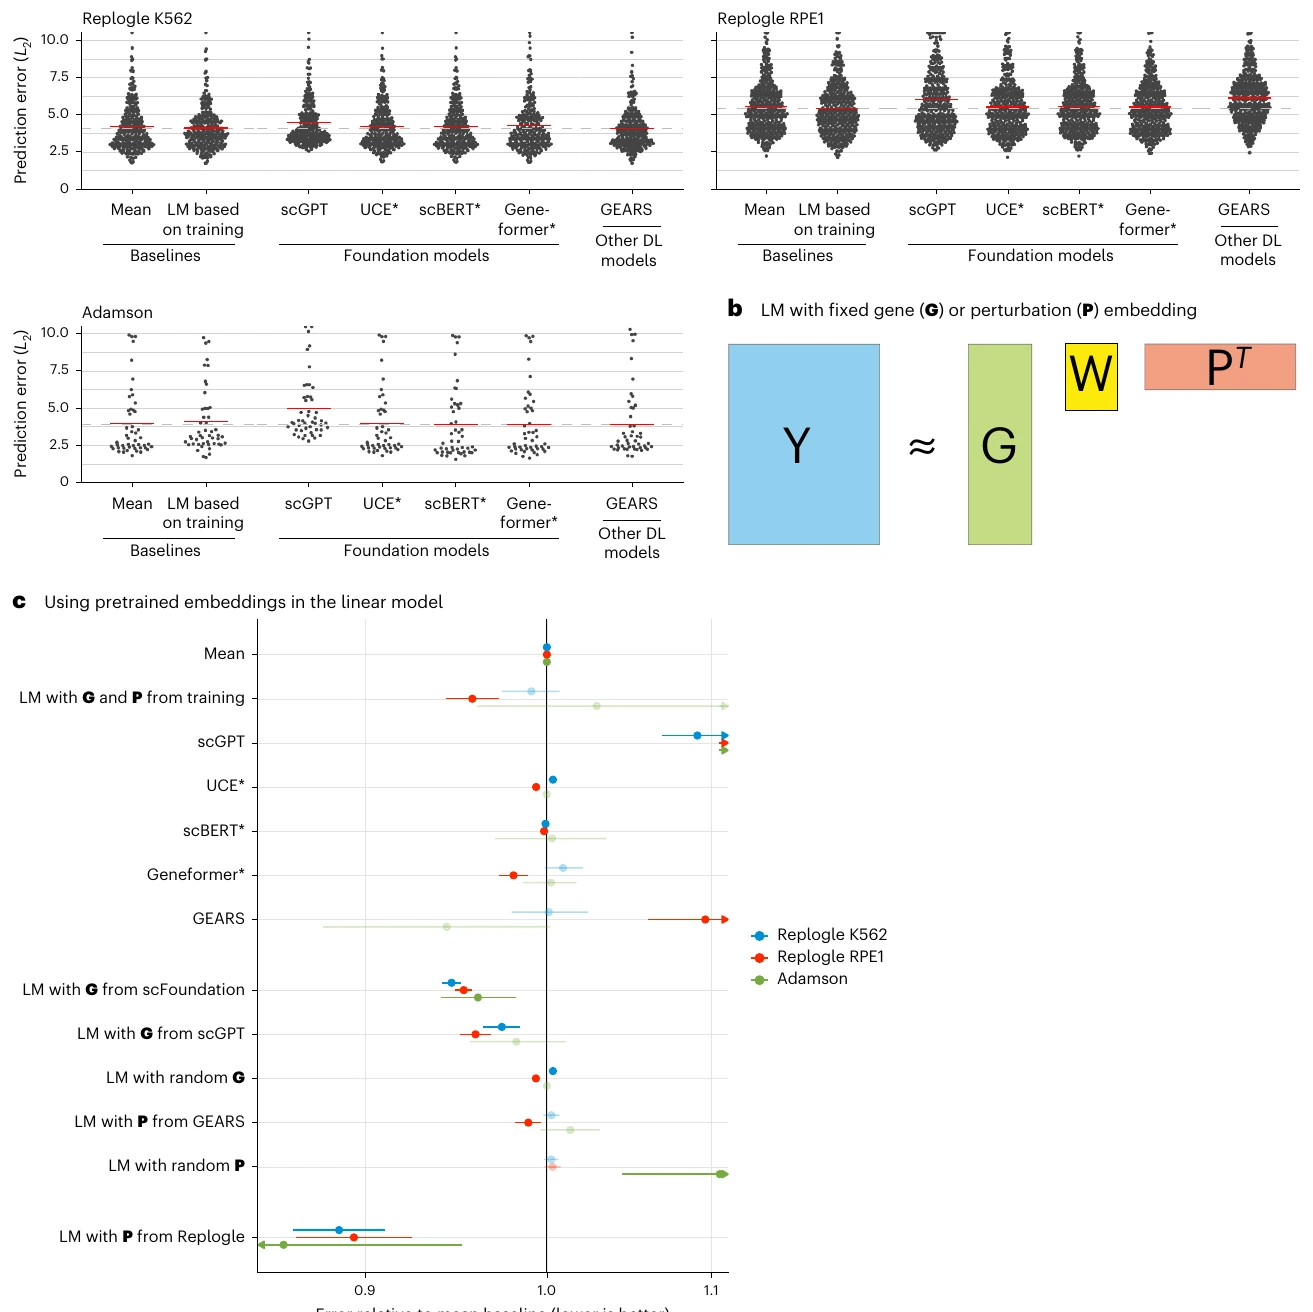
Figure 2|未见单扰动与线性表示
原图来源:所用 PDF 文件第 3 页,Figure 2。点击图片可查看原图。
a将泛化目标改为未见单基因扰动,各方法没有在三个资料上稳定超过平均或线性基线;b显示线性模型如何接受基因和扰动嵌入,c再比较不同嵌入来源。用独立扰动资料预训练的P更有帮助,提示与目标任务接近的信息可能比海量普通细胞图谱更关键。这是对训练数据价值的证据,不能解释为任何跨细胞系迁移都会有效。
图中的平均基线对每个测试干预输出同一个训练扰动平均表达,所以它不提供特异机制;模型超过它才证明有基本的条件区分能力。线性模型更强,因而还需要回答新增非线性是否改善独立条件预测。论文用条件伪bulk评估表达均值,并未全面评价单细胞分布形状、多稳态或罕见亚群。一个方法在此均值任务失败值得重视,但若声称分布优势,应设计相应的独立评价,而不是用另一个目标回避当前结果。
| 子图 | 讲解 |
|---|---|
| a | 三个数据集留出单基因扰动的 L2 误差,深度模型未稳定优于平均或简单线性基线。 |
| b | 线性模型用基因 G 和扰动 P 嵌入构建预测,区分表示的价值与复杂解码器的价值。 |
| c | 相对 mean 基线的性能森林图及 bootstrap CI;线性模型结合扰动数据预训练较强,基础模型嵌入不保证复杂模型独有优势。 |
阅读说明
- 双扰动测试在训练中见过全部单扰动;单扰动任务留出扰动基因。两种设置不同,不能把结果当成同一种泛化。
依据:对应主图、完整图注及正文 Results;实验结果只按本文给出的对象和条件解释。
我的判断与可迁移设计
我的感悟是,创新点可以来自把比较条件做对。对AD公共组学项目,若想预测候选基因扰动,训练图谱中的相关性不能替代干预资料。应先确定测试究竟是新基因、新组合、新细胞类型还是新供者,再据此设计平均、无变化、加法和低秩线性模型。单细胞随机划分会让同一扰动同时出现在训练和测试,不能支持“未做实验预测”。
对于16GB显存,一个很实在的路线是先复现低秩线性基线,使用与病理任务有关的公开扰动数据得到基因或模块表征,再加一个规模可控的非线性残差模型。只有在留出条件、合理指标及外部资料上稳定改善,才有理由强调新模型。若没有改善,识别哪些数据缺少非加性信号、哪些干预不可预测本身也可以成为严谨结果;但需要清晰的限制,而不是用大模型名称包装泛化不足。
