27.Sturgeon:原图、模型逻辑与研究范式

27.Sturgeon:原图、模型逻辑与研究范式
Perry论文题名: Ultra-fast deep-learned CNS tumour classification during surgery
期刊与年份: Nature,2023。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Nature,2023;以当前 PDF 为准。
研究瓶颈怎样转化为问题
术中需要很快分型,甲基化芯片虽有参考标签却慢,实时纳米孔很快但位点稀疏。Sturgeon 把‘数据逐渐到达且绝大多数缺失’作为训练条件,利用已有全面甲基化样本模拟纳米孔过程。依据设计逻辑推断,idea 是从目标工作流反推训练数据增强和置信机制,改善临床可用时间,而非只提高完整数据的分类 AUC。
输入、训练目标与部署逻辑
2,801 个已标注参考样本生成大量不同稀疏/噪声条件,神经分类器在多折训练、验证、校准和测试中学习类别。预测随测序更新,未达 0.95 可以暂不分类。仿真是数据增强,不是新增独立病人;真实回顾性测序和 25 次手术检查模拟到现实的桥梁。18 次正确高置信与 7 次未达阈值要同时报告,不能把覆盖与已分类准确性混成一个完美比例。
Figure 1:以模拟稀疏测序训练分类器
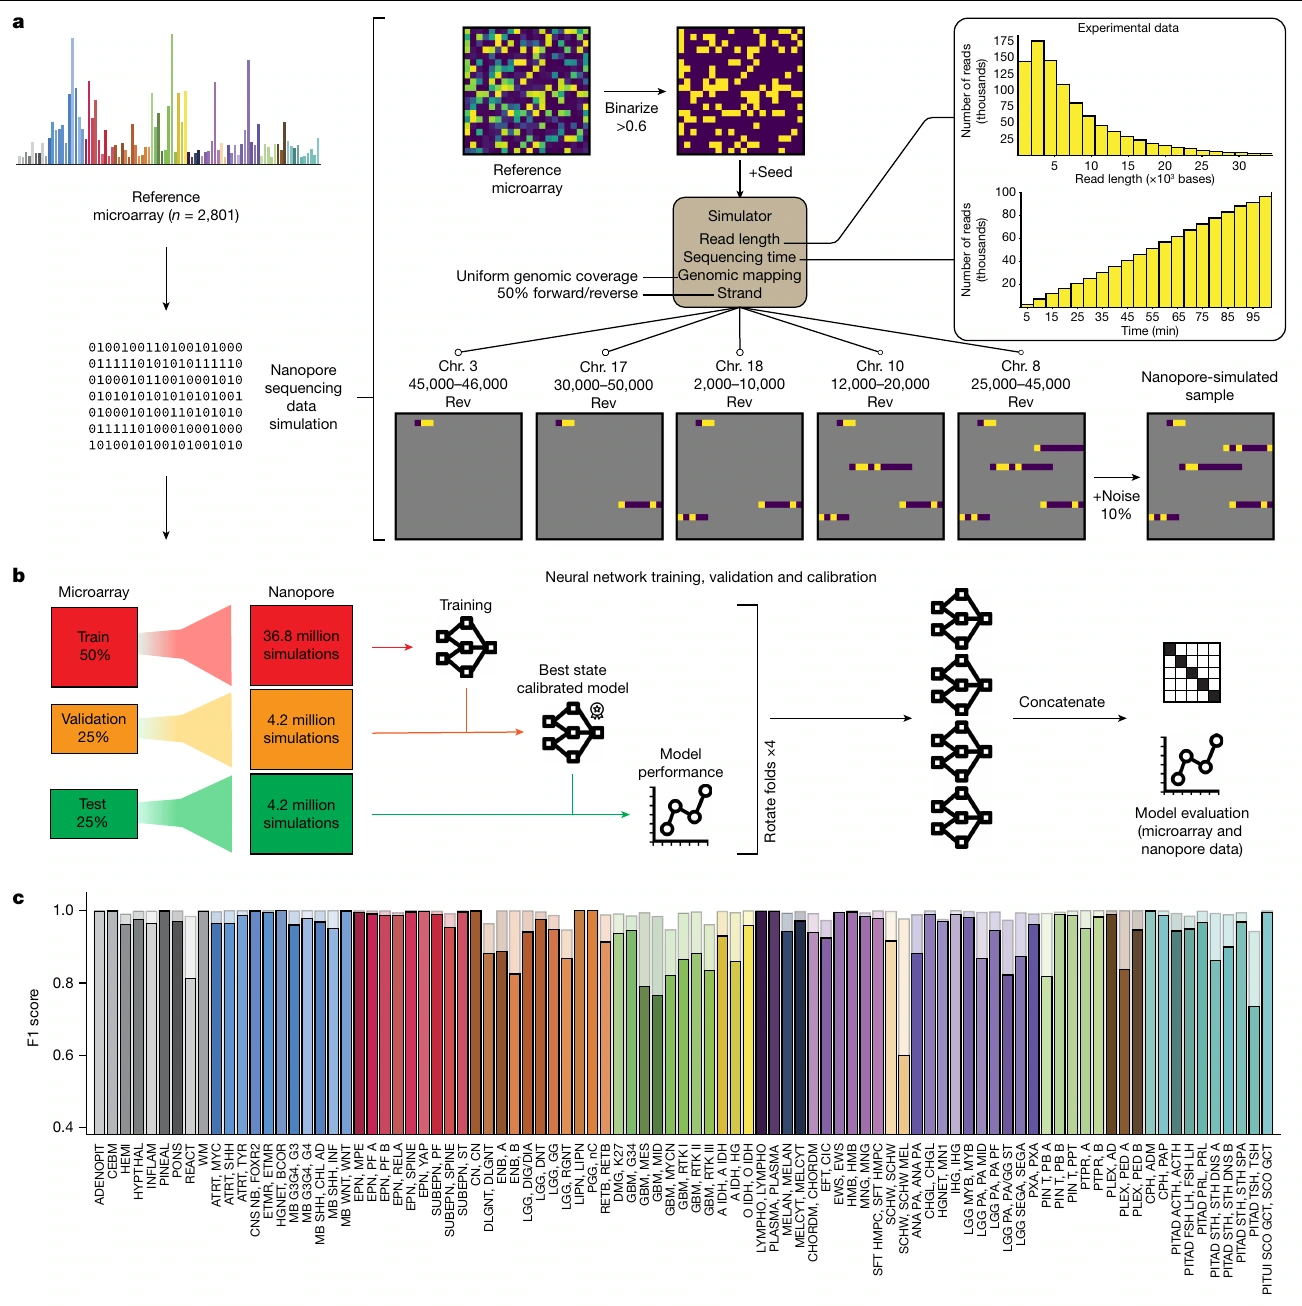
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 从 2,801 个已标注甲基化参考样本出发,按真实纳米孔读长、通量和缺失/噪声特征模拟大量测序数据;用较全面的芯片数据解决稀疏测序训练样本不足的问题。 |
| b | 四折轮换训练、验证、校准和测试,获得四个最终子模型;测试折不参加对应模型训练,用于评估泛化。 |
| c | 模拟测序 40 分钟、约 97% 芯片位点缺失时的逐类别 F1;实色为首选类别,透明色为前三候选。多数类别识别良好,生物学近似亚型仍可能混淆。 |
a 的读长、通量和缺失噪声模拟决定训练是否贴近真实设备;随机丢位点不能代表所有污染与批次。b 独立测试折和校准防止置信阈值看过测试答案。c 的 top-3 提高候选覆盖,但不是完成唯一诊断。约 97% 缺失仍能识别多数类,说明标签信息高度冗余,不能据此假定任意低质量样本都足够。
Figure 2:测序时长与肿瘤纯度怎样影响分类
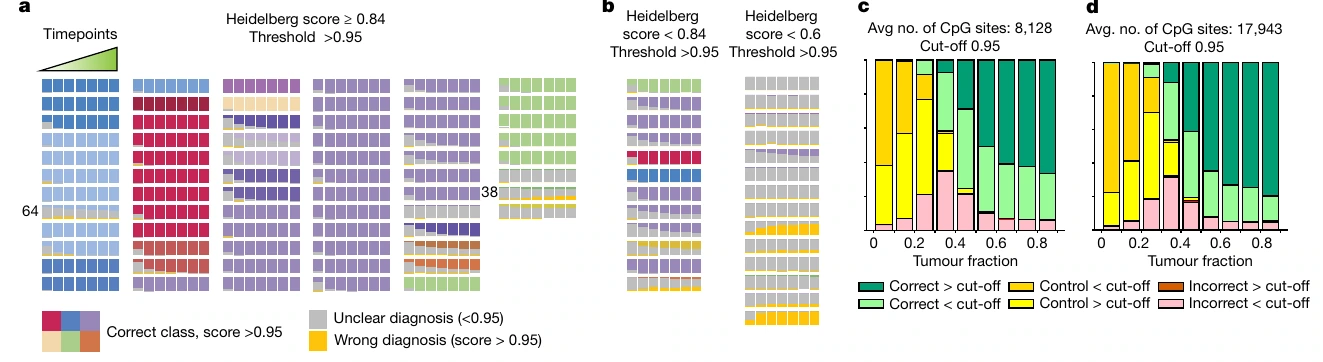
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 对 Heidelberg 明确分类的 68 个儿童病例,每个时间点重复 500 次模拟;随数据积累,达到 0.95 置信阈值的正确分类通常增加,灰色为不明确,黄色为高置信错判。 |
| b | 同样分析 Heidelberg 不明确的 26 例;考察这些困难样本能否由稀疏甲基化模型解决,部分仍需更久或无法明确。 |
| c | 约 20 分钟测序深度下加入正常组织读段降低肿瘤纯度;纯度下降会增加未达阈值或被判为对照的比例,说明污染限制早期诊断。 |
| d | 把模拟深度增到约 40 分钟再重复纯度分析;较多位点可改善分类,但不能完全补偿低肿瘤含量。 |
区分 Heidelberg 已明确与不明确样本避免只评容易病例,纯度模拟则检验正常组织污染。测序更久增加有效位点,却无法完全恢复被正常细胞淹没的肿瘤模式。高置信错判与暂不分类是不同风险,a/b 的颜色必须区分。重复 500 次模拟测试随机覆盖波动,不等于增加 500 个独立临床病例。
Figure 3:真实纳米孔样本的分类随时间演进
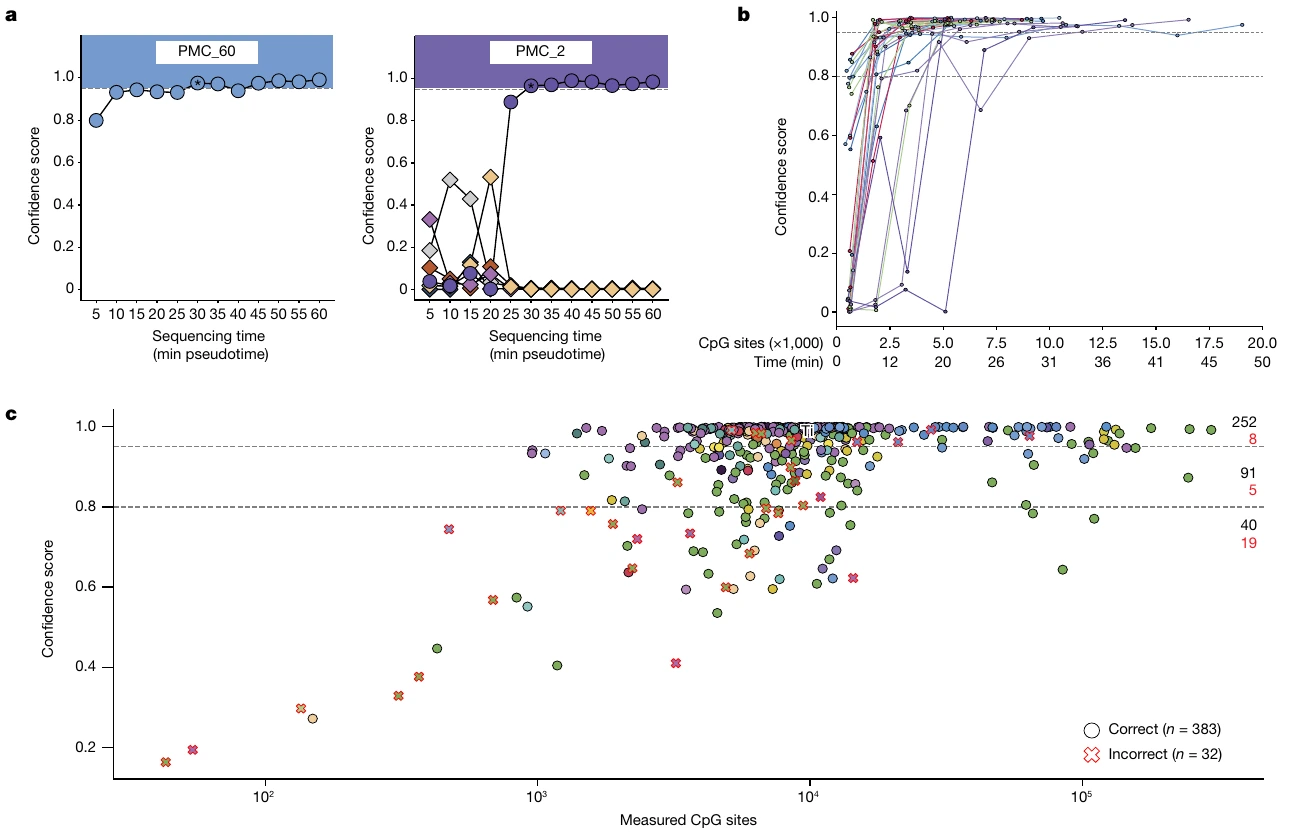
原图来源:所用 PDF 文件第 5 页,Figure 3。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 两个真实样本示例:圆点为正确类、菱形为错误类,星号标出正确类首次超过 0.95。展示真实数据积累如何使正确亚型分数逐步突出。 |
| b | 27 个儿童肿瘤的正确类别分数时间曲线;到达阈值的速度有个体差异,提示需保留暂缓给出结论的机制。 |
| c | 在公开的 415 次纳米孔测序中验证;圆点为首选类正确、叉为错误,用置信分数对照正确性,检验跨来源数据表现。 |
真实数据的时间曲线检验模拟过程能否外推;示例之外的 27 例和公开 415 次测序提供更广范围。第一次越过阈值是可操作的停止规则,但后续分数变化、近似类别和未知类别仍需关注。高置信不保证绝对正确,置信校准依赖真实测量背景;公共测序次数也不一定等于独立供体数。
Figure 4:一次术中实验的完整周转时间
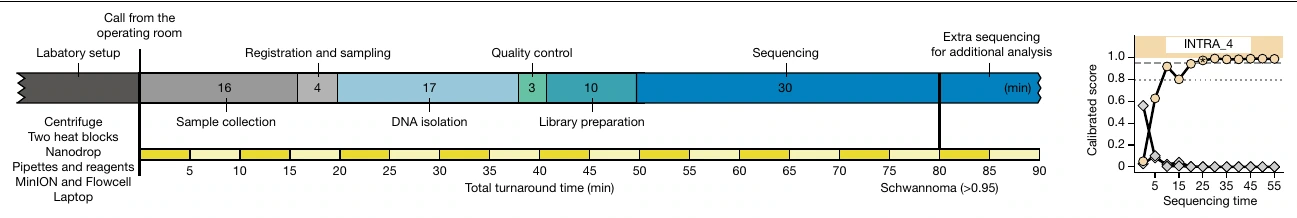
原图来源:所用 PDF 文件第 6 页,Figure 4。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| 左侧时间轴(无字母) | INTRA_4 的真实工作流:注册/取材、DNA 分离、质控、建库,再开始测序。图中给出约 80 分钟内得到高置信神经鞘瘤结果的实例;“测序用时”和“取材至结果的总用时”需要区分。 |
| 右侧分类曲线(无字母) | 同一病例的正确类分数随测序时间上升并超过 0.95,错误类分数保持较低;将时间轴上的实验流程与分类结果对应起来。 |
图的左侧将实验周转拆为取材、分离、质控、建库和测序,右侧才是模型等待数据的时间。约 80 分钟实例说明全流程可实现,不能把 40 分钟测序表现直接称作 40 分钟取材至诊断。实际系统价值来自满足手术时间和允许暂缓决定;病例分型成功不直接证明已减少神经损伤或二次手术,后者需要临床结局研究。
Figure 5:自适应采样能否更快获得有效位点
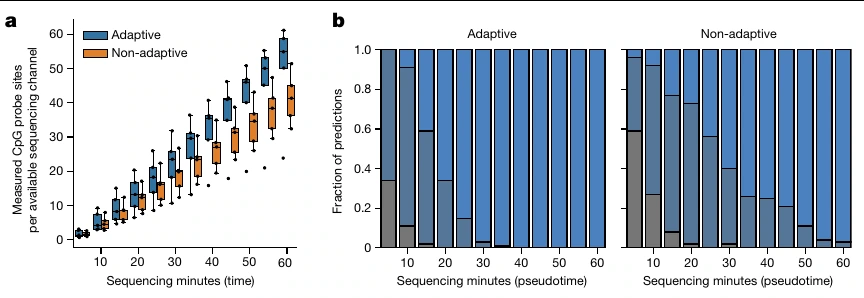
原图来源:所用 PDF 文件第 7 页,Figure 5。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 五个样本在同一测序设备中分别使用自适应与普通通道,比较按通道数归一化的有效芯片 CpG 位点产出;自适应采样提高相关位点获取效率。 |
| b | 对 PMC 68 的读段顺序重复重采样 100 次,比较两种通道的分类稳定性与达到高置信的时间;自适应通道通常更早形成正确高置信预测。 |
阅读提醒
- 模拟数据性能、回顾性纳米孔样本及实时术中应用是不同验证层次。术中 25 例中 18 例达到正确高置信分类,另外 7 例未达阈值;不能把未给结论写成全部错判。
同设备普通与自适应通道、按通道数归一化控制资源差异,检验富集相关 CpG 是否缩短达到阈值的时间。读段重采样反映顺序随机性,仍不是独立新样本。自适应策略可能依赖目标区域、读长和设备条件,不能将五样本的速度收益普遍化。该实验表明采样设计与模型可共同改进,而非模型结构 alone 解决所有稀疏问题。
我的理解与可迁移设计
我想迁移的是从真实使用约束定义研究:数据是什么时候可获得、缺失怎样产生、何时应该不给结论。AD 纯计算研究也应显式标记缺失效应/无覆盖,不能用模型补值后假装实验齐全。甲基化分类能识别状态,并不直接解释 DNA 序列变异如何产生该状态。16 GB 做小分类器足够,真正创新可能是适当的缺失仿真和独立测量验证,而非更大模型。
若借用不确定性机制,需报告预测覆盖、阈值和不同研究的校准,既不能只报告被接受子集,也不能将所有未分类记为普通错误。公共数据研究还应先核供体与测序重复,避免把一次样本的多个时间点或重采样当独立外部验证。
