67.GPN-MSA:原图、模型逻辑与研究范式

67.GPN-MSA:原图、模型逻辑与研究范式
Perry论文题名: A DNA language model based on multispecies alignment predicts the effects of genome-wide variants
期刊与年份: Nature Biotechnology,2025。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
本篇问题: 利用多物种序列比对预训练能否改善编码和非编码变异效应预测?
为什么跨物种比对值得直接进入模型
人类基因组里只有一小部分位置具有强约束,大片间隔区和重复序列会稀释从随机片段学习的信号。GPN-MSA 提出的改动是把演化资料显式放到输入端:预测一个被遮住的人类碱基时,不仅看它附近的 DNA,也看其他物种在同源位置的碱基。这样不必指望模型仅靠规模扩大,自己重新发现所有同源关系。这属于用生物学结构组织自监督学习的范式。
我的推测是,作者从未比对 DNA 语言模型在人类变异预测中不及保守性分数的事实出发,把‘已有比对是否比更大网络更有用’作为可检验的问题。论文明确借鉴蛋白 MSA Transformer,但这里不是训练后另加一个保守性分数:固定物种的每列 one-hot 编码拼接,Transformer 同时利用不同位置的列信息,训练目标是遮蔽位置的人类核苷酸加权交叉熵。固定物种顺序也让实现比任意序列集合的通用 MSA 模型更简单。
变异分数为 log P(ALT)/P(REF),越负表示替代等位基因在上下文下越不被模型支持。训练没有使用人类变异致病标签,因此可以进行零样本变异排序;但这不是疾病诊断概率,也不是经过校准的适应度下降。本文约 8600 万参数,训练使用四张 A100。它证明合理输入能降低计算成本,不能仅凭参数量承诺一张 16 GB GPU 完整复现原训练。
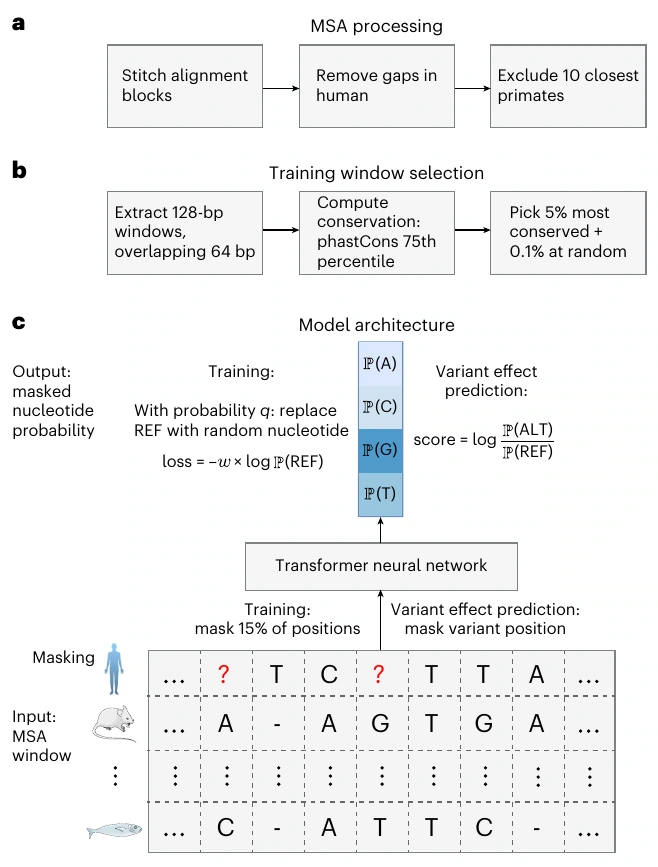
Figure 1:使用多物种比对的DNA语言模型
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
a 首先决定什么叫同源上下文:沿人参考基因组拼接比对,去掉人类缺口,并排除最近的十种灵长类。排除近亲不应只称为消除训练测试‘泄漏’;作者的核心理由是,太相似的同源行会让遮蔽预测变成照抄,低训练损失却产生无用的变异概率。保留远一些的物种,让模型必须整合约束与局部语境。这一对照提醒我们,自监督任务是否难得恰当,比损失下降得快更重要。
b 选择 128 bp 窗口中最保守的一部分,再加极少量随机背景,主动提高功能区域比例。它是有目的的数据分布设计,不是对整个人类基因组无偏取样。保守性同时进入损失权重,重复序列被降权十倍,非保守区的人参考碱基还会随机替换以缓和过强的参考偏好。于是所谓‘无标签’不等于‘没有生物学先验’:这里仍依赖多物种比对、重复注释与已有保守性计算。
c 显示训练时遮住多个位置,而变异评分时只遮住目标位置。模型看到附近人 DNA 和其他物种目标列,却看不到正在评分的参考碱基本身;输出四个碱基概率后比较两种等位基因。这个操作避免直接把人参考答案送回网络,但它仍可能偏向比对列的主要碱基。作者在方法中指出,同义变异也常得到明显负值,因此只能相对排序。两个变异的分数差不能解释为病情差多少,也不能把正分数理解成对健康有益。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 按人参考基因组拼接MSA、去掉人类缺口和最近10种灵长类,构造训练输入,避免近亲比对让遮蔽预测过于容易。 |
| b | 选择高保守窗口并补充少量其他区域,定义128bp训练窗口采样。 |
| c | Transformer依据MSA上下文预测遮住的人碱基;变异评分用替代/参考等位概率的对数比,解释模型的无监督效应指标。 |
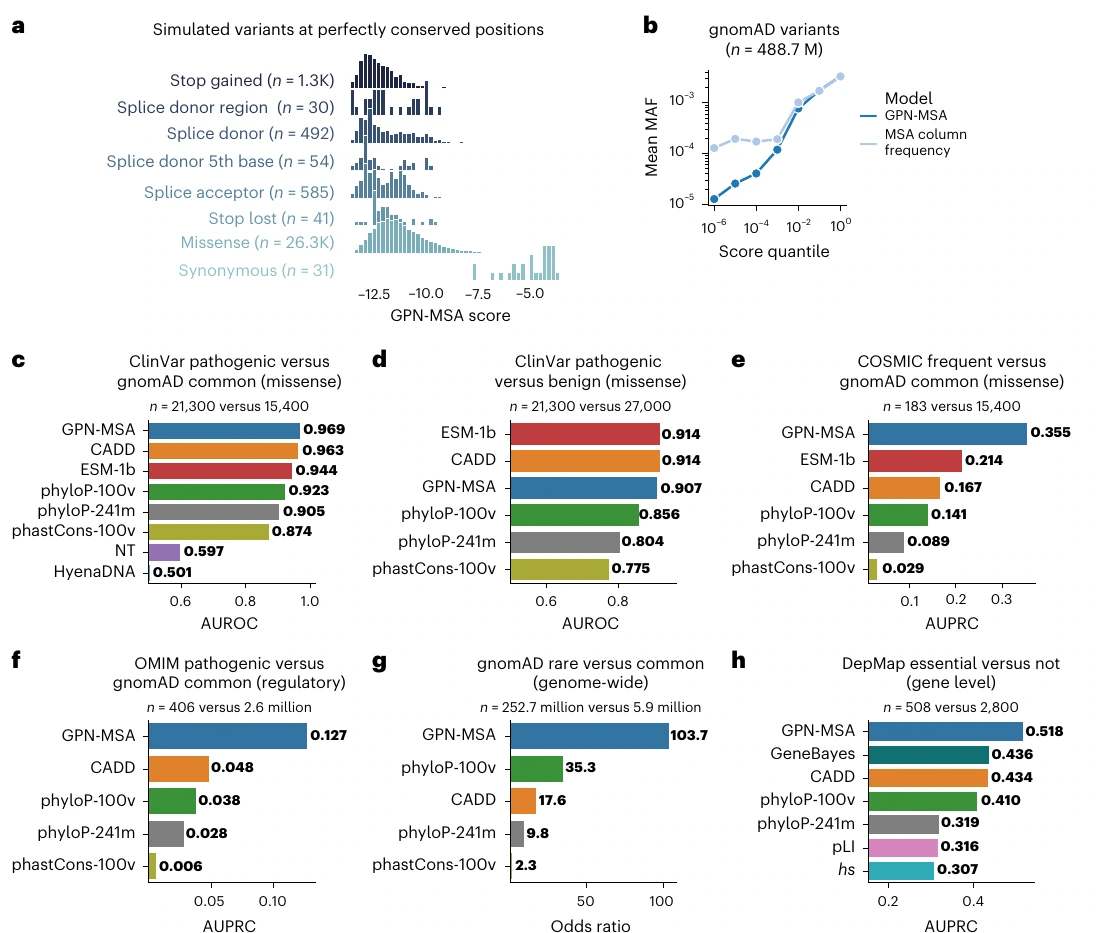
Figure 2:多类变异效应与基因功能基准
原图来源:所用 PDF 文件第 3 页,Figure 2。点击图片可查看原图。
a 是最有说服力的机制对照之一:限定其他物种完全一致的位置,传统单列保守性几乎无法再区分,模型仍对终止、剪接、错义与同义变异产生不同分布,支持它确实使用了邻近语境。它没有证明每一个高分位点的具体调控路径。b 接着用群体频率检验更负分数是否对应更少见的变异;这种趋势与净化选择相容,但频率还受突变率、人口历史和测量质量影响,不等于全部罕见变异有害。
c 和 d 必须并读:当良性参照从 gnomAD 常见变异换为 ClinVar 良性变异,所有模型的表现降低,GPN-MSA 也不再处处领先。两个数据库的收录机制不同,ClinVar 标签形成还可能使用保守性信息。因此高 AUROC 既反映真实约束信息,也可能受评估集合偏好影响。e 的癌症常见体细胞变异只是富含驱动的集合,其中仍可能有乘客;它不是把 COSMIC 中每个常见变异都确定为肿瘤原因。
f 扩展到少量 OMIM 非编码致病变异,并按上游、间隔等位置类别选择常见对照。这里正例非常稀少,AUPRC 比 ROC 更接近候选优先排序的现实。它支持非编码应用,但孟德尔疾病调控变异与 AD 的常见复杂风险变异并非同一分布。g 在每个模型允许相同数量常见变异进入尾部的条件下比较罕见富集,避免只是用不同阈值造成差异;图中的‘误发现’是这个对照定义,不能当成真实临床假阳性率。
h 从变异层走到基因层,聚合每个基因不同区域的分数分位来预测 DepMap 必需性。聚合分位在一组染色体上选择,结果报告另一组染色体,因而这一步含有下游标签指导的参数选择;不能将整张图都称为完全无监督评估。必需性定义来自大量癌细胞的 CRISPR 依赖,说明一般细胞生存约束可被序列统计捕获,尚不能推出该基因在脑细胞中决定 AD 进展。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 其他89物种完全保守位置的不同变异类型分数,检验模型是否还能区分同样保守位点的功能差别。 |
| b | gnomAD不同分数分位的平均次要等位频率,检验高有害评分是否对应群体低频变异。 |
| c | ClinVar致病对常见错义变异的分类,比较GPN-MSA及其他方法。 |
| d | ClinVar内部致病对良性错义变异的分类,降低不同数据库来源造成的偏差。 |
| e | COSMIC高频癌症错义对常见变异的分类,检验癌症相关变异识别。 |
| f | OMIM致病调控变异对匹配位置常见变异的分类,检验非编码区域应用。 |
| g | 有害分数尾部中罕见单例对常见变异的富集,控制误发现数量后比较选择约束信号。 |
| h | 用变异评分和选择约束指标区分DepMap必需与非必需基因,检验变异层级信息能否推到基因功能。 |
我的理解:演化约束与疾病机制可以互补
对‘从演化研究 AD’的思路,这篇论文给出的启发很具体:先问某个变异是否破坏长期保存的序列规则,再问在何种脑细胞中通过什么调控元件产生作用。第一问可以用 GPN-MSA,第二问需要 ATAC、表达、剪接或 MPRA 模型。它们的输出层不同,应作为相互补充的证据,不能用一个约束分数替代所有功能实验。
对转座子尤其需要反向检查训练偏好。较新的 TE、灵长类特异区域、快速演化或难比对的拷贝,恰好可能是这种保守窗口策略照顾不足的对象。低预测约束不能证明它们没有功能;高约束也不能证明它们是 AD 特异。比较 TE 与非 TE 时,应匹配比对覆盖、可比物种数、GC、距基因距离和变异频率,避免把数据可用性差异读成疾病生物学。
一个可迁移的小规模研究是:对已经具有脑细胞开放证据的 TE 拷贝,比较跨物种约束分数与局部功能效应是否一致,再将不一致者作为候选,检查人类特异调控和重复拷贝误比对。模型先冻结,候选标准先规定,独立 AD 队列或 MPRA 再验证。只有这样,‘约束与活性分离’才是可被反驳的问题,而不是给几张异常分数图附加演化故事。
还有一个容易忽略的评估边界:语言建模的泛化用留出的染色体检查,而变异效应基准使用全基因组。模型可能见过某个位置的参考序列,却没见过人类变异标签,这是零样本效应排序的设置,不等同于对完全未见基因组区域的能力。原文也明确保留了一个开放问题:区分罕见有害与罕见良性,是否仍能达到相同水平。真正面向罕见 AD 候选的验证应直接设置这一难题,同时检查区域类别和频率匹配。
