84.TissueEnhancerDesign:原图、模型逻辑与研究范式

84.TissueEnhancerDesign:原图、模型逻辑与研究范式
Perry论文题名: Targeted design of synthetic enhancers for selected tissues in the Drosophila embryo
期刊与年份: Nature,2024。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
本篇问题: 从开放度迁移到体内活性模型能否设计指定果蝇胚胎组织的增强子?
研究的真正瓶颈是功能标签,而不是DNA数量
我的推测是,这项工作从一个实际矛盾出发:果蝇胚胎已经有全基因组、细胞类型分辨的开放染色质图谱,可是真正经过体内报告实验验证的增强子,每个组织只有有限数量。直接用少量阳性训练复杂模型容易学不稳;只用ATAC又把“开放”误当成“能驱动表达”。作者把两个数据层次连起来,先训练序列到可及性,再把同一网络微调成序列到体内活性的模型。创新在标签与任务的安排,而非设计全新大型架构。
第一阶段是DeepSTARR式四层卷积网络,输入1,001 bp one-hot DNA,预测中央区域的pseudo-bulk ATAC定量信号,损失为均方误差。第二阶段保留初始化权重,将输出变为组织活跃或不活跃的二分类概率,所有层继续训练,以较小学习率和交叉熵优化。选择二分类不是因为增强子只有两种强度,而是现有体内原位杂交标签本来就不定量。把概率0.9解释成某个精确表达倍数,超出了训练目标。
CNS、表皮、肠、肌肉与脑特异任务分别训练。脑特异要求脑活跃且腹神经索不活跃,因而比“神经系统活跃”更难;这是有明确反目标的设计问题。各阶段使用一致的染色体区域交叉验证划分,测试区域没有先进入可及性预训练再被用于活性测试。这样的划分是迁移学习的重要质量条件。归因得到motif后再选择不同组合的候选,可以增加设计多样性,但它本身仍不是对每个motif的扰动验证。
从预测走到设计,作者生成大量随机501 bp序列,添加侧翼以符合模型输入,筛选同时具有目标组织可及性和活性得分的候选,再检查侧翼变化的稳定性和motif构成,人工选出每组织八条。它属于预测器驱动的随机序列筛选,不是用扩散模型直接生成增强子,也不是所有高分序列自动进入实验。理解这一点才能正确评价计算成本和成功率。
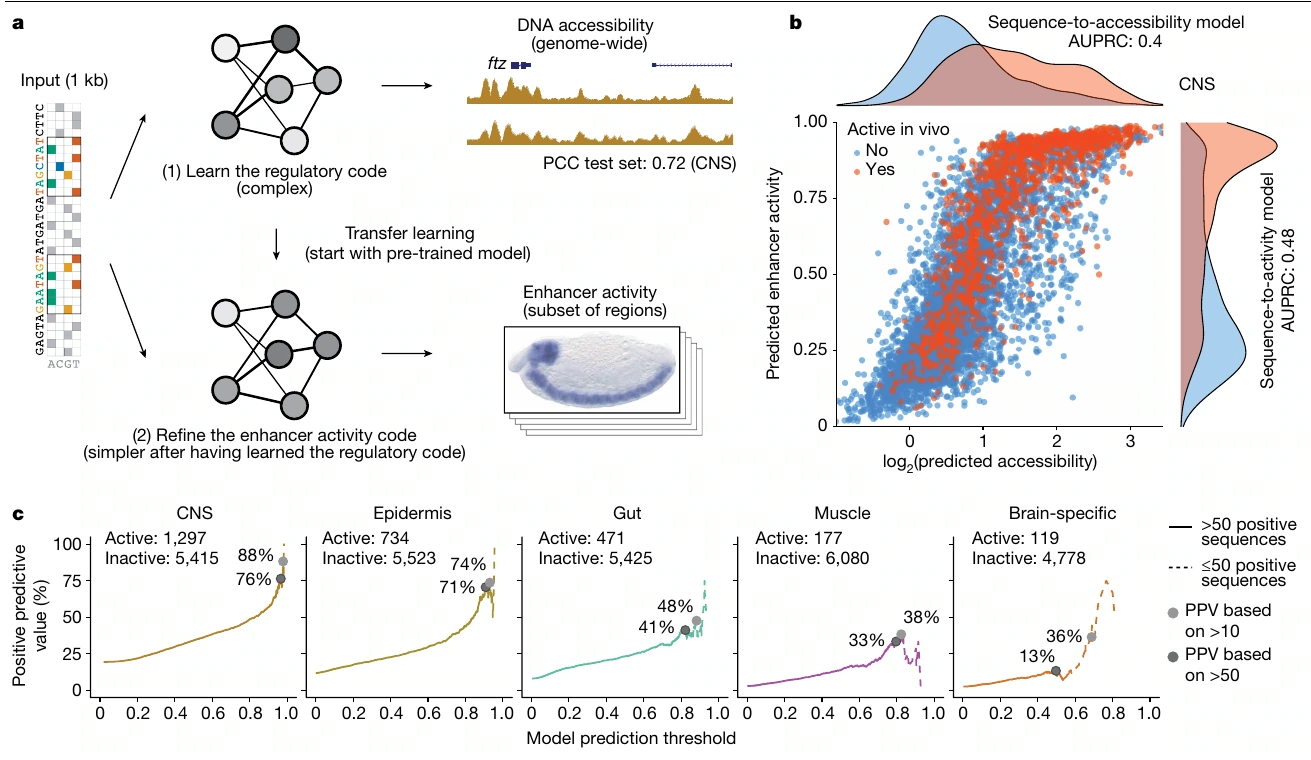
Figure 1:迁移学习设计果蝇胚胎组织特异增强子
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
a把大量可及性监督与少量功能监督放在一个流程里,并列出不同组织阳性样本数。真正的因果桥梁是第二阶段的体内活性标签;ATAC预训练提供可迁移表示,不能独自决定增强子功能。b把同一CNS序列的可及性预测与活性预测绘成散点:可及性较高但体内不活跃的区域说明两个任务并不等价。微调模型的AUPRC提高,有助于从候选空间中筛出更值得实验的序列;然而总体指标必须在相同正负集合比较,不能把全基因组预测相关系数与功能分类AUPRC互称“准确率”。
c问的是有限实验名额下的实际命中率,而不是单纯排名。提高阈值可能提高PPV,同时保留下来的候选减少,虚线段的估计更不稳定;某一组织中最高分样本的百分位很高,也不意味着不同组织的概率值已经同等校准。脑的有限阳性和高相似神经背景使任务困难。主文同时比较随机初始化、错误组织ATAC初始化与直接使用可及性模型,这些对照分别排查网络规模、泛化预训练和标签替代的解释。最有说服力的迁移主张应依赖这组对照,而非只展示一条相关曲线。
需要注意,阳性功能片段还要求与对应组织的可及性峰相交,评估以有原始实验的Vienna Tiles为基础。这提高了标签可信度,却限定了“活跃”的操作定义。模型性能并不自动覆盖所有闭合但可被激活的调控序列,也不自动等于在全基因组随机位置上的PPV。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 先用单细胞ATAC训练开放度模型,再用较少体内活性数据微调组织模型,说明两阶段策略。 |
| b | CNS实际活性对开放度预测和微调活性预测,比较仅开放度与组织功能标签的辨别能力。 |
| c | 不同阈值的阳性预测值,帮助估计高分设计序列的体内成功率,虚线表示样本数较少。 |
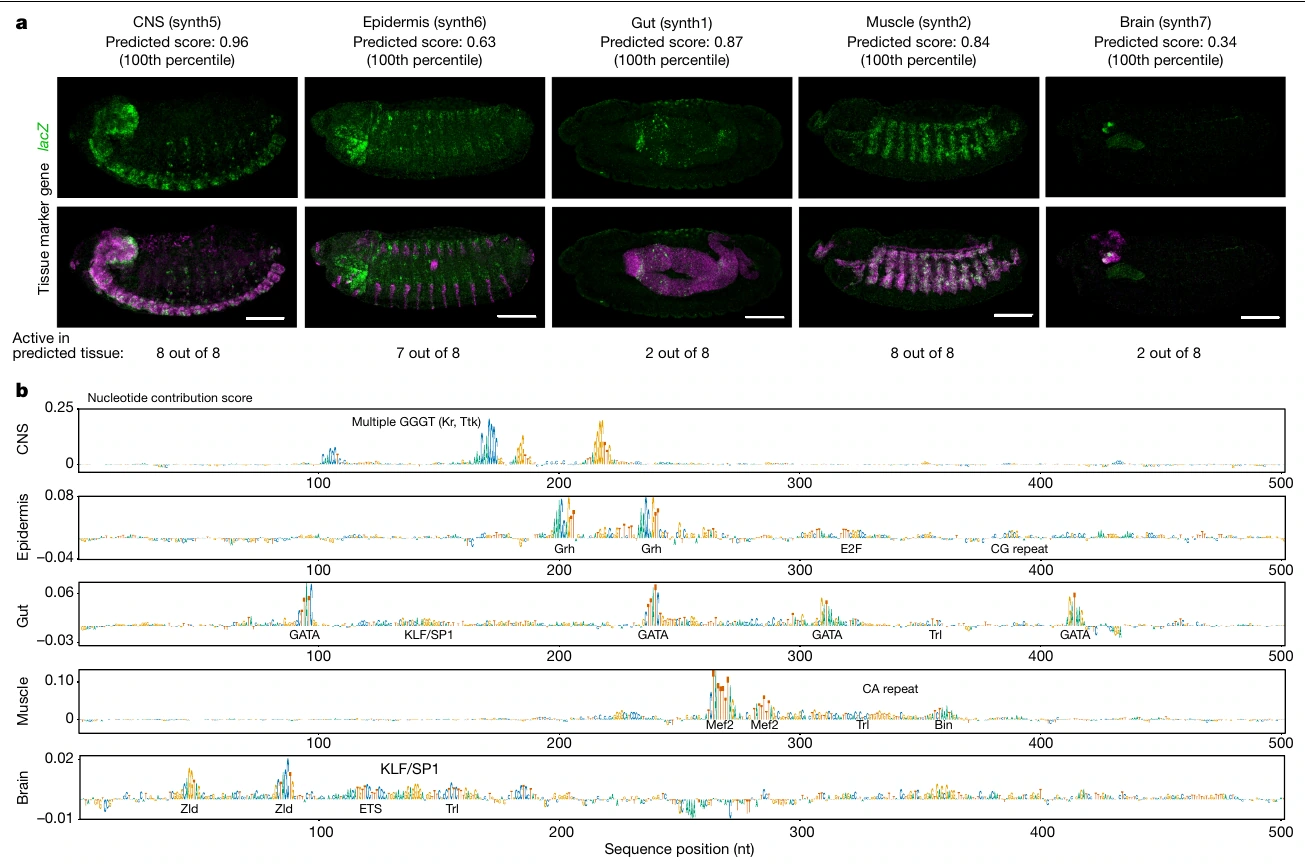
Figure 2:五个组织的合成增强子体内验证
原图来源:所用 PDF 文件第 3 页,Figure 2。点击图片可查看原图。
a将每条合成增强子接到相同hsp70最小启动子与lacZ报告基因,并放入同一基因组整合位置。固定位置和启动子控制了许多外部条件,因而观察到的表达差异主要可以归于候选序列。粉色内源组织标志与绿色lacZ的空间重合检验目标组织定位;单看lacZ有信号只能证明活性,不能证明特异性。图中展示每组织一个代表,成功数量来自完整测试集合,应避免用漂亮代表替代全部结果。
八条CNS和八条肌肉设计均在目标组织活跃,表皮七条,肠和脑各两条。这种差异比总体68%目标组织成功率更能说明方法局限。CNS的部分候选还有弱的外周神经活动;肠与脑的候选可能同时在其他组织表达。“在目标组织活跃”因此并不总等于“只在目标组织活跃”。作者的像素相关分析有助于量化空间重合,但相关较高仍可能包含额外表达。胚胎图的每个像素也不是独立生物学重复。
b把归因映射回已知组织motif,解释模型如何提出设计。肌肉的Mef2、Bin等组合相对易区分,肠的GATA因子同时服务多个组织,单靠GATA富集可能满足活性却不满足排他性。我的理解是,失败候选在这里提供了机制线索:当同一调控语言被多个细胞环境使用,设计目标必须加入显式反目标,而不是一味提高目标模型分数。图中的motif颜色是模型归因,并没有证明逐一破坏这些位点就会按预测改变体内表达。下一步最直接的验证是保持其余序列不变,只改候选的关键或反目标motif。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | CNS、表皮、肠、肌肉、脑的lacZ及组织标记双FISH,验证设计表达与指定组织重合,并给出成功序列数量。 |
| b | 各组织代表合成增强子的逐碱基贡献及已知TF模体,解释特异表达所依赖的代码。 |
可以迁移到AD,但需要把候选用途说清楚
这篇对有限显存项目很有启发:先做较小卷积网络,选择与最终任务相近的公共大数据预训练,再以少量可信功能数据修正目标,比从头训练通用基因组模型更现实。若研究AD中TE重叠调控元件,可以用相关脑细胞ATAC学习序列表示,随后利用独立、细胞背景明确的MPRA校准调控功能。若没有MPRA,就应把产出限定为可及性候选,不宜把模型改名成“致病增强子设计器”。
一个具体可做的研究是:同一TE家族成员中,哪些motif组合只提高小胶质细胞或某神经元亚型的预测活性,哪些会同时激活其他脑细胞?固定TE家族、长度、GC与基因组背景,用匹配的非TE序列和motif扰动作对照;在未见染色体或独立队列上评估目标与反目标差值。这样可以检验TE是否提供可利用的调控语法,而非因为它在基因组中多、容易与峰相交就推断特殊作用。
我也会保留本篇对“有限标签”的诚实处理:预训练不能制造实验真值,合成序列在固定报告位置成功也不直接证明可改写内源AD风险。若最后仅能纯计算,最强结果可能是发现可解释、可独立复现的候选规则,并提出数量有限、具体可实验的设计,而不是宣布治疗方案。论文证明的是条件受控的组织表达设计;迁移到疾病研究,还需要人类细胞背景、内源调控和疾病效应三条额外证据。
