46.ArrhythmiaDNN:原图、模型逻辑与研究范式

46.ArrhythmiaDNN:原图、模型逻辑与研究范式
Perry论文题名: Cardiologist-level arrhythmia detection and classification in ambulatory electrocardiograms using a deep neural network
期刊与年份: Nature Medicine,2019。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: 单导联动态心电图神经网络的多类心律失常识别是否达到心脏科医生水平?
为什么重新考虑原始心电信号
传统自动心电分析常分为去噪、提取手工特征、选择特征与分类,每一步规则都可能限制最终信息。本文以大规模标注数据测试端到端方案:原始单导联信号能否同时识别多种节律,而不是只做房颤或少数心拍类别。我的推测是,idea来自数据规模与端到端算法共同成熟,使此前因样本不足而无法全面评估的任务变得可做。这是依据引言的研究逻辑,不是作者个人构思经历。
卷积网络、节律监督和评估单位
模型每约一点三秒输出类别,三十秒记录中可以同时包含多个节律,因此存在“哪个时间段是什么”与“整份记录有哪些”两个目标。后者适合报告存在性,前者适合确定起止及负荷。计算平均时还要考虑类别比例,常见窦性节律容易主导总体数字;少见危险节律的重要性不应被频率加权自动降低。论文把两种粒度分开,让读者知道不同指标实际评价什么。
与医生比较还具有标签来源差异。训练多来自技术人员标注,核心测试采用专家委员会,另一些敏感性分析仍由技术人员标注;相同架构在不同标签质量下保持表现是有用信息,却不是所有数据都有同样真值强度。共识委员会和独立医生角色不同,前者建立参照,后者作为被比较对象。把同一个医生同时当标准和竞争对象会改变含义,本文的设计帮助减少这个混淆。实际使用仍需考虑没有完整临床背景时的诊断限度。
输入是200Hz采样的单导联ECG,34层残差卷积网络每256个采样点输出十二类概率,包含十类心律失常、窦性节律和噪声。卷积学习局部波形并逐步扩大时间感受野,残差连接使较深网络更容易优化;它不是将心电图图片交给视觉模型,也不直接使用其他病人临床属性。论文还尝试循环层但没有观察到提升,说明结构选择需要实测而非因“有时间”便必然采用RNN。
训练来自53549名患者的91232份记录,测试为328名不同患者的三十秒记录,由心脏科共识委员会标注。每份记录产生23个片段预测,形成7544个序列级评价单元;这些单元嵌套于同一患者,不能增加成7544名独立人。序列级关注节律何时发生及持续多久,记录级只问某类节律是否出现,所以两种指标的临床含义不同。
这是一项监督诊断分类研究,共识标签是操作性标准,不意味着每个节律都存在绝无争议的真值。测试标注者一致性并非百分之百,人工和模型都可能混淆近似节律。因此标题中的心脏科医生水平限定于这份任务、输入与共识比较,不能扩展为所有心脏疾病诊断或真实诊疗取代医生。
噪声单独作为类别也有意义:无法判读的输入不应被迫产生某个病理答案。模型是否可靠应包括低质量信号、边界案例和少见类别,而不仅是平均AUC。单导联设备的输入范围限制它能回答的问题,多导联、不同设备和长期监测流程仍需额外验证。
论文在公开PhysioNet2017数据上保持架构再训练,展示该架构可以适应另一数据与标签集合。它不是将原训练权重原封不动外部测试,因此应称架构复用或重训验证,而非未经适配的模型跨设备泛化。保持这个区分,才不会把方法通用性夸大成单模型通用性。
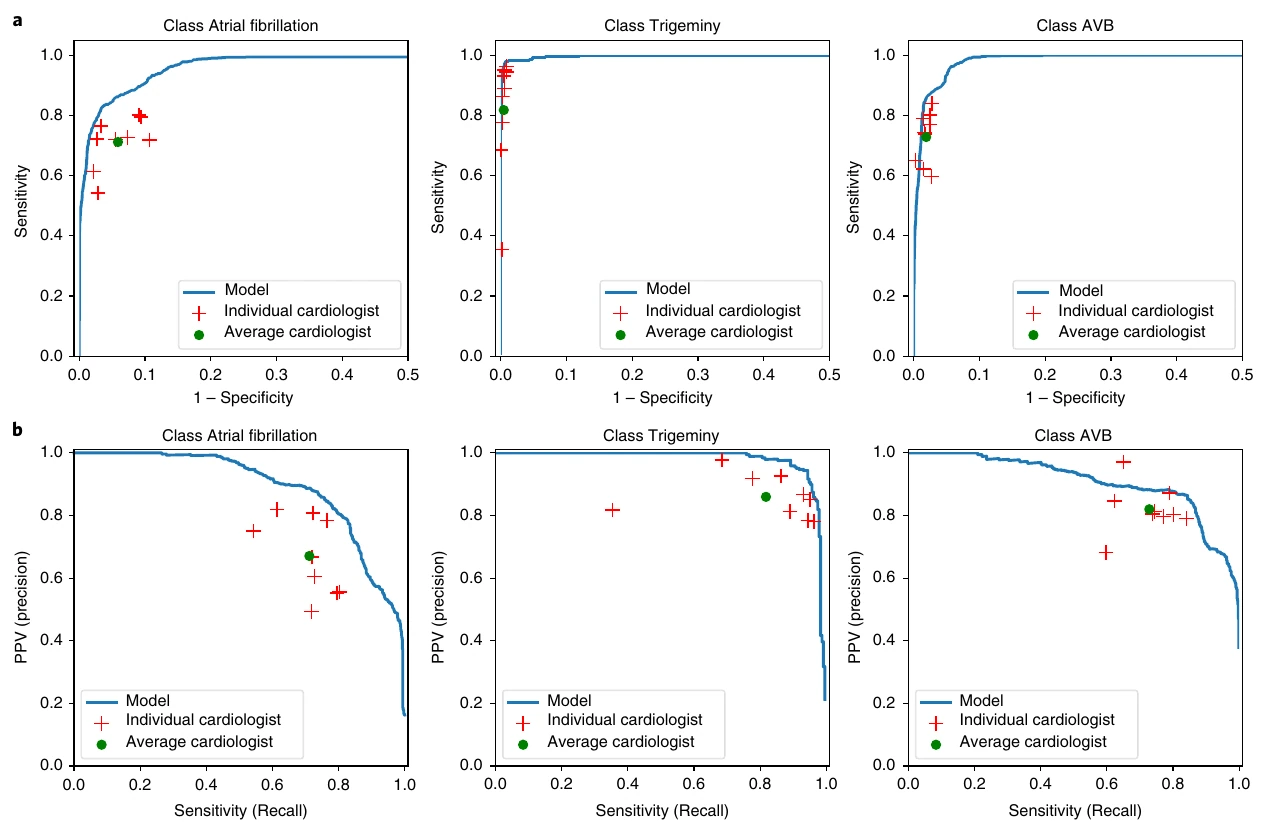
Figure 1|网络与医生的 ROC/PR 对照
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
图1把网络阈值曲线与医生操作点放在同一坐标,是对人机性能较公平的比较方式。医生通常给出具体类别,模型可以移动阈值,所以应看相同误报率或相同precision下敏感度,而不能只比较整条曲线和一个点谁更“漂亮”。ROC展示所有阈值的区分,PR更接近阳性较少时警报有多少真正符合共识。三类示例展示不同节律,但不是全部十二类;总体结论还需结合正文和完整指标。模型可以达到较强敏感度,仍可能在某个操作点制造不同临床代价。
尤其不能把片段级高性能直接转换成日级监测效果。真实佩戴很多天时,大量正常片段会累积误报,节律起止和同一事件重复提醒也需要处理。图中的三十秒测试与医生比较证明核心识别能力,尚未完整检验这个长期工作流程。
| 子图 | 讲解 |
|---|---|
| a | 分别以房颤、三联律、房室传导阻滞的序列级 ROC 为例,曲线表示网络所有阈值,红叉为个体医生、绿点为医生平均。观察网络在相同误报率下的敏感度。 |
| b | 相同三类的 precision–recall 曲线评价阳性较少情况下的识别;医生点与曲线对照显示模型达到或超过多数医生的表现。 |
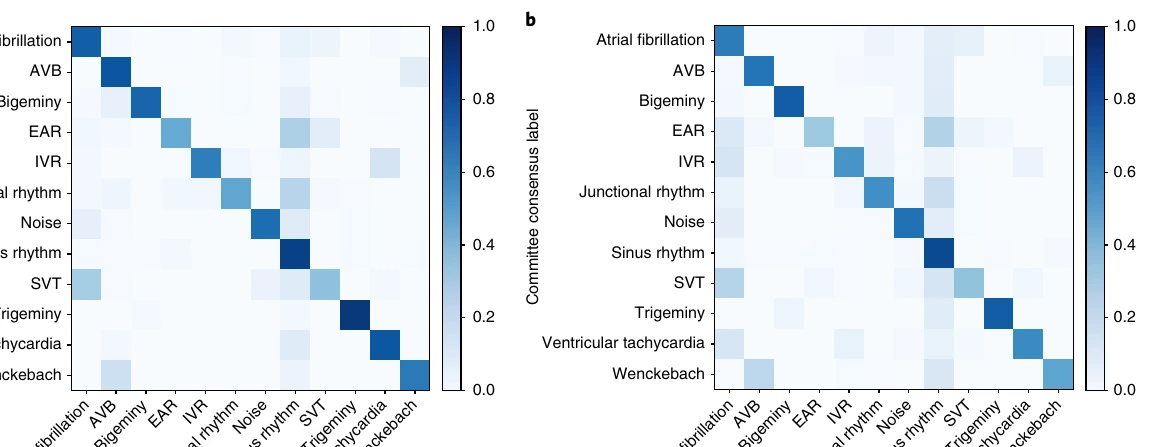
Figure 2|十二类预测的混淆模式
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
图2将错误结构放到平均指标之后,是全文重要的临床解释。网络与医生都容易混淆某些相似节律,说明困难来自输入信息与类别界限,而不是模型所有错误都随机。混淆矩阵帮助定位哪些类别需要专家复核,例如室上性节律与房颤、交界性与窦性节律;不同错误可能导致不同处置,不能仅按数量相加。频率加权平均会受到常见类别主导,稀少但危险的节律应单独查看。
与同一共识比较有助统一标准,但共识本身也受单导联信息限制。若未来增加临床背景或多导联,标签和人工表现都可能改变。因此该图检验的是限定识别任务,不能由对角线高便推出无需医生或无需其他检查。
| 子图 | 讲解 |
|---|---|
| a | 网络预测与心脏科委员会共识的混淆矩阵;对角线是正确识别,非对角线指出哪些节律相互混淆。 |
| b | 单个医生预测与同一共识的对应矩阵,可直接比较模型与人类的正确率及错误结构,而不只比较总体 AUC。 |
阅读说明
- 图 1 的 7,544 个序列级预测来自 328 份 30 秒心电图,每份分为 23 个预测片段;不应当作 7,544 名独立患者。
依据:对应主图、完整图注及正文 Results;实验结果只按本文给出的对象和条件解释。
我从端到端模型得到的判断
本文最值得学习的是数据单位与任务边界清楚:原始信号、局部输出、患者级留出和明确共识标准共同支撑结论。复杂网络的价值可以来自省去大量手工规则,但仍要有误差定位与专业对照。模型发现了可用于识别的模式,并不因此揭示全部心律失常病因。
对DNA序列研究,局部卷积也能学习motif及较大组合,有限长度序列任务可以在16GB显存完成。真正需要迁移的不是网络层数,而是独立序列或donor划分、低质量输入识别、类别不平衡处理和误差结构分析。若多个开放峰来自同一人,不能照着片段数量把统计样本放大。
我会先比较简单规则、短卷积与更深残差模型,确定提高容量是否改善难类别和外部数据,而非只改善训练集。对于TE序列,家族与重复区域可能形成近似副本,需要避免跨集合泄漏;网络学到家族身份也不等于学到疾病效应。局部分类结果要接到独立功能或病理证据,才能形成更强科学链。
最后,人工比较应把医生的信息条件和操作点写清。有限三十秒信号上的分类与医生真实综合诊疗不是同一场景。高性能研究可以为优先级排序和专家复核提供依据,但患者结局、工作量与长程误报仍需要另行研究。这样的限定使文章的贡献更具体,也让下一步改进有清楚方向。
