25.DeepDEP:原图、模型逻辑与研究范式

25.DeepDEP:原图、模型逻辑与研究范式
Perry论文题名: Predicting and characterizing a cancer dependency map of tumors with deep learning
期刊与年份: Science Advances,2021。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Science Advances,2021;以当前 PDF 为准。
研究瓶颈怎样转化为问题
CRISPR 依赖标签来自细胞系,患者肿瘤无法逐个做同样筛选。DeepDEP 先以大量未带筛选标签的 TCGA 多组学学习表示,再用较少细胞系监督依赖,询问能否缓解两者的数据差距。依据设计逻辑推断,idea 是让患者域参与表征学习,但患者输入参与预训练不等于患者依赖已经被真实验证。
输入、目标与结构
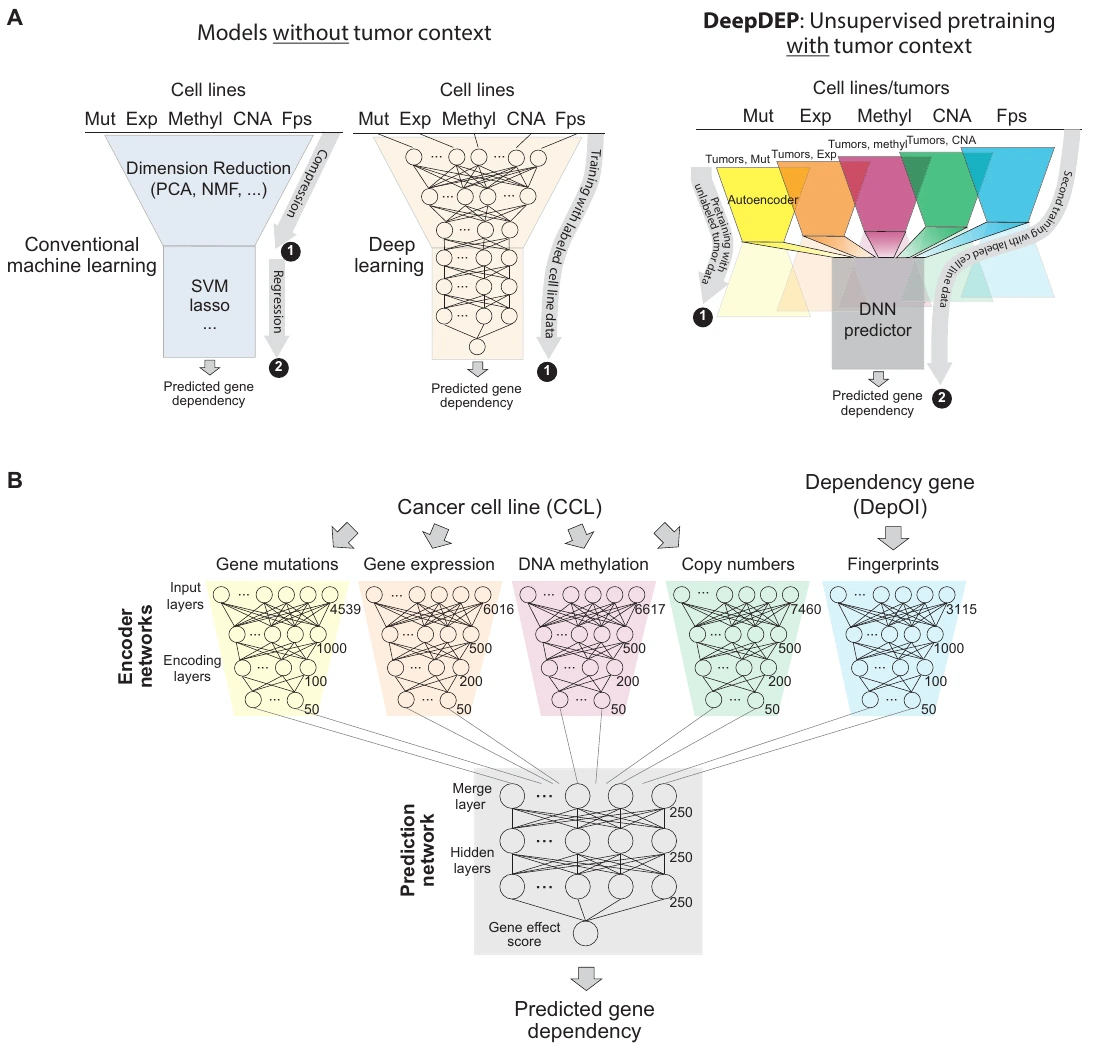
突变、表达、甲基化和拷贝数自编码器分别预训练,再结合待预测基因的功能指纹输出敲除依赖分数。指纹让不同目标基因共享功能信息,多组学描述样本背景。分数更负表示敲除更抑制生长;模型虚拟切换突变和组学再读输出,是计算敏感性,不是正式编辑。细胞系实验平台、RNAi、PDX和临床关联提供不同外部证据。
Figure 1:预训练与多组学依赖预测架构
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | 对比常规机器学习、仅使用细胞系标签的深度学习和 DeepDEP。DeepDEP 先从无标签患者肿瘤学习表示,再用细胞系基因依赖数据训练,以利用更多真实肿瘤信息。 |
| B | 突变、表达、甲基化、拷贝数等编码器与待预测基因的功能指纹共同进入网络,输出该样本敲除该基因的效应分数。各组学编码器先在 TCGA 自编码器中预训练。 |
自编码器学习患者组学分布,依赖头学习细胞系真实筛选,二者标签不同。功能指纹提供目标基因先验,需固定版本与测试知识来源。预训练的目的不是把肿瘤和细胞系强制等同,而是减少小标签学习困难;微环境和纯度差异仍可能影响应用。
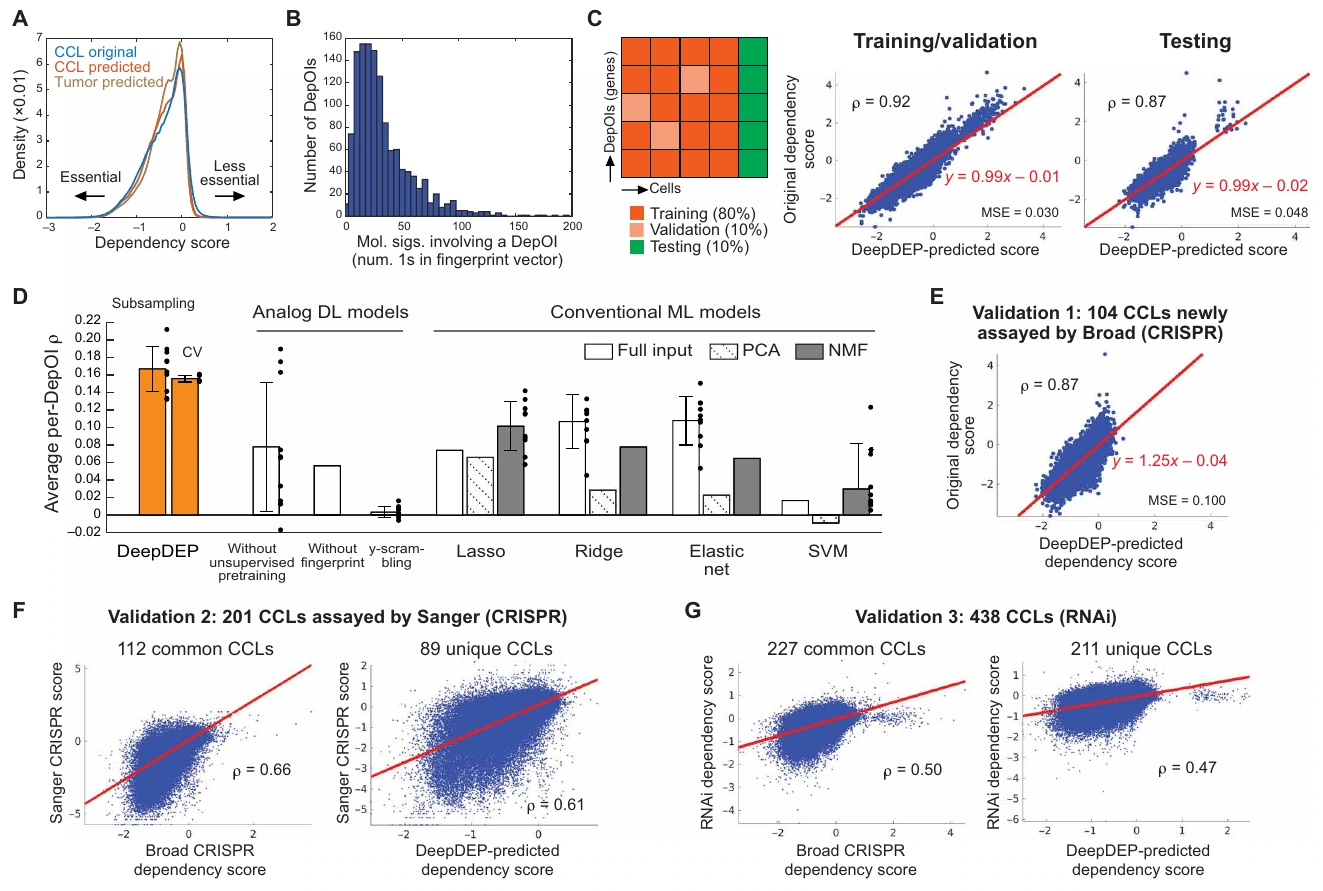
Figure 2:模型预测表现及独立验证
原图来源:所用 PDF 文件第 3 页,Figure 2。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | 比较细胞系真实分数、细胞系预测分数和肿瘤预测分数的分布;分布大体相容是把模型应用到肿瘤的一项检查,不等于肿瘤中已有真实敲除验证。 |
| B | 展示 1,298 个待预测基因的功能指纹中非零元素数量;功能指纹编码其属于哪些分子签名,使不同基因可共享功能信息。 |
| C | 真实与预测依赖分数的总体相关达到 0.87。它汇总全部基因–样本配对,不能理解成每个基因跨样本都达到相同准确度。 |
| D | 用逐基因跨细胞系相关性比较预训练、无预训练、无指纹、打乱标签及其他机器学习模型;完整 DeepDEP 总体更好,说明预训练和基因功能指纹都有贡献,平均逐基因相关约 0.18。 |
| E | 在 Broad 新测细胞系及更新处理流程上核对预测;总体相关保持,测试训练数据之外的泛化。 |
| F | 在不同 CRISPR 文库与算法的 Sanger 依赖数据上验证,分别检查共有与独有细胞系,展示跨实验平台的一致性及其下降。 |
| G | 使用 RNAi 敲低筛选作进一步独立验证;它与 CRISPR 的干预机制不同,预测仍有一定相关,但弱于原平台。 |
总体 0.87 与逐基因均值约 0.18 差异非常关键:跨基因普遍必需性容易预测,真正个体化依赖较难。去预训练、去指纹、打乱标签和外平台比较定位信息增益;RNAi 机制不同,性能下降不能简单混作同等验证。分布相似只是输入适用检查,不能代替患者敲除终点。
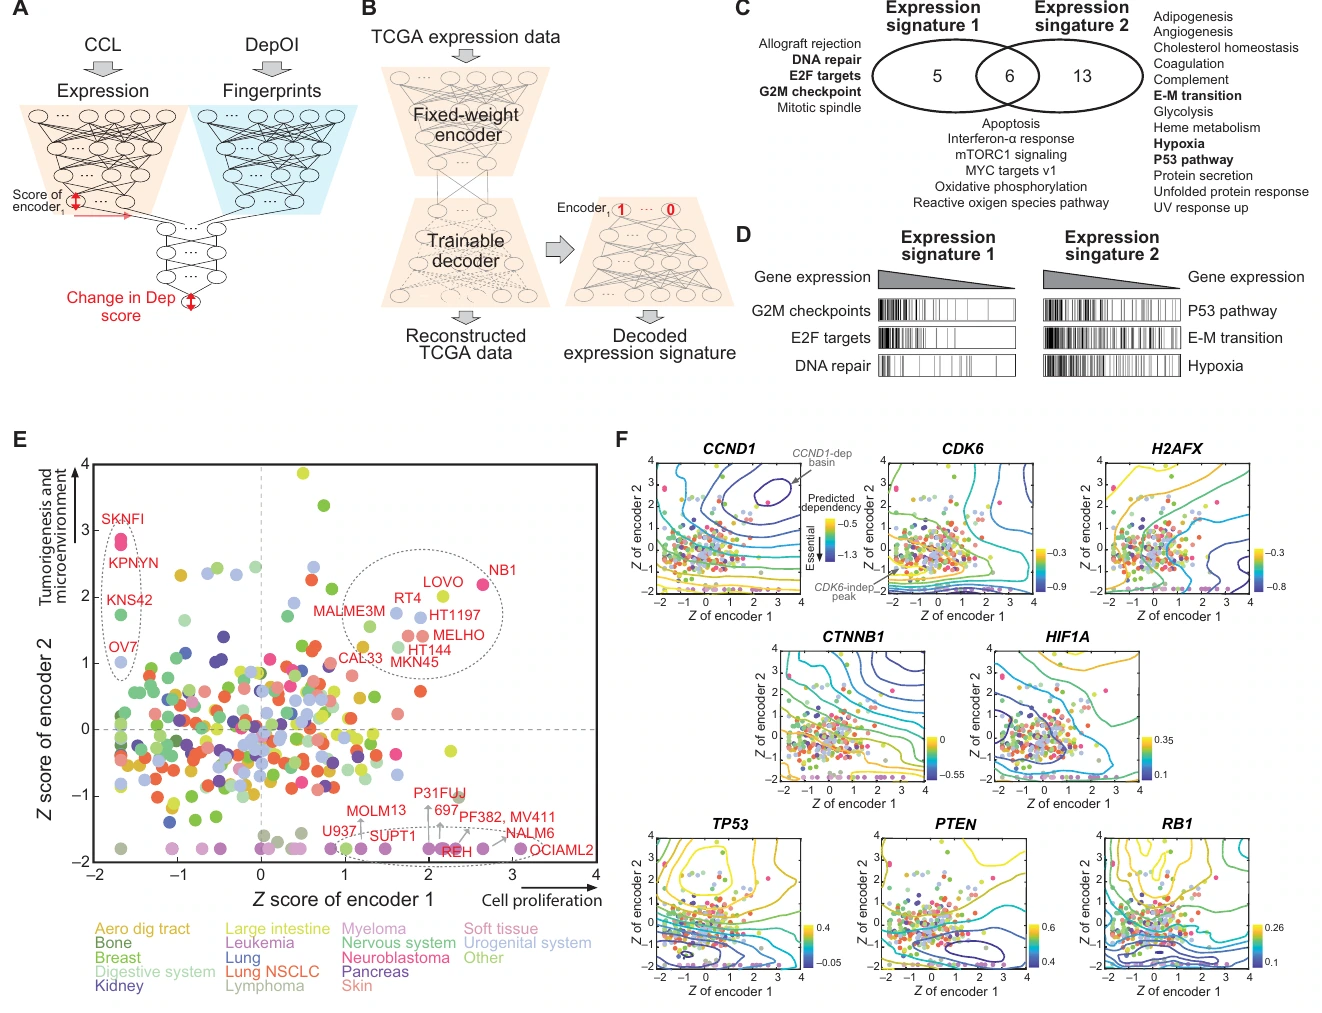
Figure 3:表达隐变量如何对应基因依赖
原图来源:所用 PDF 文件第 5 页,Figure 3。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | 仅表达输入的 Exp-DeepDEP 架构;作者挑选编码层节点,研究模型如何从表达状态推断依赖。 |
| B | 重新训练解码器,并单独激活一个隐节点来重建表达签名,把隐变量转成可做生物学富集分析的基因集合。 |
| C | 两个节点解码签名的 Hallmark 富集列表,说明不同隐节点汇总不同生物过程。 |
| D | 展示 C 中选定基因集的富集曲线,核对签名是否集中对应相关过程,而非仅依赖一个命名标签。 |
| E | 以两个节点的标准化分数定位细胞系;虚线圈出偏高于单个节点或同时高于两者的样本,定义后续功能地图的表达背景。 |
| F | 在同一二维背景上画不同基因的依赖等高线。深蓝表示敲除更强地抑制生长,黄色表示较弱;各基因的“必要性”随表达背景而改变。 |
单隐节点重建签名将抽象变量转为可富集的表达程序,等高线再解释背景依赖。但节点不是唯一可识别通路,富集由模型重建结果定义;高节点分数不等于实际激活程度。图适合形成可检验依赖假说,不能凭二维关系证明每个表达过程直接控制敲除效应。
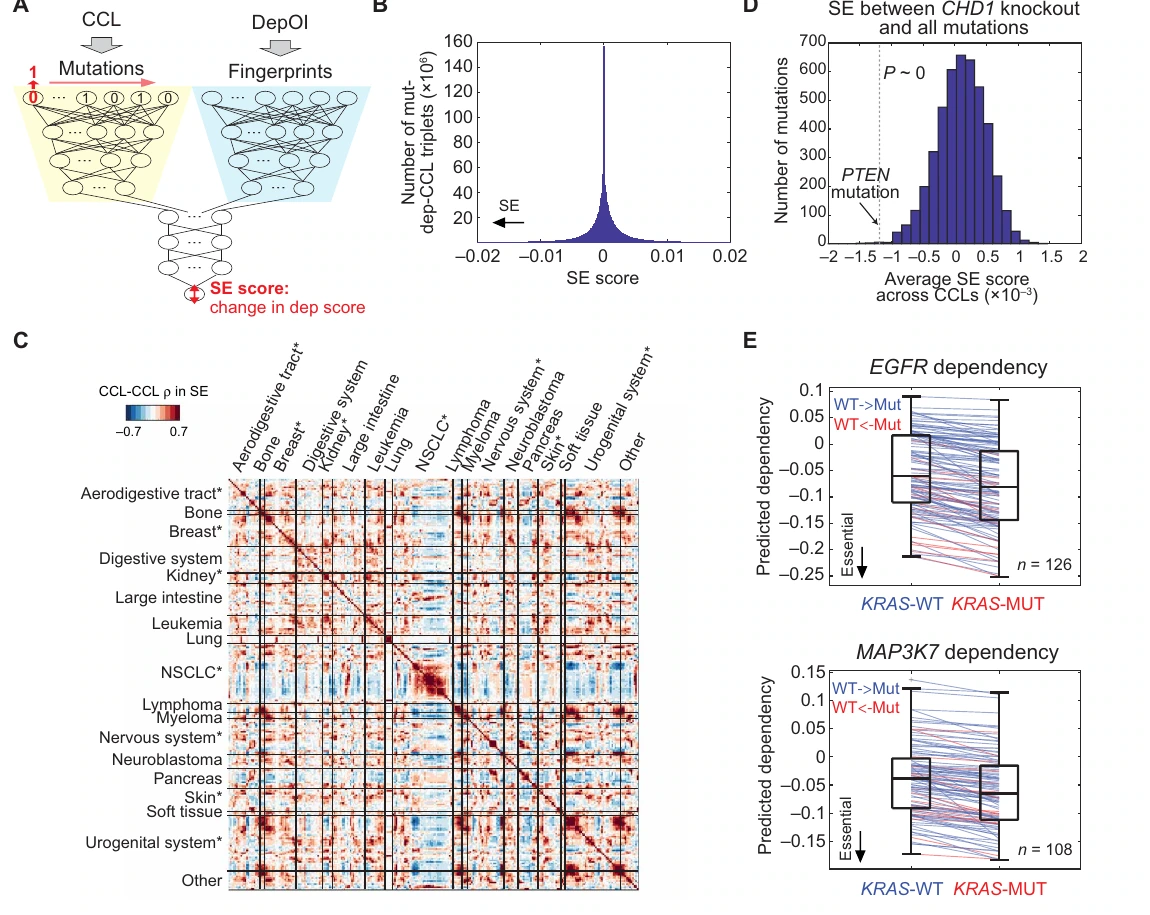
Figure 4:虚拟改变突变,预测合成必需关系
原图来源:所用 PDF 文件第 7 页,Figure 4。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | Mut-DeepDEP 每次把一个基因突变状态在 0/1 间切换,并计算另一基因敲除预测分数的改变;这是计算干预,不是真实编辑实验。 |
| B | 全部突变–依赖基因–细胞系组合的 SE 分数分布;负值表示加入该突变后另一基因更重要,大多数预测效应较小。 |
| C | 热图比较细胞系的 SE 预测相似性;一些谱系内部相关较高,但很多关系仍与具体基因组背景有关。 |
| D | 把 PTEN 突变与 CHD1 敲除这一已知组合放在其他突变的预测分布中;其效应更偏负,说明模型能回收一项已知关系。 |
| E | 分别看 KRAS 状态切换对 EGFR 和 MAP3K7 依赖的影响;蓝/红线对应从野生型加入突变或移除内源突变。预测提示部分细胞背景下 KRAS 突变会增强这些依赖,仍需实验验证。 |
突变 0/1 翻转没有区分不同突变位置和功能,且不同时重建全部下游组学。因此 SE 是模型条件响应,不一定是生物编辑后的真实变化。回收 PTEN–CHD1 支持合理性,KRAS 个体背景差异提示需限定应用;所有新关系仍应保留待验证标签。
Figure 5:患者肿瘤的预测依赖图谱
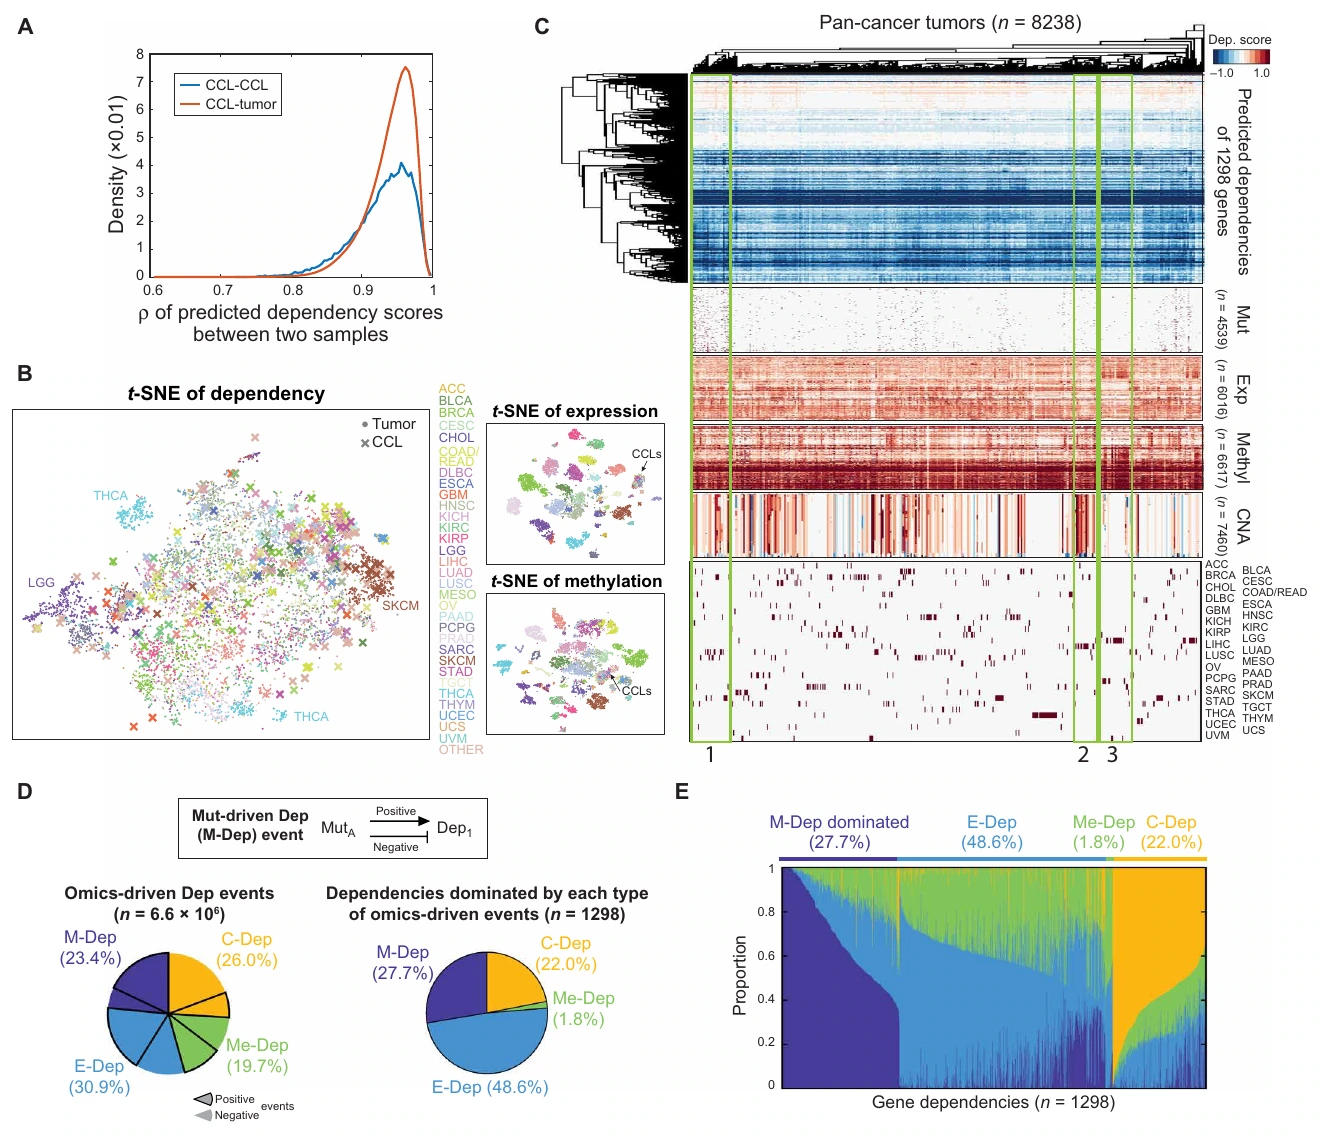
原图来源:所用 PDF 文件第 8 页,Figure 5。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | 比较细胞系–细胞系与细胞系–肿瘤的预测依赖谱相关分布;支持这些预测处于可比较的表示空间。 |
| B | 并排展示依赖预测、表达和甲基化的 t-SNE;观察肿瘤与细胞系在不同数据空间中的关系。二维重叠不能单独证明迁移预测正确。 |
| C | 依赖热图聚类与组学/癌种标签对照,识别具有不同遗传或表达特征的肿瘤分组。 |
| D | 通过改变某一组学输入定义突变、表达、甲基化或拷贝数“驱动”的依赖事件,并统计事件数和主导依赖数;这里是模型内的贡献分析。 |
| E | 逐个基因展示各种驱动事件比例;不同基因依赖对各类组学信息的敏感程度不同,表达及突变等占有较大贡献。 |
患者依赖地图和 t-SNE 重叠都为预测产物,不是新增 8,000 次真实筛选。驱动贡献来自改变模型输入,可能受相关组学补偿影响;不能将表达贡献直接解释为表达因果。癌种和纯度可能主导聚类,后续患者关联应检验这些混杂。
Figure 6:预测是否符合临床及 PDX 中已知依赖
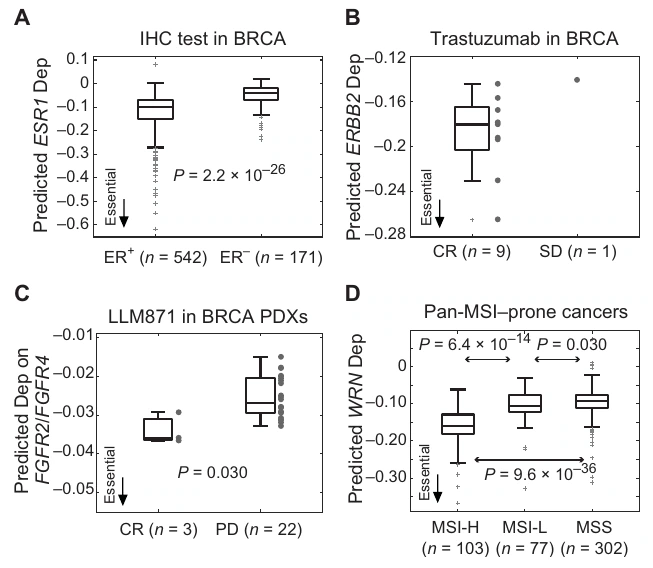
原图来源:所用 PDF 文件第 9 页,Figure 6。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | ER 阳性乳腺癌被预测更依赖 ESR1,符合雌激素受体相关生物学;依赖分数越负表示敲除越不利于肿瘤细胞。 |
| B | 比较 trastuzumab 完全缓解与稳定疾病患者的 ERBB2 预测依赖,前者更强;样本仅 9 对 1,作者明确指出不足以评估统计显著性。 |
| C | 对 FGFR2/4 抑制剂 LLM871 的 PDX 反应与预测依赖比较;完全缓解组对 FGFR2/4 的预测依赖更强,支持靶点依赖与药物反应的联系。 |
| D | 五类易出现微卫星不稳定的癌症中,MSI 高组被预测更依赖 WRN,与已知 MSI–WRN 脆弱性一致。 |
已知 ESR1、ERBB2、FGFR、WRN 背景检验预测的临床合理性,但 9 对 1 trastuzumab 分组无法支持稳定显著性。药物抑制与基因敲除也不是完全同一干预。PDX 和已知 MSI 脆弱性提供补充,应明确为这些具体关系的支持,不能推广成所有患者依赖正确。
Figure 7:依赖预测与化疗反应及生存的关联
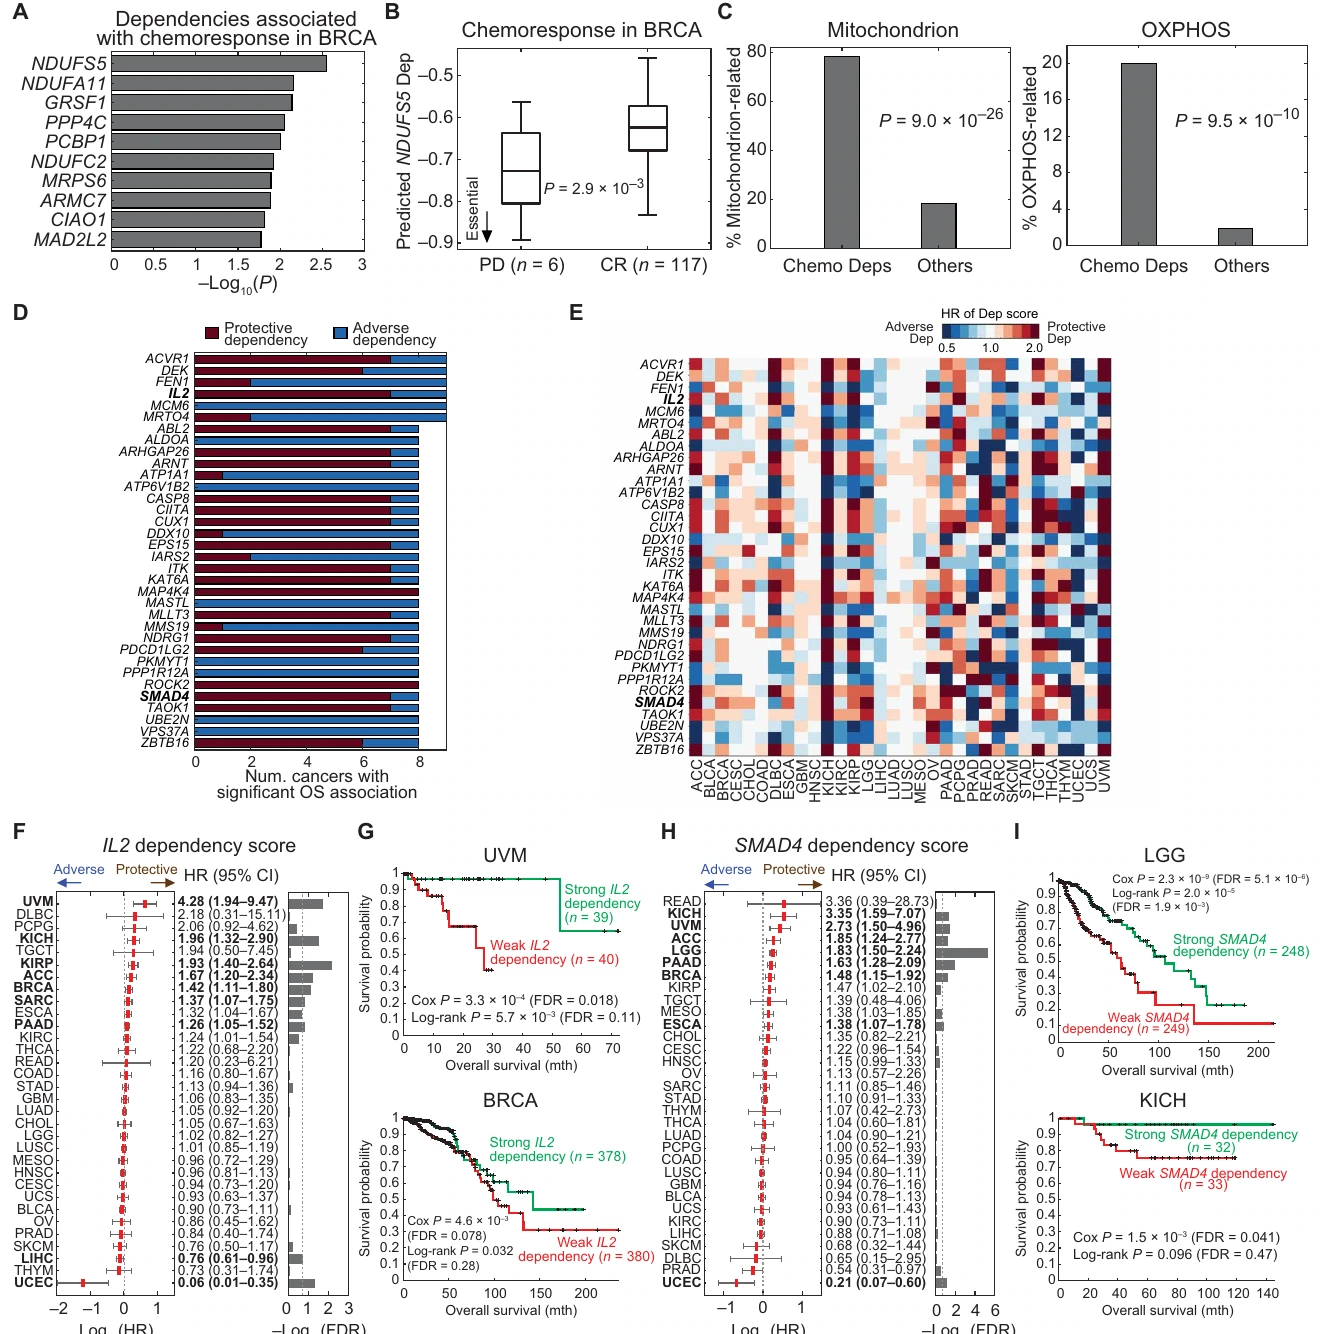
原图来源:所用 PDF 文件第 10 页,Figure 7。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | 列出乳腺癌完全缓解与进展患者之间差异最明显的十个预测依赖,用于寻找化疗反应相关基因。 |
| B | 展开排名第一的 NDUFS5:进展组依赖分数更负,提示化疗耐受肿瘤更依赖该线粒体相关基因。 |
| C | 化疗反应相关依赖中线粒体和氧化磷酸化基因显著富集,提示耐药相关代谢脆弱性。 |
| D | 统计各基因在多少癌种中与总生存相关,并区分保护性与不利依赖,显示关联具有癌种差异。 |
| E | 热图展开各癌种中依赖分数的风险比。由于负分数代表更强依赖,HR 大于 1 对应“更强依赖与更好生存相关”,阅读方向容易与普通表达量指标混淆。 |
| F | IL2 的泛癌 Cox 关联、风险比及显著性;评估其在不同癌种中的方向和强度,不是每种癌症都显著。 |
| G | 葡萄膜黑色素瘤和乳腺癌按 IL2 依赖强弱分组的 Kaplan–Meier 曲线;更强依赖组总体生存更好,但图中同时列出的多重校正结果须逐项区别。 |
| H | SMAD4 的泛癌关联森林图,与 F 类似地检查其作用方向是否随癌种改变。 |
| I | 低级别胶质瘤与肾嫌色细胞癌的 SMAD4 分组生存曲线。LGG 分组差异明显,KICH 的连续 Cox 分析与二分组 log-rank 检验并非同样显著,不能笼统写为两者均显著。 |
阅读提醒
- Figure 4 的 SE 是模型预测的合成必需效应;Figure 5 的肿瘤图谱是预测值,未对每个患者肿瘤进行真实 CRISPR 筛选。
更负是更强依赖,HR 的方向因此与常规表达指标相反。连续 Cox 与二分 log-rank 不同,多癌种检验还需校正;LGG/KICH 不能笼统合称显著。化疗反应和生存关联是回顾性探索,预测值与结局相关不能证明抑制该基因改善生存。
我的理解与可迁移设计
我最想迁移的是先有目标终点和跨域验证,再谈大型预测图谱。AD 研究同样可用公共正常数据预训练,但没有 AD 功能标签时,患者表达参与学习并不能凭空产生因果标签。若构建 TE×AD 模型,应分开普遍调控能力与 AD 特异增量,并报告逐位点/研究预测而非仅总体相关。固定目标方向、保留正式阴性和未知、避免用模型输入翻转冒充编辑实验,是纯计算研究能保持可信机制边界的关键。
