55.DeepBind:原图、模型逻辑与研究范式

55.DeepBind:原图、模型逻辑与研究范式
Perry论文题名: Predicting the sequence specificities of DNA- and RNA-binding proteins by deep learning
期刊与年份: Nature Biotechnology,2015。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: 能否从多类 DNA/RNA 结合实验中自动学习序列特异性,并解释调控变异及剪接关联?
研究难点与idea形成
DNA和RNA结合蛋白的序列偏好是调控分析的基础,但不同实验给出的标签很不相同:芯片提供连续强度,ChIP或CLIP给出细胞内富集,SELEX偏向高亲和序列。固定PWM能解释单个位点,却难以涵盖多个模式、间隔和组合。我的推测是,DeepBind的构思是把“扫描未知位置的结合模式”改写成卷积任务,再让统一的可训练接口适配不同实验;这一点比将一个分类器换成神经网络更有意义。
序列模型另一个难点是负样本定义。随机背景与实验未富集区域的组成可能不同,模型可能用GC或重复序列丰度区分它们。体外同一探针体系的留出能减少一些混杂,跨技术测试再检验是否依赖特定平台偏差;二者不能互相替代。对疾病位点,风险与非风险片段也需相同背景,否则很容易把序列类别差异误写成蛋白结合机制。
这里的自动校准同样属于研究设计。搜索学习率、正则化和dropout有助于避免人为手调偏好,但最终测试必须独立于选择。输出模型库方便使用,却不能取消每个蛋白的验证差异。一个在特定实验上性能好的模型,不必然适合另一种细胞条件中的变异评分。
输入、架构与学习范式
输入是核苷酸序列,训练目标是实测结合强度或结合与否标签。卷积滤波器沿序列扫描相当于学习多个motif;阈值与整流强调较强匹配,池化汇总其最大和平均响应,最后由非线性网络输出结合分数。最大池化帮助识别某个位点存在,平均响应可反映短模式的累积,两者的贡献通过训练学习。它不用事先提供motif的精确位置,但仍依赖实验结合标签,因此是监督学习,不是因为发现新motif就变为无监督。
权重与PWM相似但不强制为概率,神经网络能组合多个检测器,而不是只假设独立碱基贡献。架构适合局部序列模式的位置不确定性,池化也使不同长度输入可被汇总;代价是部分精确位置关系会被压缩。论文展示可变间隔、二级模式等结果,不应据此声称它已完整学会所有长程调控语法。对很长基因组距离的相互作用,仍需要另外定义输入和输出。
从结合预测到分子解释
本文首先用独立实验评估结合,然后通过突变图比较野生型与替代序列的输出,最后联系已知疾病变异和RBP的剪接位置作用。跨体外与体内的验证很重要:体外模型主要学亲和性,细胞内富集还包含染色质可达性、共因子与实验偏差。若能迁移,说明序列特异性确实有贡献;若motif来自ChIP,也可能代表共结合蛋白而非目标蛋白直接识别。
图谱里的每个突变分数是保持周边序列不变的计算比较,可以指向候选结合变化,不能直接证明该变异在患者中改变了表达。结合分数、基因调控、细胞功能和疾病表型之间有多级证据,论文的已知案例展示解释能力,不能把这些案例当成新完成的疾病因果实验。
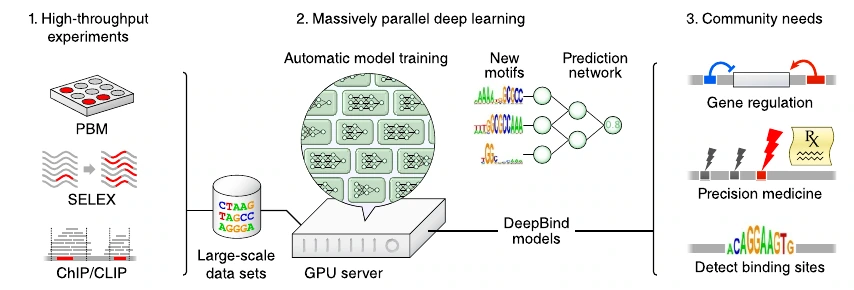
Figure 1|DeepBind 输入、学习及用途
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
图的三个编号步骤把实验标签、自动学习与下游使用串起来。第一步是不同测量技术,而非把所有数据混成同一生物真值;第二步同时发现模式和组合规则;第三步把同一模型用于新序列及突变评分。此图的动机是给出统一接口,但统一计算接口不代表体外亲和与细胞内占据完全等价。应用时应保留每个模型的训练技术与蛋白来源。
| 子图 | 讲解 |
|---|---|
| 1:实验输入 | PBM、SELEX、ChIP/CLIP-seq 等提供不同蛋白的结合序列或强度,统一为序列学习问题。 |
| 2:模型学习 | 自动学习基序和组合规则,输出预测结合分数;GPU 支持高效训练。 |
| 3:应用 | 用于找结合位点、比较野生型与突变序列分数,提出变异功能解释。 |
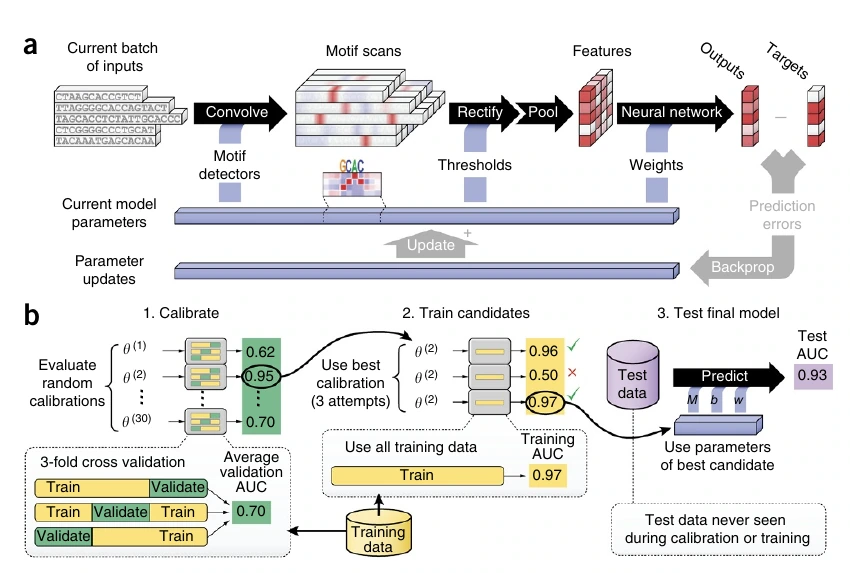
Figure 2|网络内部与训练流程
原图来源:所用 PDF 文件第 2 页,Figure 2。点击图片可查看原图。
a展示五条序列并行处理及反向传播如何共同更新motif、阈值和网络权重,说明模式不是先固定再分类。b分开校准、训练和测试:超参数选择应在测试之外完成,才可把最终结果解释为泛化。这里可学习的位置扫描避免要求每条序列先标注结合位点,这也是它比普通固定输入神经网络更适合该任务的原因。图解释了计算机制,却不能单独证明滤波器就是真实分子的唯一motif。
| 子图 | 讲解 |
|---|---|
| a | 五条序列并行通过卷积、整流、池化和神经网络得到各自分数;反向传播同时更新基序、阈值和权重。 |
| b | 校准、训练、测试的划分和流程说明超参数选择与独立验证,避免在测试集调参。 |
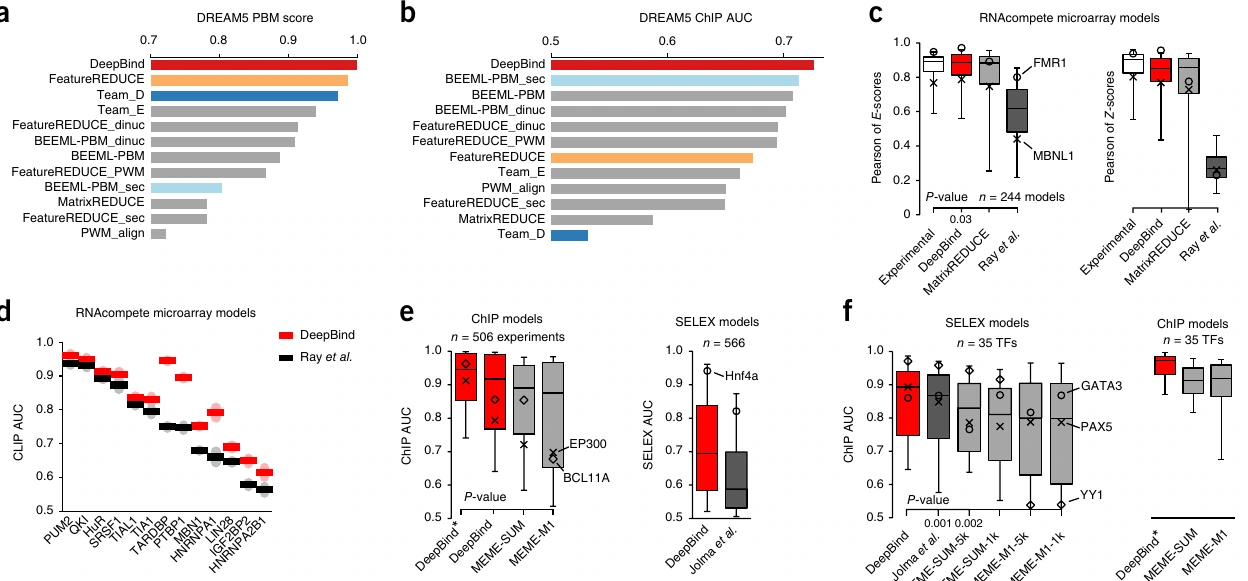
Figure 3|多技术和跨技术预测性能
原图来源:所用 PDF 文件第 3 页,Figure 3。点击图片可查看原图。
a、c分别检查DNA和RNA体外测量,b、d检验跨体外与体内来源,e检查同技术独立测试,f再看SELEX到ChIP的迁移。这样的布局把“能拟合技术”与“捕捉可迁移序列特异性”区分开;只在同平台胜出容易学到偏差,跨平台保持优势更有说服力。评价仍由各实验的真实标签和负样本定义,AUC与相关各反映不同目标,不能用某个高AUC推定所有蛋白的绝对亲和都可准确量化。
| 子图 | 讲解 |
|---|---|
| a | DREAM5 的 PBM 体外 TF 评价,用相关和 AUC 汇总 66 个蛋白,比较方法排名。 |
| b | 用体外训练模型预测体内 ChIP,DeepBind 同时在体外和体内排位较高,检验跨技术泛化。 |
| c | RNAcompete 的 RBP 体外性能分布,与已有方法比较自动序列学习。 |
| d | 体外 RBP 模型用于体内结合数据,检查 RNA 结合特异性是否可迁移到细胞情境。 |
| e | ChIP 训练→ChIP 测试及 HT-SELEX→HT-SELEX 的 AUC,检验技术内部的性能。 |
| f | HT-SELEX 模型给 ChIP-seq 序列评分的 AUC,进一步检查体外到体内迁移。 |
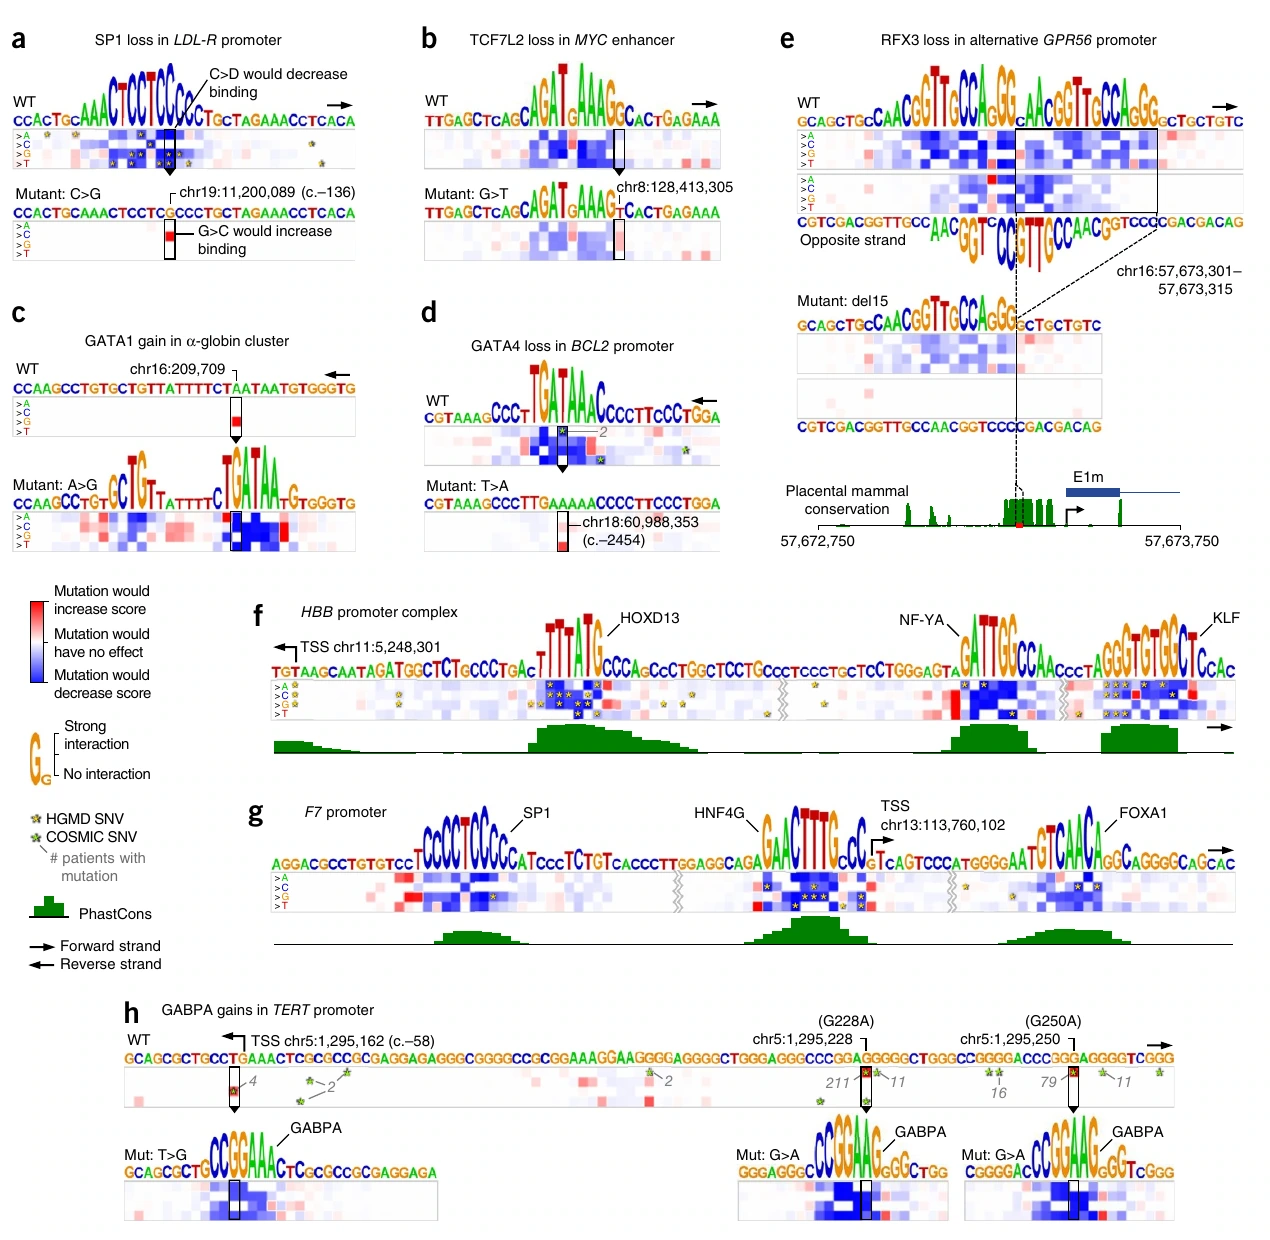
Figure 4|疾病相关序列变异
原图来源:所用 PDF 文件第 4 页,Figure 4。点击图片可查看原图。
a–h用LDLR、MYC、globin、BCL2、GPR56、HBB、F7与TERT等已知疾病相关区域说明突变图如何指向结合丢失或获得。动机不是重新计算一个风险标签,而是将碱基变化与具体蛋白的序列识别连接。病例中既有破坏位点,也有创造位点,提醒“突变有害”不总等于分数下降。图能帮助形成可检验的分子假设;即使与文献机制一致,也需区别模型复现已知事实和独立实验证明新机制。
| 子图 | 讲解 |
|---|---|
| a | LDLR 启动子 SNV 的突变图显示 SP1 位点被破坏,与家族性高胆固醇血症线索对应。 |
| b | MYC 增强子癌症风险变异削弱 TCF7L2 结合分数,连接非编码变异与 TF 位点。 |
| c | 珠蛋白基因簇变异新建 GATA1 位点,提示异常新位点可改变原有启动子调控。 |
| d | BCL2 启动子变异丢失 GATA4 位点,提出卵巢颗粒细胞肿瘤相关机制线索。 |
| e | GPR56 区域删除损害 RFX3 位点,与异常皮层发育对应;模型还揭示重叠链上的潜在位点。 |
| f | HBB 启动子多个 HGMD 变异的突变图,提示破坏 TF 结合与 β 地中海贫血的关系。 |
| g | F7 启动子同类分析,提示凝血相关疾病变异可能影响调控结合。 |
| h | TERT 启动子突变新建 GABP-α 位点,符合肿瘤中启动子激活的机制线索。 |
Figure 5|RBP 结合位置与剪接变化
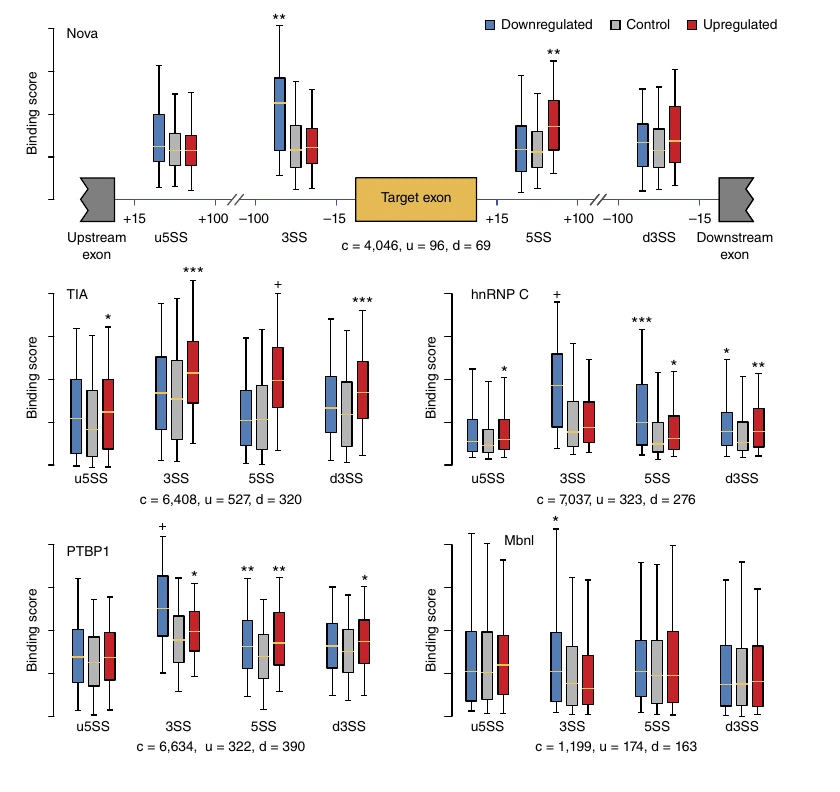
原图来源:所用 PDF 文件第 5 页,Figure 5。点击图片可查看原图。
这些块没有字母,需按Nova、TIA、hnRNP C、PTBP1和Mbnl分别读。模型对外显子周边不同位置打分,再比较蛋白变化后上调、下调与对照外显子,问同一个结合偏好是否因位置而具有不同剪接关系。Nova和PTBP1的上游信号、TIA的下游信号等说明单一结合总分不够,空间背景影响功能。这里结合分数与剪接响应的关联支持位置规则,但不能排除其他调控成分;模型没有直接测量每一条RNA上的真实占据。
| 子图 | 讲解 |
|---|---|
| Nova(上方) | 在不同剪接邻近位置比较上调、下调及对照外显子的结合分数;上游高分更联系抑制、下游高分更联系促进,显示位置依赖性。 |
| TIA(中左) | 上调外显子在下游附近结合分数更高,符合 TIA 的剪接促进作用。 |
| hnRNP C(中右) | 比较外显子前后各位置的三组分布,揭示该蛋白结合与外显子排除/包含的关联。 |
| PTBP1(下左) | 下调外显子上游分数偏高,符合上游结合抑制较弱剪接位点的已有机制。 |
| Mbnl(下右) | 各剪接邻近区域的结合分数差异显示 Mbnl 与剪接变化的关联,重点看位置和变化方向,而不是统一当作增强表达。 |
Figure 6|学到的基序与已知基序
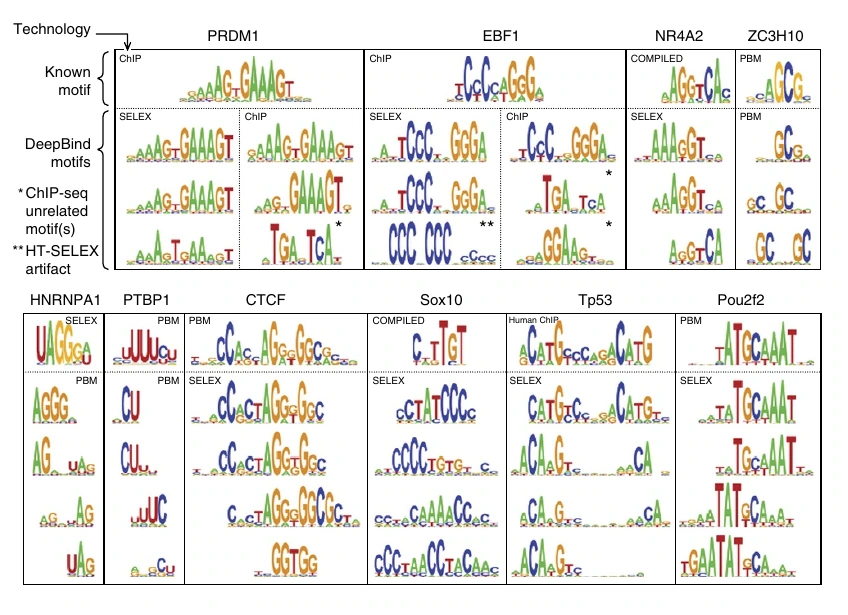
原图来源:所用 PDF 文件第 6 页,Figure 6。点击图片可查看原图。
按蛋白名称逐行比较学习模式与既有数据库,目的在于检查预测能力能否转化为可理解结构。HNRNPA1与Tp53提示可变间隔,CTCF及NR4A2提示位置依赖,PTBP1、Sox10与Pou2f2展示二级模式,PRDM1和EBF1则提醒体内数据可含共因子。与已知motif吻合支持学习到序列信息,不吻合也可能来自测量背景;不能把所有新模式都称为目标蛋白直接结合发现。每行都需要回到训练数据的实验来源。
| 子图 | 讲解 |
|---|---|
| PRDM1 | 比较体外/体内基序;ChIP 学到的部分非直接基序可能提示协作 TF,而非全是 PRDM1 直接结合。 |
| EBF1 | 同样比较已知、SELEX、ChIP 基序,揭示体内额外相关基序及技术差异。 |
| NR4A2 | 多个学习基序对应不同组合/间隔,说明单一 PWM 可能不足表示其序列偏好。 |
| ZC3H10 | PBM 学到的基序与已知序列对照,展示短核心及多个相关模式。 |
| HNRNPA1 | 多个 RNA 基序显示可变宽度间隔,说明结合不是只认一个固定长度序列。 |
| PTBP1 | 多个 RNA 基序展示次级偏好,补充主基序不能覆盖的结合模式。 |
| CTCF | 多个 DNA 基序体现位置间依赖及较长结合结构,突出比单一独立位置模型更丰富的模式。 |
| Sox10 | 学习到主、次级基序,展示同蛋白多个序列偏好。 |
| Tp53 | 不同间隔的半位点结构,展示 p53 结合的可变间距。 |
| Pou2f2 | 主及次级 DNA 基序与已知结合模式比较,检验模型解释是否具有生物学对应。 |
阅读说明
- Figures 1、5、6 无字母标号,分别按原编号步骤、蛋白位置和蛋白名称逐块解释。序列突变图是模型功能预测,不能单独替代变异的因果实验。
依据:对应主图、完整图注及正文 Results;实验结果只按本文给出的对象和条件解释。
我的理解与可迁移设计
这篇最值得迁移的是局部机制可解释与跨测量验证。研究AD风险位点落在转座子时,可以先定义某些TF或RBP的序列任务,再比较风险等位基因对结合预测的影响;但TE身份本身不证明调控活性,需要脑细胞的可达性、表达或其他独立证据。一个轻量CNN就能检验局部模式问题,不必从零预训练巨型DNA语言模型。
我会特别加入同家族相似序列的划分控制,防止重复元件的高同源性让测试看起来轻松。还应对GC、长度、可比对性和实验来源设置匹配,比较motif扫描及浅层模型。最终可把候选变异分为“预测结合改变”“有细胞背景支持”“有基因及疾病证据”三层,而不越级写成因果靶点。论文给出的范例强调可解释性,但真正可靠的机制路线仍要让每一层证据可单独复核。
