7.EVE:原图、模型逻辑与研究范式

7.EVE:原图、模型逻辑与研究范式
Perry论文题名: Disease variant prediction with deep generative models of evolutionary data
期刊与年份: Nature,2021。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Nature,2021;以当前 PDF 为准。
研究瓶颈怎样转化为问题
临床致病标签稀缺,且不同基因的收录、研究强度和标签质量差异很大。直接训练疾病分类器容易记住基因身份或标签偏倚。EVE 转而问:在自然进化已经筛选过的大量同源蛋白中,哪些氨基酸组合仍能维持功能?依据研究设计推断,其 idea 是把进化当作重复发生的功能筛选,让未标注序列学习约束,再把违背约束的变异解释为更值得怀疑的候选。它研究的是蛋白错义变异,不是非编码调控演化。
输入、训练目标与推断
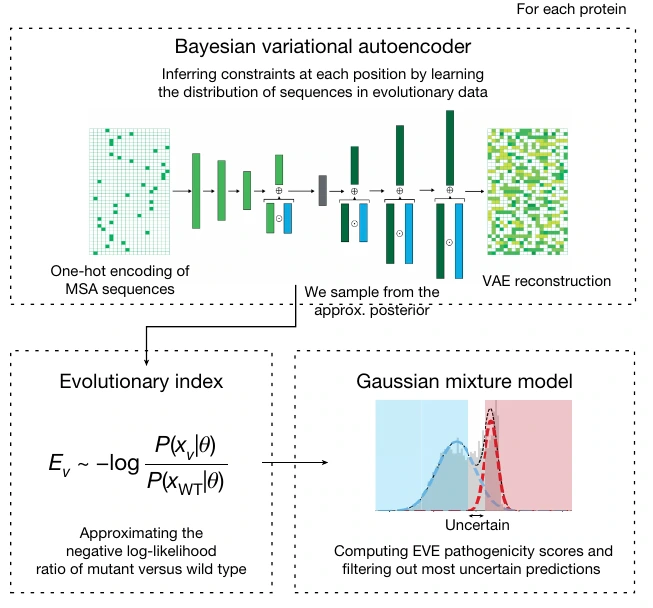
每个蛋白建立多序列比对,训练贝叶斯变分自编码器。模型以潜变量表示高阶氨基酸依赖,用重建与变分推断学习自然序列分布;相较单位置保守性,它能表达两个位置共同变化的背景。突变相对于野生型的近似负对数似然比形成 evolutionary index,再由全局/局部高斯混合模型得到连续 EVE 分数和良性、致病、不确定分类。这里分数是模型和混合假设下的推断,不是直接测量疾病发生概率。
不用 ClinVar 训练减少一种循环,但同源比对质量、物种采样、序列加权及疾病机制仍影响结果。自然选择整合多种功能;具体实验只测一项功能,所以进化预测与实验不一致时,不能预设其中一个必定错误。
Figure 1:EVE 的无监督推断流程
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| 全图(无字母标签) | 对每个蛋白的多序列比对训练贝叶斯变分自编码器;突变与野生型序列的相对似然形成进化分数,再用混合模型分成良性、致病及不确定。图说明进化约束如何转为变异类别及置信度。 |
图中两阶段必须分开:VAE 学的是序列可容忍性,混合模型做的是分数类别化。全局/局部混合用于跨蛋白共享尺度同时保留蛋白差异,预测熵则允许模型对边界样本保留不确定。这样既不要求稀有变异在自然数据中已经出现,也不把所有未出现序列都标作致病。它仍隐含自然适应性与人类疾病后果相关的假设;晚发、环境依赖或人类特异机制可能并不受到同样强的进化筛选。
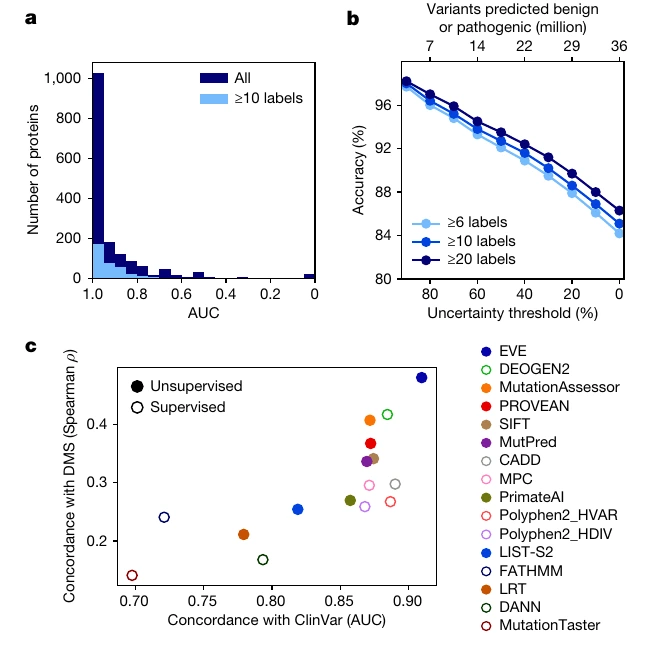
Figure 2:临床及功能基准性能
原图来源:所用 PDF 文件第 2 页,Figure 2。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 显示 3,219 个蛋白及标签较充分蛋白的 ClinVar 分类 AUC 分布,评估不同基因上的总体准确性。 |
| b | 将最不确定变异暂不分类,比较剩余变异的准确率与覆盖数量;提高准确率需要牺牲部分分类覆盖率。 |
| c | 横轴 ClinVar AUC,纵轴深度突变扫描相关性,比较有监督和无监督方法;EVE 在两类独立证据上均具有较高一致性。 |
a 的逐蛋白分布和 c 的 ClinVar+DMS 双轴减轻单一总体 AUC 被少数标签多的基因主导的问题。b 把不确定比例与覆盖数量同时展示,比只报高准确率更诚实:排除 25% 后约 90% 的分类准确率不能代表所有 36 百万预测。DMS 基准独立于临床标签但蛋白数量更少、实验读出不同,二者相互补足而非同一终点。使用模型时应保留连续分数和不确定性,不把 uncertain 作为良性阴性加入训练。
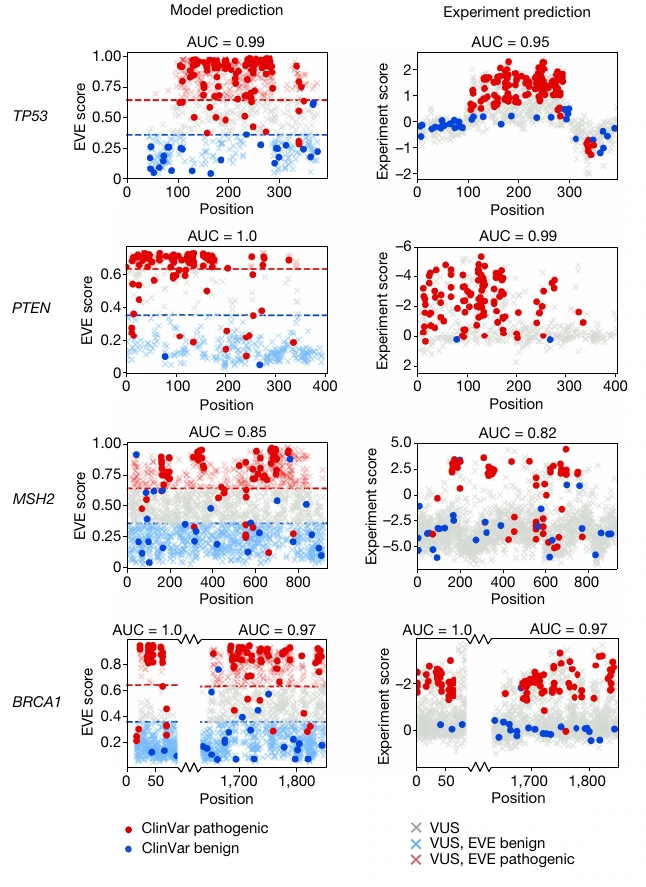
Figure 3:预测与功能实验对临床标签的比较
原图来源:所用 PDF 文件第 3 页,Figure 3。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| TP53(左:EVE;右:实验) | 按蛋白位置显示变异分数,圆点为 ClinVar 标签、叉号为意义不明变异;EVE 能分开多数良性/致病变异,且 C 端的区分比所用实验更明显。 |
| PTEN(左;右) | 用相同方式对照 EVE 与功能实验,两者对临床标签均有很强区分能力,也可为部分 VUS 提供方向性证据。 |
| MSH2(左;右) | 比较 EVE 与功能扫描的类别一致性;两种证据总体接近,但存在分数及标签不一致的个别位点。 |
| BRCA1(左;右) | 在已有功能测量的区段比较预测与实验;高 AUC 支持进化模型在这些区段提供接近实验的变异排序。 |
逐蛋白对照揭示了‘功能实验’也受读出限制。TP53 某些区段的实验区分弱,而 EVE 与临床标签更一致,可能因为实验未覆盖全部相关功能;PTEN、MSH2、BRCA1 的相近排序说明进化信息具有实际判读价值。但图中比较针对所用具体实验,不意味着计算普遍优于一切实验。VUS 的预测落点可帮助选择验证,却不会因为与已知致病点邻近就完成临床分类;必要时应区分失活、获得功能、显性负效和剪接机制。
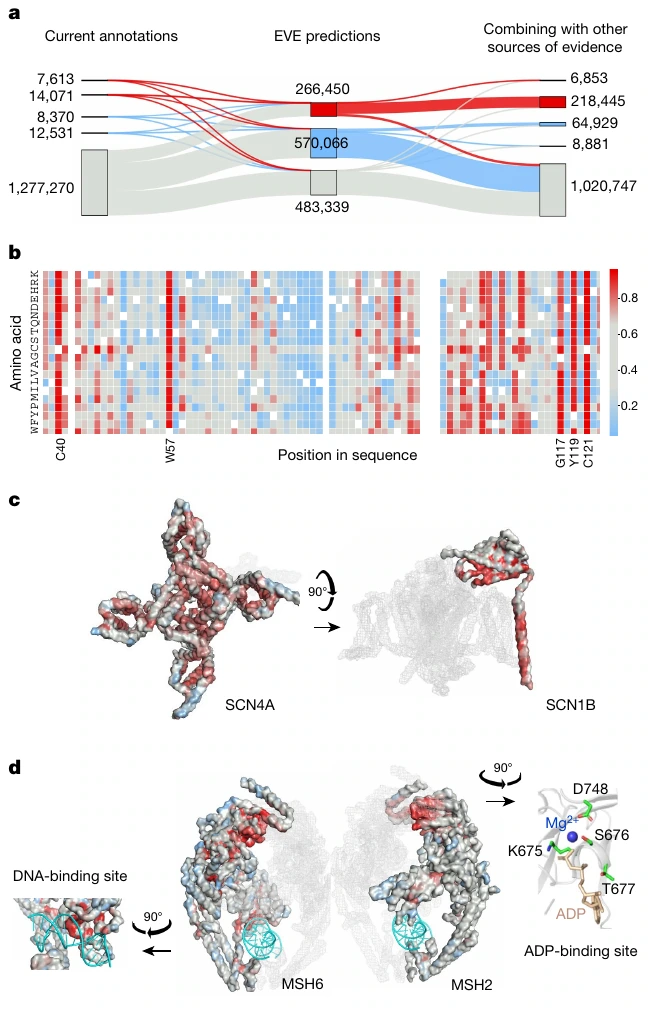
Figure 4:全基因预测及结构解释
原图来源:所用 PDF 文件第 4 页,Figure 4。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 左为已有临床标签及人群变异,中为排除 25% 不确定变异后的 EVE 分类,右为整合其他证据的分类;显示可解释变异的覆盖量增加。 |
| b | SCN1B 各位置的 19 种替换致病分数热图,区分普遍敏感的位置与特定氨基酸替换。 |
| c | 把分数映射到 SCN4A–SCN1B 三维结构;高分聚集于通道孔、疏水核心及亚基界面,给出功能解释。 |
| d | 映射到 MSH6–MSH2 与 DNA/ADP 复合物;DNA 及 ADP 结合区域高分,说明序列进化信号对应关键结构部位。 |
a 扩大可解释范围,b–d 把敏感性映射到替换热图和三维结构。界面、核心和配体结合区域高分符合机制预期,是对序列表征的解释,而不是额外训练标签。多个高分残基聚集于界面,并不说明每个替换造成同样方向和程度的损伤。平均位置分数也会掩盖某些可容忍的氨基酸替换;真正分析应回到指定变异及背景,并把结构说明与独立遗传或功能证据并列。
我的理解与可迁移设计
可迁移的是‘以丰富的自然数据预训练,保留不确定性,用正交实验验证’的逻辑。若研究 DNA 演化与 AD,可从人类序列上的真实等位功能标签出发,将保守性或跨物种背景作为解释变量;不能把 EVE 的蛋白似然直接当非编码 enhancer 标签。晚发 AD 还提醒我们,进化约束与疾病风险并非同一个目标:缺乏强保守性不等于没有 AD 功能,强保守性也不自动指定 AD。首轮应比较进化特征是否增加真实 MPRA 预测,而不是先假设进化分数就是机制。
若把这种无监督策略迁移到 enhancer,首先要检查‘序列常见’是否确实代表同一种功能。跨物种 enhancer 的活性可被 trans 环境、靶基因关系和基序补偿改变,短片段对齐也可能遗漏 TE 插入带来的背景。蛋白 MSA 中学到的约束不能直接作为 enhancer 的代理良性标签。可以提出人类/祖先背景计算反事实,再将真实人类双等位 MPRA 作为可检验目标,但没有跨物种实验时,只能说明模型预测背景依赖,不能宣称已测到演化改变功能。报告这条界限能使计算研究的创新明确且可反驳。
