31.DeepTCR-Immunotherapy:原图、模型逻辑与研究范式

31.DeepTCR-Immunotherapy:原图、模型逻辑与研究范式
Perry论文题名: Deep learning reveals predictive sequence concepts within immune repertoires to immunotherapy
期刊与年份: Science Advances,2022。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: 治疗前的 TCR 序列和患者 HLA 背景能否预测免疫检查点抑制剂疗效,并揭示应答相关 T 细胞的特异性和动态?
为什么从TCR序列出发,以及这个idea怎样成立
我的推测是,idea从“相似的克隆度可能对应不同抗原识别”这一信息缺口形成,再用序列和HLA上下文共同补足。以下是对研究逻辑的逆向重构。
免疫检查点抑制剂的临床难点,是能产生持久获益的人群只占一部分。TCR测序提供大量克隆,但常见指标把它们压缩成多样性或克隆度;两个患者可以具有近似的克隆度,却拥有识别完全不同抗原的T细胞。本文要增加的不是另一个总体计数,而是序列所携带的识别信息。进一步考虑HLA背景很合理:相似TCR在不同抗原呈递背景中未必识别相同对象。这是引言与模型设计能支持的研究逻辑;关于作者如何在某一时刻产生idea,原文没有个人经历证据,不能代替作者作心理叙述。
模型实际学什么:患者级监督与序列级潜变量
训练标签是CheckMate-038黑色素瘤患者的RECIST疗效,完全/部分应答作为一类,疾病稳定/进展作为另一类。输入是治疗前肿瘤TCR repertoire及HLA;单条序列表示与HLA嵌入结合,再由多头注意力捕捉多个序列概念,汇总到患者级分类。它属于多实例监督学习:一个患者拥有许多TCR实例,但每条TCR并没有直接的“导致应答”标签。注意力帮助模型在大批背景克隆中找信息,却不能自动为每条序列产生经过实验验证的抗原特异性。
本文另用VAE建立不使用应答标签的序列表示,并以UMAP展示。这个无监督部分承担可视化任务;随后筛选“最有预测力”的序列已依赖监督模型。把筛选后的分离图说成无监督模型自行发现患者应答群体,会掩盖信息从标签进入分析的路径。小规模43例临床训练也使患者级交叉验证、外部队列差异和估计不确定性比大规模序列数量更重要。
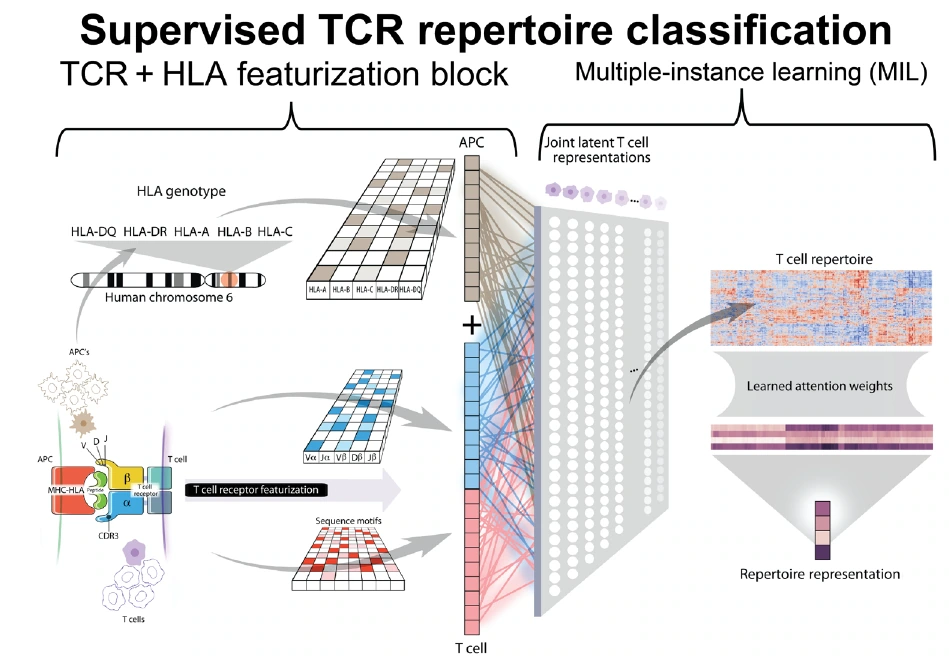
Figure 1|加入 HLA 背景的 TCR repertoire 分类模型
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
这一流程图先回答样本的粒度问题。分类对象是整个患者repertoire,序列是其中的实例,HLA则是实例解释所需的上下文。可把它理解为“先识别若干序列模式,再统计患者拥有这些模式的程度”。需要看清图中的汇总层,避免把单序列分数解释成病人的独立诊断。多头机制的动机是应答可能由多类免疫反应组成,单个统一motif不足以覆盖;但头的数量和可分离图案并不证明存在相应数量的真实抗原。
| 子图 | 讲解 |
|---|---|
| 全图(无字母标签) | 将单条 TCR 的序列表示与患者 HLA 的嵌入拼接;多头注意力识别不同序列概念,按整个 repertoire 中的比例汇总后预测疗效。图中 APC–MHC–TCR 关系解释为何同一 TCR 序列需要结合 HLA 背景解读。 |
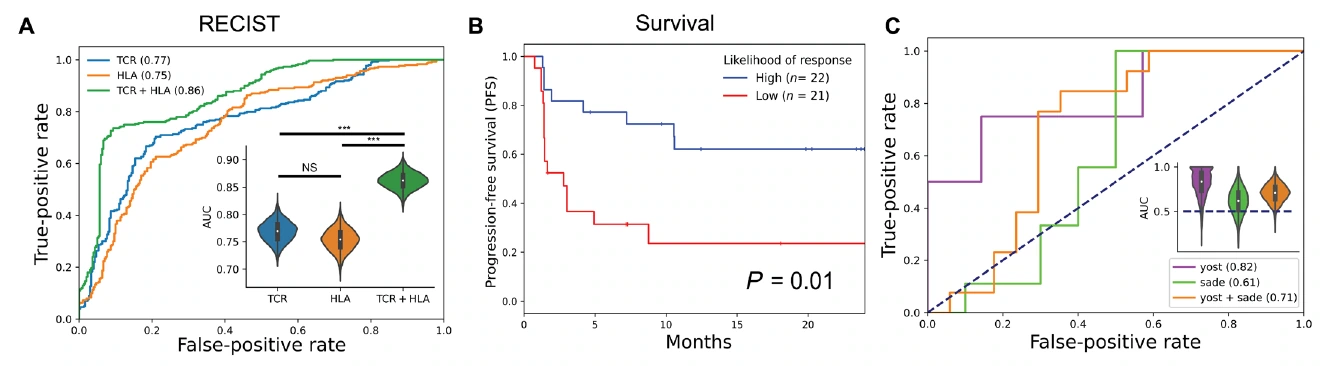
Figure 2|治疗前 repertoire 预测疗效与无进展生存
原图来源:所用 PDF 文件第 3 页,Figure 2。点击图片可查看原图。
图2是从模型结构走向临床用途的第一道检验。TCR、HLA与二者联合构成重要消融:联合AUC更高支持上下文提供增量信息,而不是只说明网络能够拟合应答。PFS分层是额外临床结局关联,但高低组用本队列预测概率中位数划分,并不是预先固定、可直接用于临床的阈值。外部yost与sade队列性能明显不同,应把这种差异作为结果主体讨论;疾病构成、治疗与采样背景变化都可能影响迁移,合并AUC不能遮住单队列的不稳定。
| 子图 | 讲解 |
|---|---|
| A | 用治疗前肿瘤浸润 TCR 预测完全/部分应答,比较 TCR、HLA、TCR+HLA 的 ROC。联合模型 AUC 为 0.86,高于单独 TCR 的 0.77 和 HLA 的 0.75。 |
| B | 按联合模型预测概率中位数分为高、低组,绘制无进展生存曲线。高预测应答组的 PFS 更好,log-rank P=0.005;这是预测分层与临床结局的关联。 |
| C | 将 CheckMate-038 上训练的模型用于两个独立皮肤癌队列。yost、sade、合并队列的 AUC 分别为 0.82、0.61、0.71,显示外部验证效果存在队列差异。 |
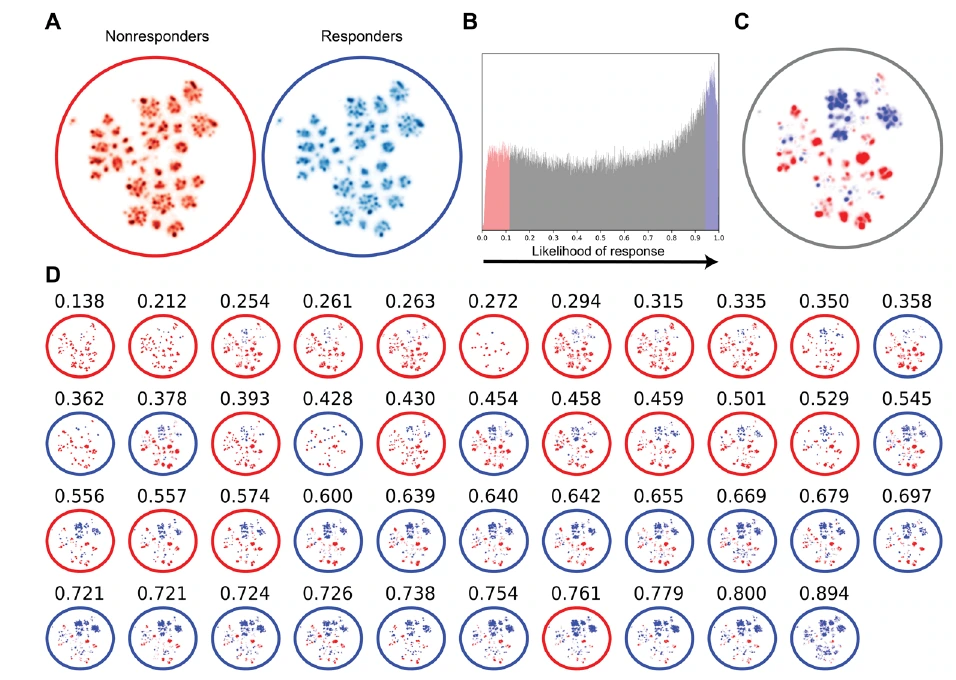
Figure 3|把预测相关的 TCR 序列放回无监督序列空间
原图来源:所用 PDF 文件第 4 页,Figure 3。点击图片可查看原图。
图3的关键是分析顺序:先无标签编码全部序列,再把监督分数映射上去,最后筛选两类高信息序列。全部序列混杂并不说明VAE失败,因为大多数序列可能与研究终点无关。筛选后形成分布差异支持分类信号稀疏,但这张图不是独立的泛化检验;颜色和筛选已经来自同一预测模型。逐患者小图的价值在于排查总体簇是否只由少数个体贡献,仍需避免把相邻UMAP点当作已证明识别同一抗原。
| 子图 | 讲解 |
|---|---|
| A | 用不依赖应答标签的 VAE 表示全部 TCR+HLA,再用 UMAP 看应答和不应答序列的分布。全部序列混在一起时,两组区别并不清楚。 |
| B | 给每条测试 TCR 汇总 Monte Carlo 交叉验证中的预测值,用颜色显示其属于应答特征的概率。它标出哪些序列对分类更有信息。 |
| C | 只保留两类最有预测力的前 10% 序列,重新查看总体 UMAP。过滤后两类序列形成不同分布,说明注意力模型可从 repertoire 的背景序列中提取信号。 |
| D | 逐患者显示这些高信息序列;边框是患者真实应答标签,上方是模型预测概率。多个患者共享相似的序列簇,而不是每人各有完全独立的模式。 |
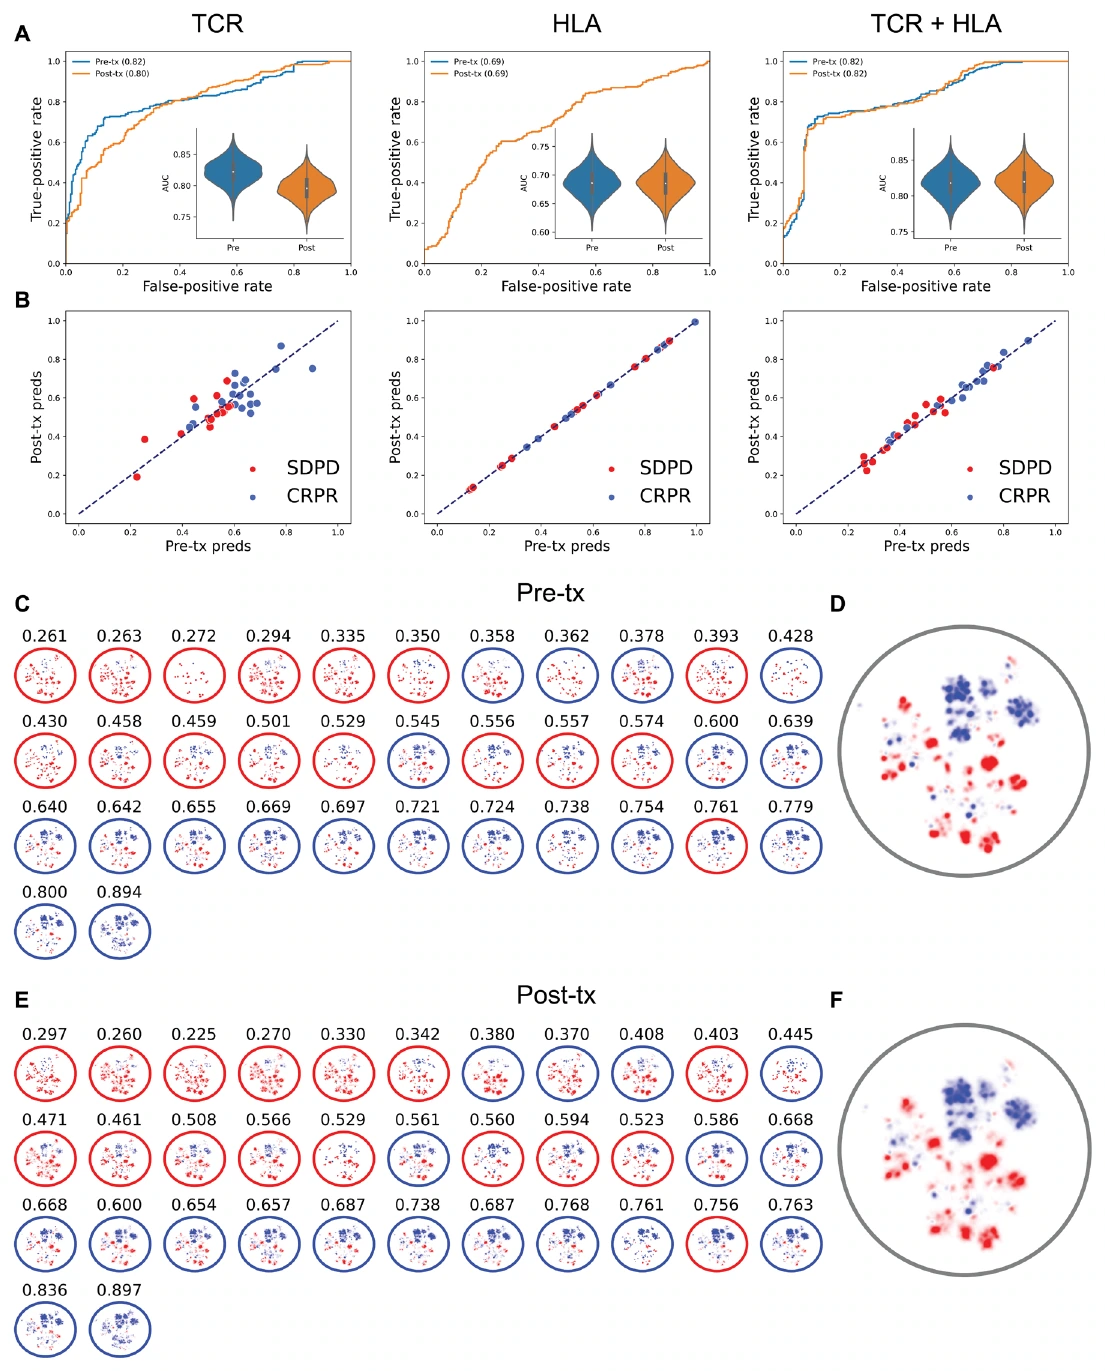
Figure 4|治疗前后的预测信号是否持续
原图来源:所用 PDF 文件第 5 页,Figure 4。点击图片可查看原图。
治疗前训练的模型用于治疗后35对样本,是一个带时间结构的迁移问题。前后预测接近支持序列概念的持续性,但在“同一患者”背景中并不等于在新患者上的外部预测。C/E可以检查各个体的变化,D/F则观察合并形状;二者必须一起读,才能区分稳定的群体概念与个体克隆替换。疾病及治疗后状态都可能改变repertoire,保持AUC不意味着免疫系统没有变化,也不意味着模型预测了治疗导致的变化。
| 子图 | 讲解 |
|---|---|
| A | 把治疗前训练的三个模型应用于 35 对治疗后 repertoire,比较前后 ROC 和 AUC。前后性能相近,提示应答相关序列信号在治疗后仍可见。 |
| B | 逐患者比较治疗前、治疗后预测概率。散点接近对角线,显示总体预测特征具有持续性。 |
| C | 逐患者展示治疗前最有预测力的序列分布,边框和点颜色区分真实标签及预测序列类型,是配对比较的基线。 |
| D | 把治疗前所有患者的高信息序列合并,显示应答与不应答序列簇的总体位置。 |
| E | 显示与 C 对应的治疗后逐患者分布。主要序列概念仍保留,可与同一患者治疗前的小图逐一比较。 |
| F | 治疗后合并 UMAP 与 D 对照;两类主要簇仍存在,支持相关抗原反应在治疗期间延续。 |
Figure 5|预测 TCR 的抗原特异性和克隆更替
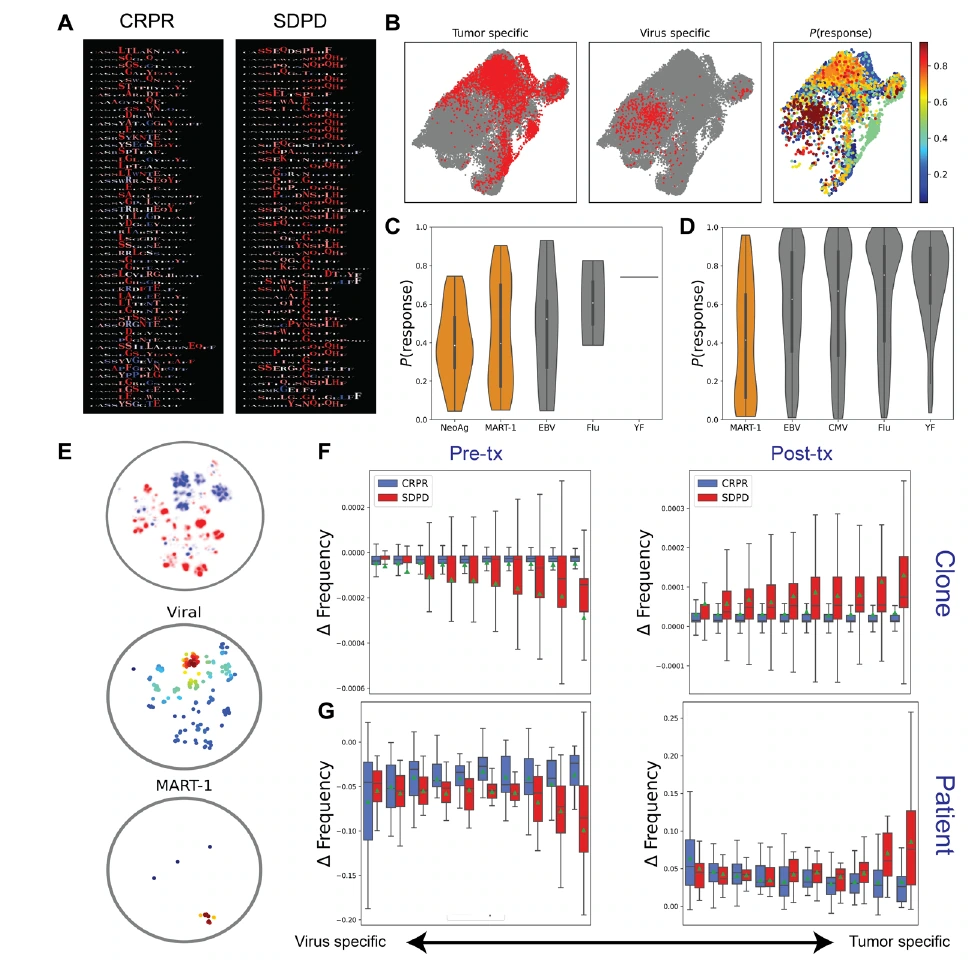
原图来源:所用 PDF 文件第 6 页,Figure 5。点击图片可查看原图。
作者在图5把抽象序列分数接到抗原注释上,这是本文最值得深读的证据跳转。残基敏感性提示模型利用CDR3中部,但logo是计算归因;Oliveira及McPas提供已知特异性TCR,是另一类证据。病毒序列偏应答、肿瘤相关序列偏不应答看似反直觉,迫使读者区分“有肿瘤反应T细胞”与“这些T细胞能有效工作”。治疗前后克隆频率及逐患者汇总支持周转不同,但从预测特异性到真实功能失调还隔着直接功能实验;新出现也可能受采样检出限影响。
| 子图 | 讲解 |
|---|---|
| A | 对两类最有预测力的各 50 条 TCR 做残基敏感性 logo。重要残基主要在 CDR3 中部,符合抗原识别相关位置的特点。 |
| B | 把已知肿瘤/病毒特异性的 TCR 放到单细胞表型 UMAP 中,并展示模型预测应答概率;由外部注释连接序列特征与抗原特异性。 |
| C | 在 Oliveira 数据中比较不同抗原类别的预测应答概率。病毒特异性 TCR 的概率高于肿瘤相关及新抗原 TCR,后者更接近不应答特征。 |
| D | 在 McPas-TCR 的已知特异性序列中重复比较,得到相似方向,提供独立注释来源的支持。 |
| E | 显示病毒特异性与 MART-1 肿瘤特异性 TCR 的核密度分布;病毒 TCR 偏应答区域,MART-1 TCR 偏不应答区域。 |
| F | 按预测肿瘤特异性概率分箱,比较治疗前已有和治疗后出现克隆的频率变化。不应答者中肿瘤特异性克隆的减少和增加均更明显,提示更快更替。 |
| G | 把上述频率变化汇总到每名患者,避免只看单克隆。结果同样指向不应答者较高的肿瘤特异性 TCR 周转。 |
Figure 6|免疫治疗下肿瘤特异性 T 细胞的解释模型
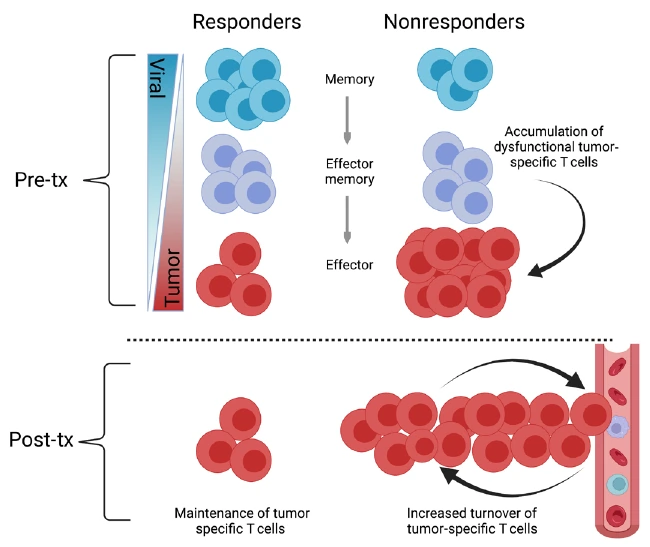
原图来源:所用 PDF 文件第 7 页,Figure 6。点击图片可查看原图。
最后的机制示意图不新增实验,而是在组织前五图的关系。作者用“可能由于功能失调”等限定表述提出解释:不应答者积累肿瘤特异性T细胞,治疗期间周转更快。它可以产生下一轮可检验假设,例如对模型提名克隆进行抗原识别与功能测定,或联合T细胞状态检测;不能因示意图画得完整,就把序列—抗原—耗竭—临床不应答整条链当作已经得到干预证明。
| 子图 | 讲解 |
|---|---|
| 全图(无字母标签) | 示意作者提出的生物学模型:不应答者治疗前积累功能失调的肿瘤特异性效应 T 细胞,治疗后这些克隆更快更替。它概括前述关联结果,功能失调机制属于解释模型,并非此图另做了直接功能实验。 |
依据:对应主图、完整图注及正文 Results;实验结果只按本文给出的对象和条件解释。
从模型走到疾病:我的判断与可迁移设计
本文完成的是患者级疗效关联、独立队列迁移、配对治疗样本分析,以及抗原注释支持的解释链。最可借鉴的设计是给实例加入生物学上下文:研究AD时,开放峰或TE片段也可能只有在特定细胞类型、染色质环境中才有意义。可以学习大量局部实例,再聚合为donor级状态;这是一种可迁移建模思路,不是说TCR结论已经适用于AD。
另一个启发是,不必要求所有原始实例都能在二维图中分离。疾病信息常稀疏,应该先定义真正的统计单位和留出方式,再问哪些实例对患者级结果有贡献。模型解释应获得独立功能注释或实验支持,而不是反复展示同一潜空间。对于无监督研究,训练不使用疾病标签可以成立,但发现后仍要有独立疾病证据;否则得到的只是序列结构。
阅读边界:HLA联合模型的增量、病毒/肿瘤注释的关联和克隆周转不同由本文支持;具体抗原及功能失调的因果作用仍需进一步检验。
如果以这一范式设计自己的研究,我会先加一个按患者置换标签的检验,并按患者而不是序列进行自助重采样,观察模型收益是否超出小队列的偶然性。还应把HLA单独模型、多样性或克隆度模型与联合网络放在同一留出划分中,检验序列是否贡献独立增量。跨队列验证要同时报告校准与阈值稳定性,因为一个模型即使排序尚可,也可能在外部队列系统性高估应答概率。上述是我的设计建议,不是声称作者已完成这些所有检验。对AD的对应关系,是以donor作为统计单位、控制细胞比例及测序深度,再检查局部元件信息是否仍有增量;不能把几十万细胞当成几十万个独立病人。这个迁移边界比复制注意力结构更有价值。
