16.Geneformer:原图、模型逻辑与研究范式

16.Geneformer:原图、模型逻辑与研究范式
Perry论文题名: Transfer learning enables predictions in network biology
期刊与年份: Nature,2023。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Nature,2023;以当前 PDF 为准。
研究瓶颈怎样转化为问题
稀有疾病或难取得的组织没有足够表达数据来从零学习基因网络。Geneformer 将大规模正常/多背景单细胞预训练与少量任务微调结合,问共享网络知识能否帮助识别剂量敏感基因并找干预候选。依据设计逻辑推断,idea 是把细胞中的基因相对重要性编码成上下文,再以低数据任务检验可迁移性;不是从患者少量细胞直接学习完整因果网络。
输入、目标与结构
Geneformer 的输入是基因名字组成的排序序列。先按细胞总计数归一,再将每个基因的表达除以它在整个预训练语料中的非零表达中位数,最后排序。这里排序的意思是“相对该基因通常水平,这个细胞里有多突出”,并非谁的原始 RNA 数最多。举一个示意例子:管家基因的归一表达为 100、语料中位数也为 100,比值是 1;某 TF 的表达只有 10、中位数为 2,比值是 5,TF 反而排在前面。这些数值仅解释算法,非论文实验数据。它帮助低表达但能区别状态的因子进入前部,也放弃了部分绝对表达幅度信息。
Genecorpus-30M 收集约 29.9 百万细胞,其中约 27.4 百万通过作者质量过滤。预训练随机遮住序列中 15% 的基因,要求六层 Transformer 根据其余基因及位置猜回被遮住的基因身份。例如心肌细胞上下文中缺了一枚 token,模型学习哪些基因通常共同出现、在哪个相对位置出现;任务不要求填写该基因的 RNA 计数,也没有直接提供 TF→靶基因的因果边。基因因此取得随细胞背景变化的 256 维表示,细胞表示由基因表示聚合。剂量敏感性、染色质分类和疾病分类再用各自真实标签微调,把这套上下文知识用于具体问题。
计算删除的操作是把某基因 token 从该细胞序列移除,重新前向计算,再比较原来与新表示的余弦相似度;相似度越低,表示方向改变越大。比较细胞表示回答整体状态影响,比较其余每个基因的表示回答哪些基因更敏感。计算激活则把基因移到序列最前部。因此它输出的是模型表征的改变,而不是自动产生带绝对单位的基因敲除转录组。本文把这类候选经患者模型、CRISPR 干预和微组织收缩终点串起来;输入起点是 RNA,DNA 位点仍需另一条证据连接。
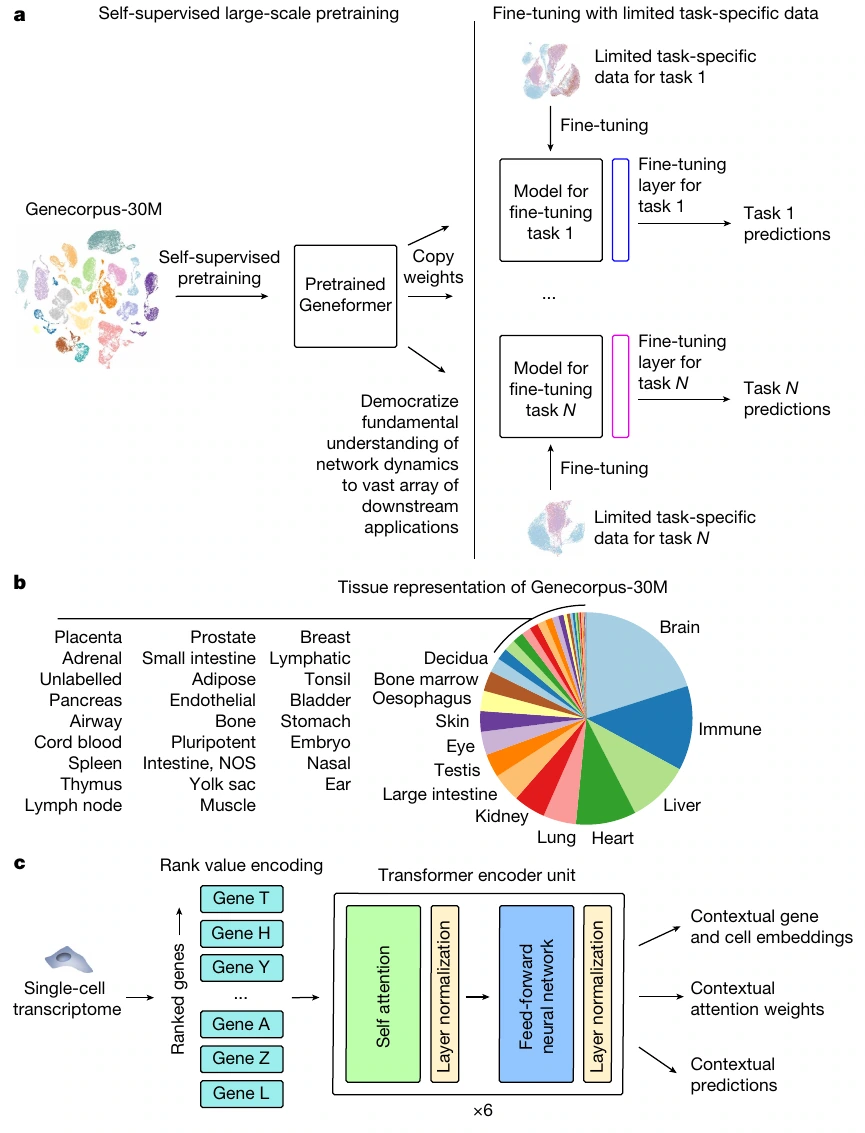
Figure 1:Geneformer 的迁移学习
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 先单次大规模自监督训练,再复制权重并以小量任务数据微调,得到多种基因/细胞预测。 |
| b | Genecorpus-30M 的组织组成,展示预训练资料多样性。 |
| c | 表达排序编码进入六层 Transformer,输出上下文基因/细胞嵌入、注意力及预测,说明其输入并非原始表达计数直接序列。 |
这张图解释迁移为什么可能发生:a 中各任务复制同一预训练权重,再加任务标签与预测头,节省的是“从零学基因上下文”的成本,而非省掉任务监督。b 的组织饼图说明预训练见过多种背景,正好为 c 的上下文编码提供变化来源;同一个 NOTCH 基因在不同细胞里可以取得不同表示。c 的六层注意力让一个 token 汇总同细胞其他基因的信息。若输入仅为一个孤立基因名字,就不能做这种背景区分。后面的各张图因此分别检验共享表示能否支持小样本分类、网络联系与可操作的干预。
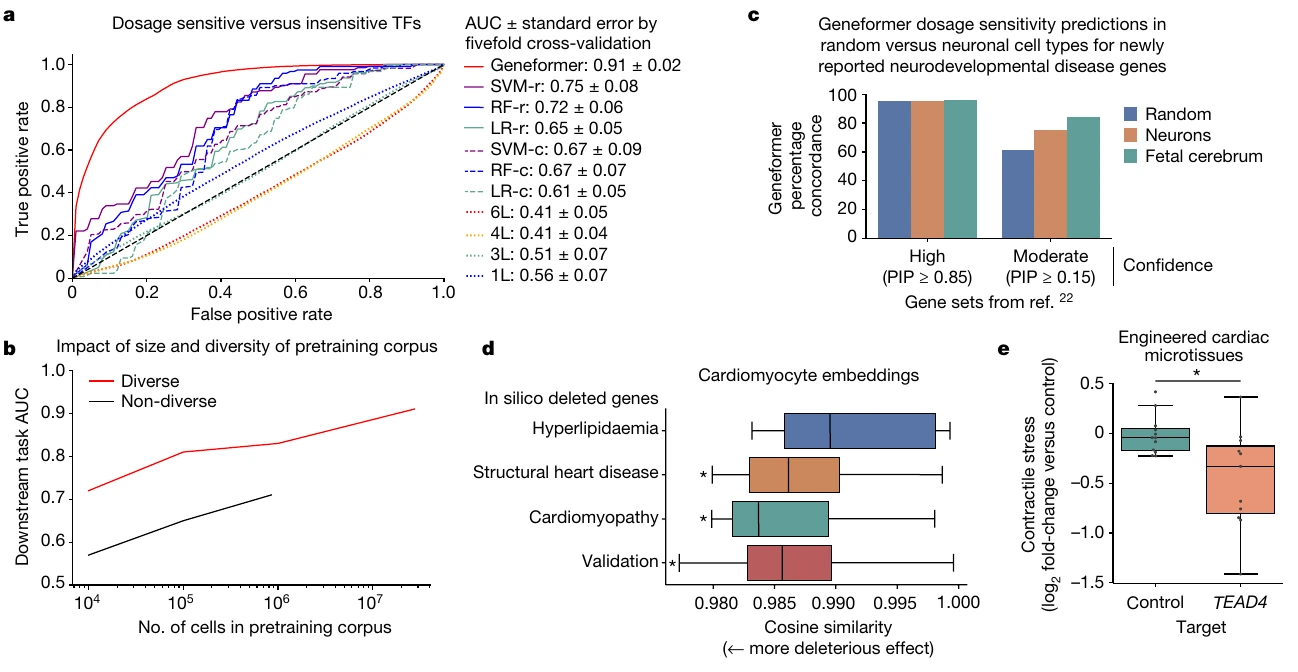
Figure 2:基因剂量敏感性
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 用约 10,000 个细胞微调识别剂量敏感 TF,ROC 与传统模型及未预训练网络比较,评估预训练价值。 |
| b | 改变预训练规模和多样性,同样下游数据下比较预测,显示广泛资料促进泛化。 |
| c | 在随机、神经元及胎儿大脑背景中评价新报道神经发育基因的剂量敏感预测,检验上下文依赖性。 |
| d | 计算删除心肌病/结构心脏病基因与非心肌机制对照基因的嵌入损伤,心肌相关基因影响更大。 |
| e | CRISPR 删除预测剂量敏感 TEAD4 后测量心脏微组织收缩应力;删除使单位面积收缩力显著降低,实验支持该候选基因对心肌功能的重要性。 |
a 的横轴是假阳性率、纵轴是真阳性率,Geneformer AUC 为 0.91±0.02;未预训练及传统分类器提供“已有表达特征就够不够”的对照。b 同时改变预训练细胞数量与多样性:更多细胞、更多相关变化是否提高同一下游任务,而不只比较最终最大模型。c 用随机细胞、神经元和胎儿大脑背景预测新神经发育基因,检查背景是否真的进入答案。d 换成无需该分类微调的计算删除:心肌病和结构性心脏病基因使心肌细胞表示改变较大,高脂血症基因同样与心血管疾病有关却主要通过其他细胞起作用,是有意义的特异性对照。e 再将 TEAD4 实际敲除:纵轴是收缩应力的对数读出,单位原图为 µN/µm²。真实功能下降使“表征对某基因敏感”跨到“该基因影响心肌收缩”,但支持范围首先是 TEAD4 这一候选。
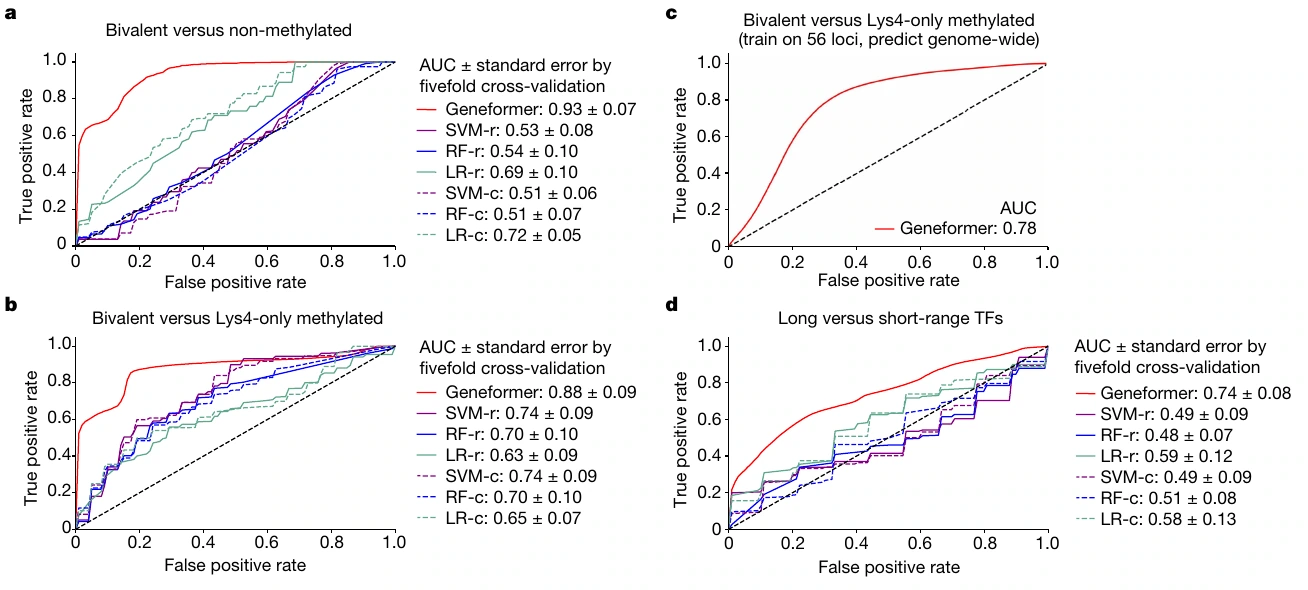
Figure 3:有限资料预测染色质属性
原图来源:所用 PDF 文件第 5 页,Figure 3。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 用少量 ESC 数据区分双价与未甲基化基因的 ROC,比较基准方法。 |
| b | 区分双价与只有 H3K4 甲基化的基因,测试更细的染色质分类。 |
| c | 仅 56 个位点微调后全基因组预测 b 的类别,检验向未训练位点泛化。 |
| d | 用心肌分化数据区分长程/短程 TF,检验模型的另一调控属性预测。 |
a/b 都是基因层面的 ROC,但问题逐步变难:从双价与未甲基化的差别,到双价与只有 H3K4 甲基化的差别。双价状态还带 H3K27 抑制标记,表达上下文必须区分更接近的调控状态。c 只用 56 个位点微调、再预测全基因组该类别,AUC 为 0.78;它把“少量标签能否迁移”与训练位点拟合分开。d 长程/短程 TF 分类更换标签体系,检查表示能否超出一种染色质任务。a/b/d 的图例显示五折结果的标准误,说明作者比较的是可重复的分类能力。这里输出都是类别分数,模型没有从 RNA 直接重建某个位点的组蛋白浓度。
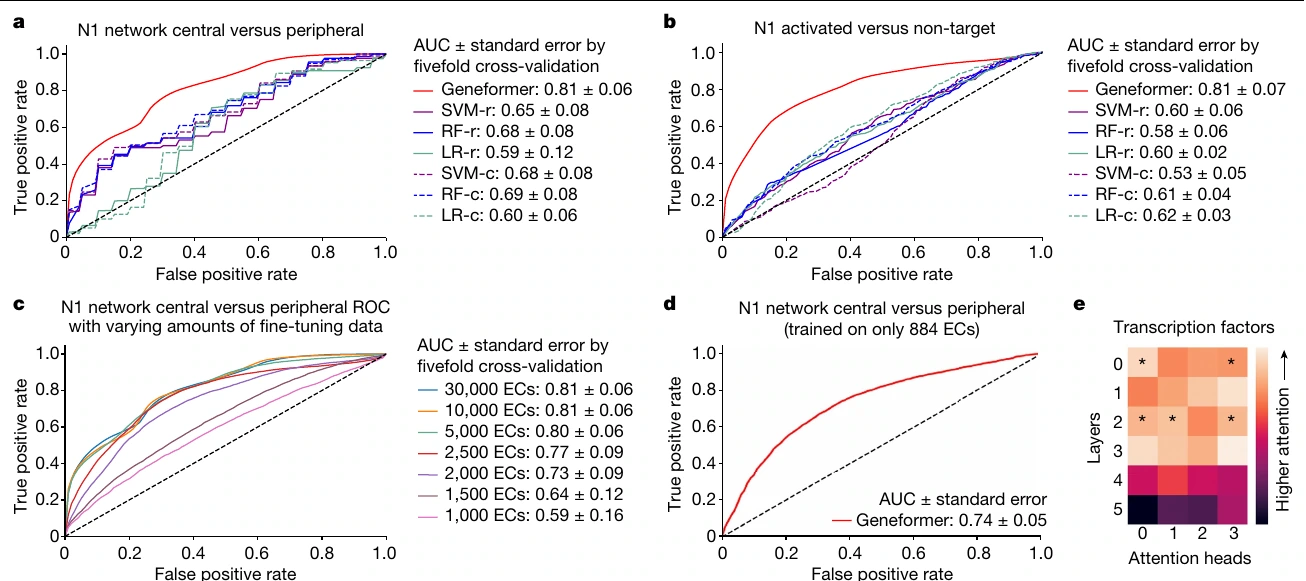
Figure 4:基因网络层级
原图来源:所用 PDF 文件第 6 页,Figure 4。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 在 NOTCH1 依赖网络中区分中心/外围基因,比较 ROC。 |
| b | 识别 NOTCH1 激活靶基因,测试调控网络成员属性。 |
| c | 从约 30,000 缩减到 1,000 细胞,比较中心/外围区分能力,检验小数据表现。 |
| d | 用仅 884 个更相关的主动脉内皮细胞预测,同更大却较不相关资料比较,强调数据相关性。 |
| e | 自监督注意力中 TF 更被部分头及早层关注,提示模型形成了 TF 类别相关的注意力偏好。 |
a 先用已有 NOTCH1 网络标签区分中心和外围基因,b 再区分其激活靶与非靶:一个测试节点在网络中的地位,一个测试是否属于响应集合。c 的横轴仍为假阳性率,多个 ROC 对应从 30,000 到 1,000 个内皮细胞的训练规模;d 则只有 884 个主动脉内皮细胞,AUC 0.74,问更贴近任务的少量背景能否替代较不相关的大样本。两种消融让“数量”和“相关性”分开。e 热图横轴是四个注意力头、纵轴是六层,颜色显示 TF 被关注的程度,TF 偏好主要出现在部分早层。它说明模型内部有可检查的结构分工,不能将每一格注意力值直接读成 TF 的调控效应大小。
Figure 5:计算删除揭示网络联系
原图来源:所用 PDF 文件第 7 页,Figure 5。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
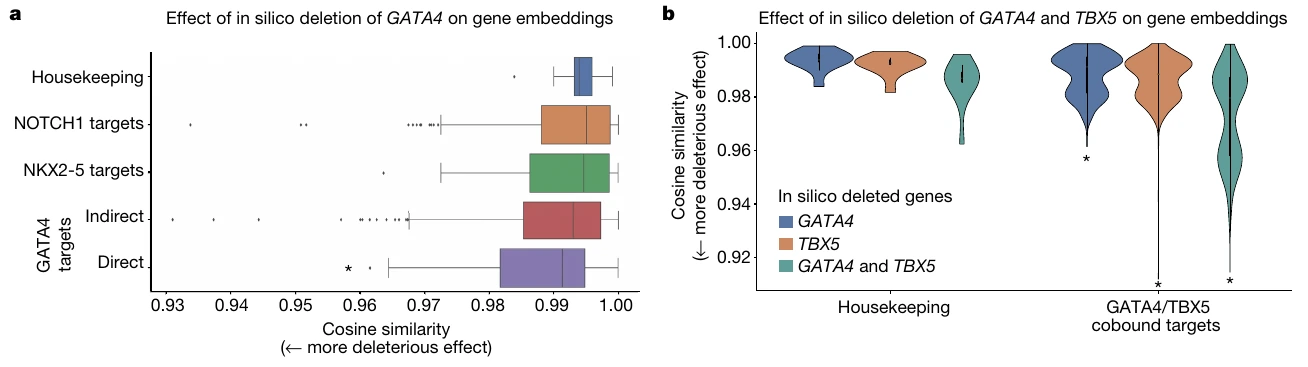
| a | 删除 GATA4 后比较已知直接靶、间接靶、其他 TF 靶及管家基因的表示影响;直接靶更敏感。 |
| b | 分别和联合计算删除 GATA4/TBX5,联合对共同结合靶的表示影响超过单独效应之和,提示模型保留了与两因子协作相关的上下文。 |
a 实际画的是删除 GATA4 后各类基因表示的余弦相似度,横轴越向左改变越大。直接靶比间接靶更敏感,而 NOTCH1/NKX2-5 靶和管家基因提供“并非所有基因一起变”的对照。直接靶来自既有 ChIP–seq,与模型表示的来源不同,使特异性有外部参照。b 对 GATA4、TBX5、联合删除分别计算,共同结合靶在联合删除下变化更大,管家基因却维持较高相似度。这种设计检验模型是否保存两因子协作的上下文,而不只是两个名字各自重要。图里的非加性是表示空间中按作者度量得到的现象,下一步最合适的是选共同靶做真实单/双扰动,而非把相似度差直接称为表达倍数的遗传交互。
Figure 6:计算治疗与实验靶点验证
原图来源:所用 PDF 文件第 8 页,Figure 6。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
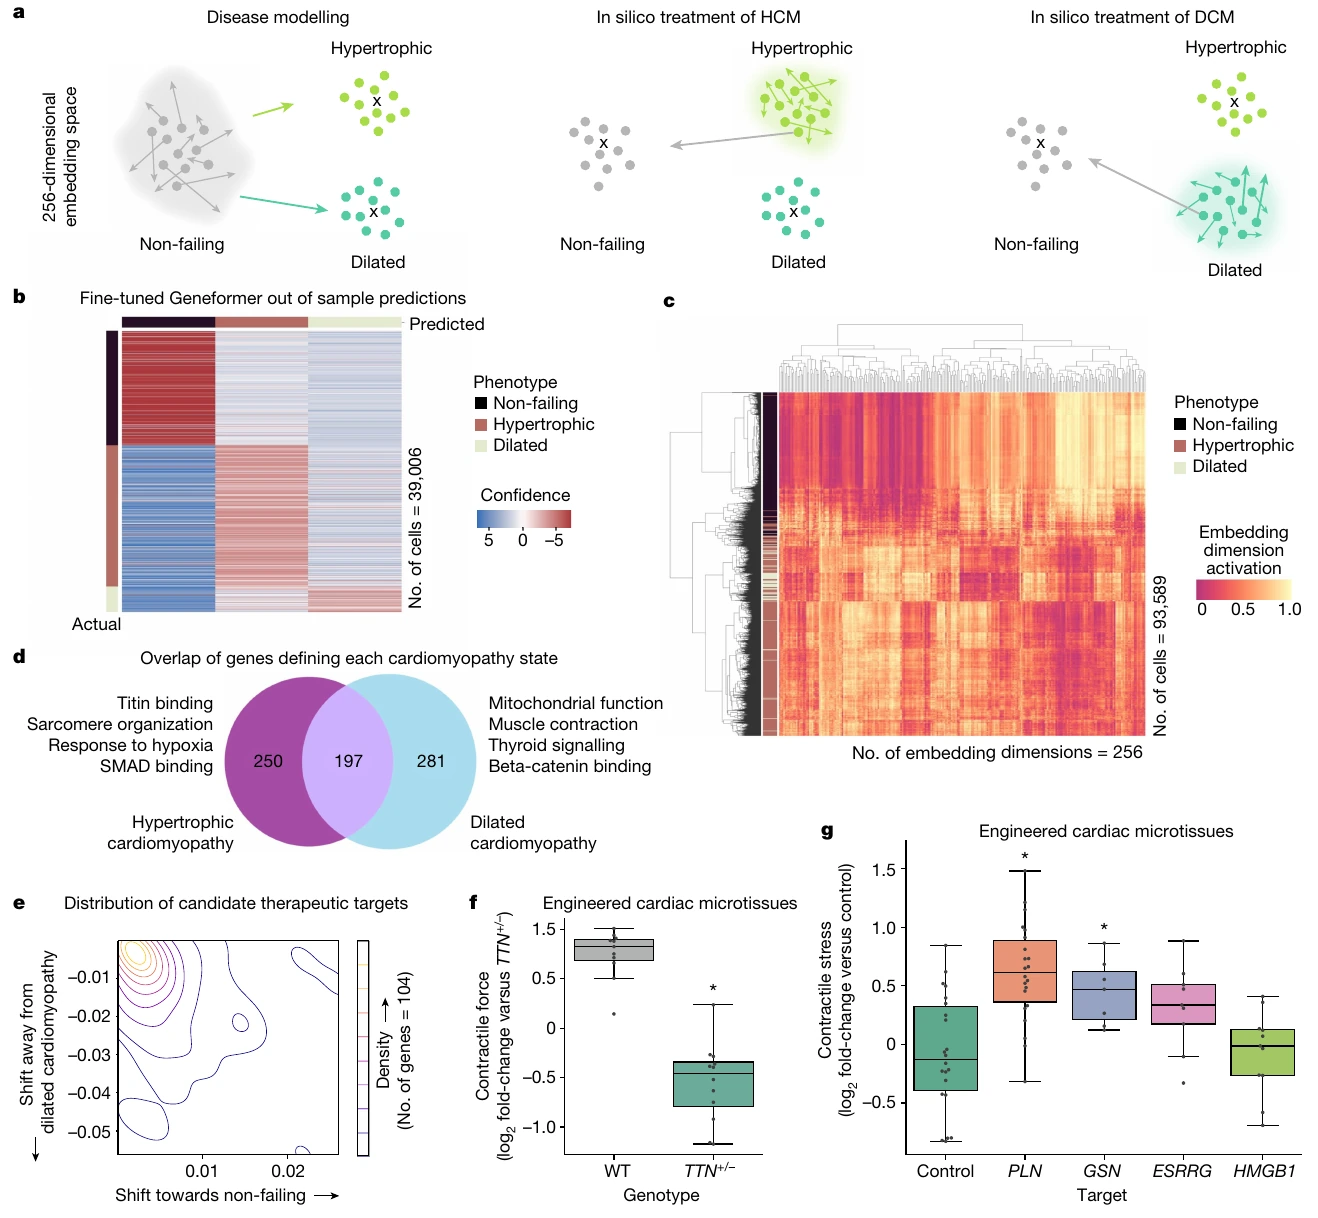
| a | 疾病/健康细胞嵌入定义状态;计算删除或激活寻找将健康移向疾病或将疾病移向健康的候选基因。 |
| b | 留出患者上分类非衰竭、肥厚及扩张心肌病细胞,评价模型是否捕捉疾病状态。 |
| c | 微调细胞嵌入的层次聚类,展示状态之间的组织关系。 |
| d | 把健康细胞计算删除后趋向两种心肌病的基因交集与 GO 富集比较,解释病理相关网络。 |
| e | 肥厚心肌病中候选治疗靶点删除导致的平均嵌入位移,按趋向健康方向优先排序。 |
| f | 野生型与 TTN 截断 iPSC 心脏微组织收缩力对比,确认扩张型心肌病实验模型。 |
| g | 在 TTN 截断模型删除 PLN、GSN、ESRRG、HMGB1 等预测靶点并测量收缩应力。PLN 和 GSN 删除显著改善单位面积收缩力;ESRRG、HMGB1 未显示同样的显著救援,因此不能把所有候选都视为已验证治疗靶点。 |
a 给出完整筛选算法:先用患者标签定义健康、肥厚和扩张状态,再扰动输入,看细胞表示朝哪种状态移动。b 的留出患者分类回答表示能否在新患者区分状态,c 的 256 维表示聚类补充显示其组织结构。d 将计算删除后从健康趋向两类疾病的基因集合比较,447 和 478 是候选规模、197 是交集,GO 用于解释它们的程序差异。e 两个轴分别显示朝非衰竭与朝扩张状态的移动,候选的价值来自方向而不只是“移动很大”。f 用 TTN 截断微组织确认功能低下,g 才实际删除候选并测量同一收缩终点:PLN、GSN 显著改善,ESRRG、HMGB1 未表现同样显著救援。整个证据链因此有可失败的最后一环;患者分类、潜空间方向和真实生理救援是三种不同证据。
我的理解与可迁移设计
可迁移的是让模型推荐之后接受有失败可能的独立实验,而不是把所有候选都写成治疗靶点。AD 细胞嵌入可帮助筛选状态相关基因,但尸检病例/对照差异可能包含病理、组成、年龄和技术因素;必须按供体留出并说明终点。若目标研究 DNA 或 TE,仍需把位点、真实靶基因和等位效应连接起来,表达 token 删除不能替代 DNA 编辑。首轮固定表征、建立简单基线,再验证一个明确分子读出,比直接用潜空间方向宣布抗 AD 干预更可执行。
