13.NucleotideTransformer:原图、模型逻辑与研究范式

13.NucleotideTransformer:原图、模型逻辑与研究范式
Perry论文题名: Nucleotide Transformer: building and evaluating robust foundation models for human genomics
期刊与年份: Nature Methods,2025。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Nature Methods,2025;以当前 PDF 为准。
研究瓶颈怎样转化为问题
专用模型往往需要每个任务各自的大量实验标签,数据少时难以复用已学规律。Nucleotide Transformer 研究的是未经功能标注的 DNA 能否提供迁移表征,并系统比较数据种类、参数量、层选择和适配方式。依据设计逻辑推断,其 idea 不只是把语言模型名字移到 DNA,而是让大规模自然序列预训练降低下游标签需求,再用统一协议判断何时值得迁移。
输入、目标与结构
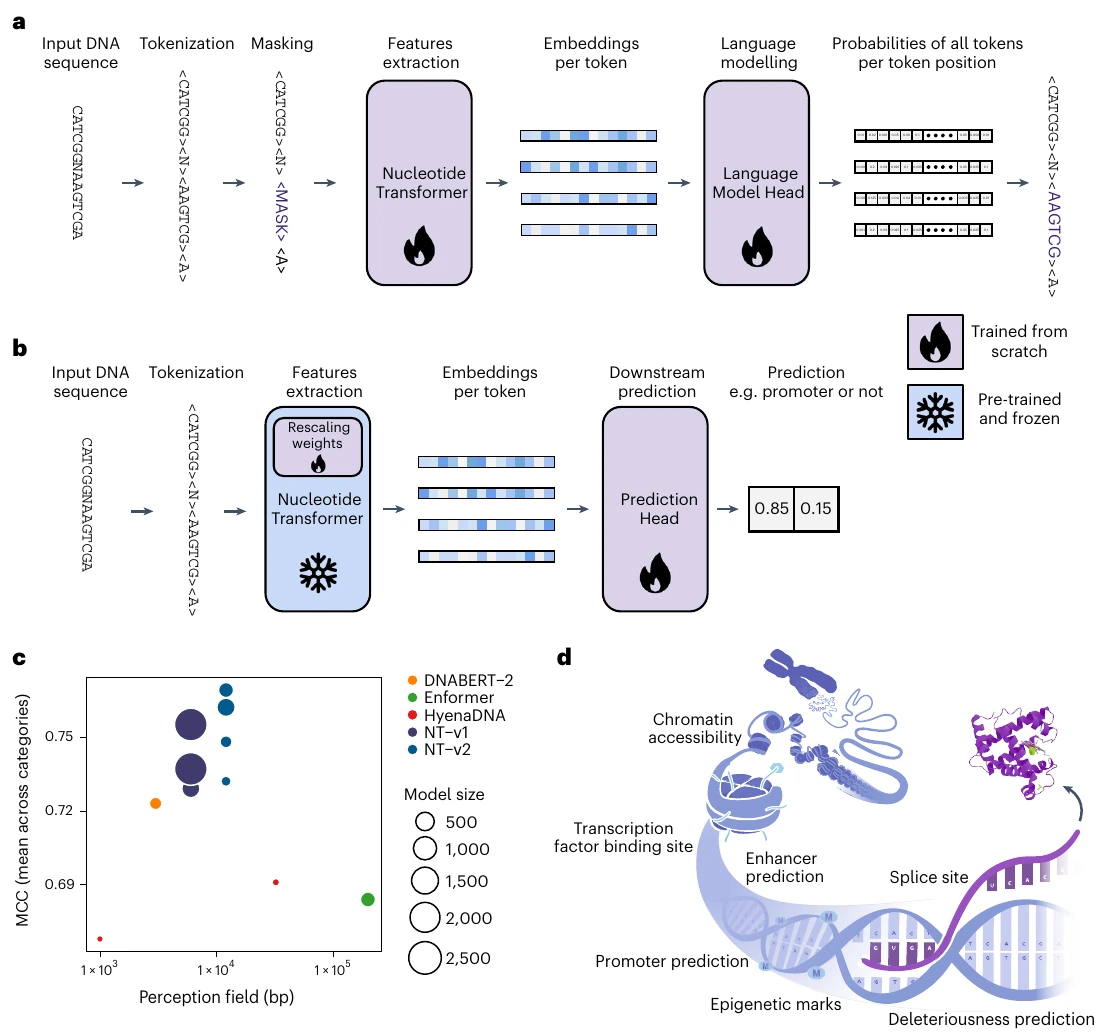
DNA token 的掩码预测促使 Transformer 学习上下文。训练来源包括参考人基因组、3,202 个人基因组和 850 个不同物种;模型从 50M 到 2.5B,并有后续高效 v2。下游 probing 用冻结层嵌入训练小模型;参数高效微调加入约 0.1% 可训练适配参数和任务头,原主体冻结但有效表示发生变化。二者不可混称完全相同的固定特征方案。基因组标签、连续增强子活性、剪接及疾病排序是不同目标,预训练本身不提供真实变异效应标签。
Figure 1:训练与任务设计
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | DNA 切分为 token,掩码预训练 Nucleotide Transformer,学习序列上下文。 |
| b | 在下游任务添加预测头,以参数高效微调训练重缩放权重;预训练主体权重保持冻结。与只读取固定嵌入的 probing 相比,少量任务适配参数使表示更适合目标任务。 |
| c | 按参数量、感知范围及 18 个任务性能比较不同基因组基础模型,展示容量和上下文的权衡。 |
| d | 示意启动子、增强子、外显子和剪接位点等下游标签在基因组中的含义。 |
a/b 明确无监督预训练与有监督任务适配的界线,c 将规模、感知范围和性能放一起,帮助避免只按参数量选模型。d 提醒任务标签来源不同:启动子身份与 enhancer 连续活性不是一个终点。比较还必须检查原始序列切分、重叠窗口和同源关系;十折验证如果保留高度相似序列跨折,可能高估未见基因组区域的能力。
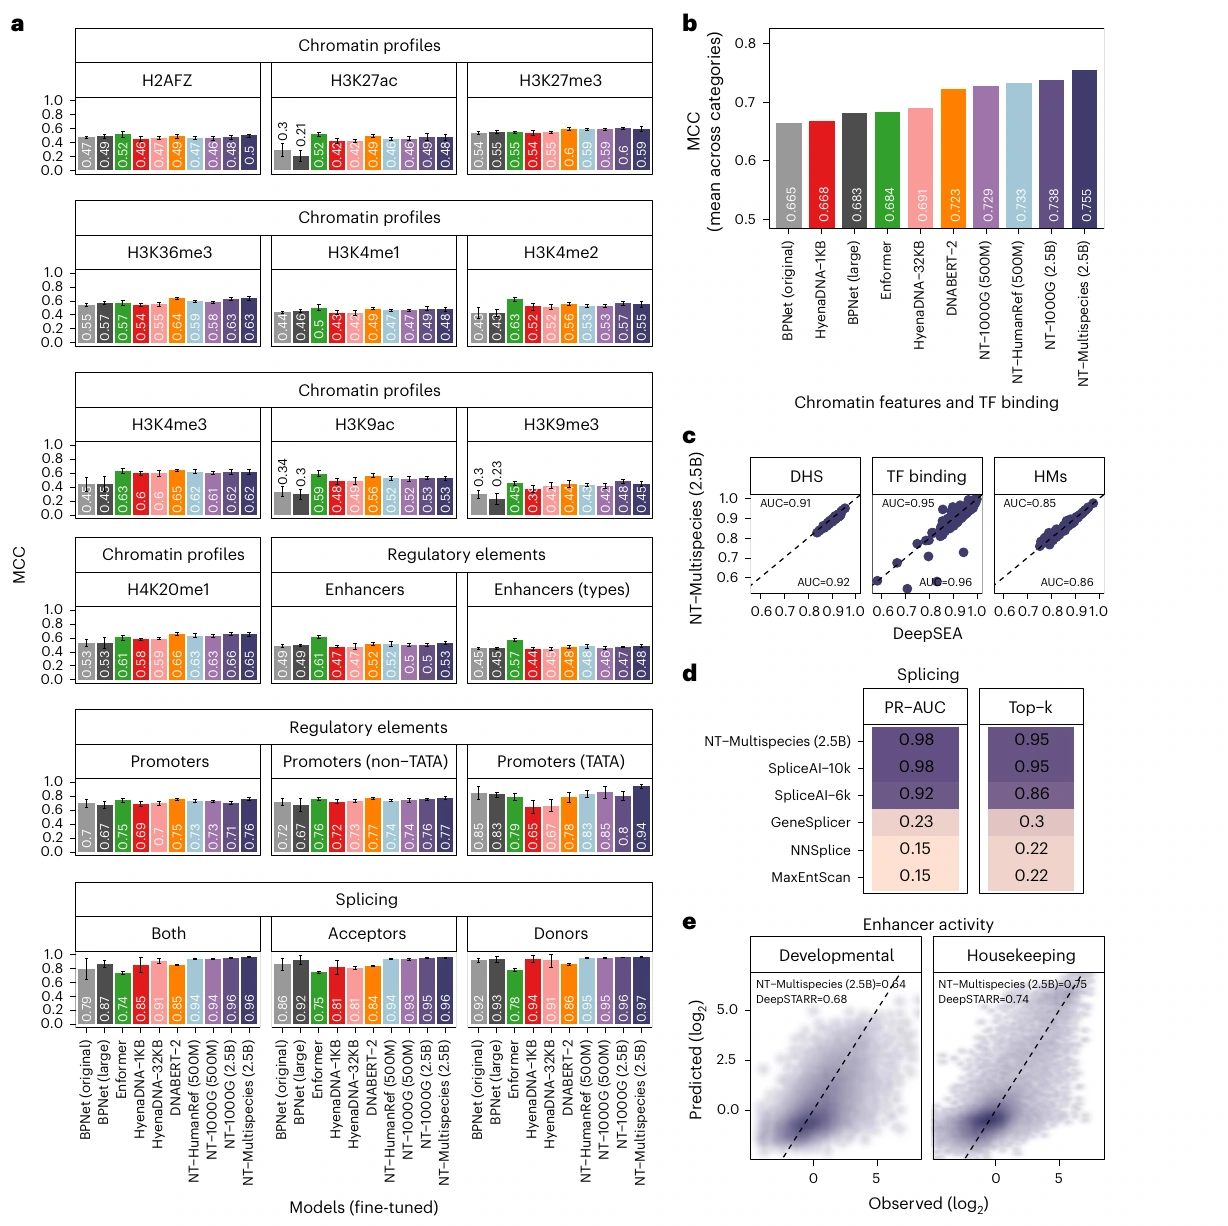
Figure 2:不同任务的微调性能
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 用 MCC 比较多个 NT、其他预训练模型及从头训练 BPNet,误差来自十折交叉验证。 |
| b | 按任务类别汇总标准化平均 MCC,多物种 2.5B 在该 18 任务基准中总体最好。该比较采用同一微调和交叉验证协议,结果说明多样序列预训练有利于迁移。 |
| c | 多物种 2.5B 模型与 DeepSEA 比较 DHS、组蛋白及 TF 结合逐轨迹 ROC-AUC;NT 的平均 AUC 约低 1 个百分点,显示接近专用模型但并非全面超过。 |
| d | 比较碱基级剪接位点预测;NT 的 top-k 准确率为 0.95、PR-AUC 为 0.98,接近 SpliceAI-10k,并优于图中较短输入的 SpliceAI-6k。 |
| e | 比较果蝇发育/管家增强子活性预测与 DeepSTARR:发育型相关性为 NT 0.64、DeepSTARR 0.68,管家型为 NT 0.75、DeepSTARR 0.74。结果显示迁移模型接近专用模型,优势因任务而异。 |
统一 MCC 基准对模型总体能力有用,但专用任务必须看 c–e 的直接比较。NT 并未全面优于 DeepSEA/DeepSTARR,发育型和管家增强子结果方向不同;这使结论更具体。剪接表现与上下文长度、碱基头结构有关,不能只归因于自监督。预训练数据多样性和微调均可能贡献收益,新研究应把简单 CNN、固定特征小头和适配模型放在同一位点切分下。
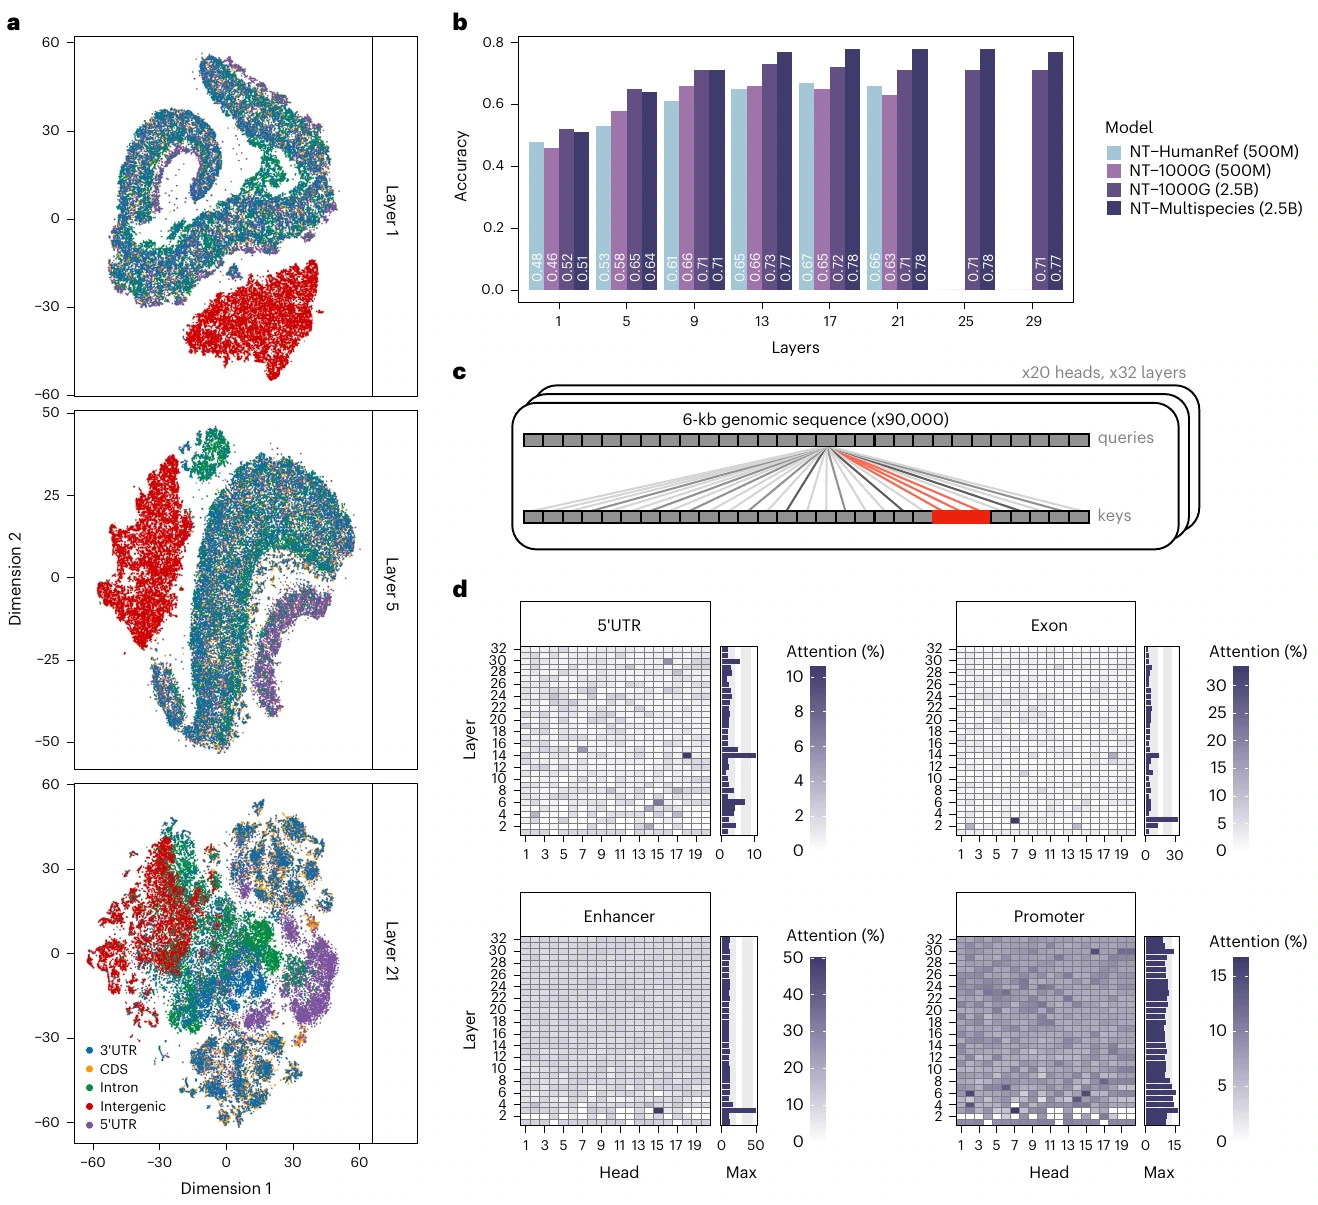
Figure 3:模型表征中的基因组知识
原图来源:所用 PDF 文件第 6 页,Figure 3。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 不同层嵌入的 t-SNE 展示五类元素分离程度,说明表示随网络深度变化。 |
| b | 逐层探测五类元素分类准确率,验证视觉分离对应可读取的信息。 |
| c | 图示计算模型对某类元素的注意力比例的方法。 |
| d | 按层和注意力头显示 5′ UTR、外显子、增强子、启动子的关注比例;不同头偏好不同元素。 |
t-SNE 分离是可视化,b 的逐层探测才检验信息是否能被读取;注意力偏向某元素也不等于其因果机制。正文发现最后一层并非总是最佳下游层,说明语言预测目标与目标功能不完全一致。挑层必须只用训练/验证集,不能在最终实验标签上选出最好层再报性能。注意力头可形成解释假说,仍需突变或其他独立证据确认。
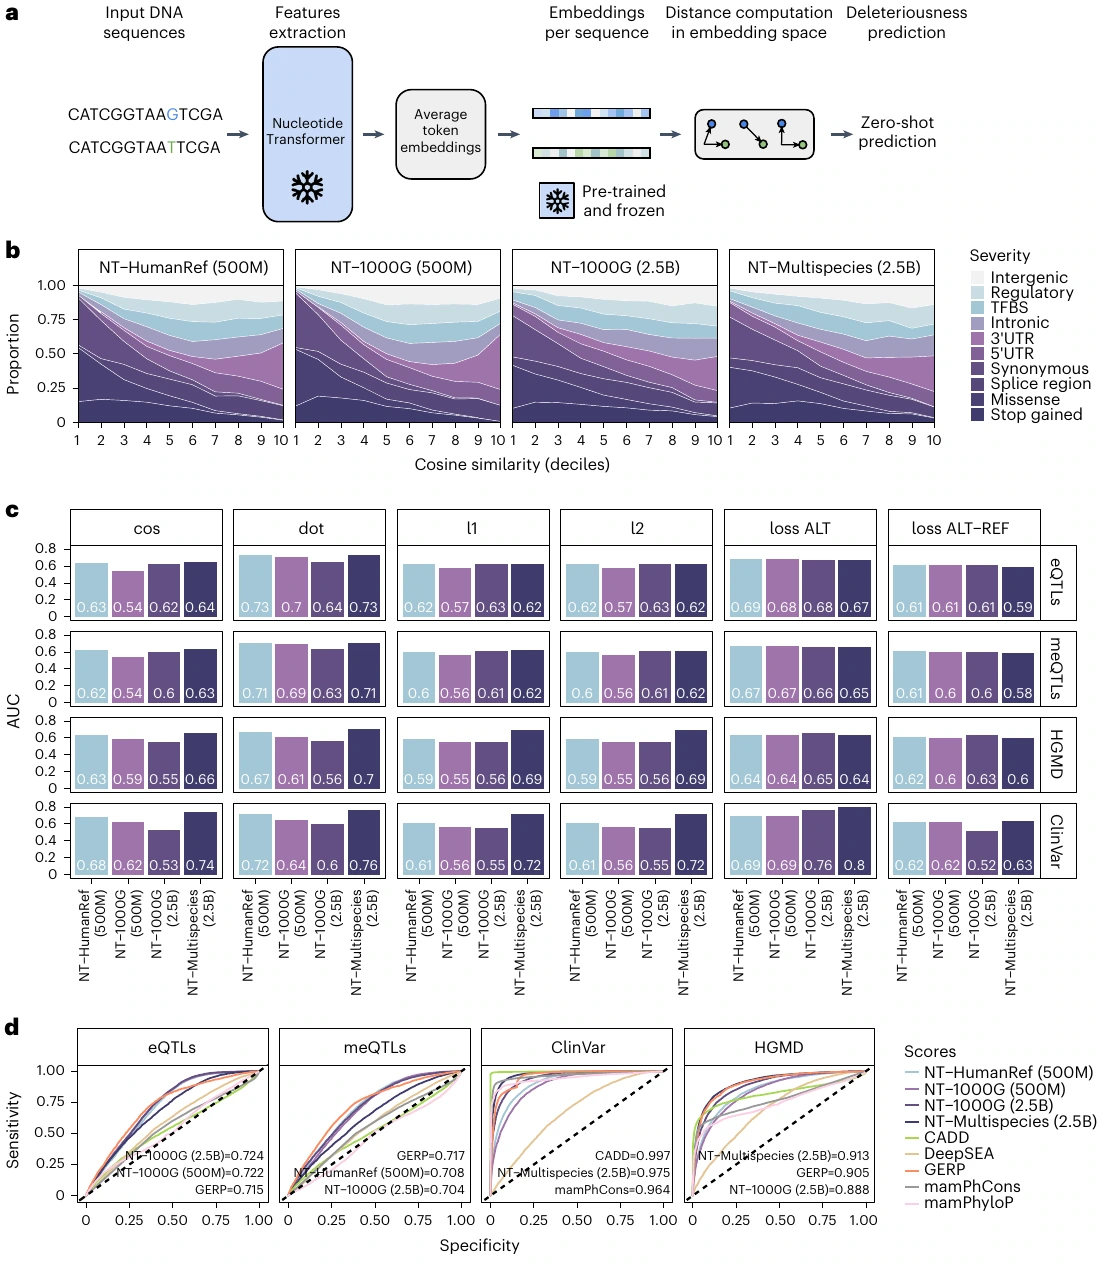
Figure 4:功能变异优先级
原图来源:所用 PDF 文件第 7 页,Figure 4。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 分别输入参考/变异序列,以表示距离作零样本效应分数。 |
| b | 按余弦相似度分数十分位统计变异功能后果;检查大表示差异是否对应更严重后果。 |
| c | 比较不同距离指标的零样本功能变异排序,说明评分选择会影响表现。 |
| d | 在 eQTL、meQTL、ClinVar 和 HGMD 上比较微调及现有方法 AUC,评估预测对表达、甲基化及疾病变异的适用性。 |
REF/ALT 嵌入距离只表示模型感知的变化大小,没有直接指定表达增减。不同距离指标表现不同,说明评分不是自然唯一的。零样本排序与用 eQTL、甲基化或临床标签微调是不同使用方式;HGMD/ClinVar 基准还受收录和基因构成影响。若目标是 MPRA 的带符号 logFC,应直接训练相应输出,不能把余弦距离当作上调/下调标签。
Figure 5:更高效的 NT-v2
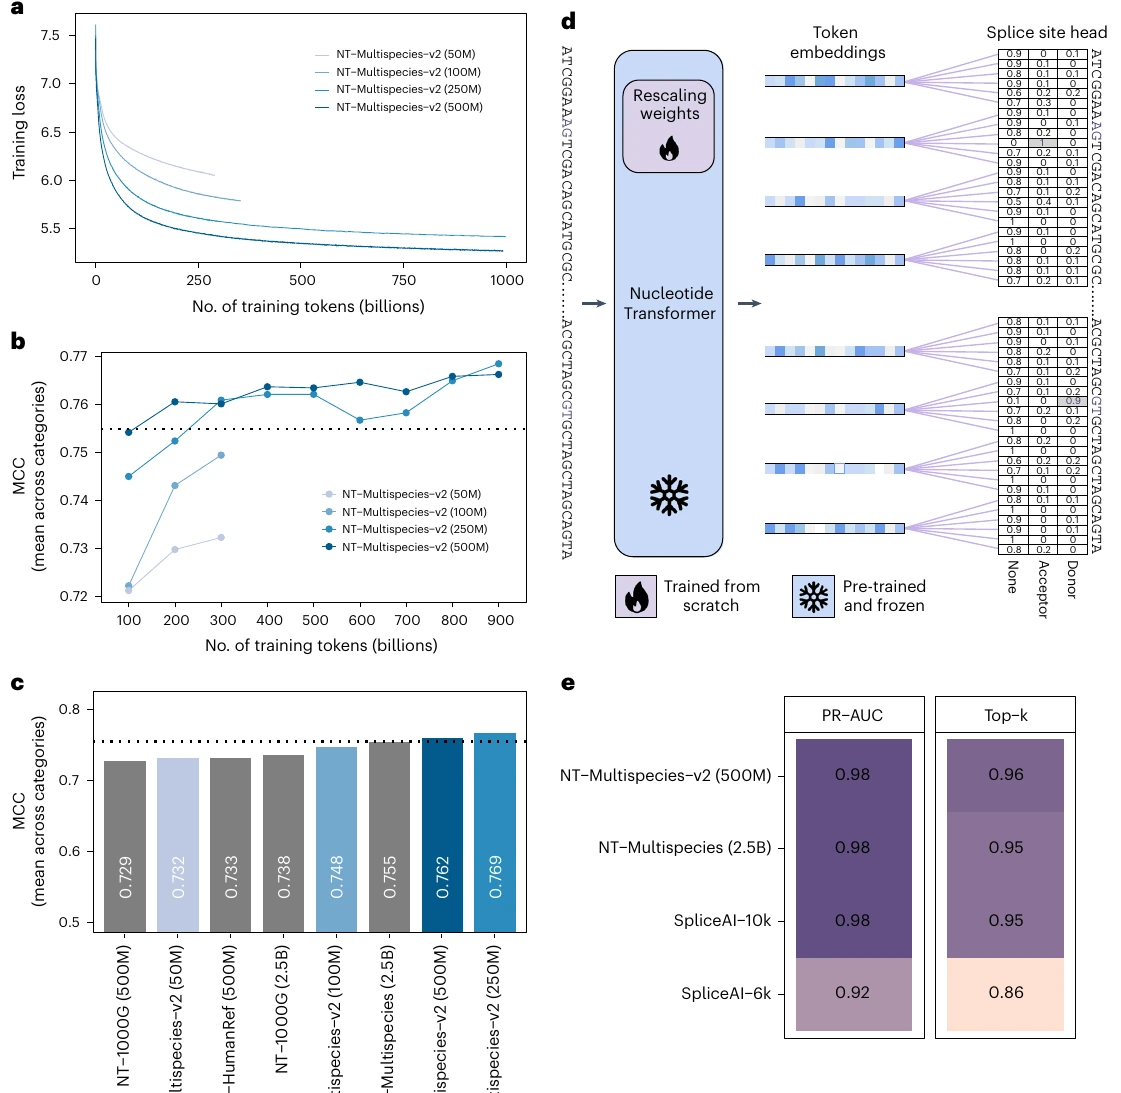
原图来源:所用 PDF 文件第 9 页,Figure 5。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 随预训练 token 数显示训练损失,检查模型收敛与规模效应。 |
| b | 随预训练量显示下游标准化 MCC,联系训练规模与迁移能力。 |
| c | 按类别比较 NT 和参数更少的 v2 微调性能;较高效架构可接近 2.5B 参照表现。 |
| d | 展示碱基级剪接预测微调结构,区分预训练和新训练权重。 |
| e | 比较 500M v2、2.5B 原版和 SpliceAI 的剪接任务,检验缩减参数后的能力。 |
v2 的规模和训练量分析将效率纳入研究问题,参数更少并不等于生物信息更少。损失下降与下游提升要分开看,掩码恢复好未必所有任务都好。e 检验缩减模型的特定剪接能力,而非替代所有 2.5B 用途。真实 16 GB 可行性还取决于序列长度、精度、批量与是否反传,不能仅凭参数量承诺任意微调都能运行。
我的理解与可迁移设计
这篇最适合迁移到有限显存项目的部分是可复用表征与严谨基准。先比较小模型、固定 NT 特征和参数高效适配,再决定是否需要更大模型。AD MPRA 应以整个位点/研究留出,并保持两等位序列成对;同一区域多个替换不能随机散入训练与测试。若研究进化,跨物种预训练可作为数据来源,但性能提升不能直接证明某个 AD 位点经历适应性演化。真正的创新应是新增可检验的标签或问题,而不是只换基础模型。
评估还应保持可计算的分母:分类报告正负样本来源和比例,回归报告带符号误差与幅度校准,不能只选最强效变异获得高相关。预测和标签缺失应分别记录。模型在某个实验上的高分也不会自动为数据库之外的细胞状态提供监督;如果环境配对缺失,宜先做单环境功能预测。
