43.PancreaticCancerPrediction:原图、模型逻辑与研究范式

43.PancreaticCancerPrediction:原图、模型逻辑与研究范式
Perry论文题名: A deep learning algorithm to predict risk of pancreatic cancer from disease trajectories
期刊与年份: Nature Medicine,2023。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: 长期诊断轨迹能否预测胰腺癌风险,模型跨丹麦和美国医疗体系泛化时会怎样?
从零散诊断到风险轨迹
胰腺癌常在较晚阶段被发现,全面检查所有人又成本高且可能产生额外损害。本文不把模型当成影像诊断器,而是用已有病史决定哪些人值得进一步监测。我的推测是,idea来自长期诊断序列携带的组合信息超过少量已知危险因素,以及医疗登记数据已覆盖大量人群。这是引言支持的研究逻辑,不是作者个人灵感史。
监督终点和时间窗口决定“提前”的含义
有限监测名额使评估必须考虑名单大小。选择每百万人中最高风险的一千人和一万人,覆盖的病例与误报都不同,不能以一个富集倍数代替整个策略。论文的相对风险曲线让这个取舍可见,却没有完整测量随后的影像、活检与心理负担。若用该模型设计真正筛查研究,应先固定阈值及后续流程,再检测早期发现比例和健康结果。这是我的下一步建议,不是本文已经实施的临床项目。
输入为诊断代码、时间及相应嵌入,编码器将历史聚合成患者表示,再预测未来不同月份窗口内是否出现胰腺癌。论文比较词袋、MLP、GRU与Transformer,模型较好表现说明病史组合及时间具有信息,但不同排除窗口下最优模型可改变,不能把Transformer视为所有设置的固定赢家。注意力能聚合较远历史,不直接证明网络发现了癌变因果过程。
数据排除窗口尤为重要:训练时删除确诊前最后三、六或十二个月的记录,检验模型是否主要依赖尚未正式确诊癌症的症状。预测窗口则定义从评估时刻到未来多久的风险,两者不能混淆。没有排除的高表现可能对识别临床已出现征象的人有用,但和真正长期预防不是同一个用途。胰腺癌正式诊断时间也不等同于肿瘤生物学起始。
丹麦与美国VA的人群和记录过程差异明显。VA男性比例高、记录更密而历史较短,诊断代码映射相同不能消除这些差别。直接跨系统应用明显下降,本地训练有所恢复,是全文应重点讨论的结果。它把泛化从抽象口号转成实测问题,同时说明训练规模和复杂模型仍不能代替目标人群验证。
模型输出可以富集高风险人群,但研究没有真实实施筛查,也没有测得检查成本、并发症或癌症死亡减少。相对风险受基线患病率、所选人数和预测窗口影响;风险倍数高不必然意味着绝对风险足够高或筛查一定有益。所有监测方案需要在临床中进一步评价。
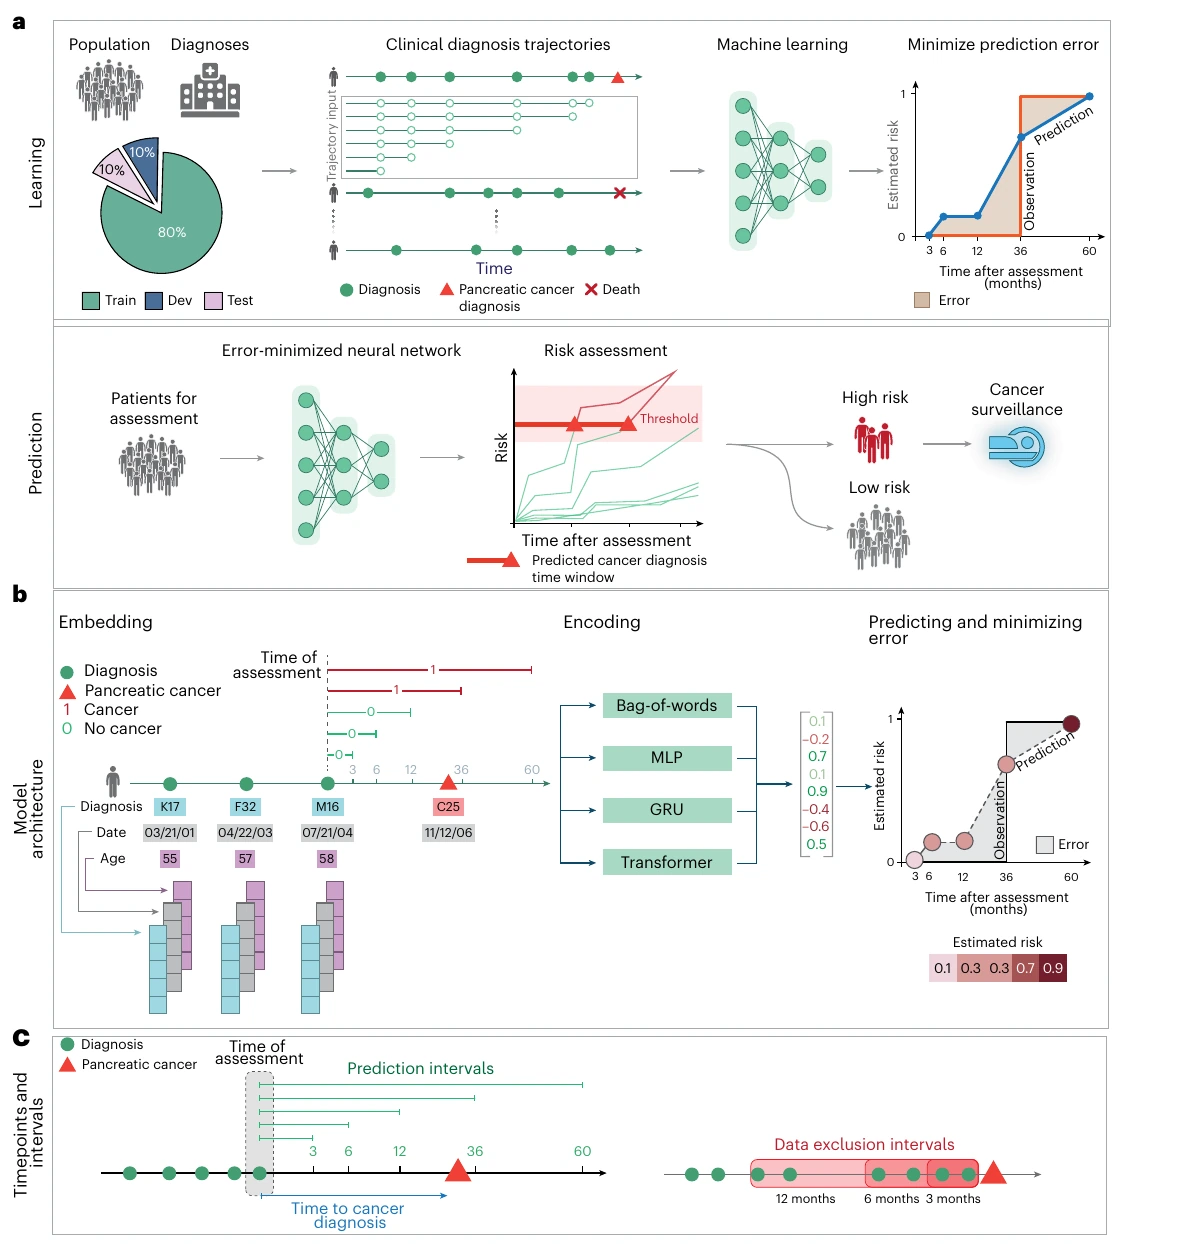
Figure 1|疾病轨迹模型及时间定义
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
图1定义训练样本和时间,避免用患者后续记录解释此前风险。同一个患者可能产生多个历史终点,但患者级拆分是防止轨迹重复泄漏的关键。嵌入、编码和预测三个步骤分别处理代码、组合历史和不同未来窗口。最后的时间示意必须先读清:评估时刻、排除窗口与预测窗口不同。若跳过它,容易把“在确诊前三个月识别症状”说成“提前五年发现癌症”,这是对模型任务的根本误读。
| 子图 | 讲解 |
|---|---|
| a | 按患者划分训练、开发、测试集,使用不同终点的历史诊断子序列学习并评价未来癌症风险。 |
| b | 诊断代码和时间嵌入后由编码器形成患者历史表示,再预测未来 3、6、12、36、60 个月的癌症发生。 |
| c | 区分评估时间、预测窗口和数据排除窗口;删除癌症前最后几个月诊断可检验模型是否只依赖临近癌症的症状。 |
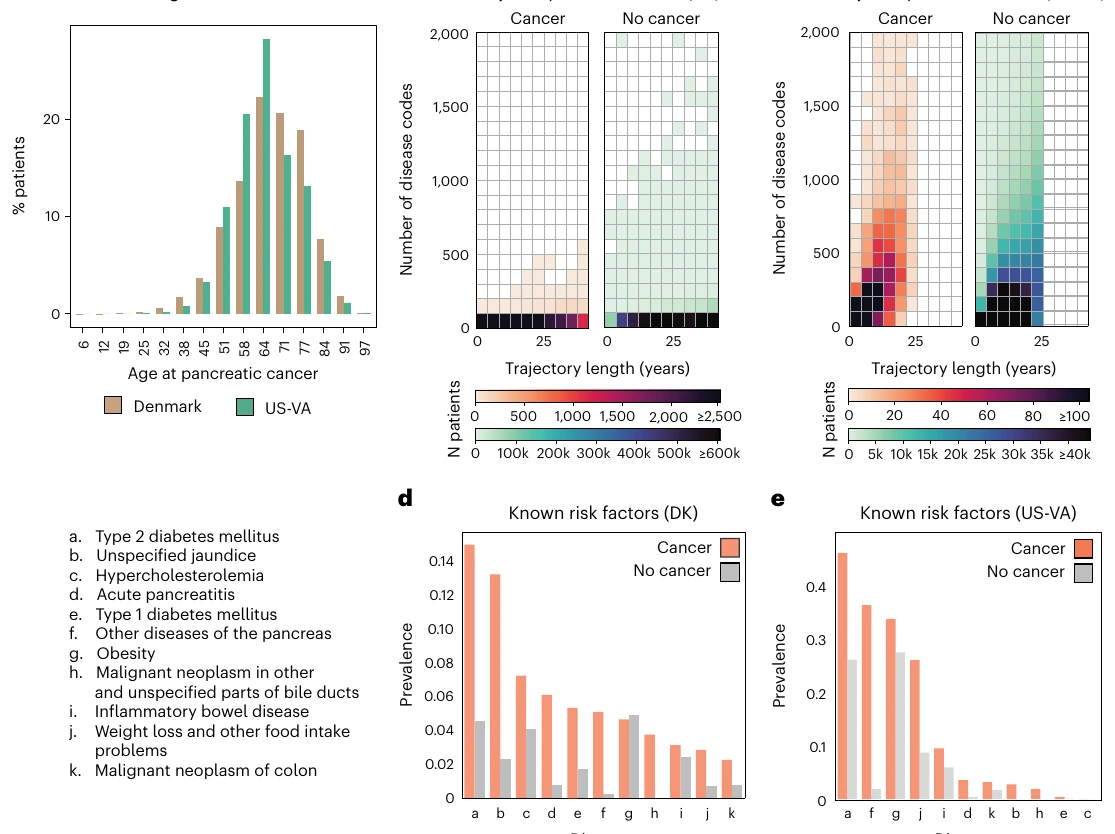
Figure 2|两套医疗数据的不同组成
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
图2不是背景装饰,而是在解释迁移为什么困难。确诊年龄、轨迹跨度、代码数量以及已知风险因素分布都影响网络能学到什么。代码密度可能反映医疗服务使用,而非生物学更复杂;危险因素在癌症组富集也可能含癌症造成的症状。此图提供合理性检查和数据差异证据,却不能独立证明危险因素因果关系。尤其应把两个系统人群组成保留在外部性能解释中,不能只说样本数量不同。
| 子图 | 讲解 |
|---|---|
| a | 比较丹麦和美国 VA 胰腺癌确诊年龄分布,说明人群差异。 |
| b | 丹麦患者轨迹长度与诊断数分布,历史跨度较长、记录相对稀疏。 |
| c | 美国 VA 相应分布,记录密度和历史长度不同,形成迁移挑战。 |
| d | 丹麦癌症与非癌症人群的已知危险因素患病率,检查模型数据是否包含合理风险信号。 |
| e | 美国 VA 的同类比较,观察两个医疗体系共有与不同的疾病背景。 |
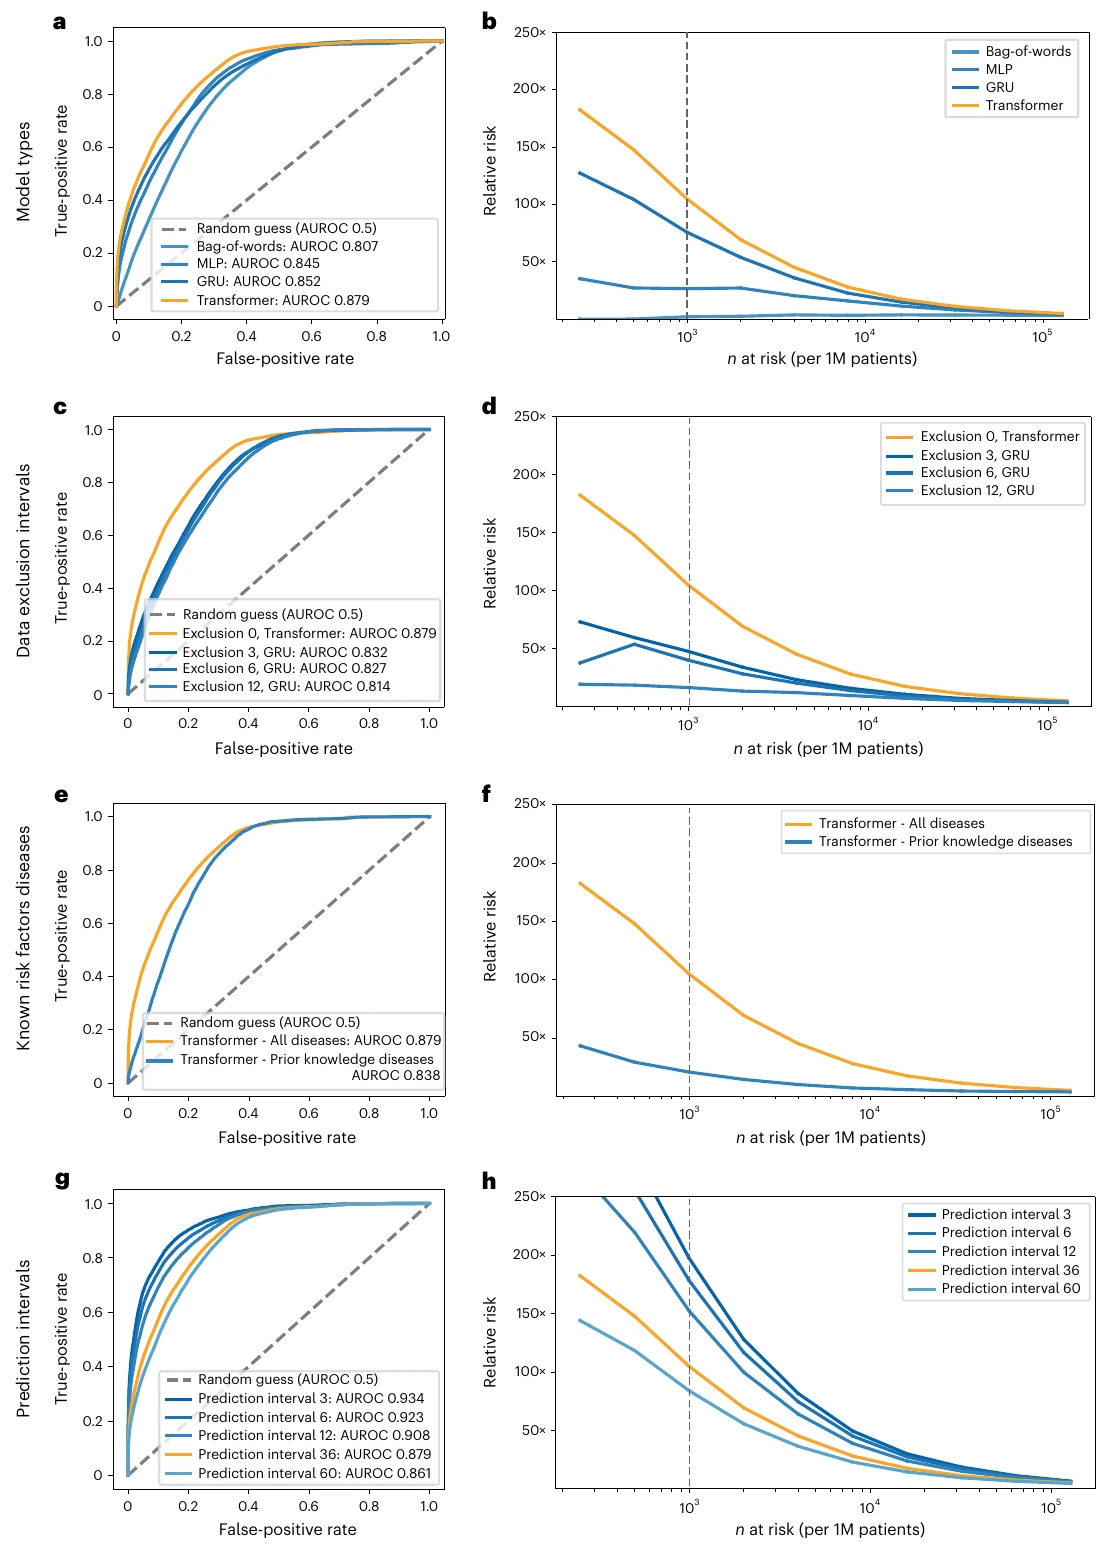
Figure 3|算法、输入和时间窗口的影响(实图 PDF 第 6 页;图注第 5 页)
原图来源:所用 PDF 文件第 6 页,Figure 3。点击图片可查看原图。
图3的多个对照分别检验架构、输入、临近记录与时间跨度。全诊断优于23个已知因素说明更多病史有增量,却不告诉我们增量全是新的癌症机制。删除近诊断信息后性能下降,显示症状信号贡献很大;最高风险相对风险也下降,将AUC变化接到监测用途。较远期窗口更难,应与更早行动的潜在价值权衡。四组曲线是在同一研究任务下比较,不可拿一个最优AUROC覆盖所有设置,尤其正文与个别图中文字数值略有差异时,应沿具体面板解释。
| 子图 | 讲解 |
|---|---|
| a | 比较算法 AUROC,Transformer 在无排除、36 个月窗口时最好,AUROC=0.879。 |
| b | 比较各算法挑出的最高风险人群相对风险 RR,把整体排序性能转为筛查人群的富集程度。 |
| c | 排除癌症前 3、6、12 个月记录后 AUROC 下降,说明临近诊断信息贡献很大。 |
| d | 同一排除实验的最高风险人群 RR;例如前 1,000 人的 36 个月 RR 从全数据约 104.7 降至排除 3 个月约 47.6。 |
| e | 使用全部约 2,000 个 ICD 代码比只用 23 个已知危险因素的 AUROC 更好。 |
| f | 同类输入比较的 RR 曲线说明完整病史有助寻找高风险亚群。 |
| g | 比较不同预测窗口 AUROC;越远期预测越难。 |
| h | 不同预测窗口的最高风险 RR,显示窗口和筛查人数共同决定风险富集。 |
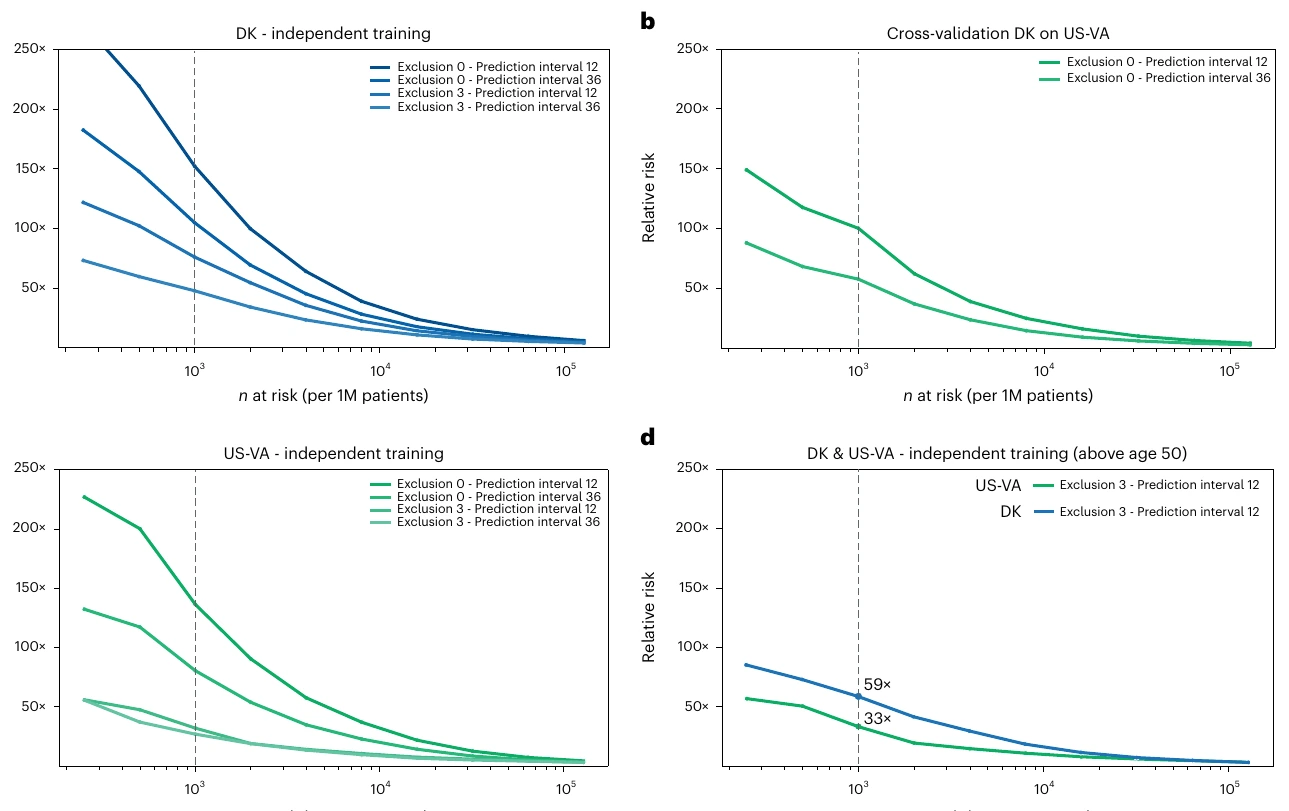
Figure 4|不同医疗体系的潜在监测策略
原图来源:所用 PDF 文件第 7 页,Figure 4。点击图片可查看原图。
图4的关键是丹麦模型直接转到VA后降低,本地重训才改善。外部应用是新医疗过程的测试,本地重训则是另一个模型,不能把重训成绩说成原模型零样本泛化。超过五十岁、排除三个月、预测十二个月的方案是模拟选择,较贴近可讨论的监测场景,但还缺真实检查负担和受益估计。富集率提供候选策略依据,不能自动转成筛查建议,更不能保证高风险名单都是早期可治病例。
| 子图 | 讲解 |
|---|---|
| a | 丹麦独立训练模型的 RR 曲线,比较排除 0/3 个月及未来 12/36 个月预测。 |
| b | 将丹麦模型直接用于美国 VA,RR 下降,显示跨系统迁移需本地验证。 |
| c | 美国 VA 独立训练模型的对应策略比较,本地训练改善其适用性。 |
| d | 限 50 岁以上、排除最后 3 个月、预测 12 个月的示例策略,比较两系统各自训练后的高风险富集;这是估算而非已实施筛查试验。 |
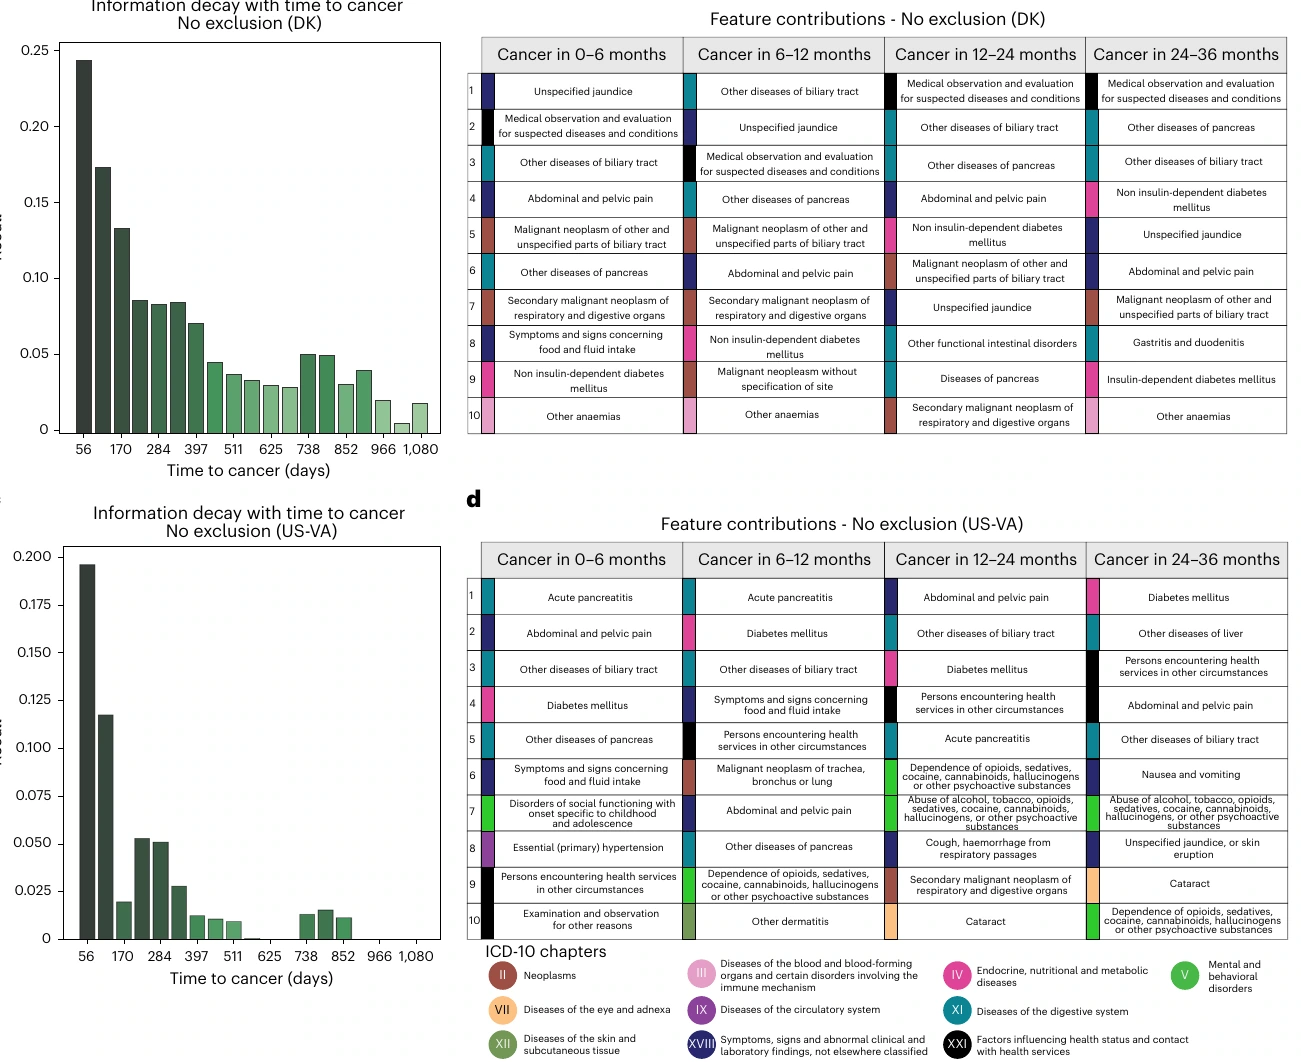
Figure 5|长期预测与重要诊断特征
原图来源:所用 PDF 文件第 8 页,Figure 5。点击图片可查看原图。
图5把长期预测与重要特征放在一起。距癌症更远时召回下降,说明模型仍有信息却漏掉大量未来病例。贡献排序随提前时间变化,临近的黄疸、疼痛等与较远期病史承担不同角色。Integrated gradients解释模型依赖,而非诊断导致癌症的效应;代码相关和就诊过程可能分配或替代贡献。丹麦与VA不同的排序进一步提示数据环境,值得用作下一轮验证假说,不宜直接命名为新的致癌通路。
| 子图 | 讲解 |
|---|---|
| a | 丹麦数据在 F1 操作点下,召回率随距癌症时间增加而下降;较远病史仍有信息,但敏感度较低。 |
| b | 丹麦不同提前时间段前十贡献诊断,用 integrated gradients 指出模型关联的疾病特征。 |
| c | 美国 VA 的提前时间–召回率关系,检验另一系统的远期预测能力。 |
| d | 美国 VA 的特征贡献排序,与 b 比较共有风险因素及系统差异;贡献分数不是疾病导致癌症的因果证明。 |
依据:对应主图、完整图注及正文 Results;实验结果只按本文给出的对象和条件解释。
可迁移到AD的思路
我从本文得到的首要设计是设置明确的时间排除实验。若AD风险研究希望发现临床症状前的信号,应排除靠近诊断的变量,或在独立、较早采样数据中检验。若使用的是尸检数据,则更适合解释终末病理关联,不能因为模型性能高便宣称已经预测病程起始。
第二个启发是对预测目标保持分层。全人群AUC、高风险子群富集与临床筛查获益不相等。组学项目也有相似层级:细胞分离、donor病理关联与机制干预结果分别回答不同问题。一个TE模块能分离细胞类型,未必能识别患者,更未必是病因。
在16GB显存上,缩小词表和序列长度的Transformer或GRU并不是主要障碍,受控临床登记与长期终点才是。纯公共数据路径可以借鉴严格留出、简单基线、排除信息和外部迁移的评估方式,不必直接复制受限数据项目。跨脑区或队列下降应主动展示,它能说明方法适用条件并形成改进问题。
最后,特征归因可帮助生成假说,但应拿独立文献、遗传或扰动数据检验。我会将已知因素与新提名因素分别报告,检查新因素是否仅增加记录密度或年龄信息。真正的创新可能在一个更干净、可行动的时间窗口内,而不是在所有记录混合后获得更高的数字。
