40.CARGrammar:原图、模型逻辑与研究范式

40.CARGrammar:原图、模型逻辑与研究范式
Perry论文题名: Decoding CAR T cell phenotype using combinatorial signaling motif libraries and machine learning
期刊与年份: Science,2022。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: CAR 胞内信号基序如何组合决定细胞杀伤与干性,能否通过模型预测再设计更好的 CAR?
把天然信号域拆成可组合的部件
CAR T设计常直接采用CD28或4-1BB等完整天然共刺激域,但天然域并非专为工程目标优化。本文把信号基序视为可组合部件,问顺序、位置和组合能否同时改善杀伤与干样状态。根据文章逻辑,可以推测idea来自天然域选择有限与组合空间庞大的矛盾:实验测少量有代表性的组合,再让模型提取设计规则。这是研究动机的解释,并非作者灵感过程的事实记载。
小实验库怎样支持监督回归
持续刺激本身是研究设计的重要组成。一次短期刺激可能把强激活当作好表型,四轮挑战则让杀伤持续性和干样细胞保留进入同一个比较。这个选择改变标签的生物含义:网络学习的是经历该刺激历史后的输出,不是基序在任何时间点的固定功能。若训练只来自一种抗原密度和肿瘤细胞背景,外部环境改变可能改变组合排名,所以后续工程需要关注标签条件而非只关注输入结构。
成对部件与位置分析还不能简单等同于统计上的严格相互作用效应。某个成对组合高排名,可能同时受到第三部件和可出现的位置影响;若要量化非加性,应设计控制其他部件的成对实验,或将加性预测与完整模型在相同留出上比较。本文的分布分析更适合产生可验证设计规则,后续修改实验再提供功能依据。这一层次使“组合语法”既有直观解释,又保持在所采样空间内,不至于从相关排名跳到普遍分子定律。
作者整理12种信号基序加一种间隔部件,构建含一到三个部件的2379种组合,固定抗CD19外部识别部分及CD3ζ信号背景。阵列实验对每个CAR单独测试,避免混池时旁分泌互相影响;用四轮Nalm6刺激模拟持续挑战,测杀伤和IL7Rα阳性、KLRG1阴性比例。干样标志是表型代理,不等于已经直接测定所有自我更新或长期记忆功能。
221个组合用于训练、25个留出测试,神经网络从部件身份及位置预测两个连续表型,再对完整组合库推断。它是小样本监督回归,所谓“语法”是组合、搭配及顺序效应的类比,不是大语言模型从海量蛋白语料生成全新CAR。固定部件库使问题可控,也使适用范围限定于这些部件、识别抗原和培养背景。
模型适合捕捉非线性的组合效应,但2379个预测不是2379个独立实测样本。由预测排名提取的规则仍可能反映模型误差,十个网络平均改善数值稳定性,也不能替代生物重复。真正重要的验证是把规则移到天然4-1BB与CD28背景、合成修改结构并重新实验,检查预测是否对新设计成立。
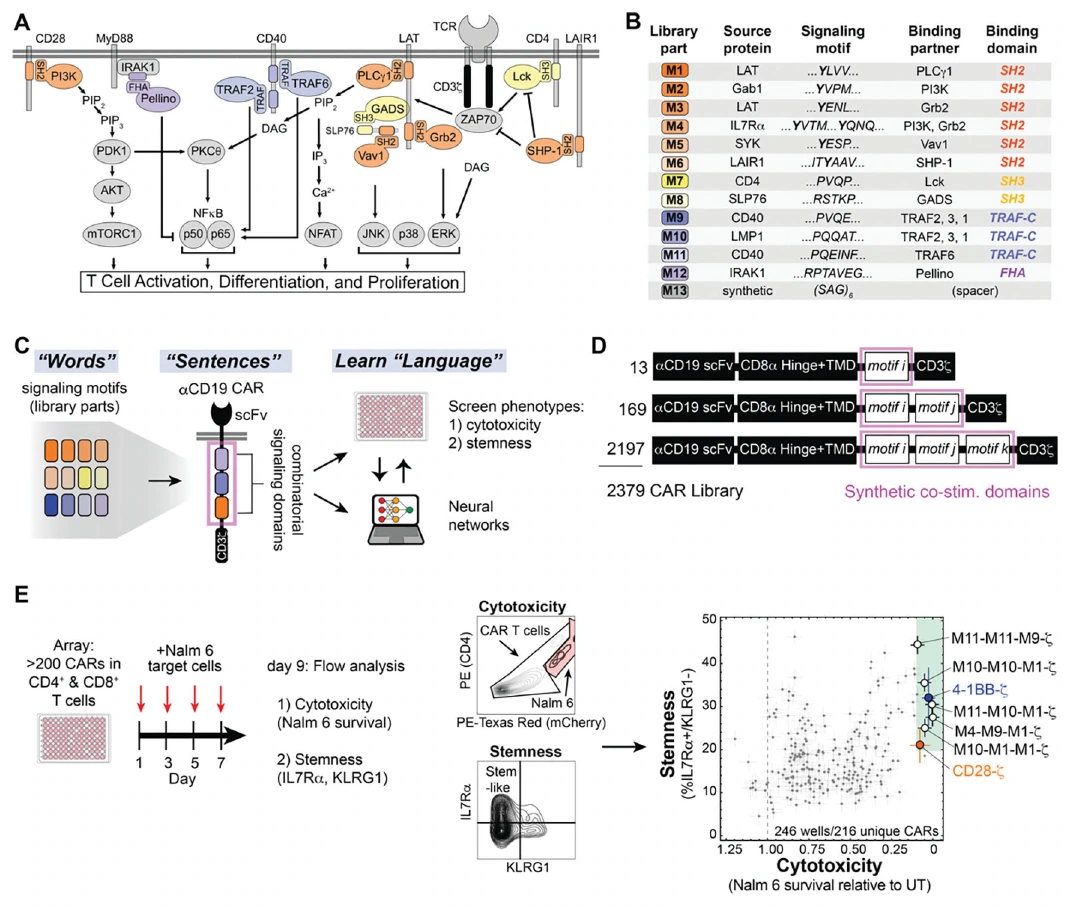
Figure 1|组合信号基序产生多样 CAR T 表型
原图来源:所用 PDF 文件第 10 页,Figure 1。点击图片可查看原图。
图1定义部件与实验输出,尤其杀伤和干性部分解耦说明单一终点优化不够。某个组合可能杀伤强但保留的干样细胞较少,因此研究目标是二维而非简单选最大值。基序招募的信号蛋白提供机制先验,但实际功能还受部件侧翼、磷酸化和位置影响。阵列点图来自具体刺激方案,不代表所有肿瘤类型及体内环境。误差由有限内部重复估计,读图时不应把每个散点都当作同等充分重复的严格临床效力比较。
| 子图 | 讲解 |
|---|---|
| A | 列出基序能招募的 T 细胞信号蛋白,为组合设计定义分子部件。 |
| B | 展示含基序及侧翼序列的 16–18 氨基酸部件,标出磷酸酪氨酸位置。 |
| C | 示意不同基序组合改变胞内信号程序,进而改变 CAR T 细胞表型。 |
| D | 抗 CD19 CAR 的结构及可变胞内信号区,定位被替换的设计部分。 |
| E | 四轮 Nalm6 刺激后的杀伤与 IL7Rα+/KLRG1− 干样细胞比例散点显示广泛组合表型;杀伤和干性可被部分解耦。 |
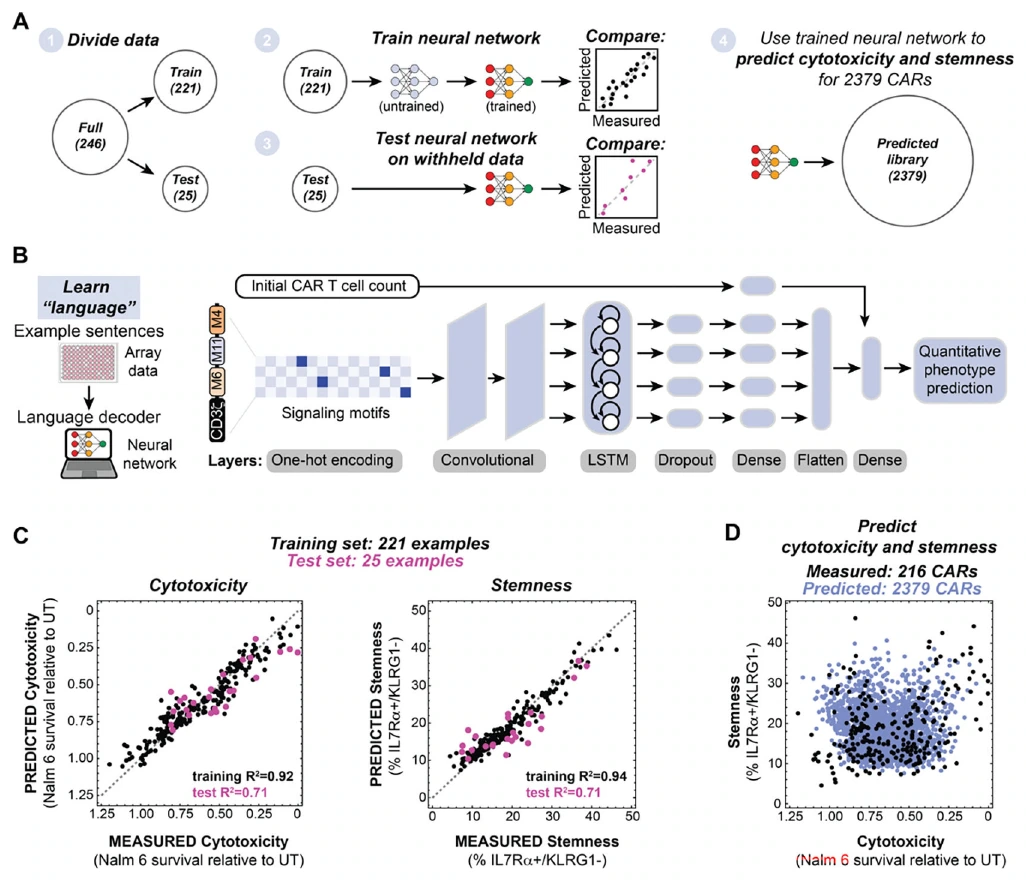
Figure 2|预测未测基序组合的神经网络
原图来源:所用 PDF 文件第 11 页,Figure 2。点击图片可查看原图。
图2先检查模型是否预测未用于训练的组合。测试RMSE高于训练,符合小样本拟合到泛化的差距;它仍捕捉表型变化,但25个测试组合的范围有限。后续2379个点描绘的是预测空间,可用于决定测哪些结构,而不能直接增加实验样本数。均值来自十个不同超参数网络,不是十次独立细胞实验。选择同时高杀伤与高干性的候选比只优化一种表型更接近工程目的,也需要在实测中检验这种优势是否保留。
| 子图 | 讲解 |
|---|---|
| A | 把实测阵列分成训练与留出测试,用训练模型预测总计 2,379 个 CAR 的表型。 |
| B | 展示基序序列输入到杀伤/干性输出的网络架构。 |
| C | 预测对实测散点分别比较训练与留出样本;测试 RMSE 高于训练,但仍能捕获两种表型的变化。 |
| D | 把 1–3 个可变基序的全部 CAR 投到预测杀伤–干性空间,十个网络均值帮助寻找两项都高的设计。 |
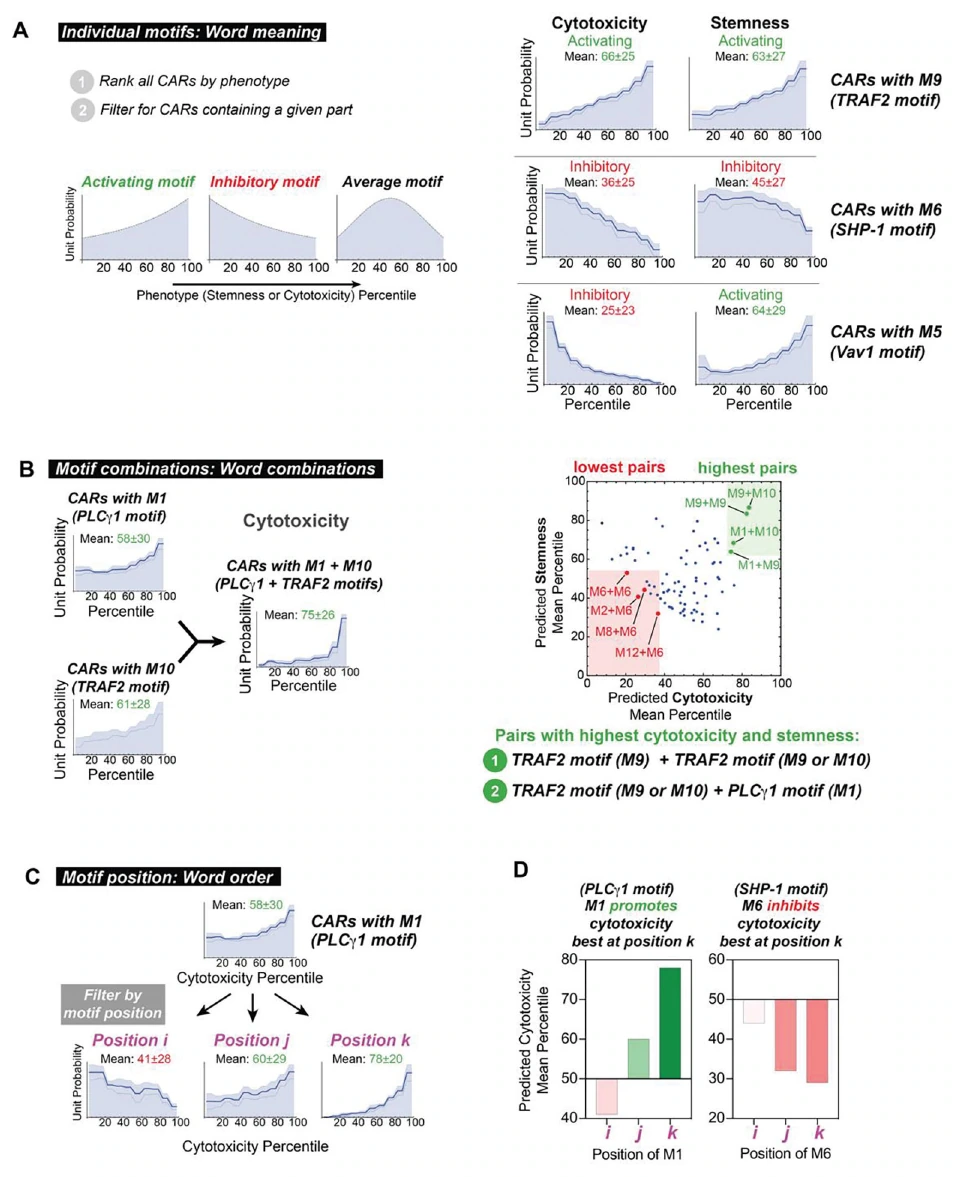
Figure 3|从预测库抽取信号基序语法
原图来源:所用 PDF 文件第 12 页,Figure 3。点击图片可查看原图。
图3从预测库中抽取单部件、成对组合和位置规律。M9/M10与M1组合偏高排名提示TRAF与PLCγ1可能互补;M1靠近ζ一侧效果不同又显示“拥有这个基序”与“把它放哪里”不是同一问题。百分位来源于网络排序,不是直接测得的效应大小。组合高于单个部件可提出相互作用假说,却不能用未经实测的全部预测证明生化协同。最有价值的是产生能前瞻修改的具体规则,而非把分布形状当作已确认的普适信号语言。
| 子图 | 讲解 |
|---|---|
| A | 按表型排名统计各部件分布;激活基序富集于高排名,抑制基序偏低排名。 |
| B | 分析基序成对组合,招募 TRAF 的 M9/M10 与 PLCγ1 的 M1 有利于同时提高杀伤和干性。 |
| C | 比较 M1 位于不同位置时的杀伤百分位分布,说明同一基序的作用受顺序/位置影响。 |
| D | 将位置效应用平均百分位量化;M1 在 k 位置最促进杀伤,M6 在该位置最抑制杀伤。 |
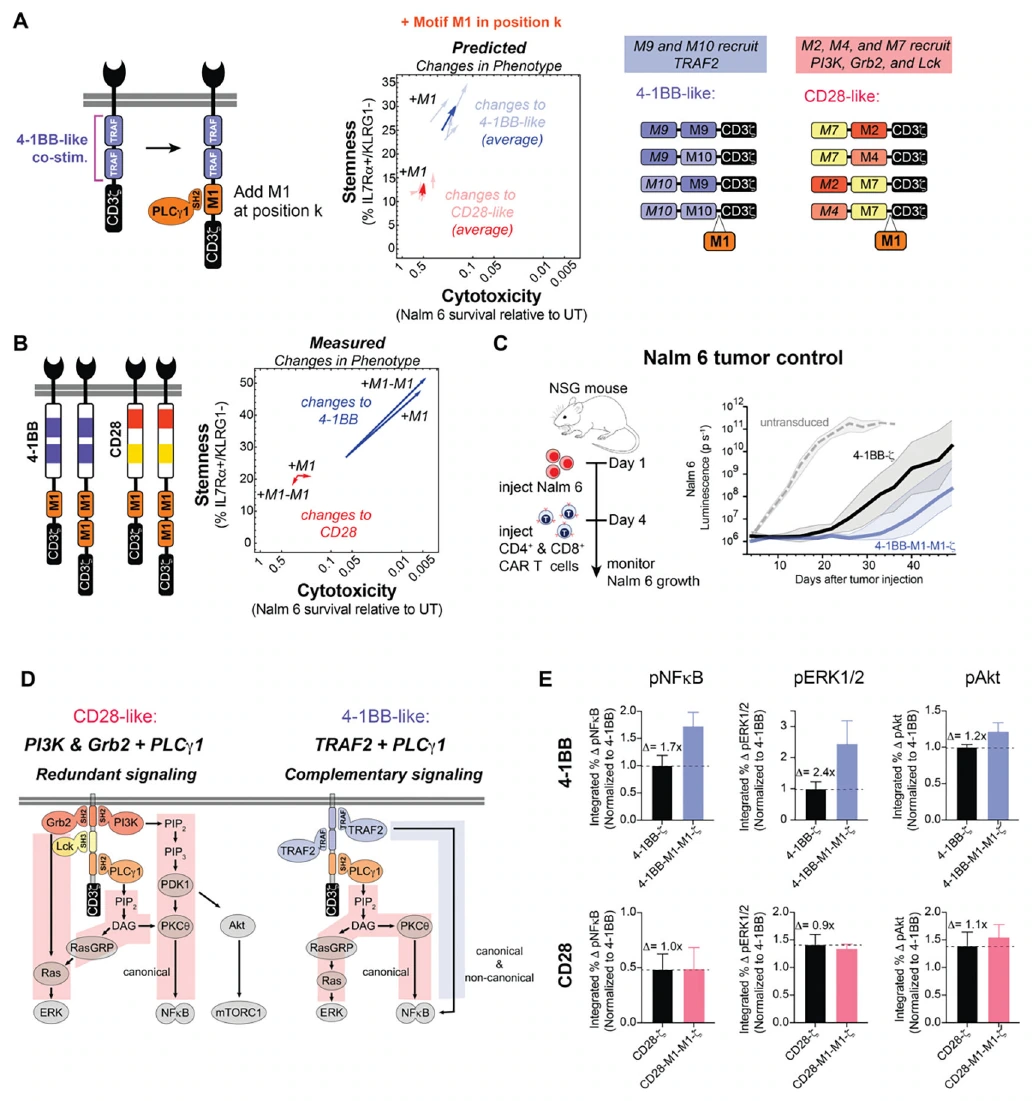
Figure 4|PLCγ1 基序的前瞻性设计验证
原图来源:所用 PDF 文件第 14 页,Figure 4。点击图片可查看原图。
图4让规则承担被推翻的风险:给4-1BB和CD28都增加M1,模型预测背景差异,实验也观察到不同结果。对4-1BB的提升与对CD28的弱变化一起出现,比只展示成功结构更支持机制解释。小鼠发光曲线证明早期肿瘤控制改善,不能直接扩大为长期治愈或临床安全。磷酸化动力学显示ERK/NF-κB改变大于Akt,与互补信号假说相容;机制示意仍包含推论,空间组织等解释没有被这些下游读数完全区分。
| 子图 | 讲解 |
|---|---|
| A | 用与 4-1BB/CD28 共享的基序部件预测加入 M1 的效果,提出可实验检验的修改方案。 |
| B | 四轮 Nalm6 刺激显示一个或两个 M1 改善 4-1BB–ζ 的杀伤和干性,但对 CD28–ζ 无同等改善,验证背景依赖性。 |
| C | 小鼠白血病模型的肿瘤发光曲线显示 4-1BB–M1–M1–ζ 改善早期肿瘤控制,提供体内验证。 |
| D | 机制示意解释 PLCγ1 与 TRAF 信号互补,而与 CD28 的 PI3K/Grb2 信号部分冗余。 |
| E | 抗原刺激后 0–60 分钟流式测 ERK1/2、NF-κB 和 Akt 磷酸化;加入 M1 后下游 ERK/NF-κB 改变更明显,支撑 D 的信号解释。 |
阅读说明
- 本文件为作者稿。Figure 3 图注在第 13 页续完,Figure 4 的 E 子图图注在第 15 页续完,均已纳入。
依据:对应主图、完整图注及正文 Results;实验结果只按本文给出的对象和条件解释。
可迁移的组合研究方法
我最喜欢的设计是实验库有明确边界、表型有真实量尺、模型输出能够转成下一轮可合成修改。这让预测与机制之间不是仅靠可视化,而是靠新增部件后的实验比较。4-1BB与CD28的差异尤其提醒我们,同一部件效果依赖背景,不能把单个motif视为固定正负号。
AD调控元件和TE研究也常面对组合问题:一个序列片段的效应取决于邻近motif、细胞类型和染色质环境。可以用已有公共扰动或报告实验学习有限组合规则,再以独立序列和donor验证。若只有观察性ATAC数据,则先将结论写成背景依赖的关联与候选,不能声称已经优化细胞功能。
在16GB显存条件下,紧凑网络完全可以承担这样的部件组合回归。应同时设置线性或加性模型、显式交互项及其他简单基线,检验非线性网络到底增加多少信息。测试划分也应考虑组合相似性:仅随机留下相近组合,可能比留出某类部件搭配容易得多。泛化任务决定结果能支持怎样的工程结论。
还有一个重要取舍是合成组合与天然上下文。阵列数据只覆盖有限库,把规则移到完整天然域之后再测是关键跨步;如果直接把预测库分析叫作天然信号机制,就跳过了这一环。对TE可以对应为先在人工或简化输入中提名模块,再检查其在原生基因组背景中的稳定性。
本文提供的是特定CAR与白血病体系中的设计规则。其他抗原、肿瘤环境、细胞来源和安全性终点需要新的实验,不能从一个成功修改得到一套永远通用的CAR配方。模型最强的贡献是帮助找到有方向性的下一步,而不是让试错彻底消失。
