83.DeepC:原图、模型逻辑与研究范式

83.DeepC:原图、模型逻辑与研究范式
Perry论文题名: DeepC: predicting 3D genome folding using megabase-scale transfer learning
期刊与年份: Nature Methods,2020。论文原文。
阅读版本: Europe PMC 作者接受稿(Author Manuscript),2021-04-16在PMC公开;正式发表为 Nature Methods 2020。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
本篇问题: 兆碱基DNA序列能否预测三维折叠,并定位影响结构的调控变异?
问题如何形成:局部碱基怎样影响远程结构
非编码变异常远离目标基因,因此只预测一个局部位点是否结合转录因子,并不能回答它会改变哪一个远程调控关系。我的推测是,作者把当时两类方法的缺口放在一起:逐碱基模型精细但看得近,大尺度结构模型看得远却把DNA简化成粗粒度特征。DeepC选择先学习局部调控语言,再把这些表示连成兆碱基范围的结构预测。这一推断来自引言提出的尺度冲突,不代表作者对研究过程的逐字回忆。
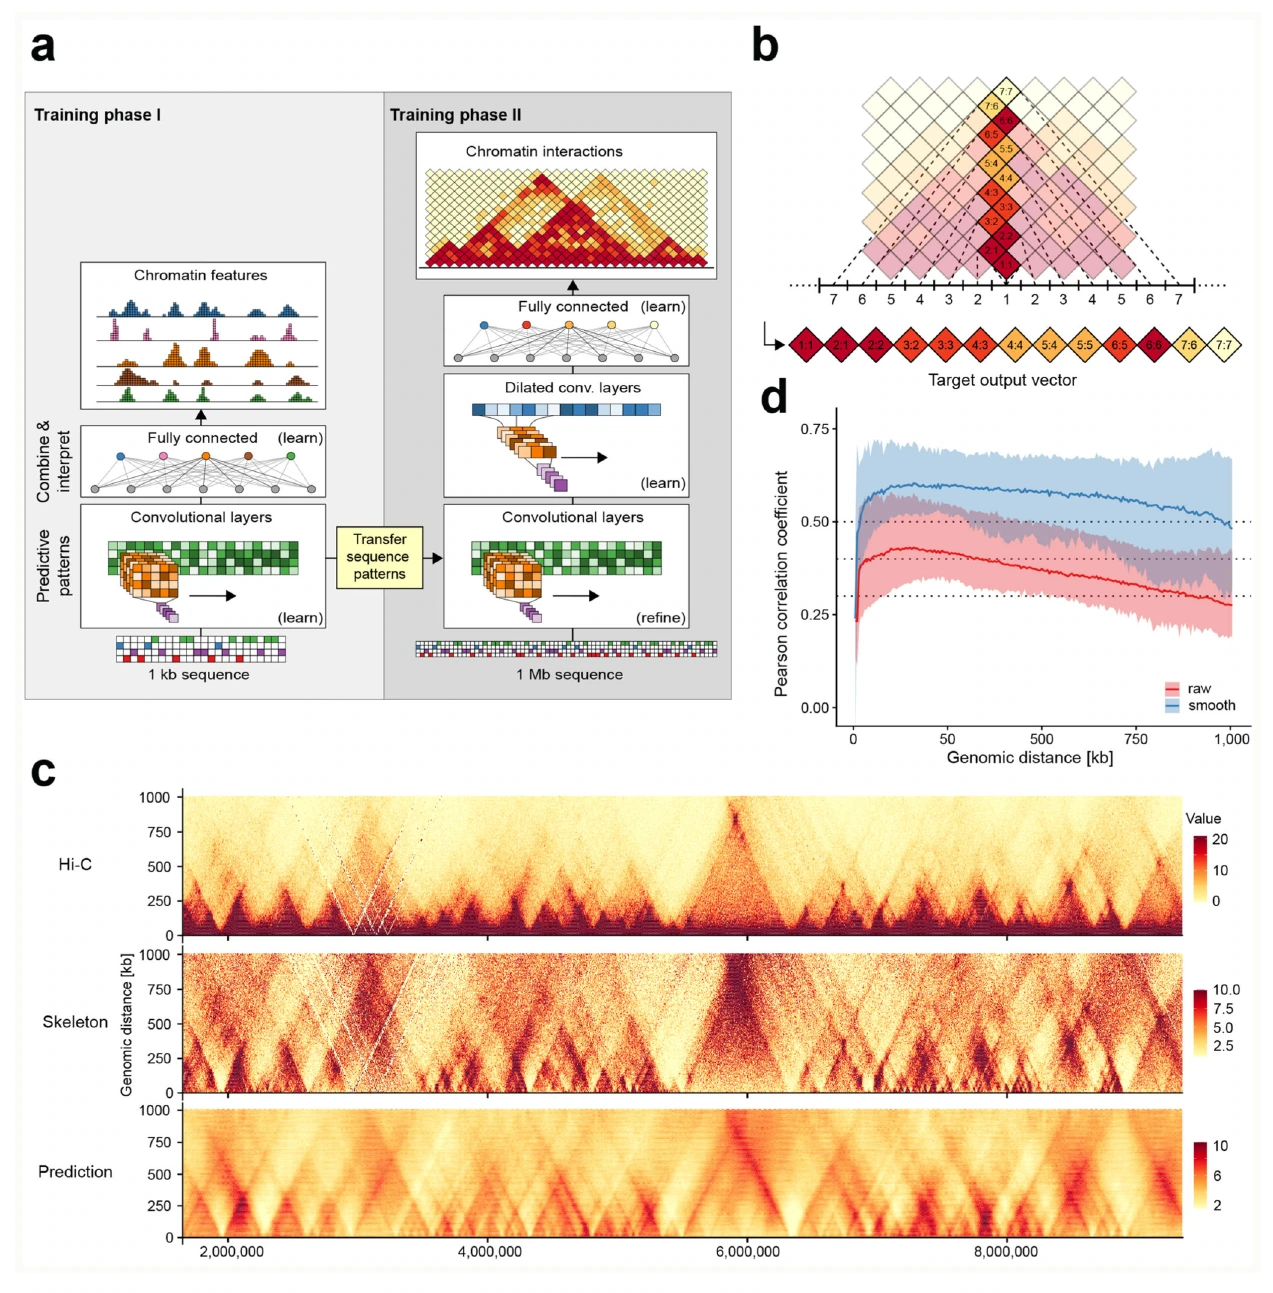
模型先用1 kb DNA预测936组染色质实验的峰标签,训练卷积模块;随后移除分类输出层,将卷积权重迁移到三维预测网络。第二阶段输入约1 Mb DNA,经池化、十层带门控的膨胀卷积和全连接层,输出中心附近的一列成对接触信息;滑动窗口再拼成矩阵。监督目标是按距离分层后的接触百分位编号,以均方误差学习,而不是未经处理的Hi-C原始读数。卷积识别局部motif,膨胀卷积整合远程背景,分别对应问题的两个空间尺度。
输入虽只有DNA,模型依然按细胞类型分别使用Hi-C监督训练。同一DNA在不同细胞中表现不同,靠的是不同模型权重,而不是一个DNA模型自动知道细胞状态。作者尝试多细胞联合模型,但其细胞特异模式不如分别训练。研究范式是有监督的多任务表示迁移,不是无监督发现三维结构。疾病链条应写成序列改变、预测结构改变、可能影响调控,再由独立数据验证,不宜跳过中间环节。
Figure 1:由DNA预测三维接触的deepC
原图来源:所用 PDF 文件第 23 页,Figure 1。点击图片可查看原图。
a是“先学局部、再学远程”的路线图;b则明确输出到底是什么,避免误以为网络一次输出完整三维坐标。中心接触列覆盖不同距离,既便于训练,也让滑窗结果可重构为染色体接触图。c将原始Hi-C、百分位骨架与模型预测放在未见染色体同一区域,主要检验域结构和边界。距离归一化强化远距离对比,却改变了读数意义,因此预测色深不能直接等同于原始接触概率。
d按基因组距离分别计算相关,而不是让大量近距离强接触主导总分。平滑后的相关更高,说明目标数据的离散噪声会影响评估,但也意味着原始与平滑两种成绩不能混用。尤其需要理解“高分辨率”:输入可逐碱基修改,主要展示模型的Hi-C输出仍是5 kb分箱,二者不是同一种分辨率。学习后的图看起来平滑整齐,也不代表每个细小条纹都真实。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 先迁移学习序列表示再预测接触的网络与训练流程。 |
| b | 1Mb序列窗口对应Hi-C目标向量的编码,说明学习对象。 |
| c | 未见染色体约7Mb区域的Hi-C、简化骨架和deepC预测,检查域结构及边界。 |
| d | 全染色体交叉验证的距离分层相关,比较原始和滤波骨架目标,避免近距离主导评估。 |
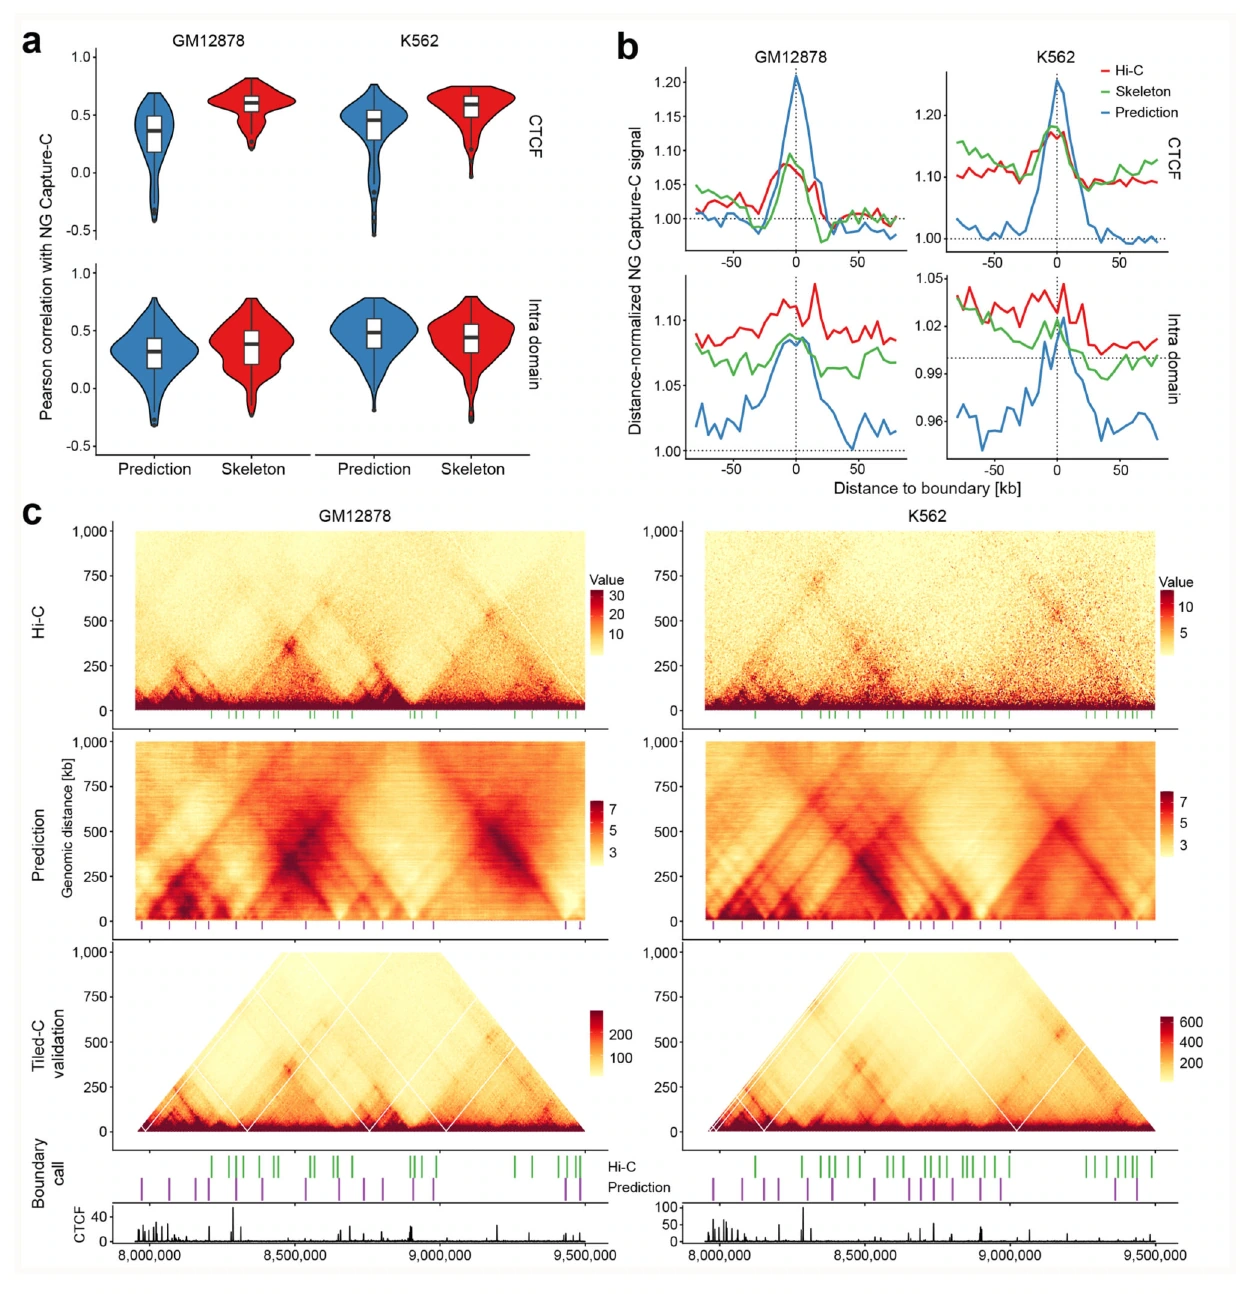
Figure 2:独立三维实验验证
原图来源:所用 PDF 文件第 25 页,Figure 2。点击图片可查看原图。
这张图用独立测量检查网络是否只是复述Hi-C的处理方式。a以NG Capture-C的定点高深度接触轨迹分别测试CTCF位点与域内位点;将二者分开很重要,因为它们强调不同结构现象。模型对域内总体结构较好,对CTCF尖锐接触峰则弱于原始骨架。这个缺口提示DNA序列能够解释边界的一部分,却未必包含cohesin过程性、核内蛋白浓度等状态变量。
b围绕模型与实验调用的边界做平均轨迹,c再以Tiled-C检查未见染色体的具体区域。它们分别回答“总体是否存在边界”和“这个位置是否看得见”,不能互相替代。方法部分说明220个验证观测点有意选择预测与Hi-C细节不同或预测信号很弱的区域,这适合检验模型提出的结构假说,却不是全基因组随机抽样的无偏性能估计。实验技术重复被合并增加深度,也不能当作大量独立生物学重复。模型可能夸大域间条纹、低估隔离程度,阅读漂亮案例时应同时记住这一已报告偏差。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | NG Capture-C对骨架虚拟4C及预测虚拟4C的相关,分别在CTCF和域内观测点验证。 |
| b | 实际、骨架和预测边界周围的Capture-C平均轨迹,检验模型是否定位隔离边界。 |
| c | 未见chr17的Hi-C、预测、Tiled-C及边界对照,借高灵敏独立实验验证精细结构。 |
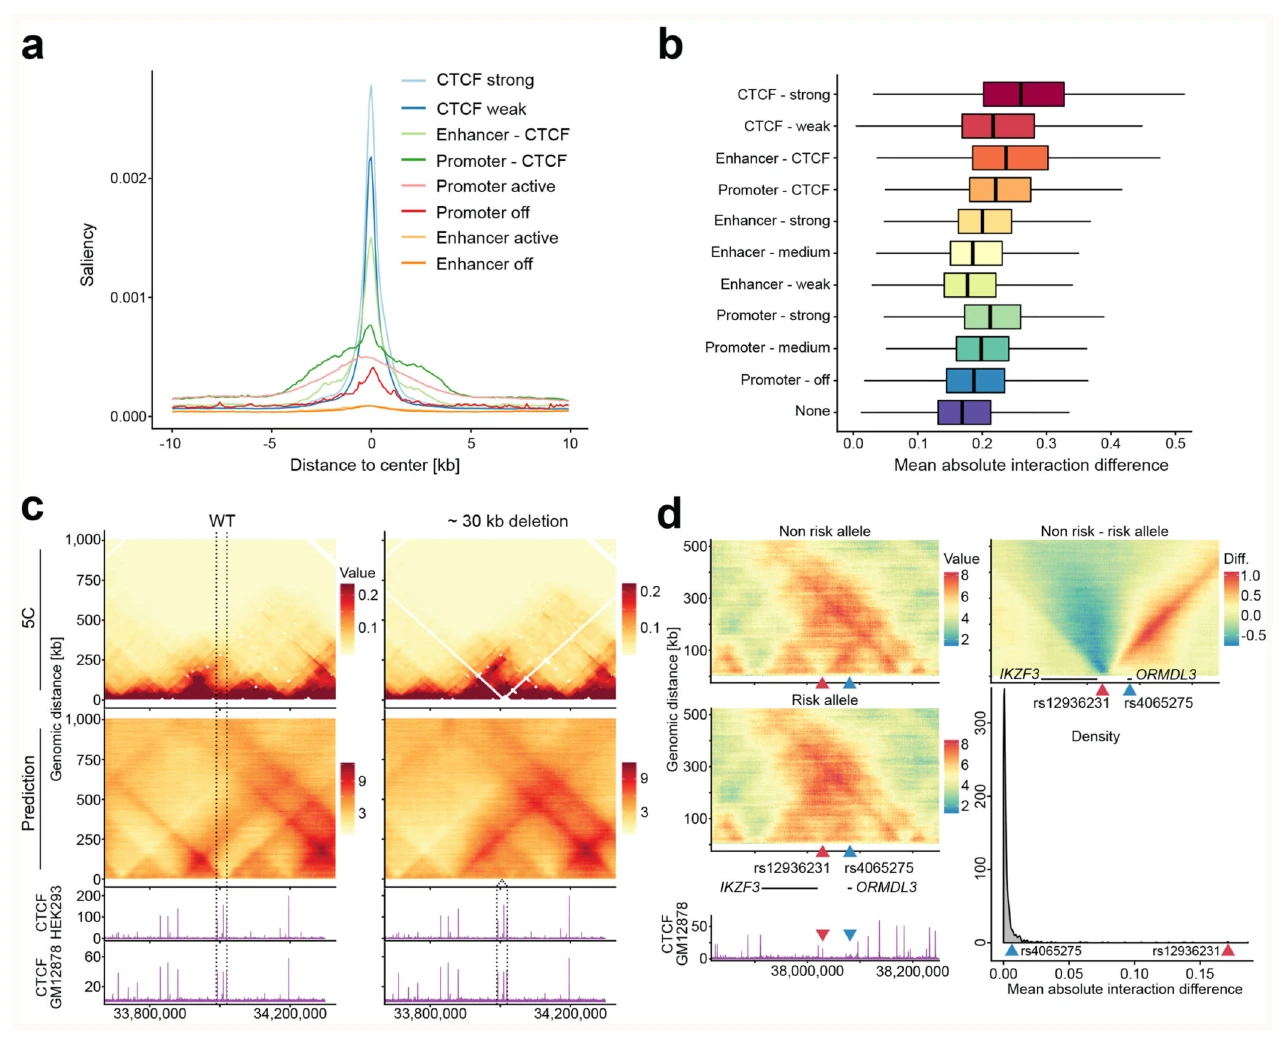
Figure 3:序列结构决定因素与遗传变异
原图来源:所用 PDF 文件第 27 页,Figure 3。点击图片可查看原图。
a与b分别提出序列重要性的两个计算证据:梯度归因寻找网络敏感位置,虚拟删除比较参考与改变后接触预测。CTCF、启动子和增强子附近信号更强,说明模型利用了这些模式;但梯度不是实际突变实验,删除后的预测差也不是已经测到的结构变化。虚拟删除还会改变序列距离与上下文,分析应区分motif丢失和结构长度改变的贡献。
c与真实约30 kb删除后的5C结果对照,是整篇从模型内部解释走向干预证据的重要一步。不过实验发生于HEK293相关细胞,展示使用GM12878模型,两种细胞并不相同;复现域融合支持跨背景的结构规律,却不能证明所有预测变异都具有同样准确度。d再将分析缩小到两个哮喘相关SNP:通过风险等位与非风险等位的差异、背景SNP分布和既有CTCF知识优先排序候选。它为ORMDL3调控提出机制路径,尚未独自完成变异、结合、接触、表达和疾病风险的全链条因果证明。一个预测排名很高的SNP仍需要控制连锁不平衡和细胞类型。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 不同调控注释区域的归因富集,识别模型认为影响结构的序列类别。 |
| b | 全基因组删除开放区、CTCF及随机对照后的预测变化,定量检验元件的结构影响。 |
| c | 删除含四个CTCF位点的约30kb片段后,预测与5C实测结构变化对照,验证大段删除效应。 |
| d | 两哮喘关联SNP的风险/非风险预测差异,定位ORMDL3/IKZF3附近接触变化;为候选机制,不能单凭预测认定因果。 |
阅读说明:实际阅读版本为 Europe PMC 作者接受稿(Author Manuscript),页脚注明于2021年4月16日在PMC公开;正式发表记录为 Nature Methods 2020,17:1118–1124,DOI 10.1038/s41592-020-0960-3。主图与图注按此份接受稿的PDF页码讲解。
我自己的理解:先把结构读数做成可验证的中间层
我最认可的是作者没有仅靠三维热图相似度结束工作,而是让边界预测面对另一种高灵敏实验。可以迁移的研究设计是:模型训练所用读数,与最终论断所需的证据尽量分开。例如研究TE重叠的AD候选变异,先问是否可能改变CTCF或调控元件及三维关系,再用脑相关细胞的实际接触、表达关联或已有扰动数据检查;不能用同一模型的归因图给自己的预测再次盖章。
纯计算时可以先用已公开的删除或结构变异集合做外部验证,把相似大小、相似距离、相似可及性的非TE区域作为背景。TE家族、位置和可比对性需匹配,避免重复序列在输入或实验标签中的技术困难被当作特有机制。若只有ATAC,没有脑Hi-C,就应先研究可及性与局部调控,三维模型只提供待验证的候选路径。
作者实际在12 GB Titan V上以batch size 1训练约6000万参数模型,这说明兆碱基任务不必全部依赖超大基础模型;但原文软件版本、训练目标与吞吐不能直接换算成5060的训练时间。可执行的起点是复用预训练卷积表示,先完成一个细胞背景、固定留出染色体的基准,再比较是否需要远程结构分支。特别注意,第二阶段测试染色体15在局部预训练阶段的划分有所不同;跨任务迁移的全部数据划分必须一起审计,不能只检查最后一层训练集合。最终创新应来自新的生物问题与独立检验,而非把网络输入延长。
另外,训练预处理把接触强度离散到不均匀百分位,高接触区得到较细分辨;这不是中性的文件转换,而是把模型容量优先分配给域边界的设计选择。迁移时应先确定自己最关注整体接触、尖锐环峰还是边界,而后选择目标表示。不同目标的数值成绩不能直接横向比较。
