87.PersonalExpressionBenchmark-Sasse:原图、模型逻辑与研究范式

87.PersonalExpressionBenchmark-Sasse:原图、模型逻辑与研究范式
Perry论文题名: Benchmarking of deep neural networks for predicting personal gene expression from DNA sequence highlights shortcomings
期刊与年份: Nature Genetics,2023。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
本篇问题: 参考基因组训练模型能否真正预测不同个人的表达差异及变异作用方向?
从漂亮的跨基因预测里提出一个反问
我对研究思路形成的推测是:如果模型学到了调控逻辑,就应该能在固定基因处解释不同人的DNA为何造成表达差异;然而传统基准通常比较不同基因的平均表达。这两个任务看似都叫“预测表达”,实际变化来源完全不同。作者利用839位ROSMAP供体的配对WGS与皮层RNA,把测试单位从基因位置改成人。论文的贡献不是发布更大模型,而是设计直接挑战个体遗传解释能力的基准。
Enformer原本输入参考基因组附近长DNA,输出CAGE、ATAC等多种实验轨迹,利用基因组各位置之间的差异训练。本文将每位供体的两条分相序列分别输入,再平均表达预测。为适配皮层RNA-seq,作者还在预训练输出上训练弹性网映射,其标签来自GTEx的跨基因平均表达;这不是在839人WGS上微调整个Enformer。它可以改善读数匹配,却没有直接教网络同一位点的变异方向。
比较模型PrediXcan则用GTEx个体基因型与表达训练每个基因的弹性网。它只能处理训练中可用变异、缺乏任意新序列解释,却适合本项个体表达任务。这说明“泛用序列模型”与“针对个体变异模型”各有能力边界。基准范式是冻结已有模型、重新定义评估单位,再结合归因追查失败原因。数据来自AD研究队列,并不使这篇成为预测AD诊断或病理进展的模型;研究终点仍是个体间皮层表达。
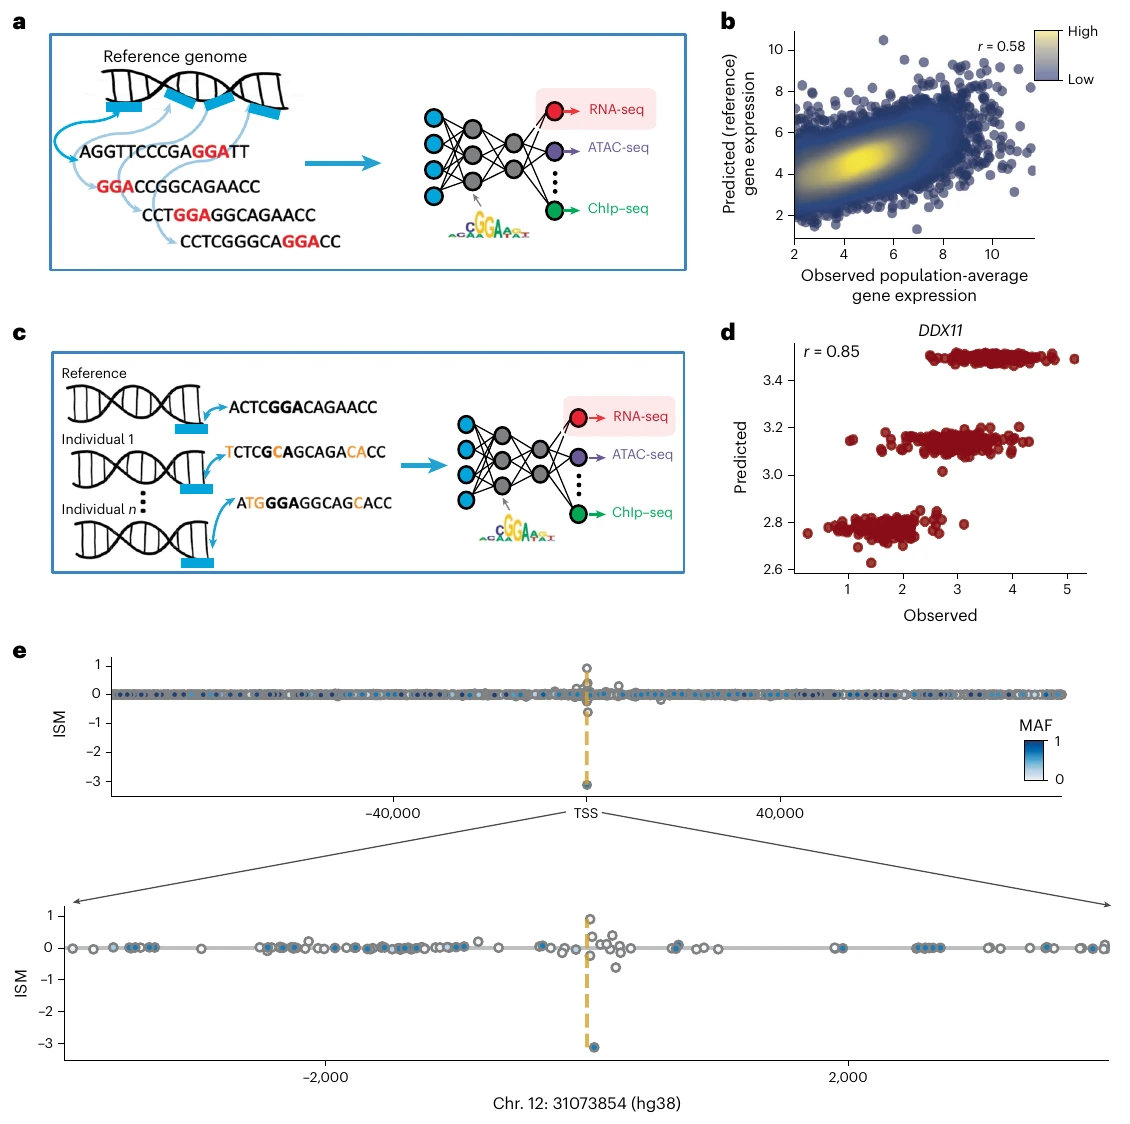
Figure 1:跨基因准确性不等于个人表达准确性
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
a与c是全篇最值得理解的对照:a比较不同基因组位置,c固定一个位置改变个体DNA。b中跨基因相关较高,可能反映网络能区分强与弱启动子等平均规律;它不能为c的个体变异任务提供直接保证。d以DDX11展示真实成功案例,839个点对应839人,说明模型在特定高遗传度位点确能捕获表达差异。e检查哪些变异驱动这一预测,并与精细定位的单个候选一致,把成功从散点关联推进到可解释遗传信号。
但DDX11不能代替全局评价。它的遗传度与较清晰单驱动结构有利于预测,选择这样的实例有助说明可能性,却不说明普遍性。e的ISM是在模型中改变一个碱基的输出差,不是实际编辑实验;“延伸抑制motif”仍是机制假说。两个等位序列取平均也默认一种汇总方式,未独立解决细胞组成、转录后加工、环境和疾病状态对bulk RNA的影响。
我认为这张图的教育作用在于先保留模型确实能做好的任务和位点,再提出更严格问题。它没有因为新的评估失败就否认参考基因组预测,而是要求每项能力在对应数据变化上被验证。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 参考基因组不同区域作为训练样本的示意,解释Enformer原任务。 |
| b | ROSMAP皮层839人的平均表达对跨基因预测,检查传统总体性能。 |
| c | 固定一个位点、比较不同个人的评估示意,定义更直接的个体变异测试。 |
| d | DDX11在839人中的预测对实际表达,提供个体层面实例。 |
| e | DDX11附近个人SNV的ISM效应按等位频率着色,检查哪些变异主导表达预测。 |
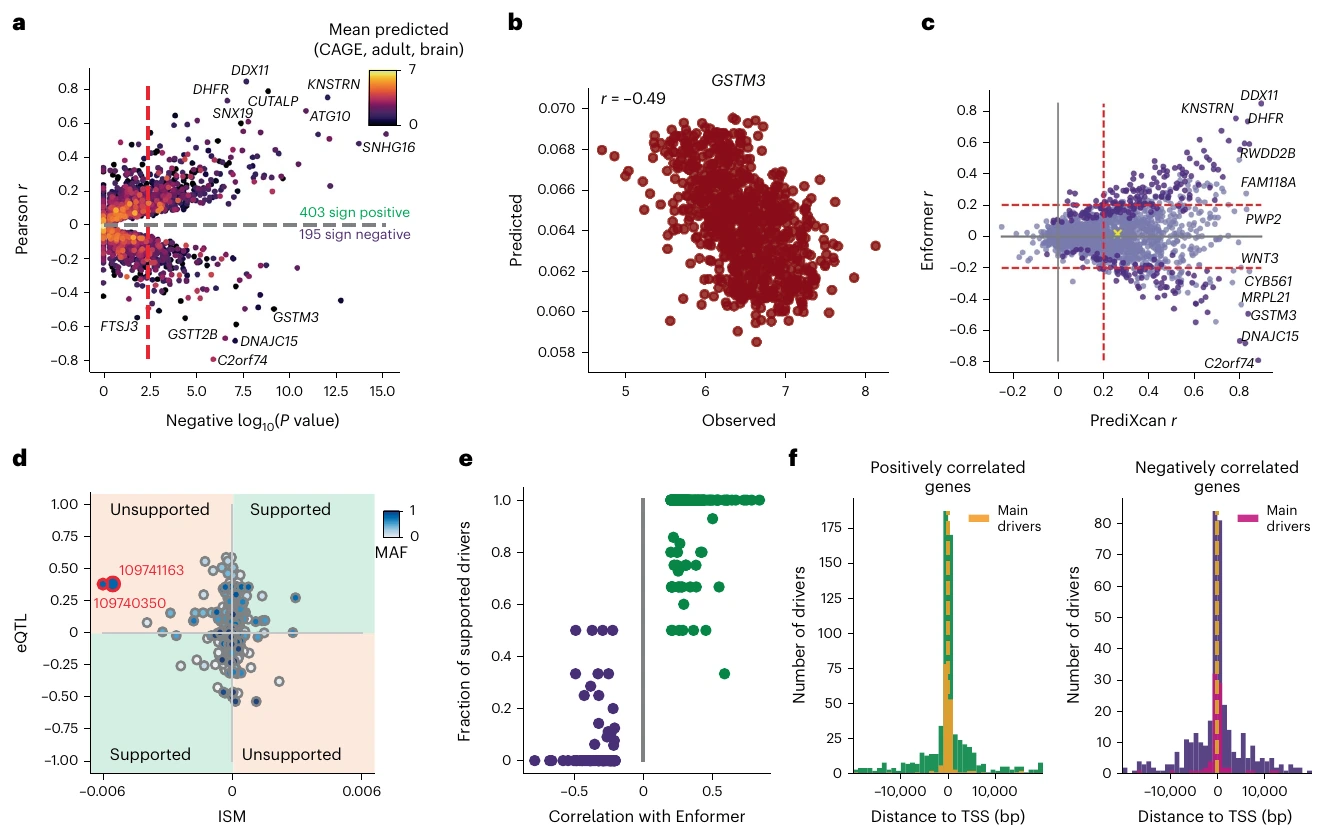
Figure 2:个体间表达预测的方向与驱动变异
原图来源:所用 PDF 文件第 3 页,Figure 2。点击图片可查看原图。
a将6,825基因逐个按人与人之间相关评价:平均相关约0.01,显著基因中有195个方向相反。显著负相关意味着模型输出稳定地沿错误方向变化,不是“也有预测能力,所以可以忽略符号”。b的GSTM3是这种失败的直观实例。c与个人遗传数据训练的PrediXcan对照,表明简单模型在合适任务上可以优于大型序列网络;比较集合受PrediXcan可用基因限制,不能把这一结果扩展为所有新变异或所有组织任务的排序。
d、e追踪方向错误。ISM与输入梯度先近似个人表达预测,再定位少数主驱动SNV;多数基因只由几个变异支配模型差异,错误方向因此可以传递到全基因表达。这里“驱动”严格指驱动模型输出,不自动指生物因果变异。与边际eQTL方向不一致是警示证据,边际eQTL本身受LD影响;反过来,边际效应很大的位点却没有模型效应,也不能单凭这一点判断网络错了。理想核对仍需精细定位或独立扰动。
f显示许多模型驱动靠近TSS。这提示长输入不等于学会使用远端调控,motif语法也可能未被充分学习。作者没有发现一种简单统一的错误motif,因此不能归纳成“模型把某一个TF全部读反”。敏感性分析涉及输出映射、移位与正反链平均、因果候选子集,降低了仅因轨迹选择或输入对齐出现结论的可能。研究给出了失败现象及证据链,而关于新的训练数据能否彻底解决,仍是后续待测假说。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 6825个基因的个体间相关对统计显著性,检查高平均表达预测是否转化为真实个体差异。 |
| b | GSTM3个人表达预测对实测,展示可出现方向错误的强关联实例。 |
| c | 逐基因Enformer与PrediXcan相关比较,检验通用序列模型对个体训练线性模型的差异。 |
| d | GSTM3所有SNV的ISM对eQTL效应,标出驱动SNV并检验符号一致性,解释错误方向来源。 |
| e | 支持方向的驱动SNV比例对模型个体间相关,连接逐变异错误与整基因表达错误。 |
| f | 正/负相关基因驱动SNV在TSS附近的数量与位置,检查模型的驱动定位偏好。 |
我对AD与TE模型的直接启发
若想研究AD中TE附近WGS变异,这篇提醒我先确定最终问题是什么。预测一个TE所在峰比另一个峰更开放,与预测同一TE副本在不同供体中因等位差异而更开放,是两个任务。前者高相关不能替后者背书;更不能再跨一步宣称模型揭示病理进展。我们应同时报告跨位点性能、同位点跨供体性能,以及变异方向是否正确。
一个可执行的纯计算设计是冻结现有序列模型,对脑相关公共队列的候选位点比较个人等位预测与实际供体表达或可及性。只在有足够遗传变异和测量可靠性的位点做方向评估,并用匹配非TE背景、线性基因型模型和简单序列模型作基线。若数据权限尚未获得,不能把ROSMAP文件名或摘要中的人数当已经拥有的训练样本。外部MPRA可以核对局部方向,但其报告体系与内源个体表达仍需区分。
这篇也让我调整“创新”的标准:严谨揭示当前模型在一个生物学必要任务中的失效,本身可以形成重要研究;不一定要先堆更大模型。一个小网络若经过供体与基因组区域双重留出,在TE变异方向上稳定改善,并能解释改善来自何种上下文,比只在随机切分上提高几个百分点更有价值。
无监督路线同样要面对这个检验。发现TE调控模块后,应先锁定模块和特征,再在未参与训练的供体或独立队列中检验病理关联;不能利用AD标签反复选择潜空间,随后仍称疾病信号“完全无监督发现”。模块可能主要编码细胞组成、批次或参考序列规律,这些解释需要作为明确对照排查。论文没有证明无监督一定更好,它要求的是目标、划分和结论对齐。
在评估设计上,疾病队列里的bulk表达还会混入细胞组成与病理相关变化;基因型模型不应被要求解释所有非遗传方差,但也不能用这个理由忽略方向错误。应先以有可靠cis遗传度或精细定位信号的基因建立正对照,再分别检查神经元、胶质细胞和整体组织背景。遗传度估计与模型参数调优也应限于开发数据,最终测试只做一次锁定评价。这样才能分清数据没有足够遗传信号,还是模型把已有信号读错。变异方向的检验还应事先规定等位编码,避免正负号由参考/替代定义互换而产生假错误。
