10.Borzoi:原图、模型逻辑与研究范式

10.Borzoi:原图、模型逻辑与研究范式
Perry论文题名: Predicting RNA-seq coverage from DNA sequence as a unifying model of gene regulation
期刊与年份: Nature Genetics,2025。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Nature Genetics,2025;以当前 PDF 为准。
研究瓶颈怎样转化为问题
RNA-seq 读段并不只受所处局部序列决定:3′ 端覆盖可能受数十万碱基外的启动子/增强子影响,还整合剪接和加尾。Borzoi 因而问,能否预测整条覆盖轨迹,再从同一输出派生不同调控读出?依据设计逻辑推断,其 idea 是把多个专门模型分开的机制放回统一 RNA 测量空间,让表达量、转录本选择和变异效应共享序列信息。
输入、目标与结构
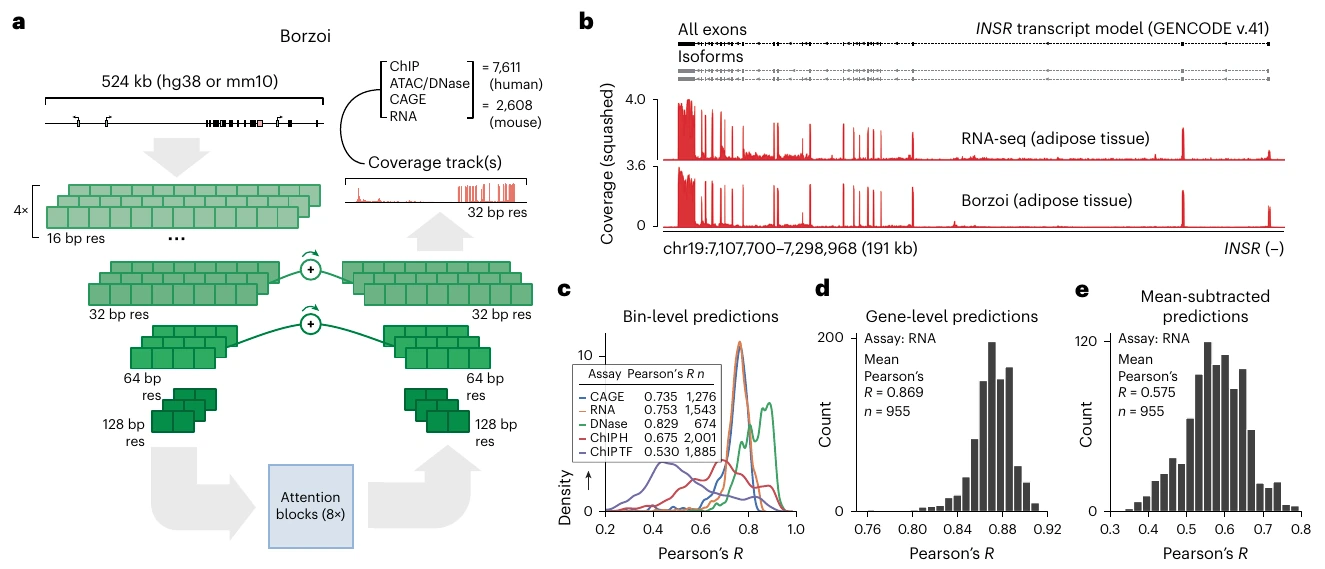
524 kb DNA 经过卷积和注意力,在 128 bp 尺度整合长程背景;U-net 上采样并与早期特征连接,恢复 32 bp 输出。长上下文解决远端依赖,跳连接补回外显子边界等较细空间信息。训练用人/小鼠 RNA-seq 与多类调控轨迹,四次随机初始化用于检验稳定性和集成。32 bp 并非逐碱基剪接标签;从覆盖派生外显子/内含子、近/远端加尾的比值,可以隔离不同机制,但仍受 RNA 稳定性和测序处理影响。
Figure 1:Borzoi 网络及基础预测
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 卷积和注意力先在 128 bp 尺度建模,U-net 上采样输出 32 bp 信号;由 DNA 序列预测细胞和组织特异测序覆盖。 |
| b | 留出基因 INSR 的脂肪组织预测与实测 RNA-seq 覆盖对比,展示模型恢复外显子信号。 |
| c | 跨 CAGE、RNA-seq、DNase、ChIP–seq 轨迹比较逐 bin 相关性,评价不同任务。 |
| d | 将外显子覆盖相加后比较基因级表达,检查覆盖预测能否转为准确表达量。 |
| e | 分位数标准化并减去跨轨迹平均表达后再比较,重点检验组织差异而非基因本身高低表达。 |
c 看逐 bin,d 看基因总覆盖,e 去除跨轨迹均值再看组织差异,防止同一高相关掩盖三个任务。RNA-seq 基因级相关与局部覆盖相关本来不同。INSR 示例说明长基因可建模,不能代替总体留出评估。论文明确部分轨迹处理与 Enformer 不同,基础覆盖性能不能脱离处理管线直接横比。
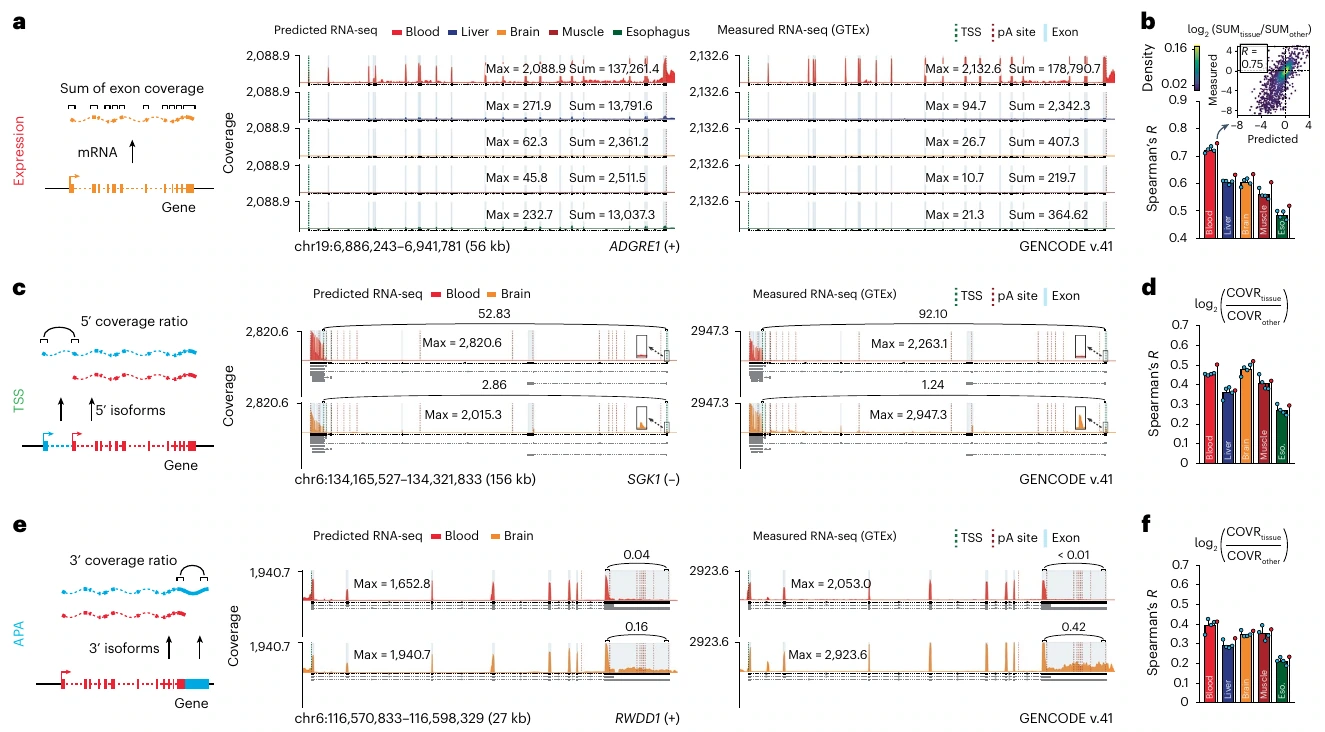
Figure 2:组织特异表达及转录本选择
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 五种 GTEx 组织中 ADGRE1 的覆盖对照,检验血液特异表达。 |
| b | 在 1,940 个留出基因比较某组织相对其他四组织的表达 fold-change;重复模型与集成模型显示组织差异预测能力。 |
| c | SGK1 多个 TSS 的覆盖比例示例,展示组织间启动位点选择。 |
| d | 337 个多 TSS 基因的预测/实测覆盖比例变化相关性,量化 c 的现象。 |
| e | RWDD1 近端及远端加尾位点覆盖比,展示 3′ UTR 的可变加尾。 |
| f | 在 994 个多加尾位点基因比较组织间覆盖比变化,评估 APA 的定量预测。 |
表达 fold-change、多个 TSS 覆盖比例和近/远端加尾比例都由覆盖派生,使同一模型可回答不同问题。每个案例后都有更多留出基因的定量比较,降低示例挑选风险。但覆盖比仍可能受转录本稳定性和重叠结构影响;要称为特定启动子或加尾事件,需相应注释和独立 RNA 证据,不能只凭预测曲线形状。
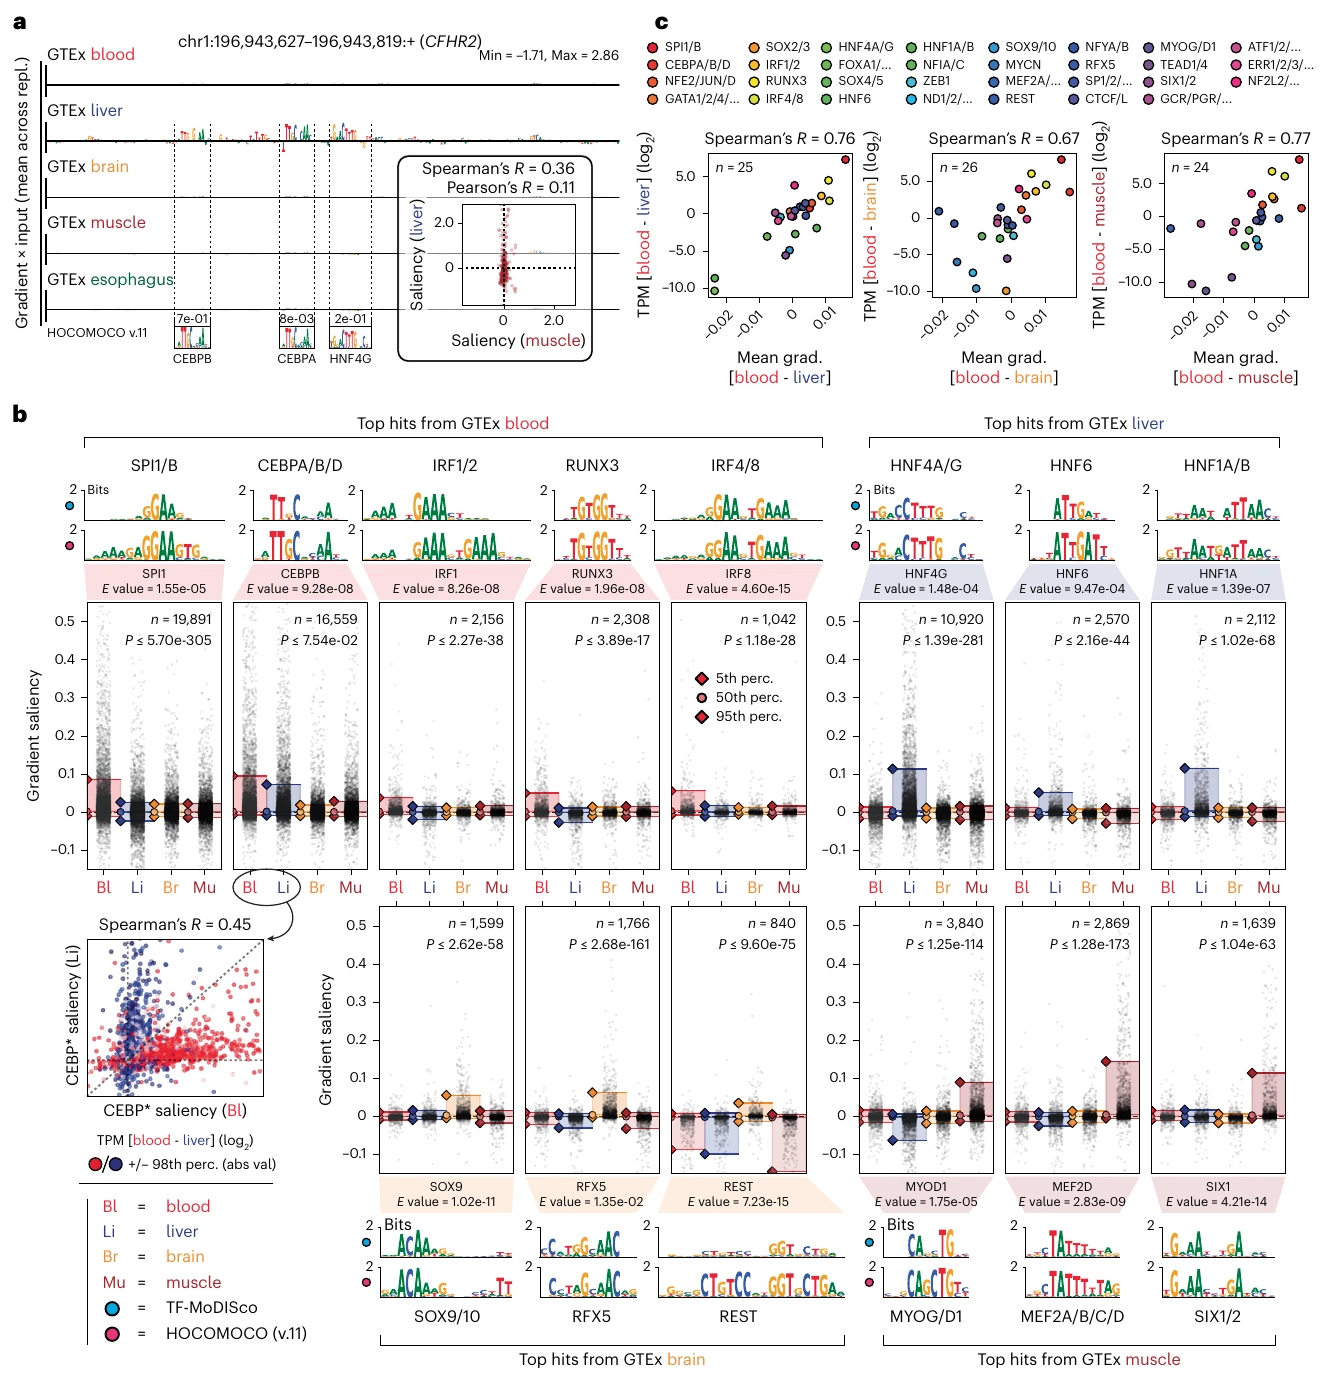
Figure 3:组织特异调控基序
原图来源:所用 PDF 文件第 5 页,Figure 3。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | CFHR2 的梯度贡献及基序匹配,比较肝与其他组织模型,定位组织相关调控序列。 |
| b | MoDISco 汇总不同组织贡献片段并与已知 TF 基序比对;各基序的贡献在组织间不同,部分与血液或肝相关。 |
| c | 比较两组织间基序贡献差与对应 TF 实测表达差,支持贡献模式具有生物学对应性。 |
贡献片段与已知基序匹配检验模型是否利用合理调控信息,c 再问贡献差是否对应 TF 表达差。它们是解释和一致性证据:梯度不等于 TF 实际占据,基序常由多个 TF 共享。组织贡献变化也可能反映相关序列或标签背景。最有用的后续是选择特定基序做等位或扰动实验,而非从热图宣称完整转录网络已被恢复。
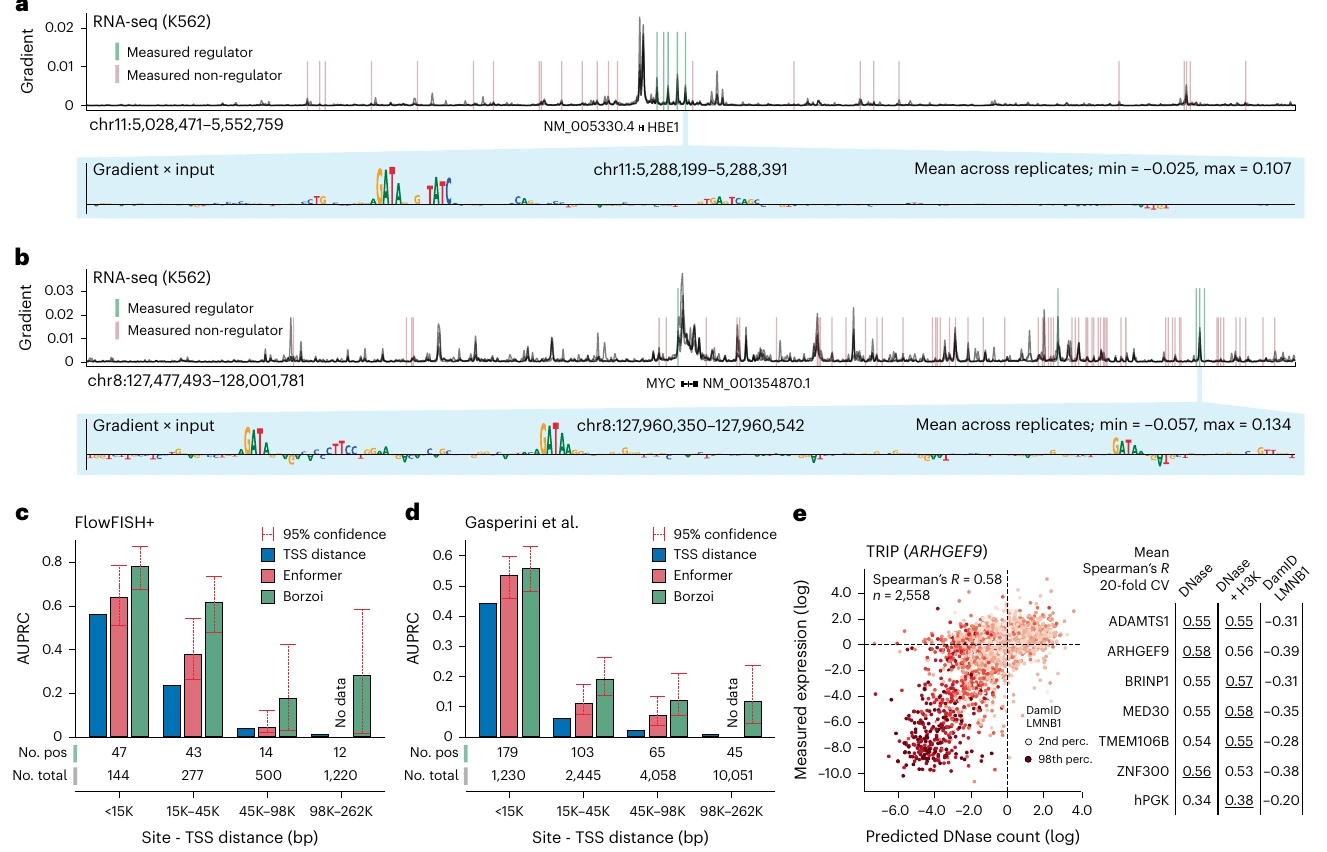
Figure 4:远端调控及基因组背景
原图来源:所用 PDF 文件第 6 页,Figure 4。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | HBE1 在 524 kb 输入中的梯度,标注实测有效/无效 CRE;模型可定位远端有效增强子及其局部基序。 |
| b | MYC 的同类梯度图,检验另一基因的远端调控区域。 |
| c | 按 CRE 距基因分组比较 Borzoi/Enformer AUPRC,衡量贡献分数识别真实调控联系的能力。 |
| d | 在 Gasperini CRISPR 数据上重复距离分层评估,提供另一实验来源验证。 |
| e | 比较 TRIP 报告基因表达与预测 DNase 信号、不同预测分数的相关性;考察插入位置的染色质背景对表达的影响。 |
远端 CRISPR 阳性与无效 CRE 是评估贡献排序的核心,而不是注意力本身。按距离分层检验 524 kb 信息的增量价值;不同 CRISPR 数据再测增强可信度。TRIP 询问的是报告构建在不同插入背景中的表现,具有位置依赖意义,仍不能代替某个原生 enhancer–gene 的验证。应保持内源调控和插入报告两类实验的解释边界。
Figure 5:eQTL 效应与负选择
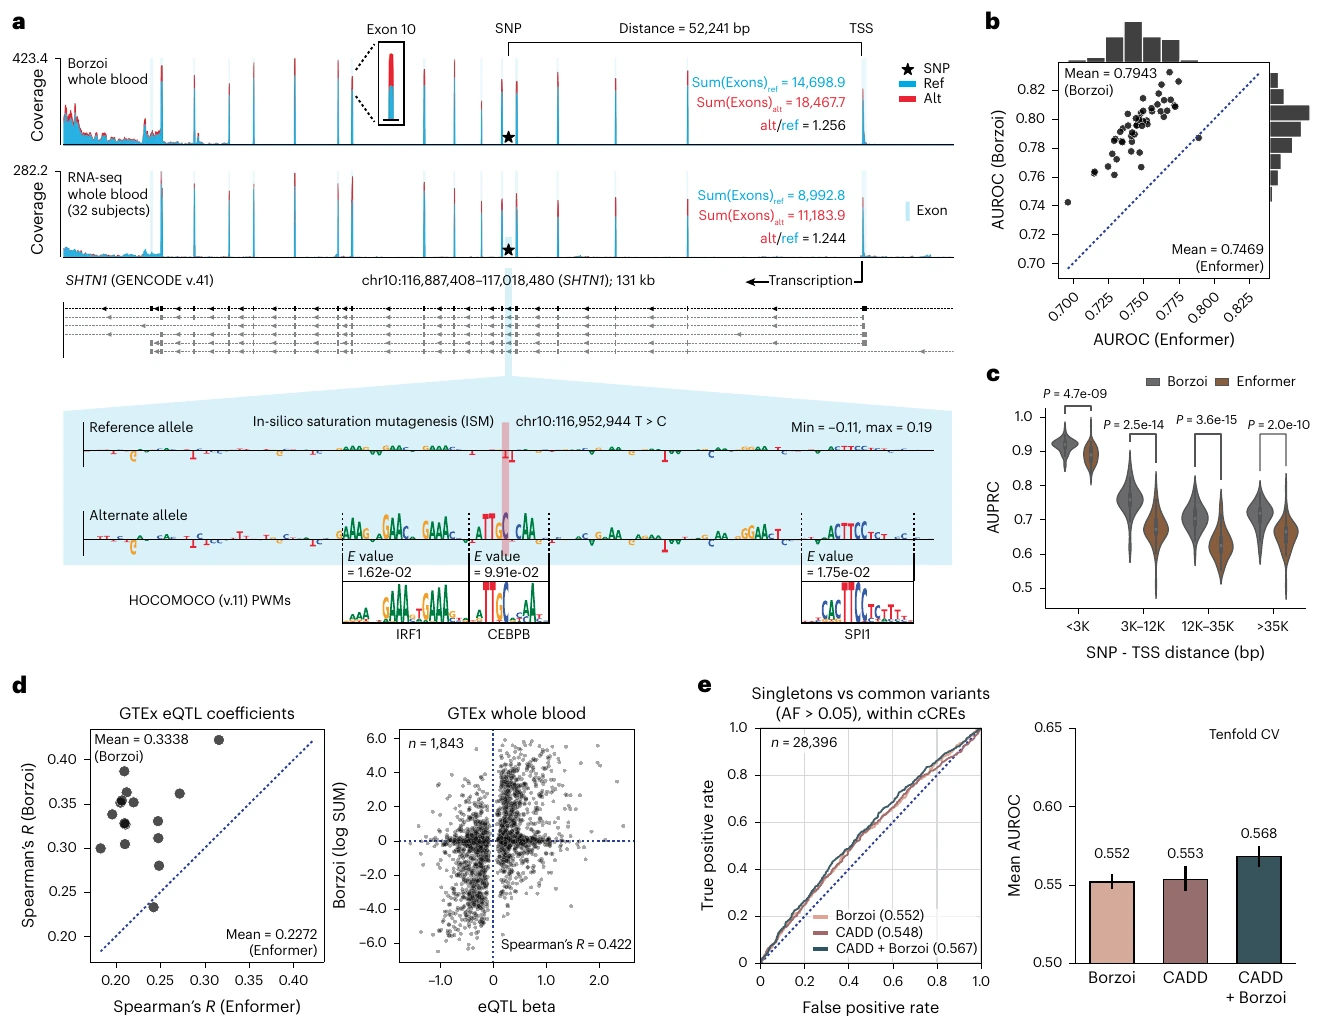
原图来源:所用 PDF 文件第 7 页,Figure 5。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | rs1905542 参考/替代等位基因预测与人群 RNA-seq 覆盖对照,计算突变定位可能的基序改变。 |
| b | 逐组织比较精细定位 eQTL 分类 AUROC,检查 Borzoi 与 Enformer 的总体排序。 |
| c | 按 TSS 距离比较 AUPRC,评估近端与远端变异。 |
| d | 比较 eQTL 预测与实测效应大小的 Spearman 相关,并展示血液具体散点,检验方向和幅度。 |
| e | 用 cCRE 中的 singleton 与常见变异比较 ROC/AUROC;高预测效应与受负选择的罕见变异相关。 |
a 的携带者 RNA 与双等位预测连接功能方向,b/c 看因果候选排序,d 看效应量,e 看人群选择,四种指标不能相互替代。eQTL 精细定位仍含不确定性,选择背景也受频率和可突变性影响。负选择支持功能重要性,并不特指 AD;常见变异具有较小预测效应也不等于对复杂性状没有作用。
Figure 6:可变加尾及 3′ paQTL
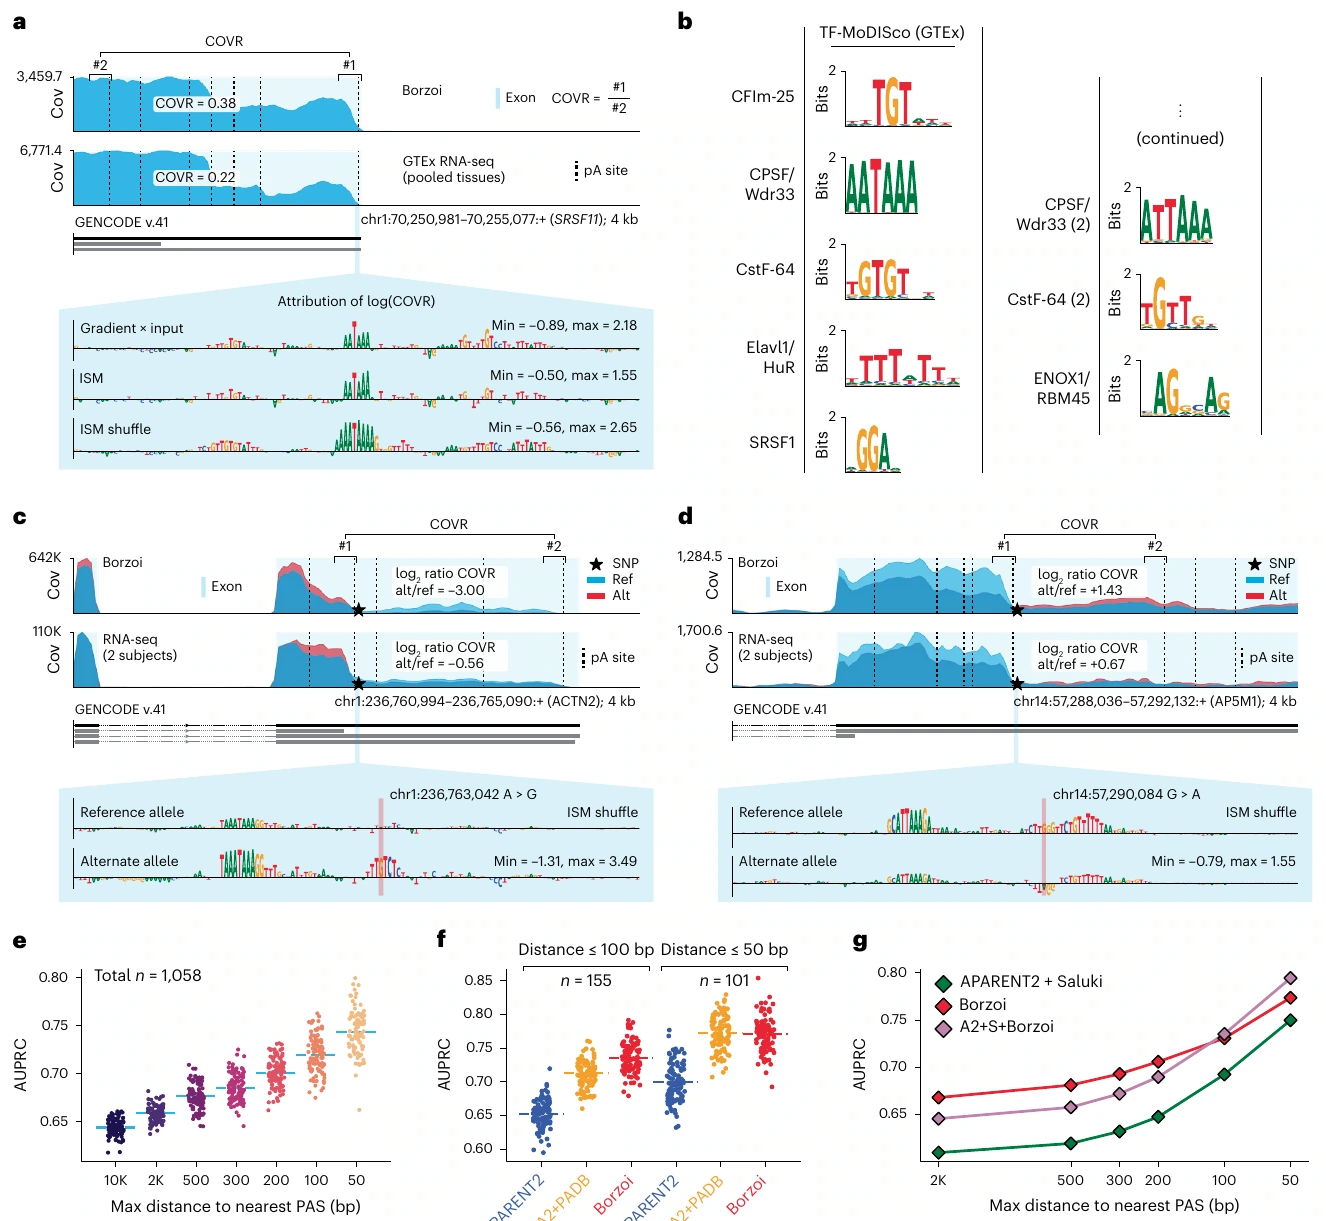
原图来源:所用 PDF 文件第 8 页,Figure 6。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | SRSF11 远端加尾位点的覆盖比定义及梯度/计算突变图,解释从覆盖读出 APA。 |
| b | 覆盖比贡献片段汇总出的已知加尾调控基序,验证模型信息。 |
| c | rs114880747 携带者与非携带者覆盖对比,贡献提示获得 CstF 基序,改变加尾使用。 |
| d | rs80168986 的预测/实测覆盖变化,贡献提示获得 HNRNPA1 基序。 |
| e | 按距 3′ UTR 加尾位点阈值检验精细定位 paQTL 分类 AUPRC。 |
| f | 比较 Borzoi、APARENT2,以及结合 PolyADB 加尾位点注释的 APARENT2,评价不同 APA 方法的互补性。这里的注释指 RNA 加尾位点,帮助模型判断哪些位置可作为备选终止位置。 |
| g | 随位点距离改变比较模型及集成 AUPRC,检验综合信息能否提高远端变异识别。 |
覆盖比使 APA 变成可计算读出,实例与基序贡献再提出具体机制。APARENT2 是专门加尾模型,加入真实位点注释或与 Borzoi 集成可能互补,所以比较必须交代注释输入是否额外提供信息。paQTL 距离分层检验附近和较远变异的不同难度;最稳健结论是覆盖模型含有 APA 信息,而非所有覆盖变化都来自加尾。
Figure 7:剪接及内含子加尾 QTL
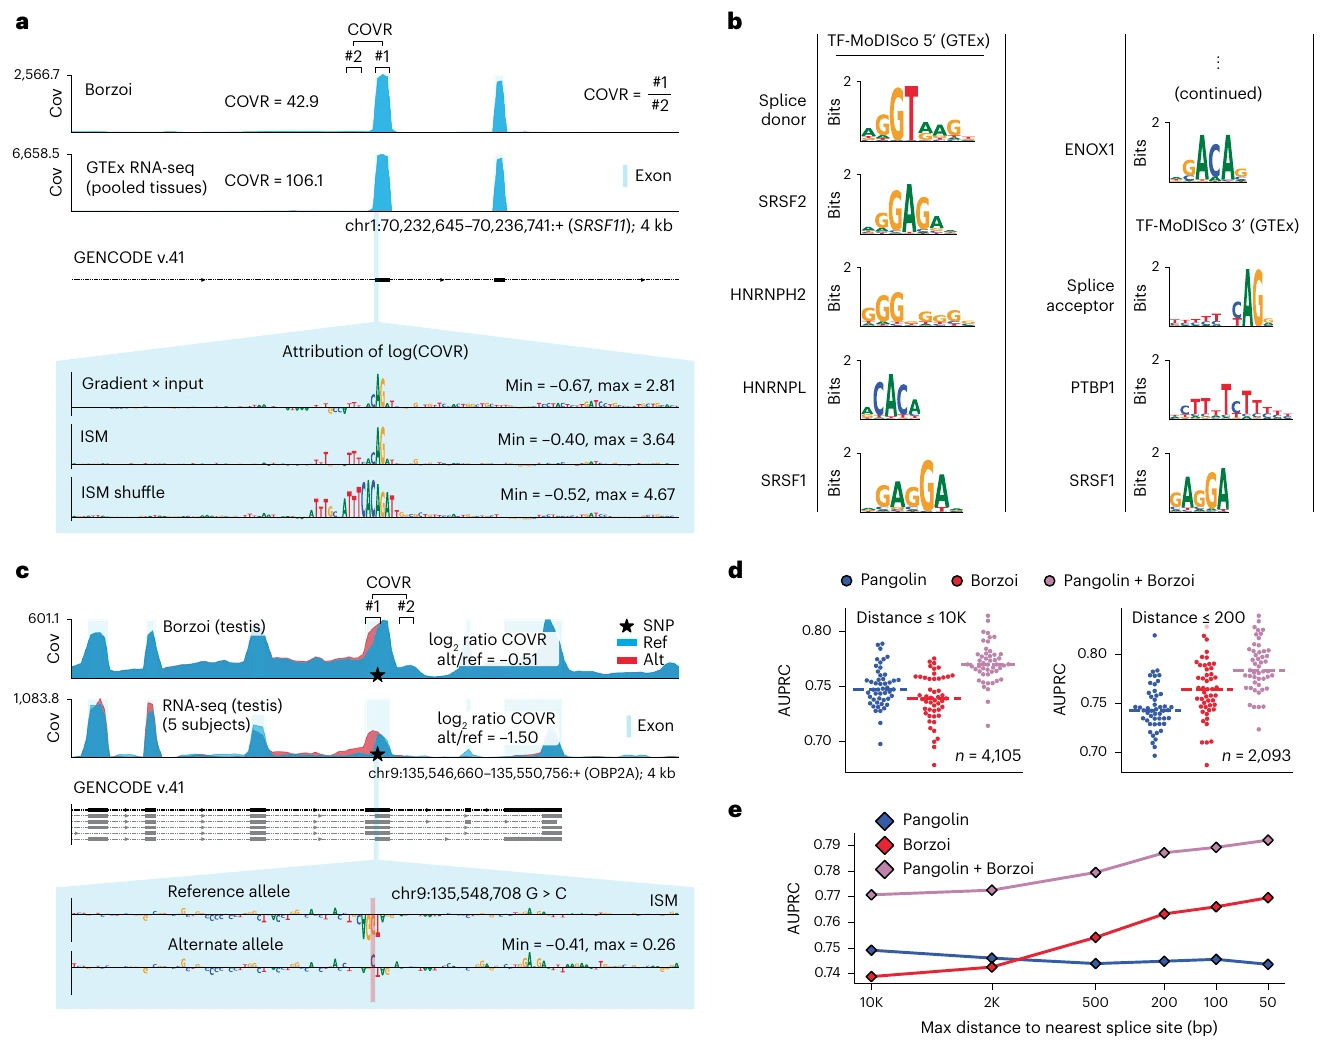
原图来源:所用 PDF 文件第 9 页,Figure 7。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | SRSF11 的外显子/内含子覆盖比与贡献图,解释从 RNA 覆盖识别剪接变化。 |
| b | MoDISco 提取的候选剪接调控基序,说明覆盖预测捕捉到剪接序列信息。 |
| c | rs55695858 在睾丸的预测/实测覆盖比较,显示变异导致的局部剪接差异。 |
| d | 按距剪接连接的距离阈值比较 Borzoi、Pangolin 及集成模型的 sQTL 分类 AUPRC。 |
| e | 将 d 的逐组织结果平均,展示不同距离下的性能及两模型互补性。 |
外显子/内含子覆盖比同时可能反映剪接与内含子加尾,因此实例 RNA 和注释有助于拆分机制。与 Pangolin 及集成比较说明统一模型不必在所有专门任务上独占优势。远离剪接位点的预测尤其依赖背景与覆盖。新研究应保存异常连接、表达和 3′ 端读出,避免一个‘RNA 效应’分数抹平不同生物学原因。
我的理解与可迁移设计
最可迁移的设计是统一测量、分解终点:先共享表征,再以有机制含义的统计量评价。AD 非编码变异可能同时影响表达和转录本,不能只用基因总量标签训练后便宣称解释所有 RNA 后果。对 16 GB 环境,优先离线调用预训练模型得到有限位点特征;原模型训练和全基因组饱和扫描不适合首轮。新增工作应依靠真实等位标签证明某一种机制的增益,并为不同细胞背景单独检查,而不是以更长输入本身作为创新。
