75.C-Origami:原图、模型逻辑与研究范式

75.C-Origami:原图、模型逻辑与研究范式
Perry论文题名: Cell-type-specific prediction of 3D chromatin organization enables high-throughput in silico genetic screening
期刊与年份: Nature Biotechnology,2023。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
本篇问题: 加入细胞状态数据能否预测细胞特异三维染色质及遗传扰动后的结构?
为什么三维预测需要细胞状态输入
同一份参考 DNA 在不同细胞中会形成不同的染色质接触。仅输入序列,模型可以学习某类细胞的结构平均规律,却没有信息说明这次要预测哪种细胞。C.Origami 因此把 CTCF ChIP-seq 与 ATAC-seq 作为状态条件,再用 Hi-C 监督。对研究构思的解释属于我的推测:作者并非先选 Transformer 再寻找应用,而是从“序列不够指定细胞状态”的缺口出发,选择兼顾结构边界与开放调控区的两类实验输入。
输入是约 2 Mb 的五通道 DNA 和两条连续实验信号;卷积编码器把长度压缩成 256 个位置,Transformer 交换远距信息,再把各位置两两拼接,交给二维膨胀卷积生成 256×256 接触矩阵。训练目标是处理后的 Hi-C 强度均方误差,输出约 8 kb 分辨率,不是逐碱基物理接触,也没有直接预测基因表达。研究范式是“条件预测—虚拟扰动筛选—实验与疾病背景核验”。它可以从一个细胞类型向新细胞推广,但新细胞仍需提供 CTCF 和 ATAC 测量,不能称为只用 DNA 的完全零数据预测。
Figure 1:细胞类型特异三维染色质预测模型
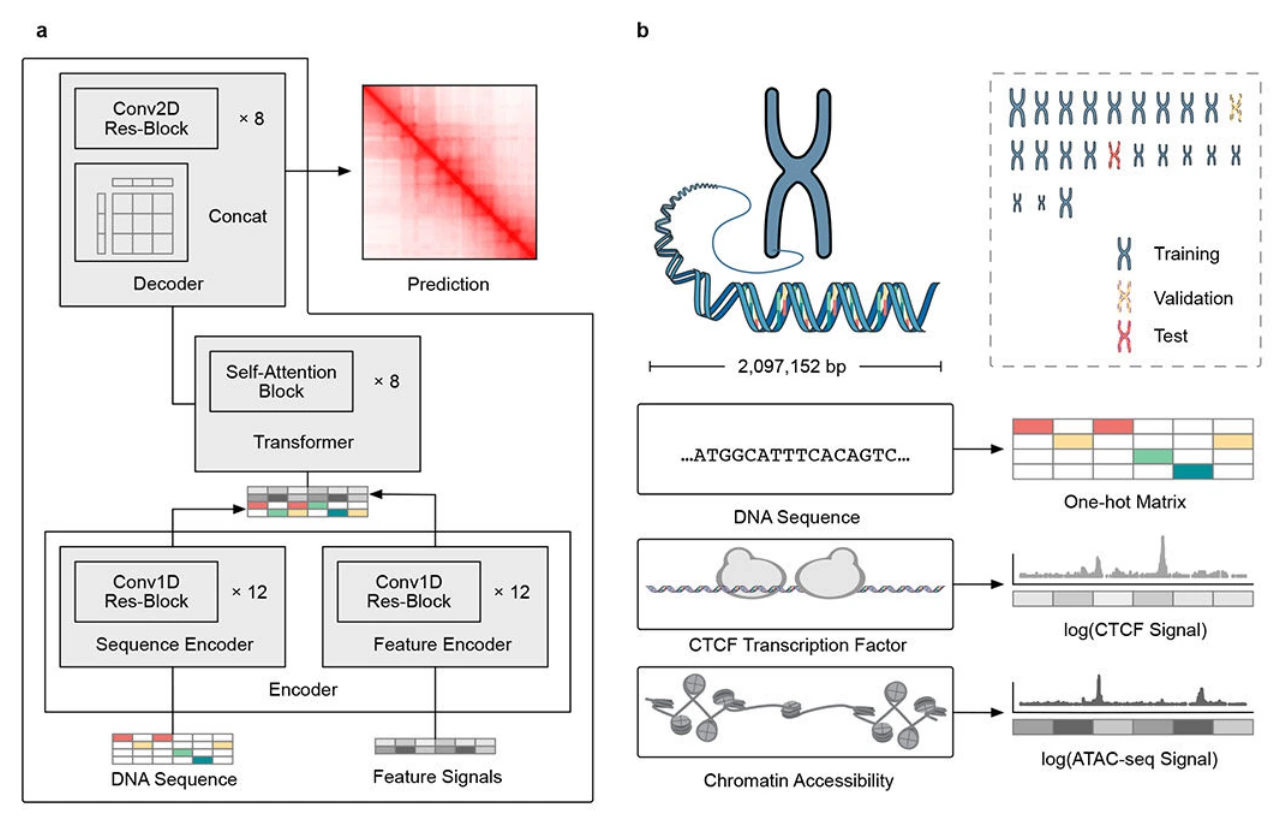
原图来源:所用 PDF 文件第 36 页,Figure 1。点击图片可查看原图。
a、b 用两套编码器解决信息尺度不同的问题:DNA 负责潜在结合语法,连续 CTCF 与 ATAC 指定哪些位置在目标细胞中实际呈现相应状态。二维解码器则适配接触矩阵,而不是把一维序列输出勉强当成相互作用。两两拼接是建立候选位置关系的计算操作,尚不证明每一对位置有真实接触。输入压缩能够降低远距建模成本,也意味着细小序列变化要经过多层汇总;读出分辨率限制了可验证问题的粒度。架构合理性最后仍需通过图 2 的输入消融确认。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | C.Origami网络结构,整合序列与细胞状态数据。 |
| b | 输入DNA、CTCF ChIP和ATAC,输出2Mb窗口Hi-C矩阵,说明细胞特异信息如何进入预测。 |
Figure 2:三维接触矩阵预测准确性
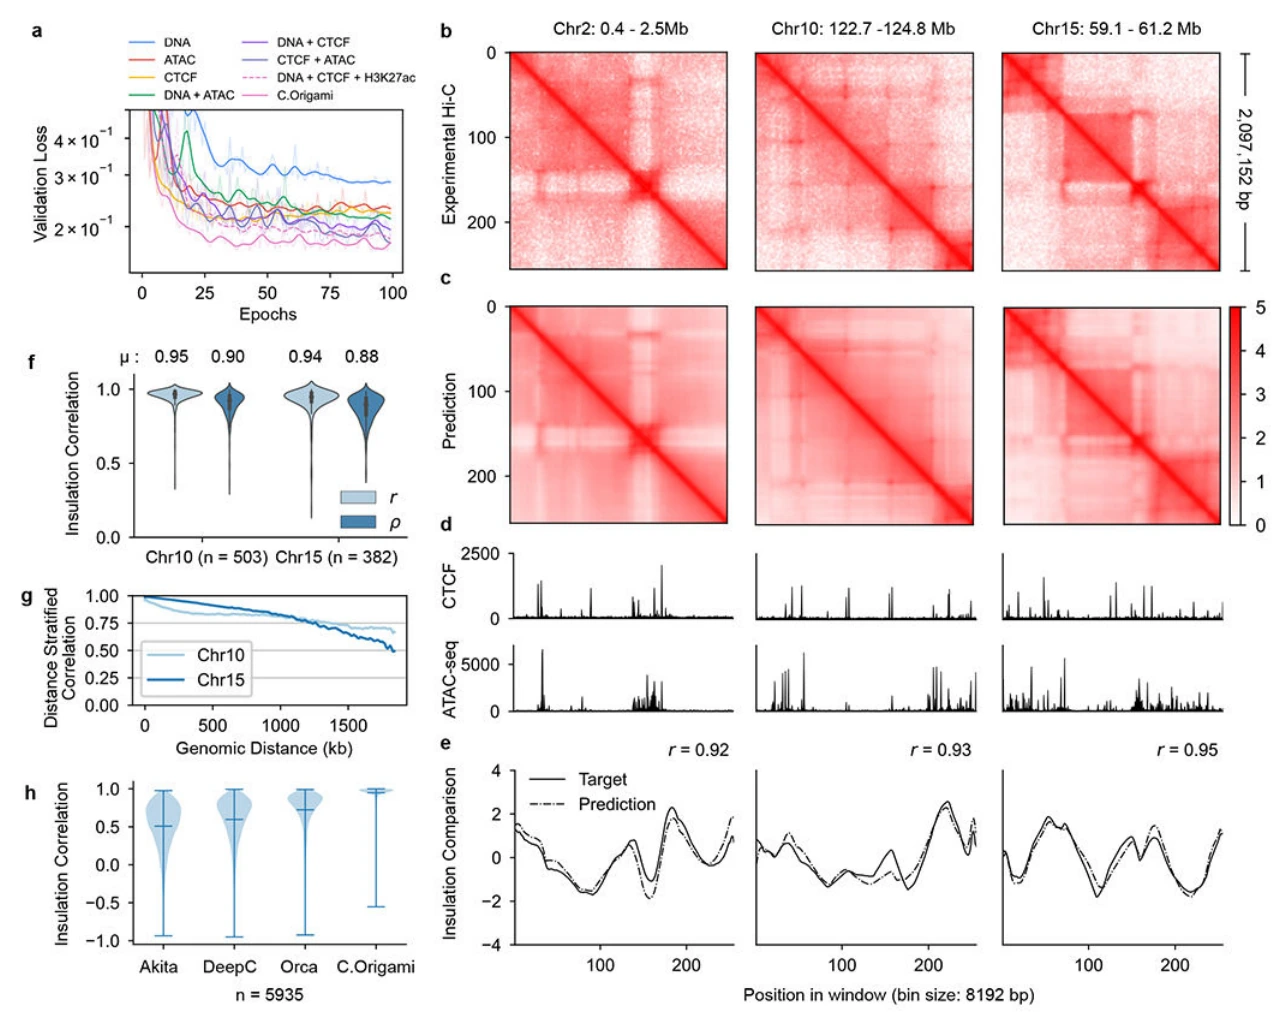
原图来源:所用 PDF 文件第 37 页,Figure 2。点击图片可查看原图。
a 的全部输入组合训练提供比较干净的证据:序列、CTCF、开放度都对预测有贡献。b–f 从矩阵外观推进到绝缘曲线,并包含染色体留出,避免只在训练窗口里证明会重建。绝缘相关高主要支持边界结构恢复,不能替代所有增强子—启动子接触的准确率。g 把距离分层,防止普遍存在的近距高信号掩盖远距误差。h 的方法比较还需结合 Methods:不同模型的输出经过裁切、重采样和按距离调整到实验目标的均值、标准差。这是为了比较结构,但对强度误差的解读依赖该校准;它不是未经目标校准的绝对接触强度竞赛。
C.Origami 比序列模型多用了两类实验信息,因此胜出支持“这些条件信息有用”,不能单独证明网络架构本身更优秀。训练与评估细胞、输入长度及目标处理也应同时报告,才有机会复现公平的结论。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 不同输入组合的验证损失,检验序列、CTCF及开放度各自贡献。 |
| b | IMR-90训练、验证、测试染色体的实测Hi-C矩阵,提供实验参照。 |
| c | 对应预测矩阵,检查未见染色体的边界及接触模式。 |
| d | 输入CTCF和ATAC轨迹,连接预测结构与细胞调控状态。 |
| e | 实测和预测绝缘分数及相关,评价TAD边界定位。 |
| f | 全部验证/测试窗口的绝缘Pearson与Spearman相关,检验整体表现。 |
| g | 按接触距离分层的相关,避免短距强接触掩盖长距误差。 |
| h | 与Akita、DeepC、Orca的绝缘相关比较,评估多输入模型的收益。 |
Figure 3:跨细胞类型从头预测
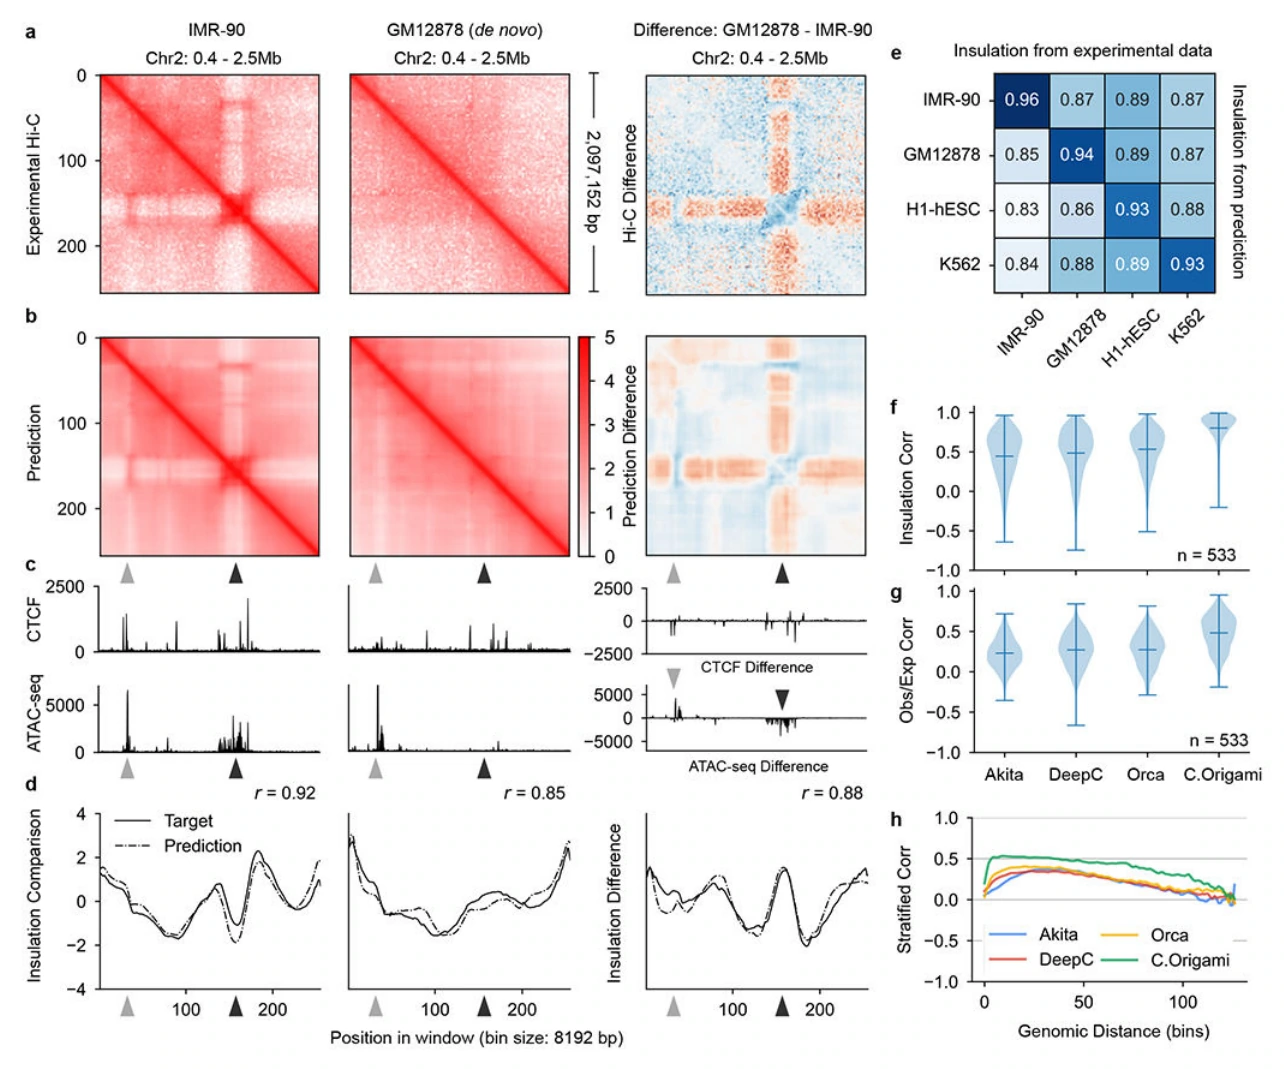
原图来源:所用 PDF 文件第 38 页,Figure 3。点击图片可查看原图。
a–d 在同一基因组位置更换状态输入,检验的是真正的细胞差异而非不同位置的天然差异。e–h 还专门分析结构差异区域,因为大多数边界保守,简单全基因组高相关可能只反映共享骨架。此处差异区域由实测 Hi-C 识别,作用是评估模型能否恢复已知差异,不是一个无需目标 Hi-C 就能确定的临床筛查规则。预测与同细胞实验最相符,支持模型利用状态条件;不能推导其可以预测细胞命运或病理进展。
跨细胞成功还有适用边界:新的输入轨道要采用相近预处理和覆盖标准。如果 AD 公共数据只有 ATAC、缺少相应细胞 CTCF,直接把另一细胞的 CTCF 轨道补上会改变任务定义,应作为有缺失条件的模型另行验证。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | IMR-90与GM12878实测矩阵及差异,标出细胞特异接触。 |
| b | 预测矩阵与预测差异,检查模型能否再现细胞特异结构。 |
| c | 两细胞的CTCF/ATAC输入轨迹,解释差异的状态信息来源。 |
| d | 实测与预测绝缘曲线,检查边界差异。 |
| e | 不同细胞类型的绝缘相关,评估泛化。 |
| f | GM12878从头预测的绝缘相关,与仅序列模型比较。 |
| g | GM12878观测/期望矩阵相关,评价去除距离背景后的结构预测。 |
| h | GM12878距离分层相关,进一步检验不同接触距离的性能。 |
Figure 4:易位和删除扰动后的三维结构
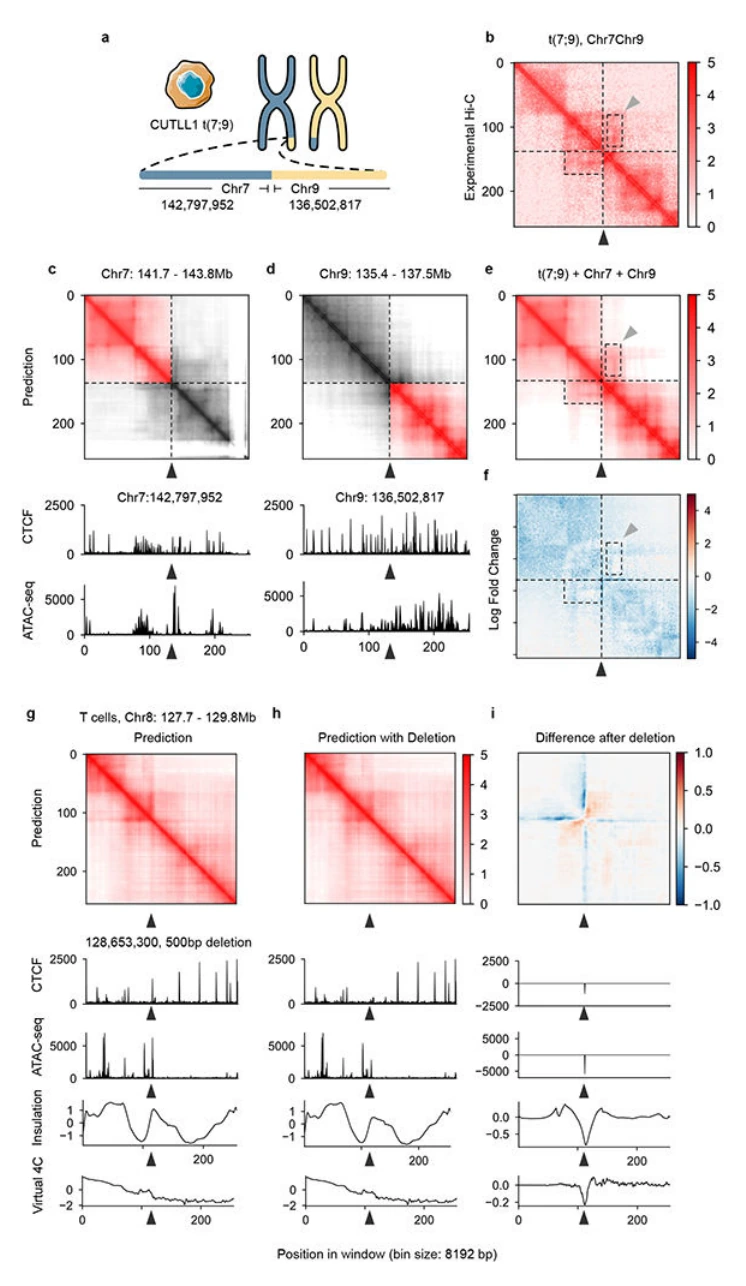
原图来源:所用 PDF 文件第 39 页,Figure 4。点击图片可查看原图。
a–f 把参考顺序重组为易位染色体,检查模型对超出正常窗口关系的结构泛化。CUTLL1 的易位是杂合的,实验混有正常与易位等位基因,Methods 因而将两类预测平均再比较;不能把矩阵吻合解释成纯易位等位基因的直接精确测量。g–i 的 MYC 区域删除有既往实验结果作参照,比只有虚拟热图更有说服力。本 PDF 图注将 g/h 的删除状态写反,与原图标签及正文不一致。视觉核对显示 g 标为 Prediction,是未删除基线;h 明确标为 Prediction with Deletion,是删除后预测,且相应 CTCF 轨道的尖峰被移除。本解读据原图标签与轨道修改解释,并保留图注冲突记录。
虚拟删除不仅移除 DNA,还同步处理相应状态轨道,并在末端补齐输入。它在问这一输入区域对模型预测有多重要;真实细胞删除后的 CTCF 重新分布、开放度反馈和代偿,并不会由这个操作自动模拟。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | CUTLL1中t(7;9)易位示意,定义重排。 |
| b | 按易位参考染色体映射的实测Hi-C,展示新接触域。 |
| c | 未易位染色体7的预测矩阵,提供重排前参照。 |
| d | 未易位染色体9的预测矩阵,提供另一侧参照。 |
| e | 易位后的预测矩阵呈现neo-TAD和条带,检验重排结构预测。 |
| f | 易位位点实测对预测的log倍数差异,展示剩余误差。 |
| g | MYC位点未删除基线预测矩阵。原图标为 Prediction;本 PDF 图注对 g/h 状态写反,此处以原图与正文为准。 |
| h | 删除500bp CTCF结合区后的预测矩阵。原图标为 Prediction with Deletion,CTCF轨道相应尖峰消失;本 PDF 图注对 g/h 状态写反。 |
| i | 两矩阵差值及虚拟4C,定位删除导致的特定环化变化。 |
Figure 5:计算机内遗传筛选发现结构元件
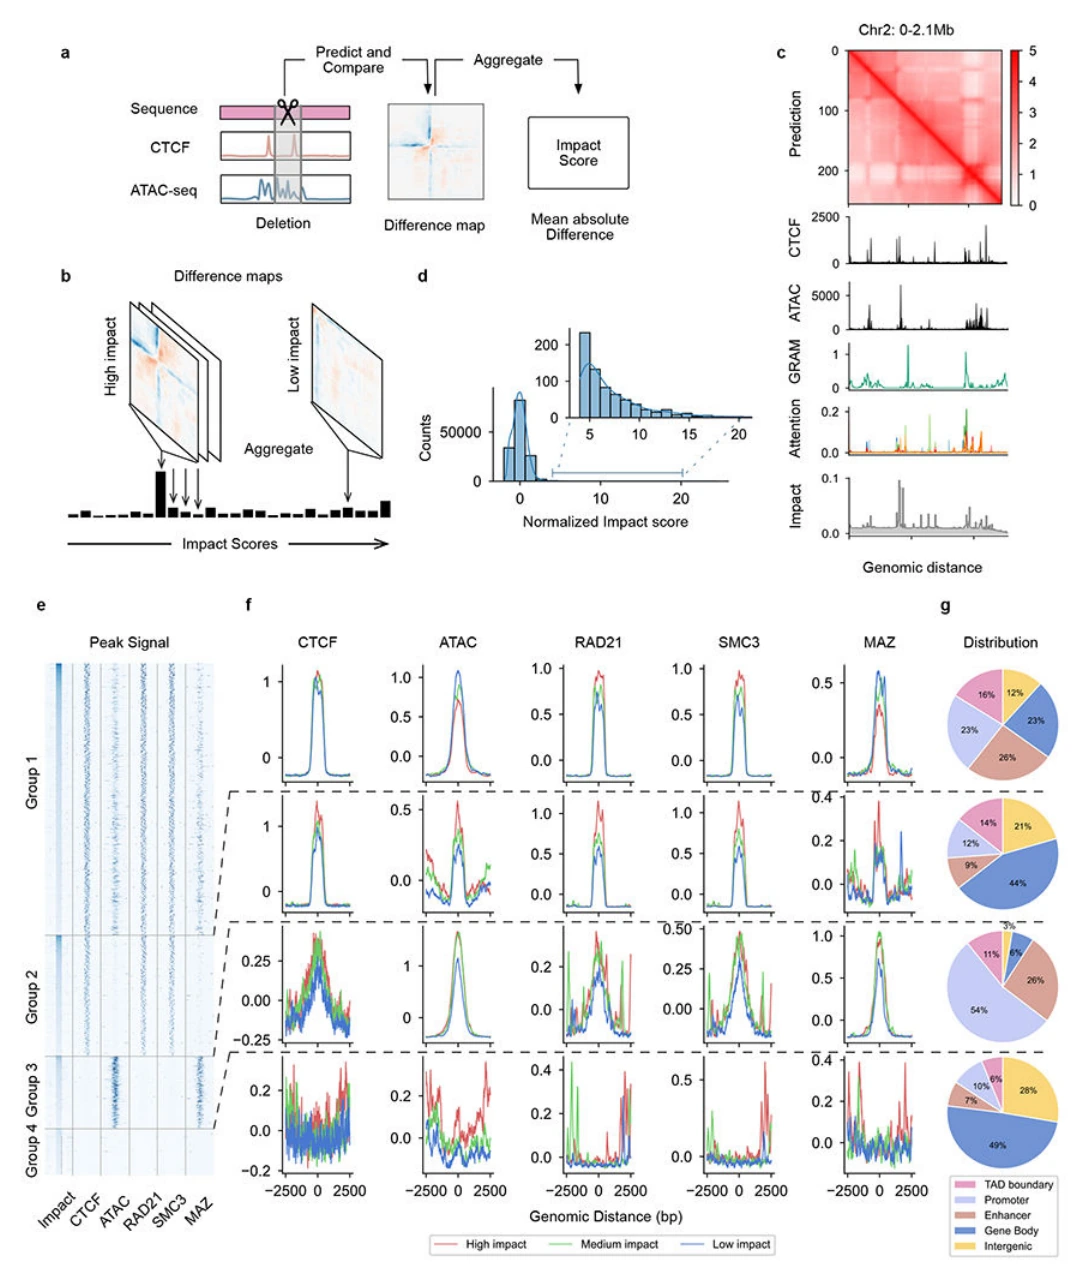
原图来源:所用 PDF 文件第 41 页,Figure 5。点击图片可查看原图。
a–c 比较梯度、注意力和删区后的矩阵变化,强调“关注某位置”与“改掉该位置会怎样”是不同的问题。impact score 是两张预测的平均绝对差,越大只说明模型结构输出越敏感,既不携带变化方向,也不是致病概率。d–g 再把高分元件按 CTCF 与开放度分组,寻找结构调控模式。所谓全基因组 1 kb 筛选,Methods 实际采样了十条染色体代表基因组;约前 1% 的阈值是筛选规则,不能说整个基因组只有这些必需结构元件。
非 CTCF 开放元件及 MAZ 富集提出了额外结构机制的候选。富集建立的是统计关联,而且部分输入正是 CTCF 和 ATAC;重现这些信号本身有一定预期。要确认一种新结构蛋白,应依赖独立结合数据和扰动,而不是把四组热图中的富集直接写成必要性。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 删除候选元件并计算预测接触变化,定义impact score。 |
| b | 高通量ISGS扫描流程,说明如何遍历顺式调控元件。 |
| c | GRAM、注意力与删除影响评分的归因比较,展示三种定位方式。 |
| d | 删除筛选分数分布,定义强影响元件的范围。 |
| e | 高影响1kb元件中心附近热图按评分排序,展示典型轨迹组织。 |
| f | 四类元件的ATAC及多种ChIP富集,并按影响强弱分层,寻找结构调控蛋白。 |
| g | 筛选元件的基因组注释分布,描述其与已知功能区域的关系。 |
Figure 6:细胞特异结构元件与反式调控因子
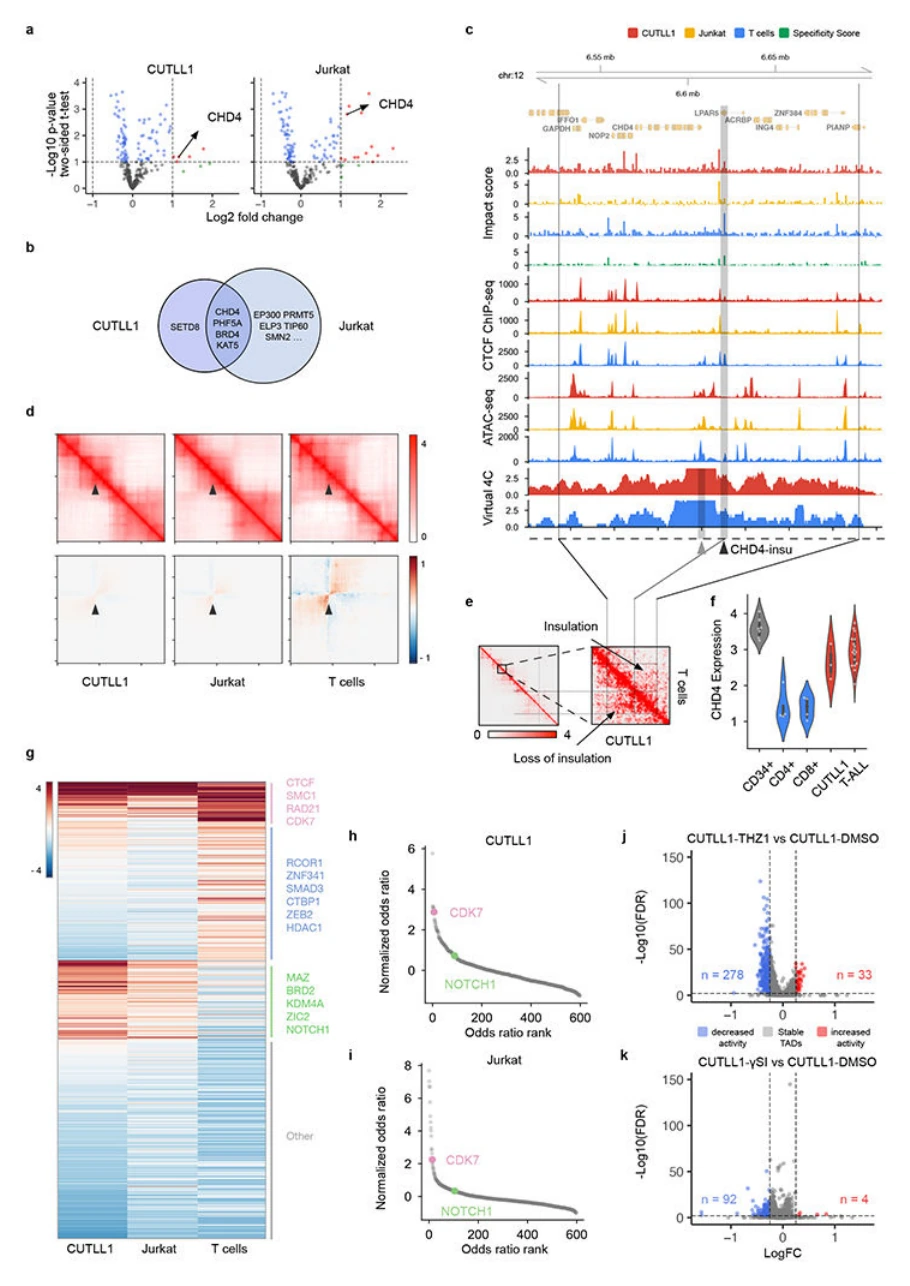
原图来源:所用 PDF 文件第 43 页,Figure 6。点击图片可查看原图。
a、b 是真实的染色质调控基因 CRISPR 筛选,gRNA 随增殖改变,证明 CHD4 等基因影响白血病细胞生长。c–f 将 CHD4 周围的虚拟删区、CTCF 缺失、实验接触和表达升高连起来,提供可检验的局部调控假说。然而敲除 CHD4 基因与敲除 CHD4-insu 元件是两种实验,前者并没有证明后者通过这个接触链促进增殖。本文这里更稳妥的结论是证据相互吻合、提示失去绝缘可能增加表达。
g–i 用筛选区域与 ReMap 结合谱的重叠寻找反式因子,再把 CDK7 与 NOTCH1 的相对排名拿到 j、k 的抑制实验中核验。CDK7 抑制影响更多 TAD,支持其较广泛的结构作用,但药物效应还可能包含转录和细胞状态的间接变化。因子富集排序不等于每个候选都是直接结构蛋白,治疗靶点仍要逐一验证。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | CUTLL1、Jurkat染色质调控基因CRISPR筛选火山图,gRNA丰度变化反映靶向后增殖效应。 |
| b | 两细胞筛选命中重叠,区分共享与细胞特异依赖。 |
| c | CHD4位点影响评分、CTCF、ATAC及虚拟4C,标出T细胞特异CHD4-insu元件。 |
| d | 不同细胞中删除CHD4-insu后的预测矩阵及差异,展示细胞特异结构作用。 |
| e | CUTLL1与T细胞实测Hi-C,为CHD4局部结构提供实验参照。 |
| f | CHD4表达分布,连接结构状态与基因表达背景。 |
| g | 各细胞反式因子富集热图,寻找与高影响元件对应的调控蛋白。 |
| h | CUTLL1反式因子排名的肘部图,突出CDK7与NOTCH1。 |
| i | Jurkat的对应排名,检验两细胞共享候选因子。 |
| j | 抑制CDK7后3672个TAD的结构变化火山图,验证候选反式因子的作用。 |
| k | 抑制NOTCH1后的结构变化火山图,检验另一候选因子。 |
可以怎样借鉴到 DNA 与疾病研究
这篇最有启发的地方是明确了虚拟扰动的读出:删掉元件后,具体哪类接触改变,而不是只得到一个抽象的重要性分数。对于 TE 重叠变异,可以先提出“这个家族在某细胞中承担边界或接触锚点”的问题,按家族、可比对性、开放度和 CTCF 信号匹配非候选拷贝,再比较结构敏感性。候选排序之后需用独立 Hi-C、QTL 或扰动数据检验;模型敏感性不能代替变异的临床致病证据。
另外,输入包含实测细胞状态的优势,也是因果解释的限制。若风险变异通过改变开放度影响接触,保持 ATAC 不变只是在条件固定下估计序列直接效应;同时删除 ATAC 则模拟了另一种假设。研究前必须声明要问哪一种。原训练使用四张 V100,轻量设备快速推理的结果不代表单张 16 GB 能原样训练。计算资源有限时,先用预训练模型验证候选机制和读出增益,比重新训练整套三维网络更实际。
