26.CODE-AE:原图、模型逻辑与研究范式

26.CODE-AE:原图、模型逻辑与研究范式
Perry论文题名: A context-aware deconfounding autoencoder for robust prediction of personalized clinical drug response from cell-line compound screening
期刊与年份: Nature Machine Intelligence,2022。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Nature Machine Intelligence,2022;以当前 PDF 为准。
研究瓶颈怎样转化为问题
细胞系和患者表达既共享药物生物学,又各自包含培养、微环境与技术特征。直接压缩或强制域混合可能丢掉真实响应。CODE-AE 问能否把共享与私有因素分开,只让共享表示服务可迁移预测。依据设计逻辑推断,idea 是利用两域无标签表达学习分解,再在细胞系真实药物标签上训练,而不是先假定任何域差异都应删除。
输入、目标与结构
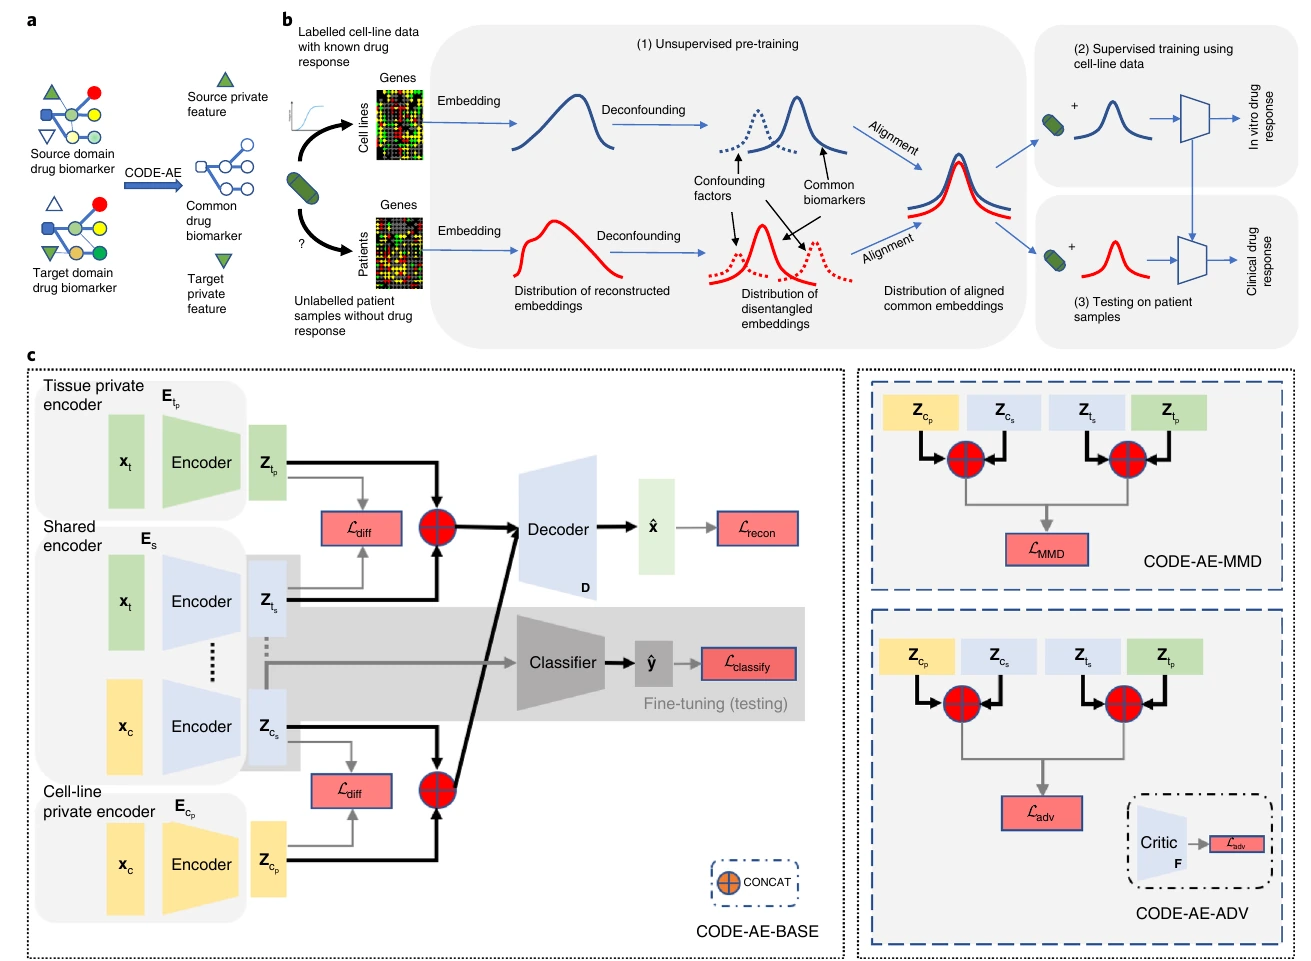
共享编码器加两套域私有编码器共同重建表达;正交损失抑制表示重叠,MMD 或对抗版本进一步对齐共享分布。之后以细胞系药物响应微调,再应用患者。重建、域对齐和响应监督是不同目标,对齐漂亮不等于去掉全部因果混杂。细胞系药物活性、PDTC 分类和临床缩小/复发终点也不同,需要分别验证。目标患者参与无标签学习时,应明确与临床留出设计的关系。
Figure 1:CODE-AE 的共享/私有表示与迁移流程
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 概念示意:细胞系与患者共享药物调控网络,也各有环境特异特征;目标是保留可迁移的药物反应信息。 |
| b | 三个阶段:先用两类无标签表达数据预训练并对齐表示,再以有标签细胞系药物反应微调,最后输入患者表示作推断。 |
| c | 共享编码器学习共同信息,两套私有编码器学习各自背景,解码器重建输入,正交损失减少重叠;MMD 与对抗版本进一步对齐域分布。 |
a 将‘共享’作为待学习的假设,c 的私有分支避免把域特异变化全塞入药物表示。正交是计算约束,不代表生物因素真正独立或唯一可识别;若药物反应只与某域条件共变,仍可能被错误分配。b 的预训练/微调/推断要分开记录,患者没有响应标签不等于患者域完全没参与模型。用于新病种须重检查共享信息是否与真实终点有关。
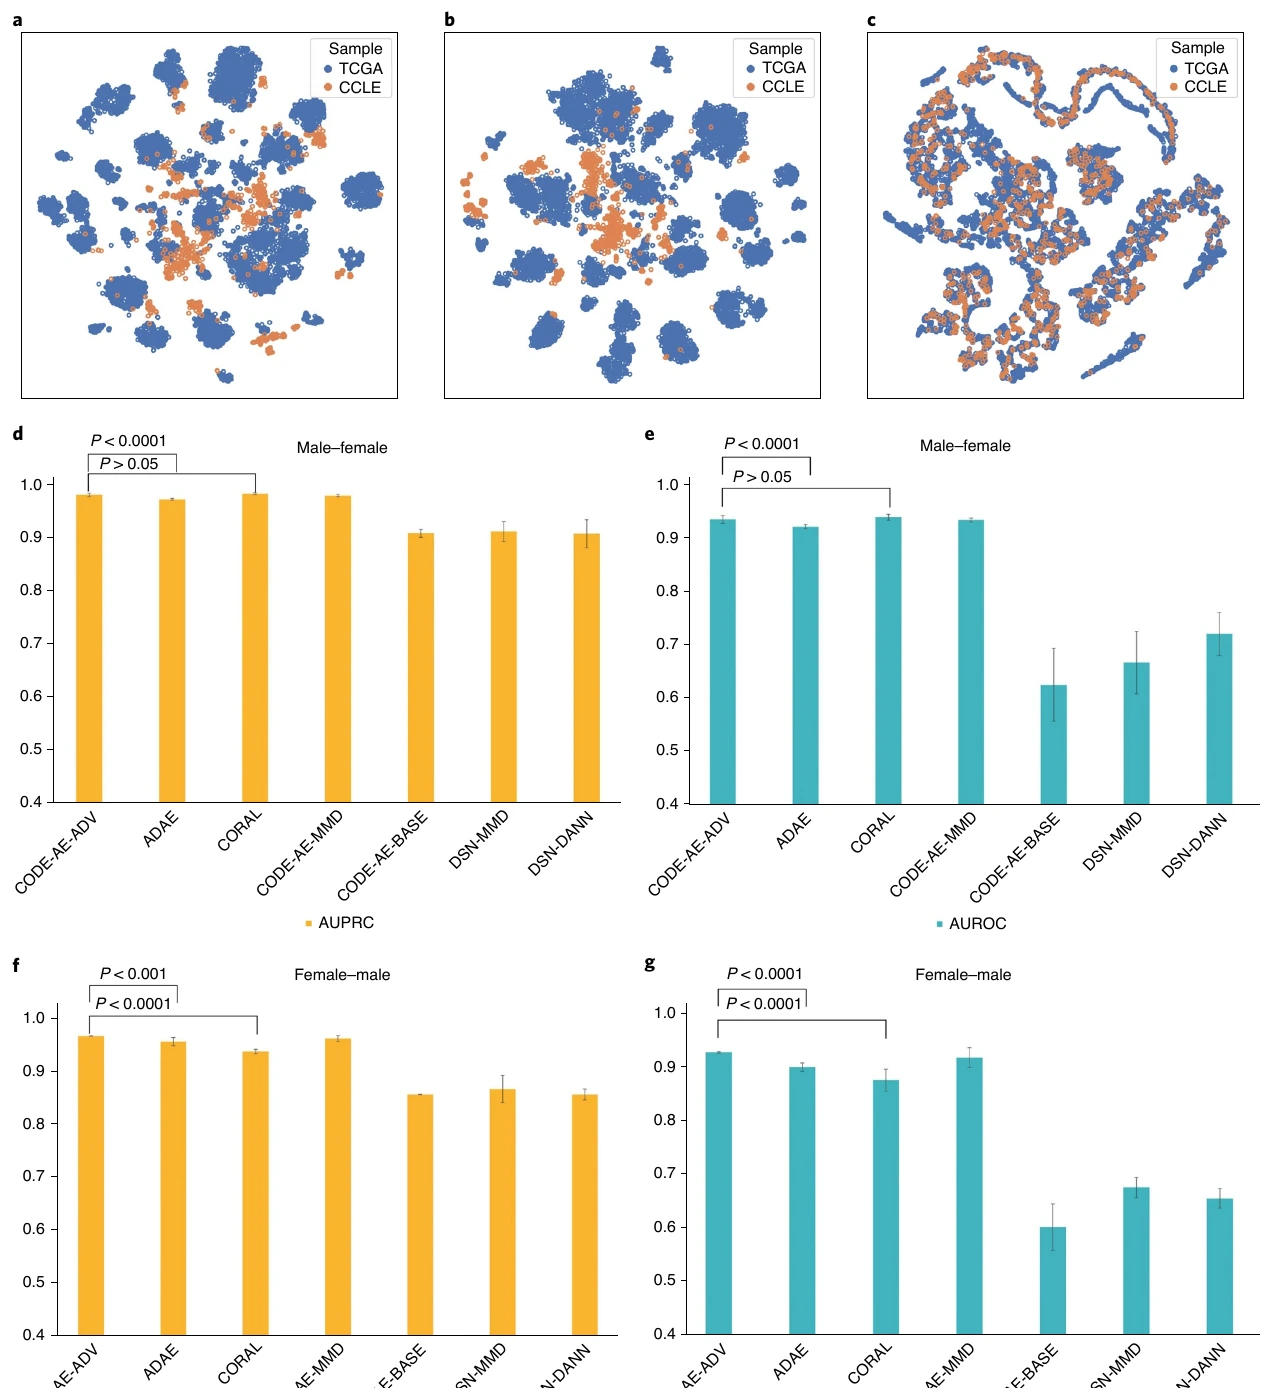
Figure 2:域对齐及性别混杂下的跨组预测
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 原始表达的 t-SNE 展示 TCGA 患者与 CCLE 细胞系有明显数据域差异。 |
| b | 普通自编码器的嵌入仍保留明显域分离,说明压缩表达本身不一定去除背景差异。 |
| c | CODE-AE-ADV 嵌入中两类样本更混合,显示对齐效果;后续预测指标才用于检验这种对齐是否有用。 |
| d | 只在男性样本训练、在女性样本预测癌症亚型,用 AUPRC 比较模型;评估在性别混杂改变时能否迁移。 |
| e | 同一男性到女性任务用 AUROC 评估;与 d 对照,区分排序能力和精确率–召回率表现。 |
| f | 反向在女性训练、男性测试的 AUPRC,检查迁移效果是否具有双向一致性。 |
| g | 女性到男性任务的 AUROC。CODE-AE-ADV 总体表现良好,具体模型对照既有显著也有不显著比较,不能写成胜过全部模型。 |
t-SNE 仅检查嵌入域混合,男女交叉预测才检验相关的泛化。性别是可观察的测试场景,不代表所有未测临床混杂都被去掉;某些性别相关变化也可能为真实生物信息。AUPRC 与 AUROC受不同类别背景影响,各组显著和不显著比较应逐项读。对齐若改善域混合却降低响应,应被视为失败,而非继续宣称去混杂有效。
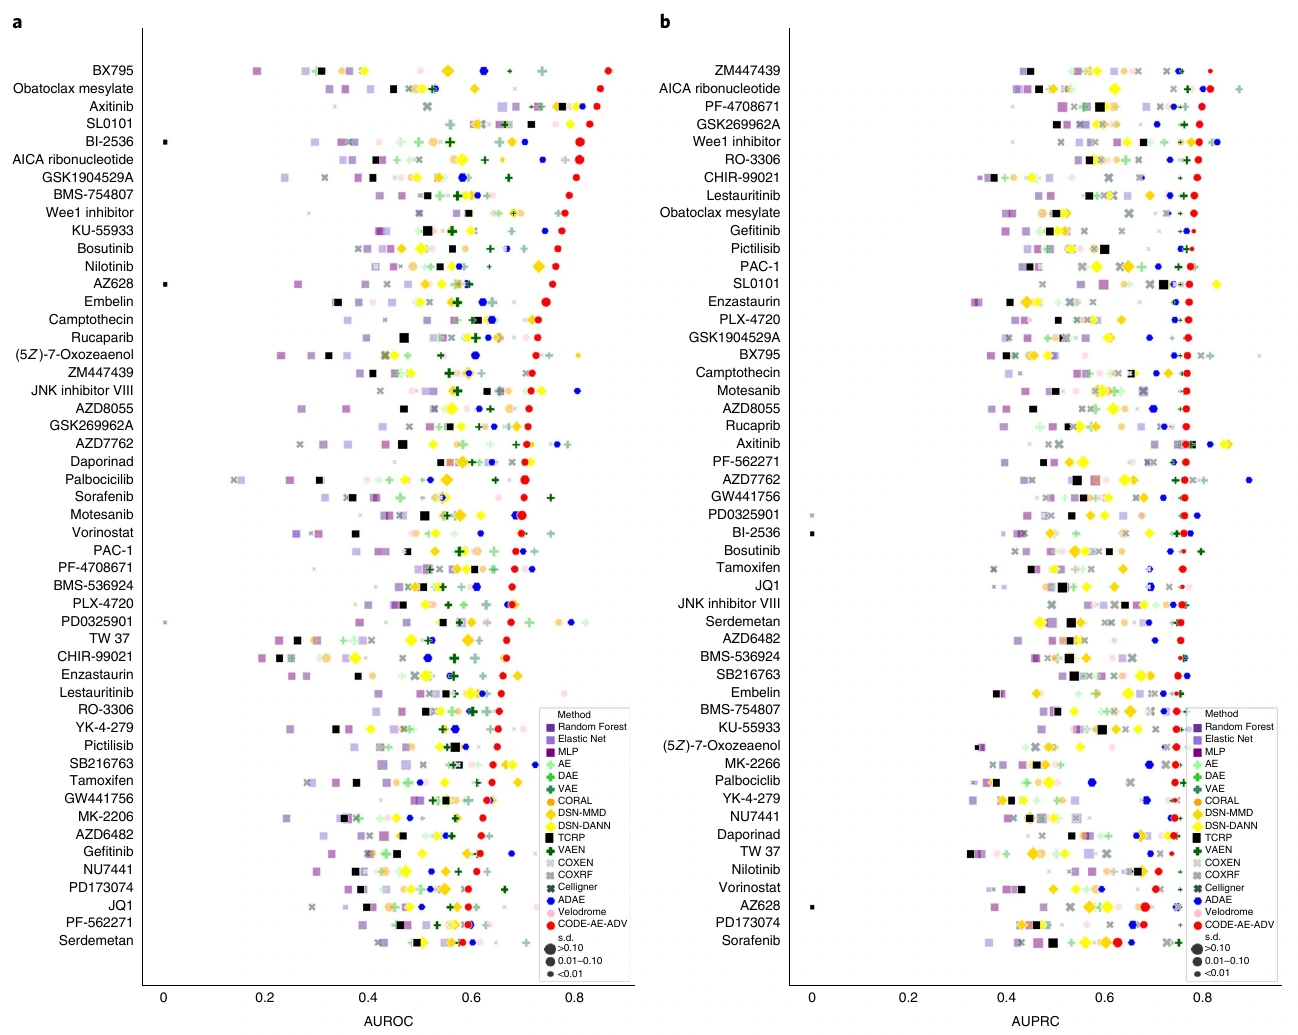
Figure 3:逐药物的 PDTC 反应泛化
原图来源:所用 PDF 文件第 6 页,Figure 3。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 对患者来源肿瘤细胞 PDTC 数据,逐药物比较反应分类 AUROC;检查细胞系训练模型在独立患者来源材料中的区分能力,优势随药物变化。 |
| b | 同一测试的 AUPRC,用来观察阳性反应识别的精确率与召回;CODE-AE-ADV 在多种药物中表现较好,避免用单一平均指标掩盖药物差异。 |
PDTC 提供比普通细胞系更接近肿瘤背景的独立材料,但仍为离体测量,不是患者临床疗效。逐药物 AUROC/AUPRC 检查泛化是否均匀,正例比例也会影响 AUPRC。预测输出和阈值要针对该实验定义校准,不能把一个总体最好方法的名次推广到所有药物,更不能用未知真实标签的大规模筛选作为验证。
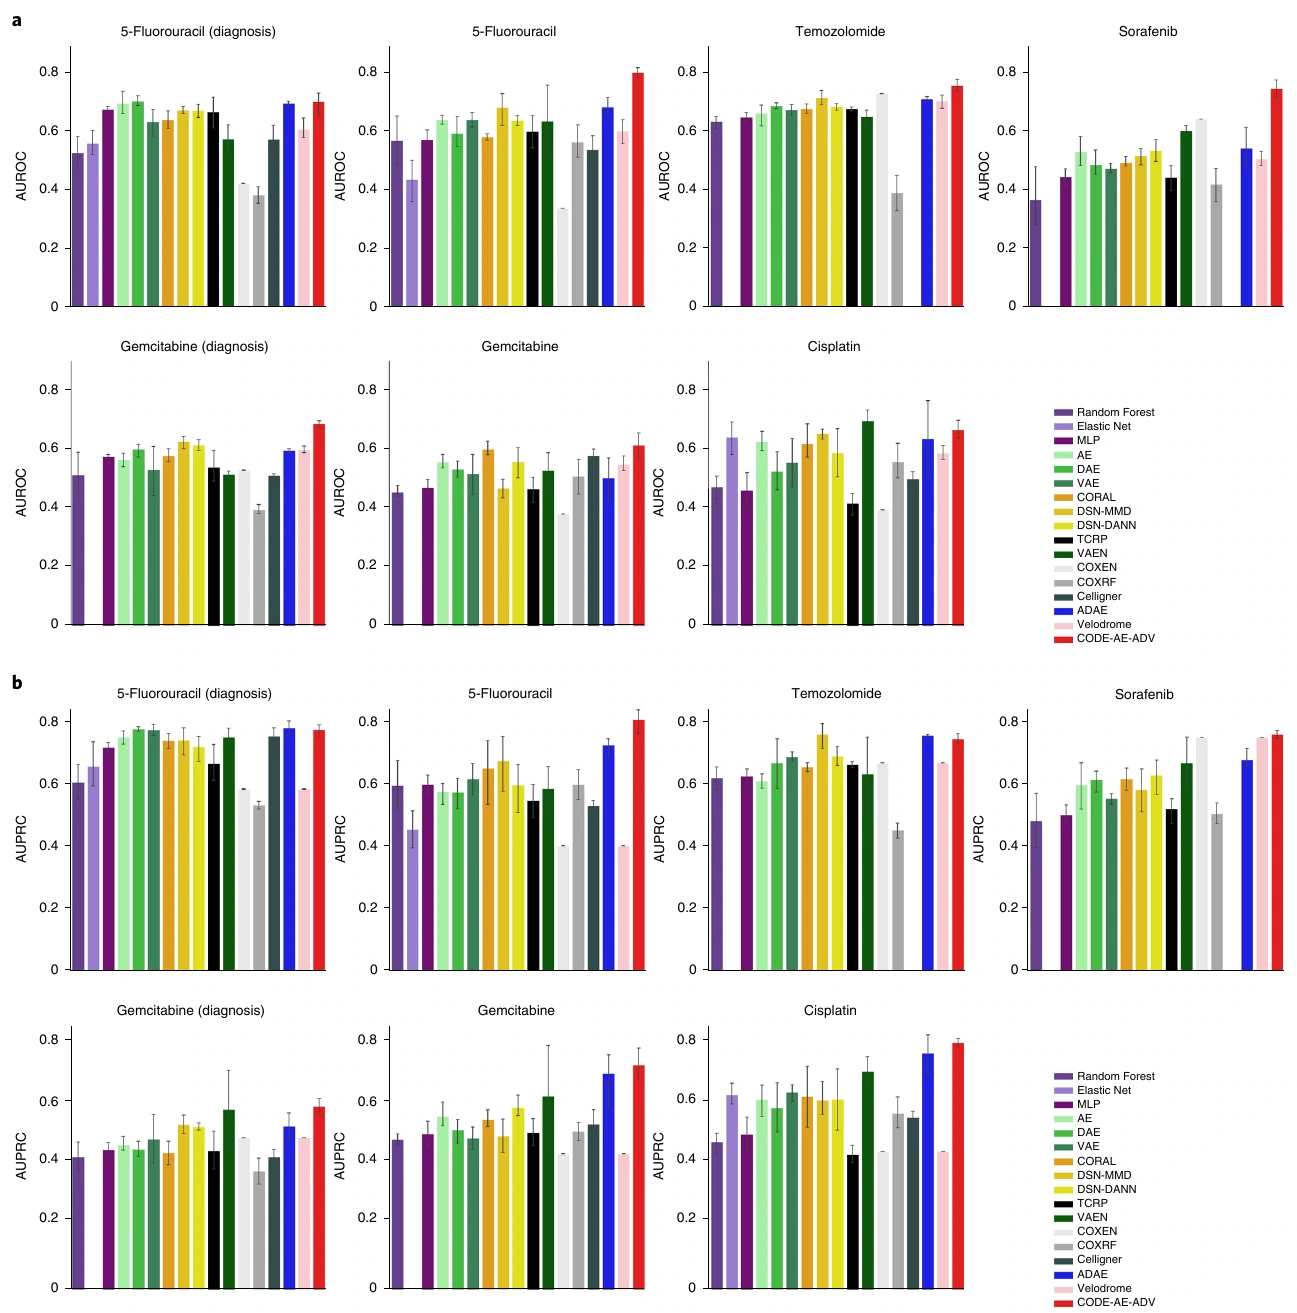
Figure 4:患者单药化疗反应预测
原图来源:所用 PDF 文件第 7 页,Figure 4。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 逐药物比较患者临床反应的 AUROC;标为 diagnosis 的图评价肿瘤缩小,其余图评价初始反应后的复发。总体支持 CODE-AE-ADV 的迁移预测优势。 |
| b | 相同临床任务的 AUPRC,误差线反映交叉验证波动;两个终点应分别理解,不能把所有图都称为客观缓解率预测。 |
肿瘤缩小与初始反应后的复发需要不同随访和标签,图上 diagnosis 面板的终点不能与其余混同。交叉验证误差衡量内部划分稳定性,不是前瞻用药获益的置信区间。模型可从表达分层风险,实际治疗选择、病期与样本时点仍可能混杂;应明确是回顾性预测,不是随机分配治疗的因果证据。
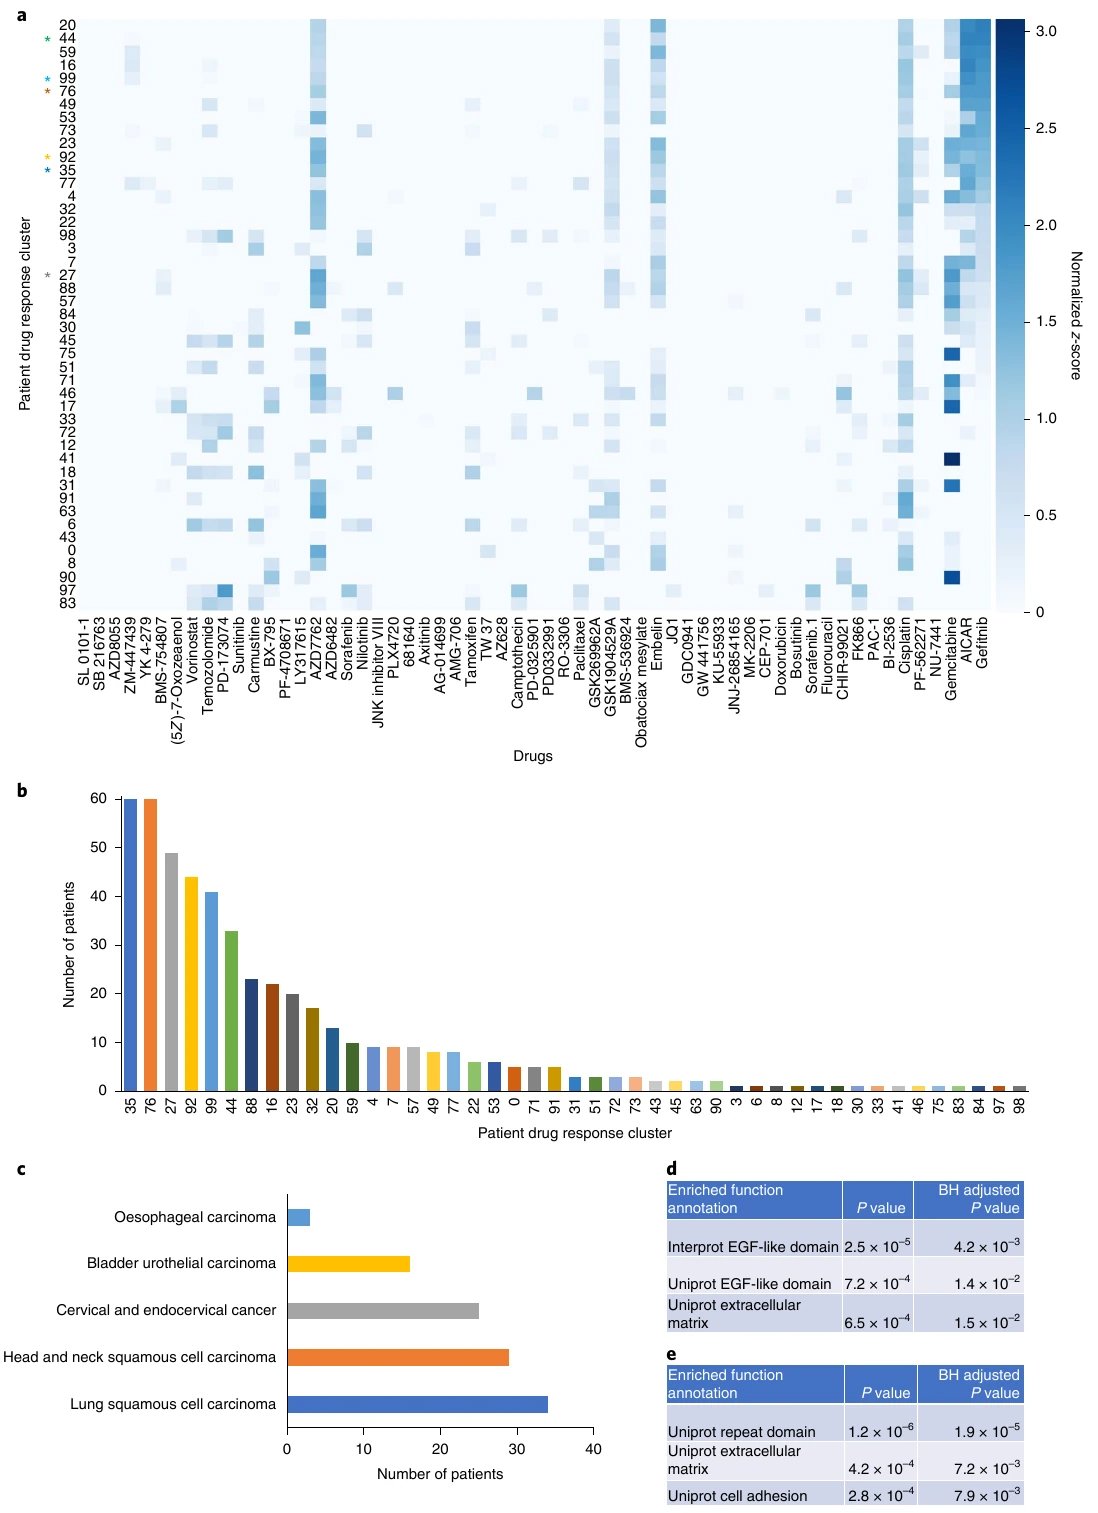
Figure 5:预测患者群体反应,并分析关联生物标志物
原图来源:所用 PDF 文件第 8 页,Figure 5。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 498 名肺鳞癌患者按预测反应分为 45 簇,热图展示对 59 个药物的相对 z 分数;值越高表示预测越敏感,负值为便于显示截为 0。这些是模型预测,不是新完成的患者用药试验。 |
| b | 各患者簇的样本数,帮助判断热图中某种反应模式覆盖多少患者,避免把小簇与大簇等量解读。 |
| c | 第 44 簇中不同原发癌种的组成,说明模型中的某些反应群体可跨癌种关联。 |
| d | AICAR 预测敏感/耐受患者之间突变频率差异最大的前 50 个基因的功能富集,突出 EGF 样结构域与细胞外基质等候选联系;属于关联解释。 |
| e | gemcitabine 的同类富集分析,突出重复结构域、细胞黏附及细胞外基质等;它提出可检验的机制方向,不能仅凭富集证明因果。 |
45 簇和 59 药物热图给出预测患者反应谱,z 分数与截负值是可视化处理,不能当真实 IC50 或临床响应率。小簇大小会影响解释,跨癌种相似性不等于相同治疗机制。对预测敏感/耐受组的突变富集由模型分组定义,属于候选解释,需在独立真实药敏或临床标签中复核;没有新的 9,808 次患者用药实验。
我的理解与可迁移设计
最可借鉴的是域适配也需要功能终点验证。AD 人类脑与细胞系 MPRA 差异不能只靠把嵌入对齐解决:构建、细胞和病理环境可能改变真实效应,强制去除反而损失信号。首轮可以建立单研究功能模型,再逐研究留出检查迁移;若没有配对环境标签,就不宣称准确估计环境交互。16 GB 适合共享/私有小编码器或固定表征,难点在于识别哪些差异可迁移。
应保留原始标签、研究来源和输入时点,防止把预测分组的富集重新当训练证据。域对齐前后的目标性能、简单线性/无适配基线及不同研究的失败场景,比单一 t-SNE 更能说明实际创新。共享表示的成功最终是对某个可测终点的泛化,不能以方法名称中的 deconfounding 自动保证机制因果。
