92.ProCapNet:原图、模型逻辑与研究范式

92.ProCapNet:原图、模型逻辑与研究范式
Perry论文题名: Dissecting the cis-regulatory syntax of transcription initiation with deep learning
期刊与年份: bioRxiv,2024。论文原文。
阅读版本: bioRxiv, 2024-11-21。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: DNA 序列如何决定转录启动的强度与起始位点,并通过 motif 排列、竞争及染色质状态产生不同细胞中的启动模式?
用更接近过程的读数,拆开表达的混合原因
我对研究思路形成的推测是:直接预测稳态RNA虽然实用,却把转录启动、暂停、剪接和降解混在同一目标里,难以确认某个motif影响哪一步。作者选择PRO-cap这一新生RNA起点测量,把问题缩小为局部DNA怎样决定启动强度和起始位置。这是监督的序列到分子读数模型,疾病关联是后续应用方向,正文主图没有直接证明AD机制。
ProCapNet用2,114 bp DNA预测中央1 kb两条链的逐碱基概率及合计log计数。BPNet式八层扩张卷积、512通道提供非线性局部上下文;多项分布损失负责起点与方向,计数均方误差负责总量。两链共用一次softmax,使模型不仅选择链内位置,还能预测正负链间读段比例。窗口比输出宽避免边缘零填充伪特征。
训练使用PRO-cap峰和开放但缺乏启动的DNase背景,按染色体七折划分。这种负例针对性地要求模型区分开放与启动,而不是只学哪些区域开放。低可比对碱基在训练形状损失中屏蔽,评估却仍纳入;这对重复序列是实质边界。作者没有用本文疾病标签训练,也没有将后面的启动子/增强子标签作为网络分类目标。
Figure 1:以碱基分辨率预测转录起始
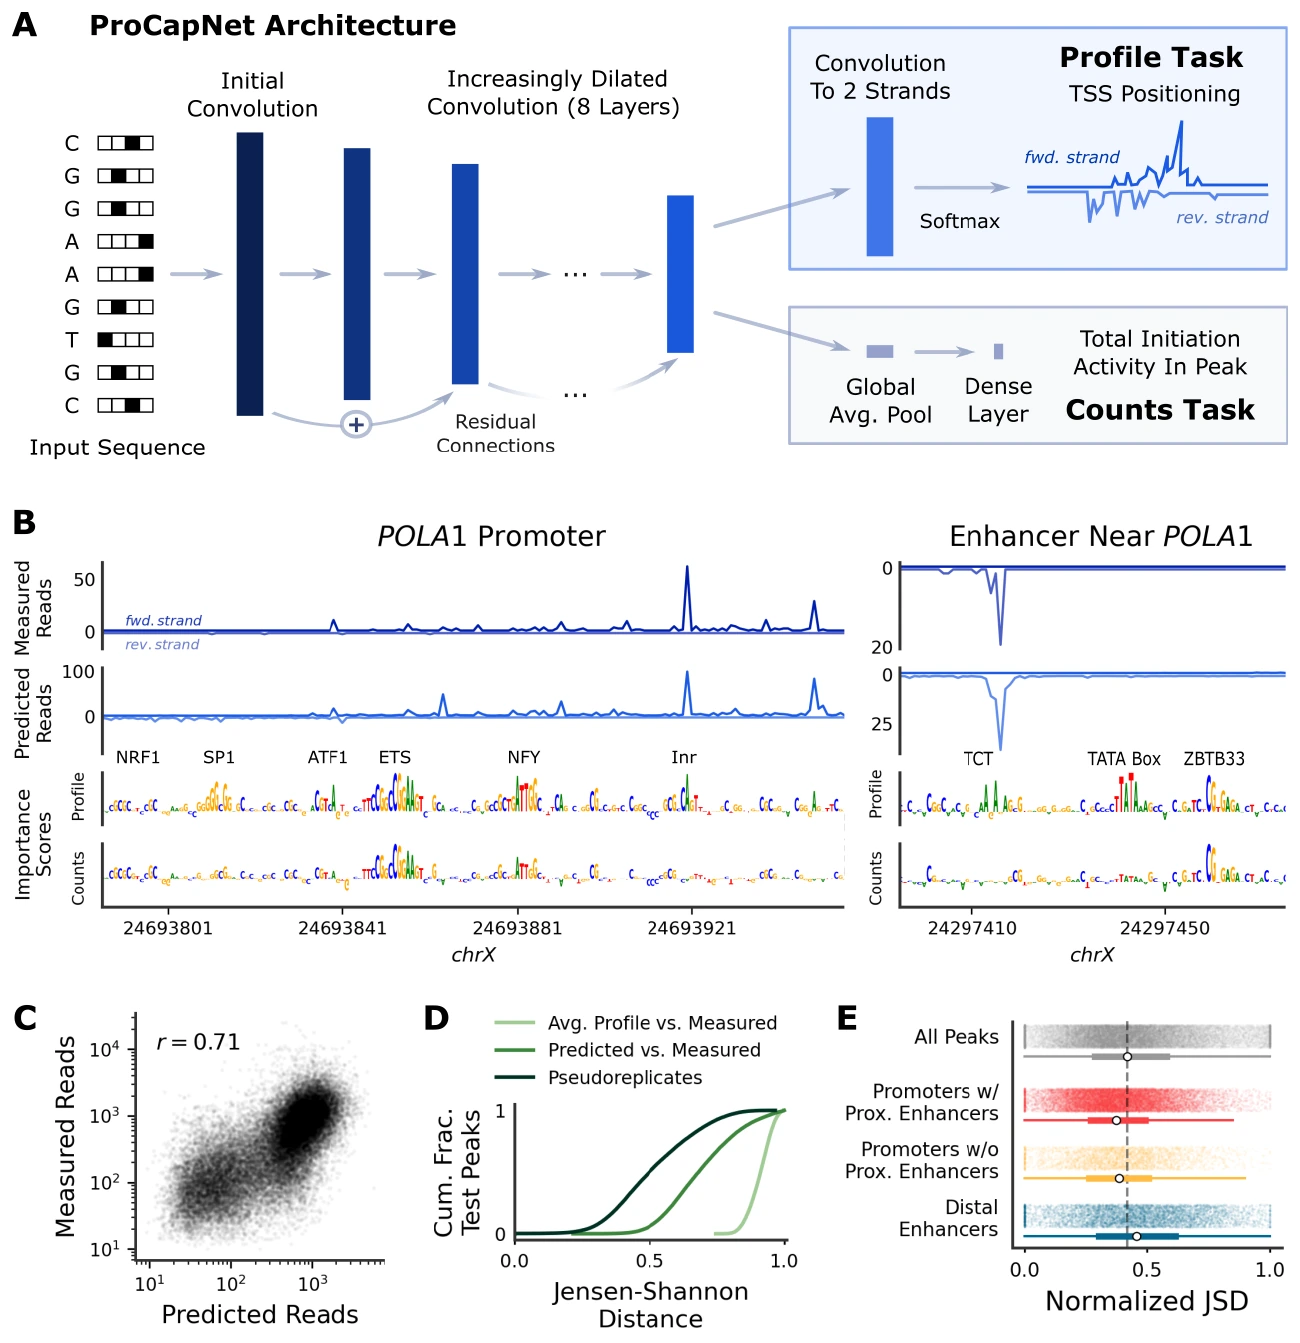
原图来源:所用 PDF 文件第 4 页,Figure 1。点击图片可查看原图。
A把强度与位置分别定义,B用启动子和附近增强子说明同一架构能处理两类元件,C/D在未见染色体量化,而E检验成绩是否仅由某类强信号位点带动。实验重复提供可达到程度的参照,平均轨迹是较弱基线;模型与重复间仍有差距,局部序列不包含远端和细胞状态的全部信息。覆盖越低,测量分布越随机,E的逐例JSD归一化正是为降低这种混杂。归一化后不能将不同定义的JSD数值直接拼到其他论文排行榜。
| 子图 | 讲解 |
|---|---|
| A | ProCapNet 输入局部 DNA 序列,同时预测 PRO-cap 的总起始计数与逐碱基正/负链分布;前者回答启动多强,后者回答在哪里、向哪个方向启动。 |
| B | 两个位点的实测 PRO-cap、预测轨迹及两项任务的序列贡献分数对照;预测能追踪峰的位置,贡献分数指向 Inr、TATA 和转录因子等候选序列元件。 |
| C | 七折留出染色体测试中总计数预测与实测的相关性,评估训练未见位点的起始强度泛化。 |
| D | 逐碱基分布预测的 JSD 累积分布,并与相关对照比较;JSD 越小越好,不能按相关系数“越大越好”的方向阅读。 |
| E | 按 ENCODE 调控元件类别分层的归一化 JSD,比较不同启动子/增强子等位点的分布预测;归一化用于减少覆盖深度混杂,多数类别保持一定预测能力。 |
Figure 2:预测贡献识别启动 motif 及其定位规律
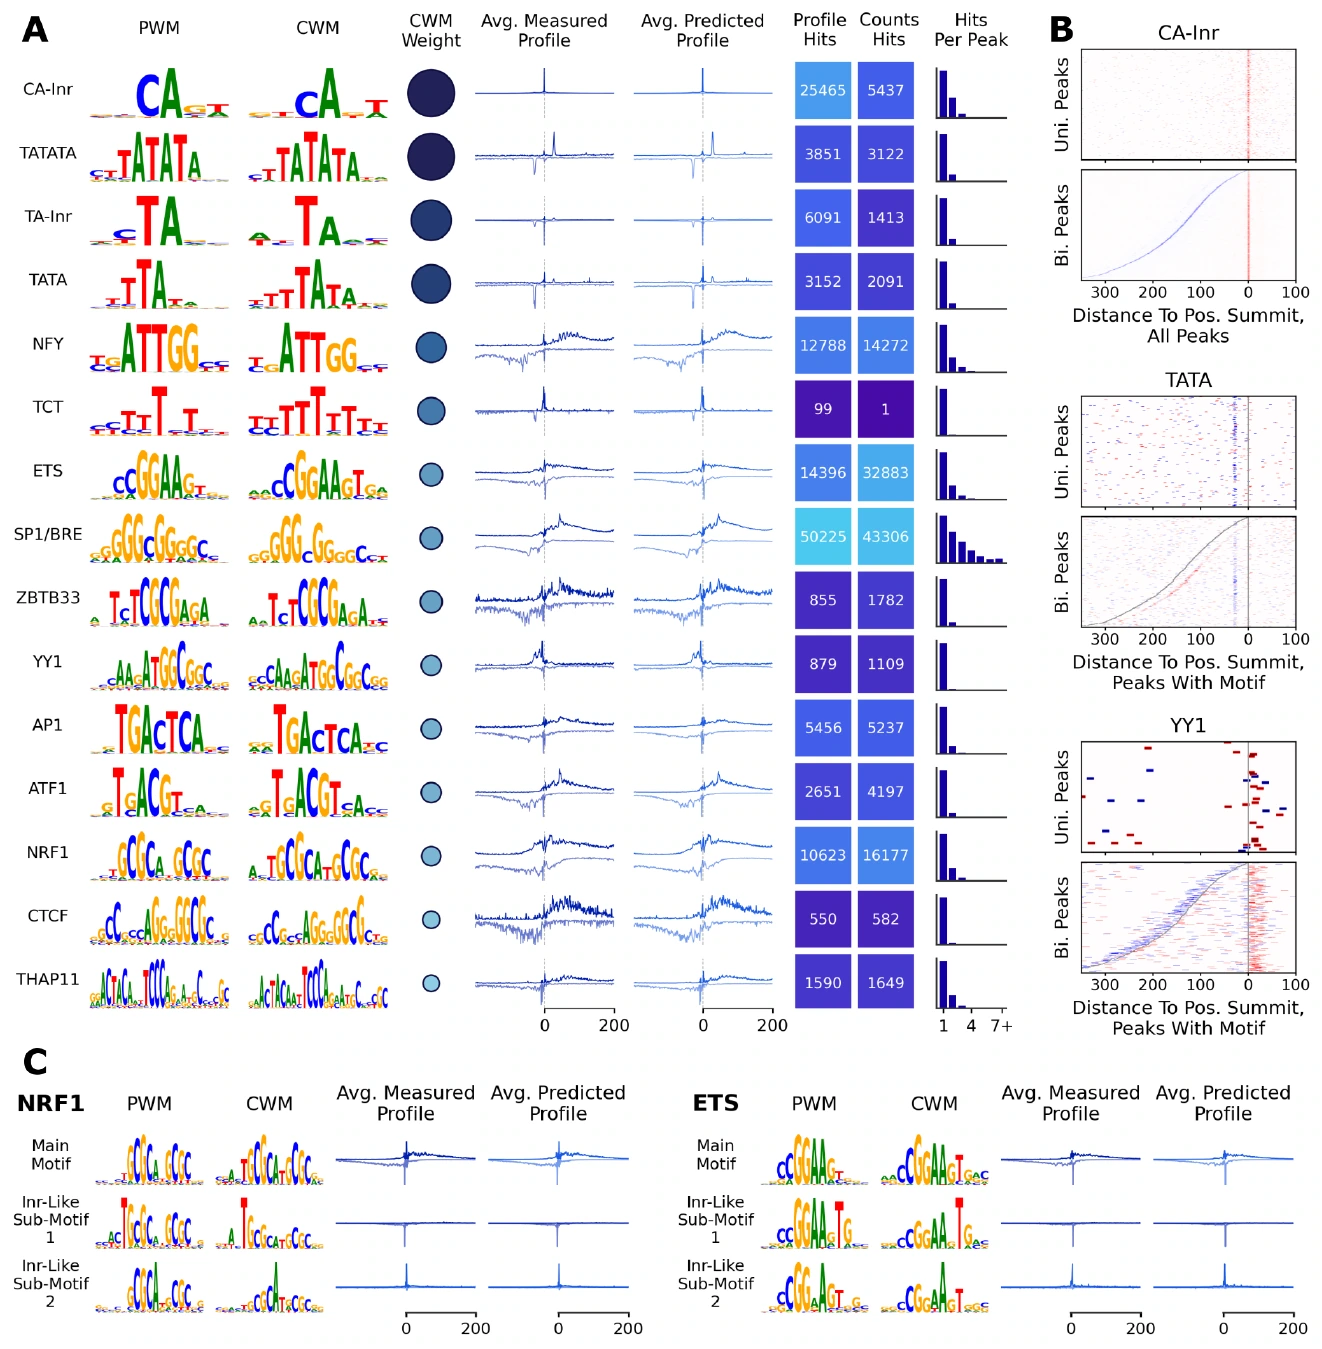
原图来源:所用 PDF 文件第 6 页,Figure 2。点击图片可查看原图。
A的PWM、CWM、贡献幅度与起始轨迹分别回答序列长什么样、模型使用哪些碱基、贡献有多大、起点在哪里,不能只看等高的logo判断motif重要性。B按方向对齐后显示TATA约在起点上游、Inr更贴起点,C再揭示NRF1和ETS内部可能含隐蔽Inr。这说明同一TF样序列在不同上下文可承担不同功能。motif实例要求序列与归因双重匹配,过滤许多仅有序列相似的命中;高覆盖注释仍是模型支持,不是逐个位点已完成真实扰动。正文还发现与TE重叠的长模式中,较短子片段贡献突出,为重复副本功能分化提供候选线索。
| 子图 | 讲解 |
|---|---|
| A | TF-MODISCO 从高贡献片段提取重复 motif,综合展示 PWM、贡献加权 CWM、贡献幅度、平均起始轨迹及出现频率。序列匹配与实际模型贡献需要分开,模型在绝大多数活跃位点找到可预测 motif。 |
| B | 把各 motif 实例相对 PRO-cap 峰顶的位置按方向排列;TATA 与起始位点有偏移,Inr 更直接贴近起点,不同元件具有不同方向/定位关系。 |
| C | NRF1 与 ETS 的子模式中出现 Inr 样序列贡献,提示一个转录因子 motif 可同时包含影响起始定位的局部信息。 |
Figure 3:启动子和增强子的共同词汇与复杂度差异
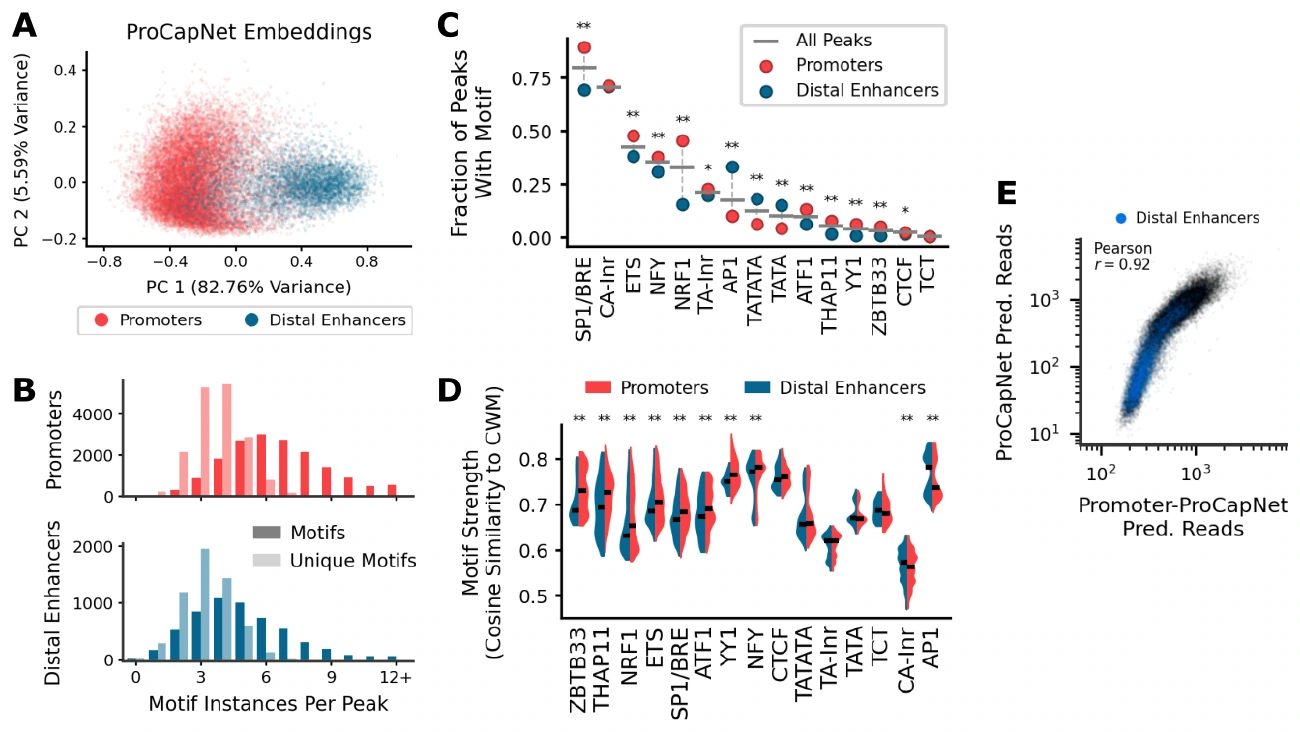
原图来源:所用 PDF 文件第 8 页,Figure 3。点击图片可查看原图。
A用监督模型学到的表示做PCA,再叠加元件标签;它没有直接用这些标签训练,却不能因此把整个ProCapNet称无监督模型。B/C/D从密度、种类和匹配强度解释分离,E用仅启动子训练再预测增强子检验共享语法的迁移。启动子与增强子可以共享词汇又有组成差别,并不矛盾。CWM余弦相似是作者采用的亲和力代理,不是实验结合常数。增强子端出现计数校准偏差,还说明预测排序一致与绝对强度可迁移是不同标准。
| 子图 | 讲解 |
|---|---|
| A | 模型内部表示的 PCA 将启动子与远端增强子分开;说明网络即使没有直接训练这类标签,也学到了可区分两者的序列模式。 |
| B | 比较预测相关 motif 实例数,启动子总体比远端增强子含有更多起始相关元件。 |
| C | 比较各 motif 至少出现一次的比例;启动子偏富集 SP1/BRE、ETS、NFY 等,增强子偏富集 AP1、TATA,显示共享词汇中的组成偏好。 |
| D | 比较 motif 实例与 CWM 的匹配强度,启动子通常更强;此为序列/贡献匹配代理,不能当作直接实验测得的结合亲和力。 |
| E | 只用启动子训练的模型与全位点训练模型在留出位点的计数预测比较;两者高度一致,增强子区间有校准偏差,支持启动子学到的起始逻辑能够一定程度迁移到增强子。 |
Figure 4:MYC 启动子中逐元件虚拟修改与起点竞争
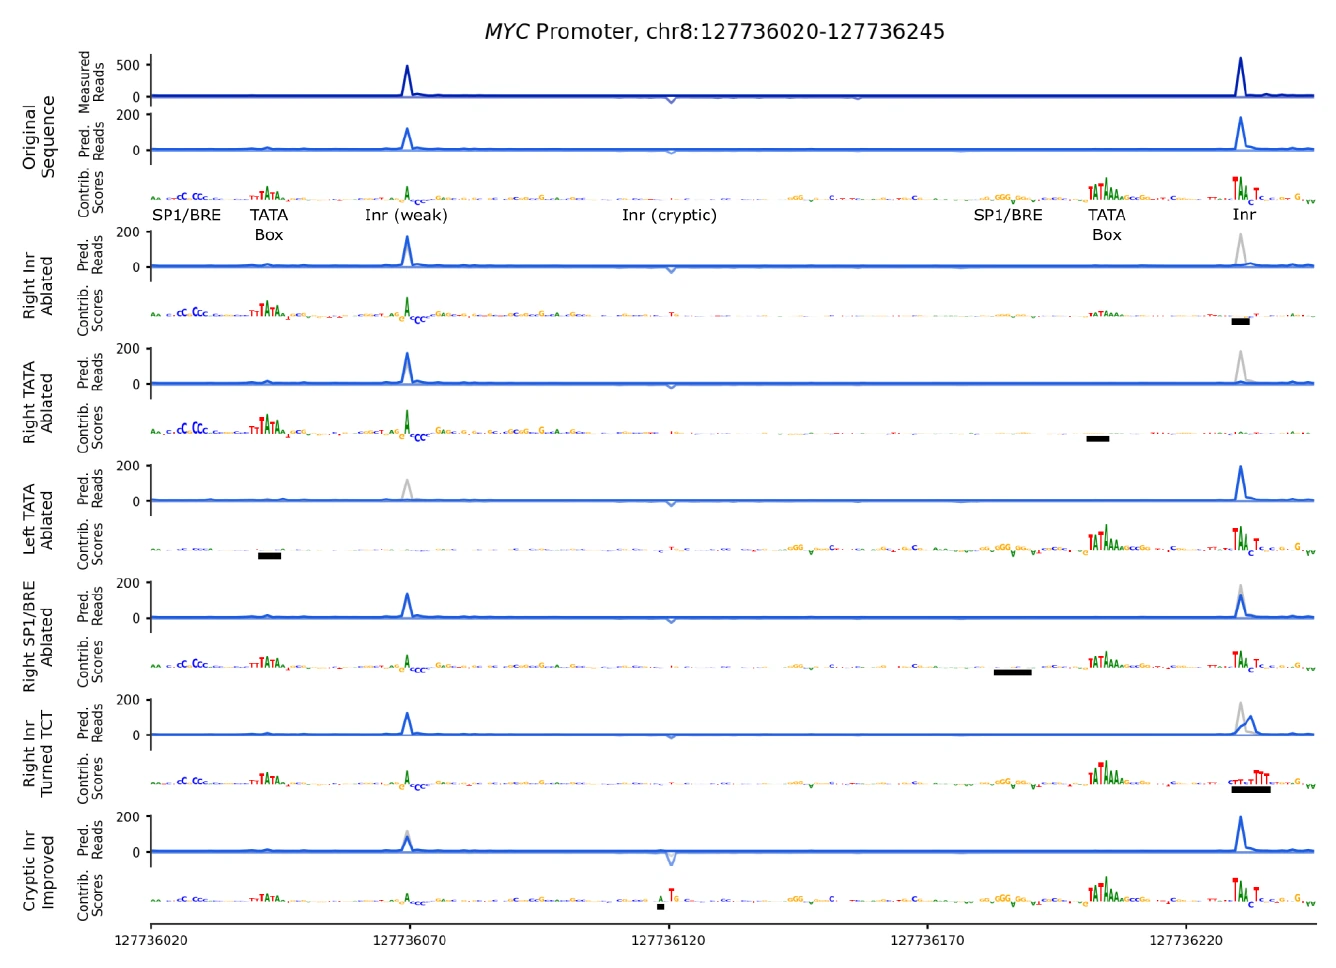
原图来源:所用 PDF 文件第 10 页,Figure 4。点击图片可查看原图。
MYC实例把同一背景中的右Inr、左右TATA、SP1/BRE、TCT替换和隐蔽反向Inr分别修改,统一纵轴避免缩放制造视觉效果。右起点被破坏时左起点预测增加,反向起点增强又压低左起点,提示非对称竞争。真正值得注意的是重算归因后邻近元件贡献也改变,模型表示的作用依赖其他元件。所有修改都是计算模拟,选择的替换序列还可能引入未识别新模式;因此应以多种替换和实测突变检验稳健性,不能仅凭单例宣称发现真实PIC竞争机制。
| 子图 | 讲解 |
|---|---|
| 原始序列(无字母) | 同一 MYC 启动子展示实测、模型预测和贡献轨迹,标出两个正向起点及隐蔽反向起点,作为所有序列修改的基线;纵轴尺度保持一致。 |
| Right Inr Ablated | 破坏下游右侧 Inr 后该起点预测信号下降,左侧起点增强;提示起始信号会在邻近位点间重新分配。 |
| Right TATA Ablated | 破坏右侧 TATA 也削弱下游起点并增强上游起点,与右侧 Inr 的计算破坏一起支持两起点竞争的模型解释。 |
| Left TATA Ablated | 破坏左侧 TATA 降低上游起点,但下游起点没有对称的同等变化;起点之间的影响具有方向不对称性。 |
| Right SP1/BRE Ablated | 破坏右侧 SP1/BRE 使右侧预测起始强度降低,显示除核心起始元件外,邻近转录因子相关元件也影响该位点活性。 |
| Right Inr Turned TCT | 把右侧 Inr 改为 TCT 模式,预测信号的位置/强度随之改变;直接检验核心起始序列类型变化的影响。 |
| Cryptic Inr Improved | 增强隐蔽反向 Inr 后反向起始信号增加,上游正向起点减弱而下游正向起点基本不变;进一步展示邻近起点之间的竞争和重分配。 |
Figure 5:系统性 motif 破坏区分起始强度与位置作用
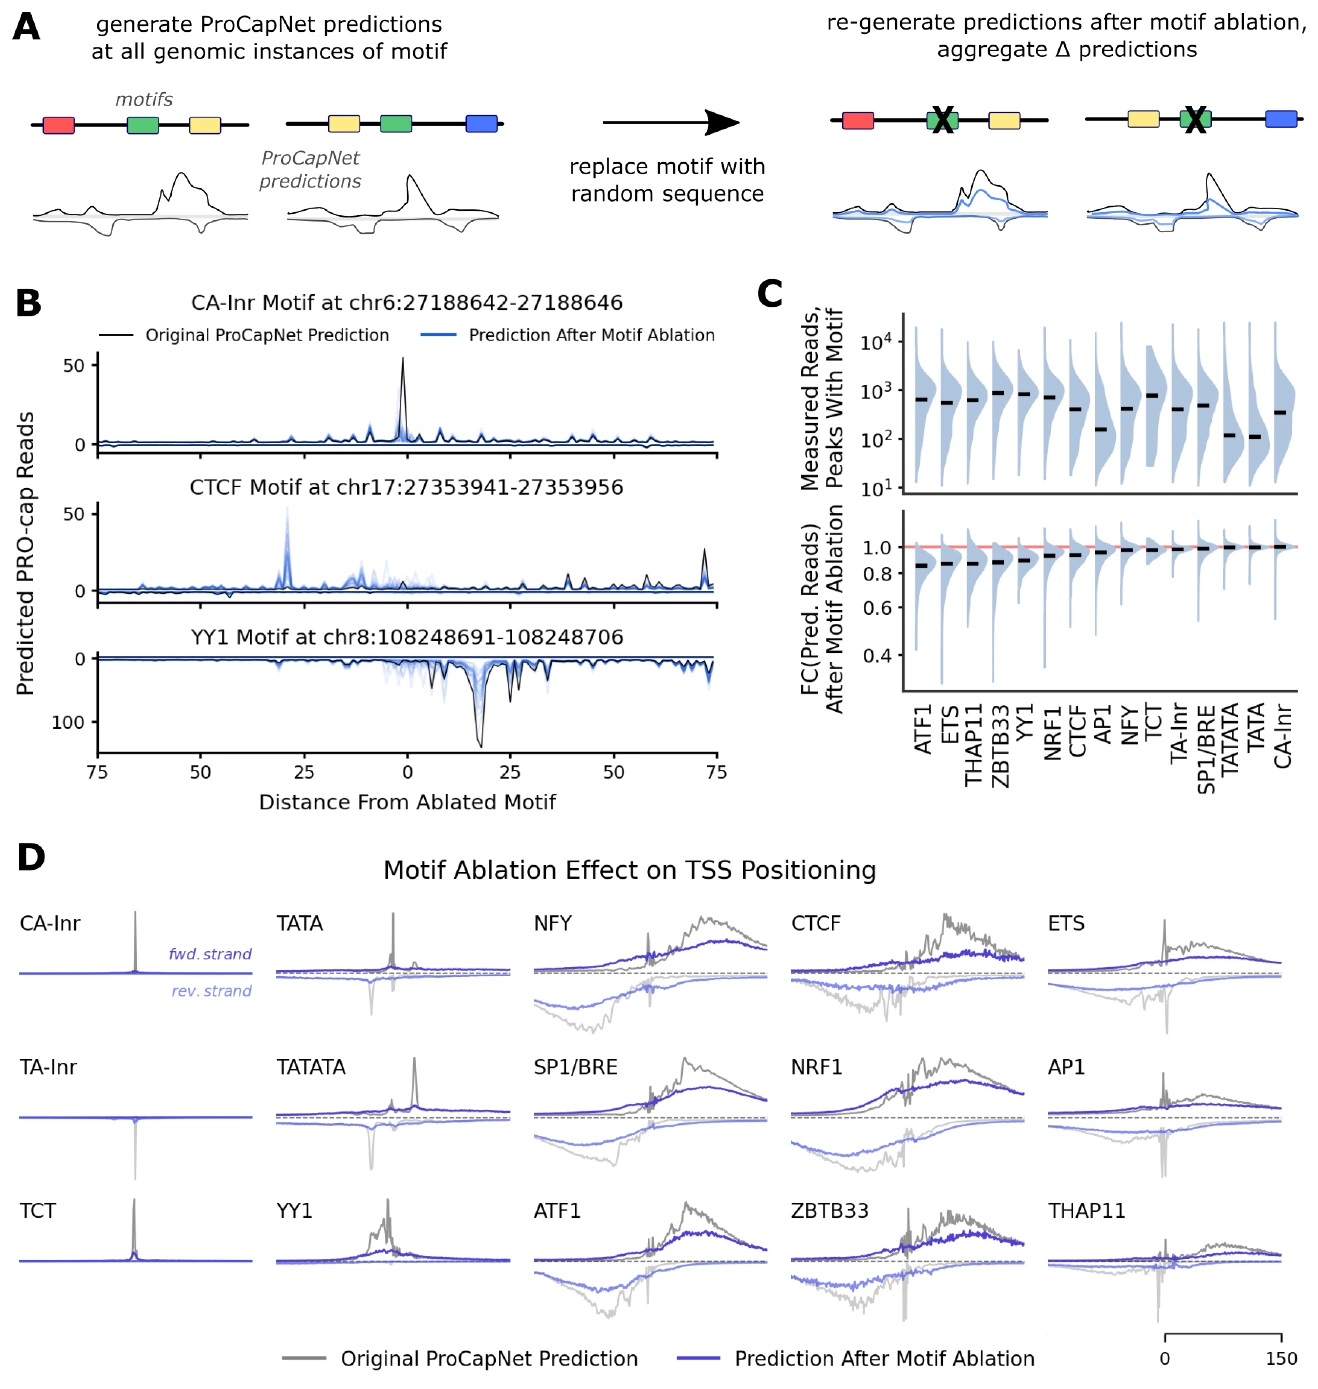
原图来源:所用 PDF 文件第 11 页,Figure 5。点击图片可查看原图。
A/B将单例扩展为全体motif实例,并用重复随机替换降低某个替换序列的偶然影响。C上方是含motif位点实测量,下方是破坏后的预测效应,两者排名不同,说明观察富集容易被启动子或增强子组成混杂。D比较归一化起点概率,某个位置丢失后概率必然分配到其他位置;这在数学上并不自动代表其他位置的绝对起始量增加,还需结合计数头。Inr/TATA可能显著改变局部起点而对全窗口总量影响较小,表明只用gene-level RNA会漏掉调控形式变化。
| 子图 | 讲解 |
|---|---|
| A | 在各位点逐个破坏 motif 实例,重复估计预测变化的计算实验流程;将单一 MYC 示例推广到全体 PRO-cap 峰。 |
| B | 代表性位点的破坏前后预测轨迹:Inr、YY1、CTCF 等元件造成的变化位置和重新分配模式不同,说明只看总信号会遗漏局部效应。 |
| C | 上方展示含有各 motif 位点的实测信号分布,下方展示破坏 motif 后预测总计数的倍数改变;二者区分观察关联与模型反事实效应。Inr/TATA 等的局部起点效应可以很强,但总起始量中位数变化不一定大。 |
| D | 对所有 motif 实例汇总破坏前后的逐位置分布变化;定位 motif 更集中影响局部起点,部分激活因子对更广区域信号有影响。 |
Figure 6:稳态转录数据训练的模型学到了什么
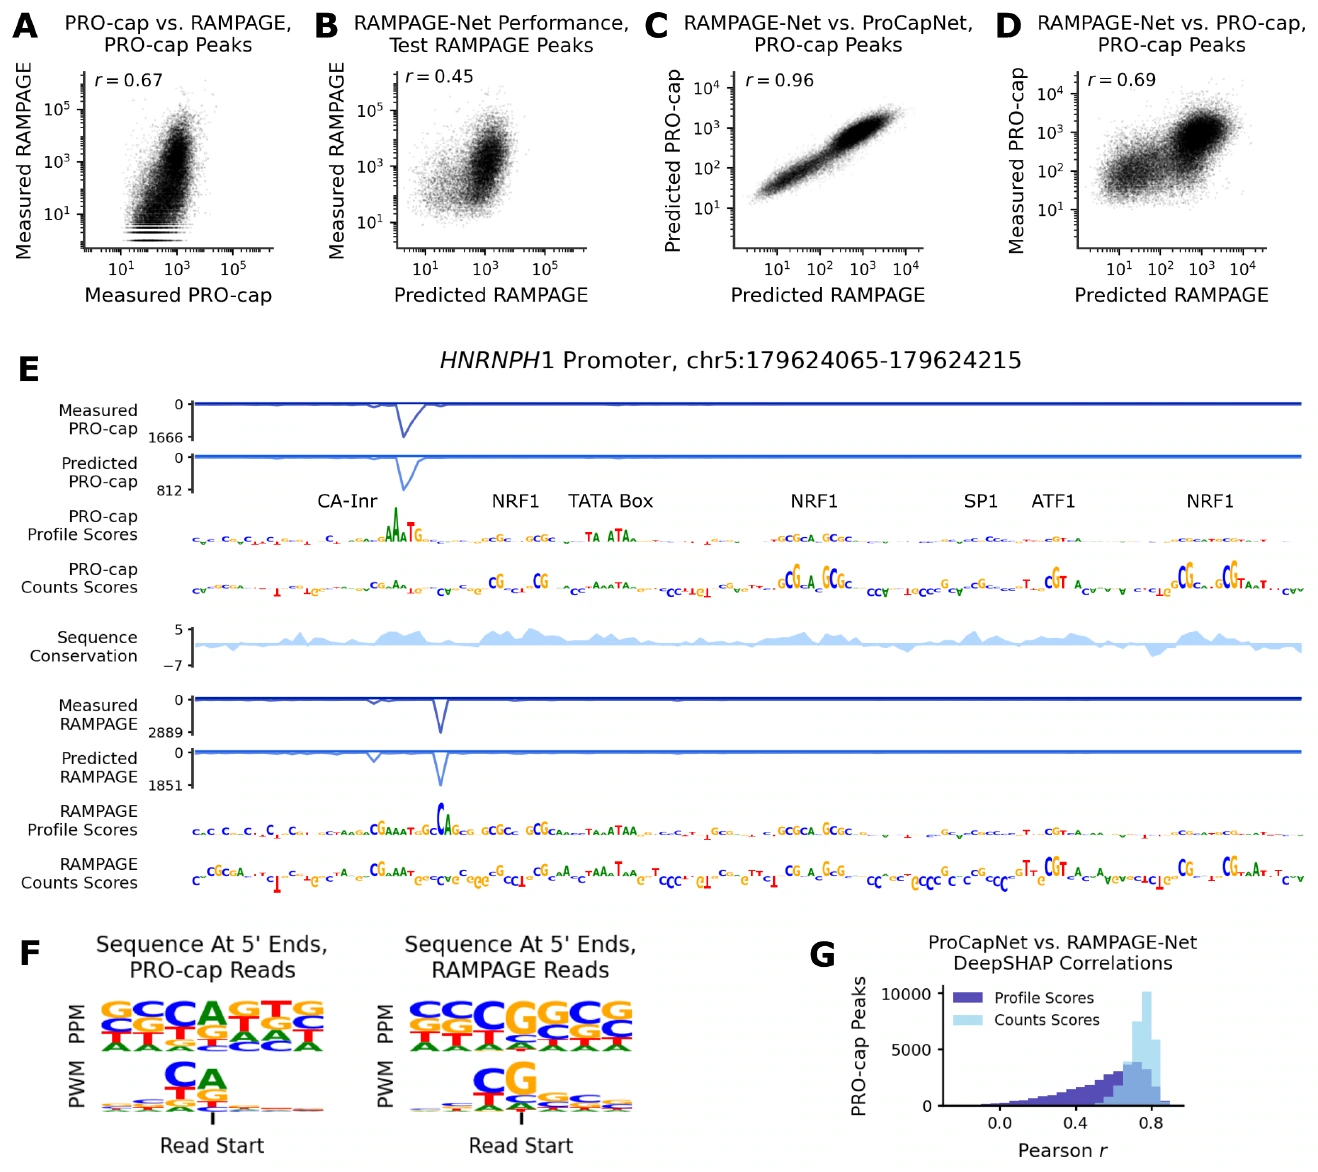
原图来源:所用 PDF 文件第 13 页,Figure 6。点击图片可查看原图。
A先展示PRO-cap与RAMPAGE测量有关但不相同,B–D再显示局部序列模型对二者作出比原始数据更相近的预测。E/F/G检验这种一致来自何处,同时暴露起点测量偏好不同;RAMPAGE的帽子与模板切换流程可能造成G起点偏好。作者据此推测局部模型主要提取启动成分,这是一种模型和测量共同支持的解释,不能称已经精确分离每条RNA的降解效应。对AD公共数据,可借稳态读数提出启动假说,但模型插补不等于目标脑细胞已经测到新生转录。
| 子图 | 讲解 |
|---|---|
| A | PRO-cap 起始信号与 RAMPAGE 稳态转录信号的实测总量相关;二者有共同信息,但并非同一测量,实际相关约 0.67。 |
| B | 仅用 RAMPAGE 训练的 RAMPAGE-Net 在留出峰上预测 RAMPAGE 计数的表现;稳态信号较难从局部序列完全解释。 |
| C | 两种模型在 PRO-cap 峰上的计数预测高度一致,相关约 0.96;暗示 RAMPAGE 模型更容易学到其中由局部序列决定的起始成分。 |
| D | RAMPAGE-Net 预测与真实 PRO-cap 信号比较,仍有较高相关,支持其序列可解释成分与起始活动相联系。 |
| E | 一个启动子的两种实测信号、模型预测、贡献分数和保守性轨迹;模型解释比两种原始信号更相似,可定位共同的起始序列元件。 |
| F | 对 PRO-cap 和 RAMPAGE 检出的读段 5′ 端序列汇总 PPM/PWM;比较两种实验识别起点的序列偏好及差异。 |
| G | 在所有 PRO-cap 峰的 1 kb 窗口内比较两模型贡献分数相关性,分别评估位置分布和总计数任务;检验共同序列规律是否广泛存在。 |
Figure 7:跨细胞起始规律与细胞特异染色质信息
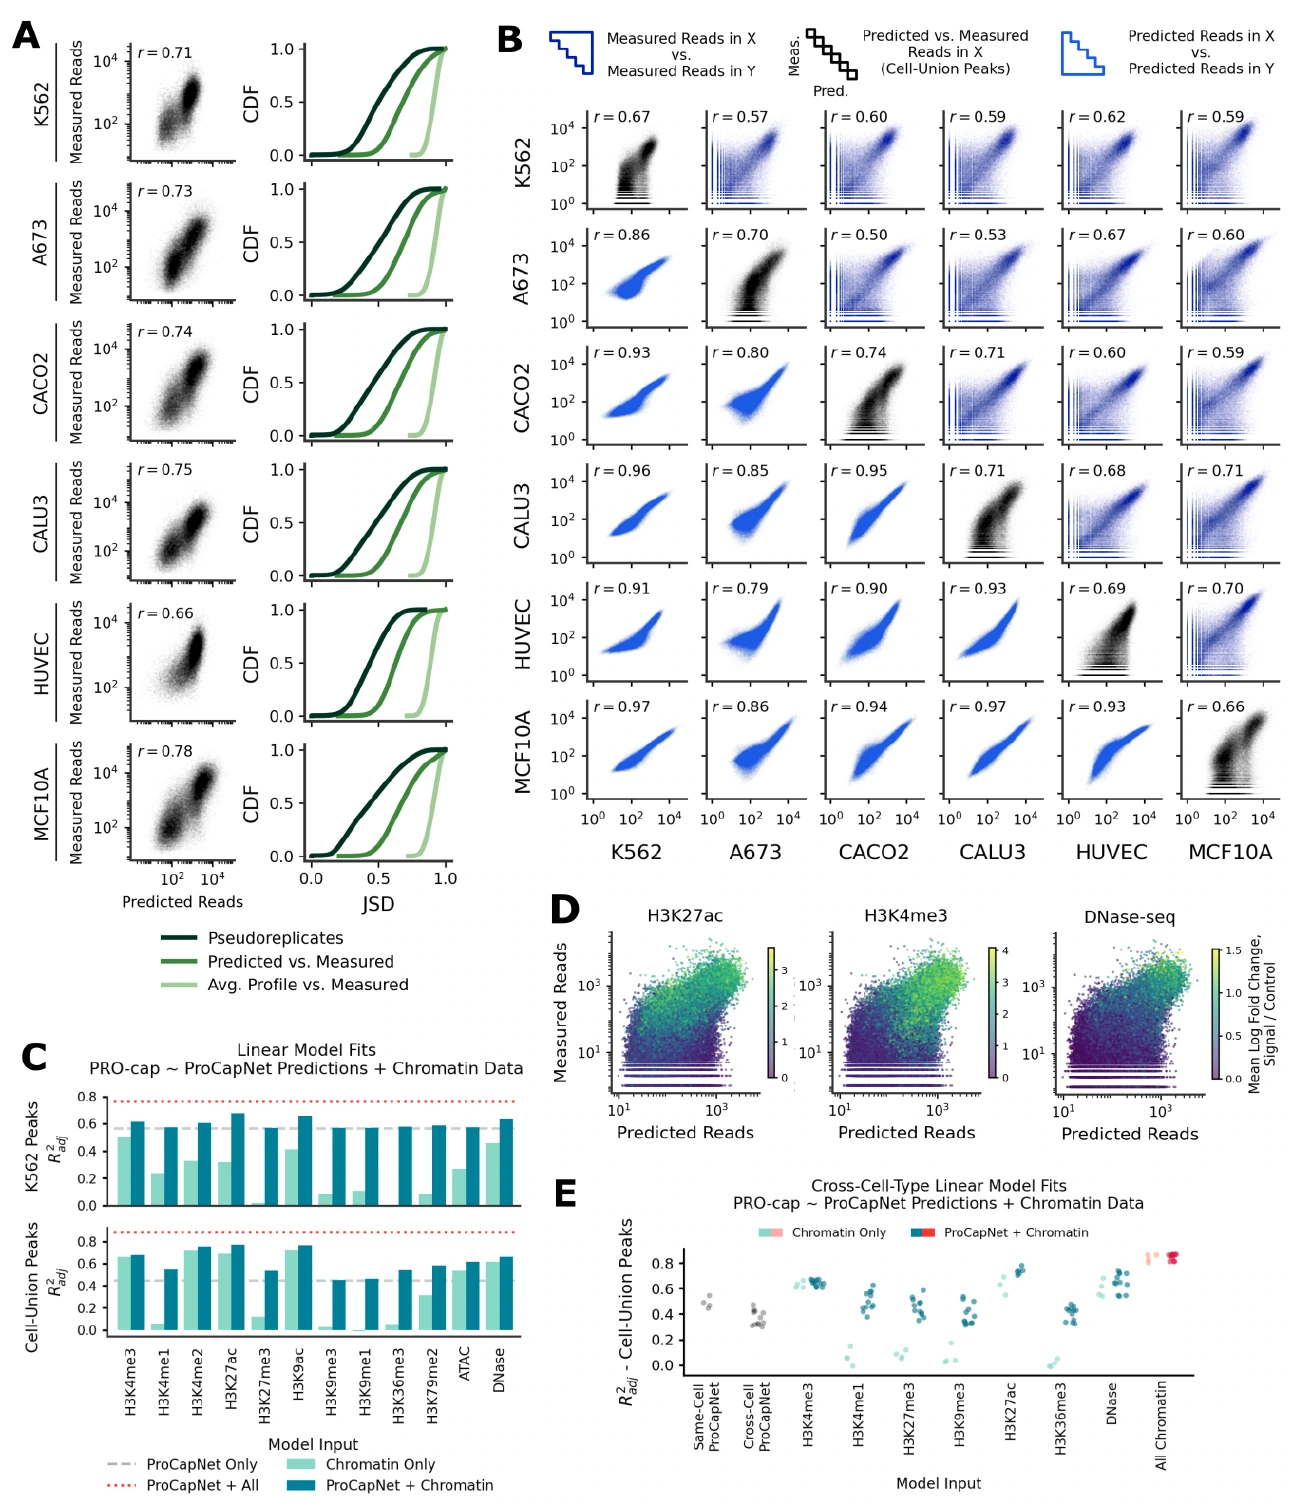
原图来源:所用 PDF 文件第 15 页,Figure 7。点击图片可查看原图。
A的本细胞测试与B的所有细胞峰并集测试回答不同问题:模型在本细胞活跃峰上很好,却可能在只于别的细胞活跃处仍预测启动。C/D用目标细胞的染色质信息检验缺失的状态因素,E把参考细胞模型与目标细胞实测染色质组合。拟合采用留出染色体,并包含二阶交互项,不能只称简单单变量线性校准。染色质补充改善说明局部启动能力和实际细胞活性有区别;组蛋白与启动之间的关联还不能单凭拟合确定因果顺序。使用目标细胞实测状态后,也不能再宣称从DNA零样本获得完整细胞特异性。
| 子图 | 讲解 |
|---|---|
| A | 在多个细胞类型分别训练/测试模型,比较计数与位置分布表现;局部序列能够在不同细胞中支持起始预测。 |
| B | 上三角为细胞间实测信号相关,下三角为各细胞模型预测相关,对角线为本细胞预测与实测;模型预测跨细胞更相似,说明大量序列决定的信息相对通用,不能因此声称细胞差异不存在。 |
| C | 用 ProCapNet 预测加不同染色质测量拟合 K562 PRO-cap;加入组蛋白修饰或开放染色质等信息改善拟合,补充局部序列未解释的细胞背景。 |
| D | 在实测与预测的联合位点分布中叠加组蛋白/DNase 信号;观察模型预测相近却实际活性不同的位点是否可由染色质状态区分。 |
| E | 用另一细胞模型的序列预测再结合目标细胞的染色质测量拟合目标 PRO-cap;支持通用序列规律与细胞特异染色质信息共同决定起始活性。 |
阅读提醒
- 来源为用户提供的 2024-11-21 bioRxiv 版本。Figure 4/5 的 motif 修改均为计算模拟,显示模型学到的调控关系,需要与真实突变验证区分。
我会怎样将起点变化转成TE课题
一个具体方向是检验TE副本附近变异是否主要改变转录起点选择,而不是总RNA量。先在有可信起点读数的公共数据建立基准,将TE副本与同家族、GC和可比对性相近的对照匹配,比较等位替换对正负链分配、起点位置和总量的三种影响,再用独立CAGE/PRO-cap或等位数据验证。若脑细胞没有对应读数,只能把细胞系发现作为候选规则,不能直接称AD结果。
对有限显存,我会先用公开模型提取局部表示或进行等位前向推理,研究清楚一种细胞类型、一类TE家族,再决定训练。创新可落在“哪些副本保留祖先起始语法,哪些副本经变异改写起点,以及病理相关细胞环境是否允许它生效”,但演化年龄、拷贝同源性和可比对性必须分别控制。相似副本随机分到训练测试会造成同源泄漏,跨家族或跨染色体检验应作为独立挑战。
我的感悟是,模型的可解释性不只来自架构透明,还来自目标读数、负例和验证的设计。ProCapNet保留非线性,Puffin对motif作用加入结构约束,两者代表不同取舍;这里的比较带有作者方法视角,需要在统一细胞、数据和评价目标下判断,不能引用一句评论就宣布一种范式全面失效。对于自己的AD研究,最可迁移的是先找能够区分机制的中间读数,再选择允许该机制被检验的模型。
