45.Delphi2M:原图、模型逻辑与研究范式

45.Delphi2M:原图、模型逻辑与研究范式
Perry论文题名: Learning the natural history of human disease with generative transformers
期刊与年份: Nature,2025。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: 生成式 Transformer 能否根据既往疾病、年龄和生活方式预测疾病发生与时间,并模拟多年健康轨迹?
把疾病历史作为事件与时间共同建模
只为每种病单独训练风险模型,很难统一描述共病与多年变化。本文将病史类比成序列,却进一步解决疾病发生在连续年龄轴上的问题。我的推测是,idea来自语言模型擅长条件事件预测,而健康轨迹还需要知道下一事件何时发生,这推动GPT架构增加时间建模。它是依据引言的逻辑重构,不是作者个人构思经历。
两百万参数模型的自监督目标
疾病发生率还需在人群背景中校准。
指数等待时间是一项建模假设,能够把事件与时间联合到可计算的目标中,却不意味着每种疾病真实等待时间都服从简单指数分布。年龄与历史不断更新使条件率可以改变,校准图帮助检查整体效果;对稀有疾病、长无事件区间及较高年龄仍需分别评价。架构的优雅性不能替代这些细分检验。
输入为首次诊断代码、发生年龄、性别和生活方式,以及用于填补长无事件区间的token。模型用连续年龄编码替代普通位置编码,因果注意力限制未来与同时记录的信息,预测下一个疾病事件及等待时间。时间头采用指数等待时间模型,使疾病类型概率可以联系到发生率。约2.2M参数是架构扫描得到的合适规模,并非通过无限增大容量取胜。
训练来自UK Biobank约四十万人记录,预测目标由后续事件自行产生,属于自监督生成学习;生活方式和性别作为条件输入,不是所有这些变量都被预测。模型可逐步采样未来轨迹,输出一种符合条件分布的可能历史,不是个人必然命运。生成、风险排序、时间校准和外部转移各自需要测试,不能用几条看起来合理的轨迹替代全部验证。
数据有真实时间戳,因此这与横断面单细胞的pseudotime不同。即使如此,记录时间也未必是生物学发病时间,诊断过程、基层医疗覆盖与队列招募会影响序列。UKB只招募活着的中年参与者,缺失招募前死亡,模型会复制这种选择。题名中的自然史应理解为从记录学习到的疾病过程,而不是已经观察无偏全人口生命周期。
疾病联系主要来自共现与条件关联。SHAP给出输入事件怎样影响模型预测,不把既往病转换成可干预的因果效应。改变吸烟token后生成不同结局,也不能等同于随机戒烟干预的反事实。探索疾病进展时,这些边界比是否使用生成模型更关键。
Figure 1|Delphi 的数据、架构和时间预测
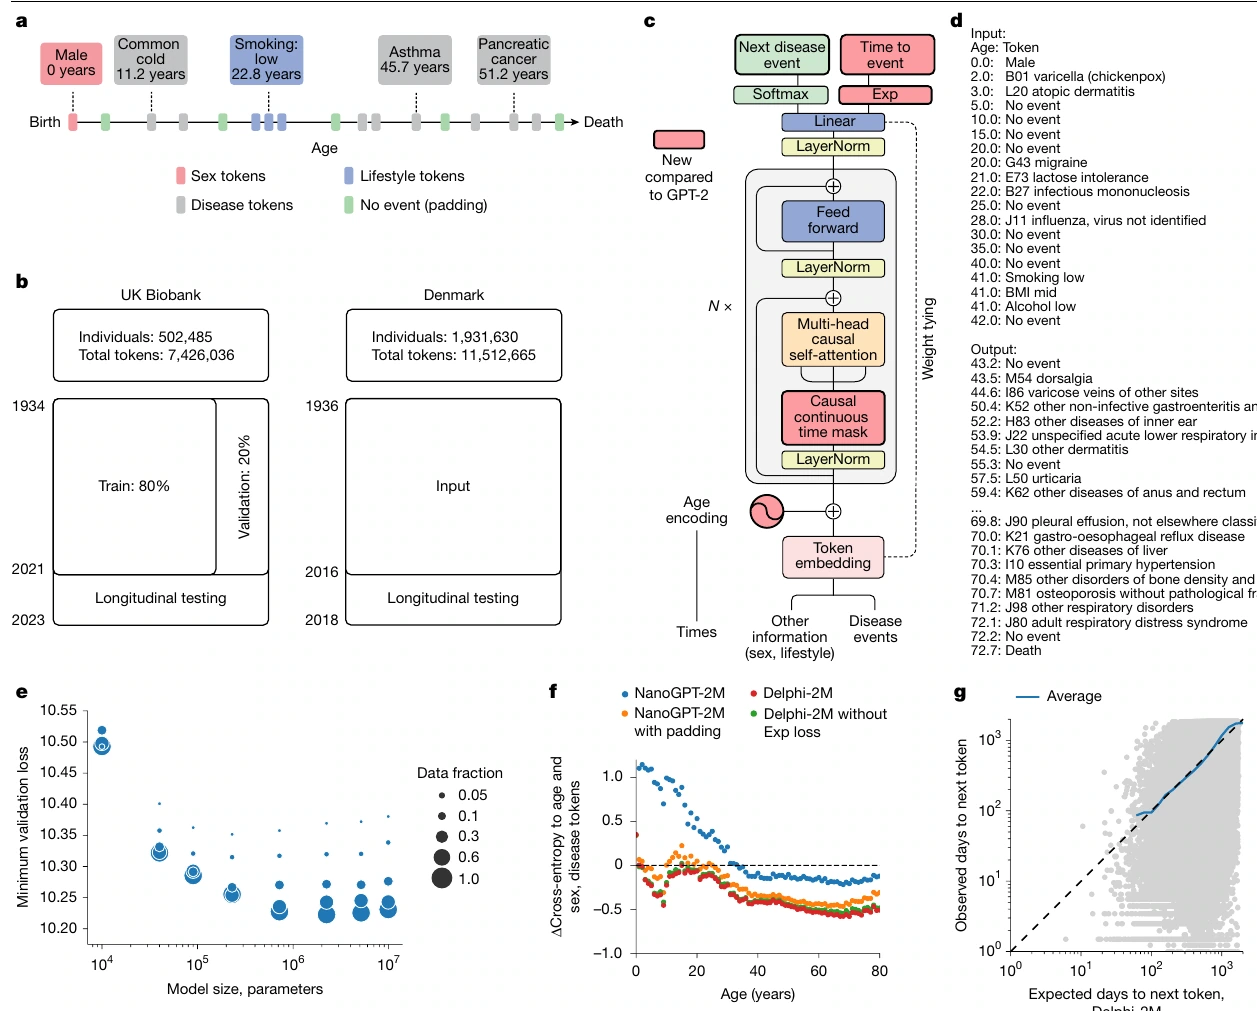
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
图1证明增加时间结构的必要性。年龄编码、等待时间损失与无事件token消融分别检验不同设计;没有事件不是没有年龄变化,因此padding可以帮助长期风险更新。预期与实际等待时间比较涉及校准,而参数扫描表明数据量限制合适容量。图中多个输出轨迹体现随机采样的不确定性,不能选一条当成患者未来。适度规模是本文对个人硬件研究最直接的启发,但需要匹配可用数据与明确目标。
| 子图 | 讲解 |
|---|---|
| a | 把 ICD-10 疾病、生活方式及健康填充 token 写成带发生年龄的序列,是模型输入。 |
| b | 英国 Biobank 及丹麦登记数据的训练、验证、测试划分,定义内部与外部评价。 |
| c | 展示相对 GPT-2 的架构修改,使模型同时学习下个事件和等待时间。 |
| d | 一个病史 prompt 及多个生成轨迹,显示输出是年龄–事件对而非单一疾病分数。 |
| e | 验证损失随模型参数、训练数据规模变化,寻找合适容量而非无限扩大网络。 |
| f | 相对年龄/性别基线的交叉熵消融,评价不同组成对预测信息的贡献。 |
| g | 预期与实际下一事件等待时间散点及分箱均值,检验时间预测的校准。 |
Figure 2|多种疾病的风险预测
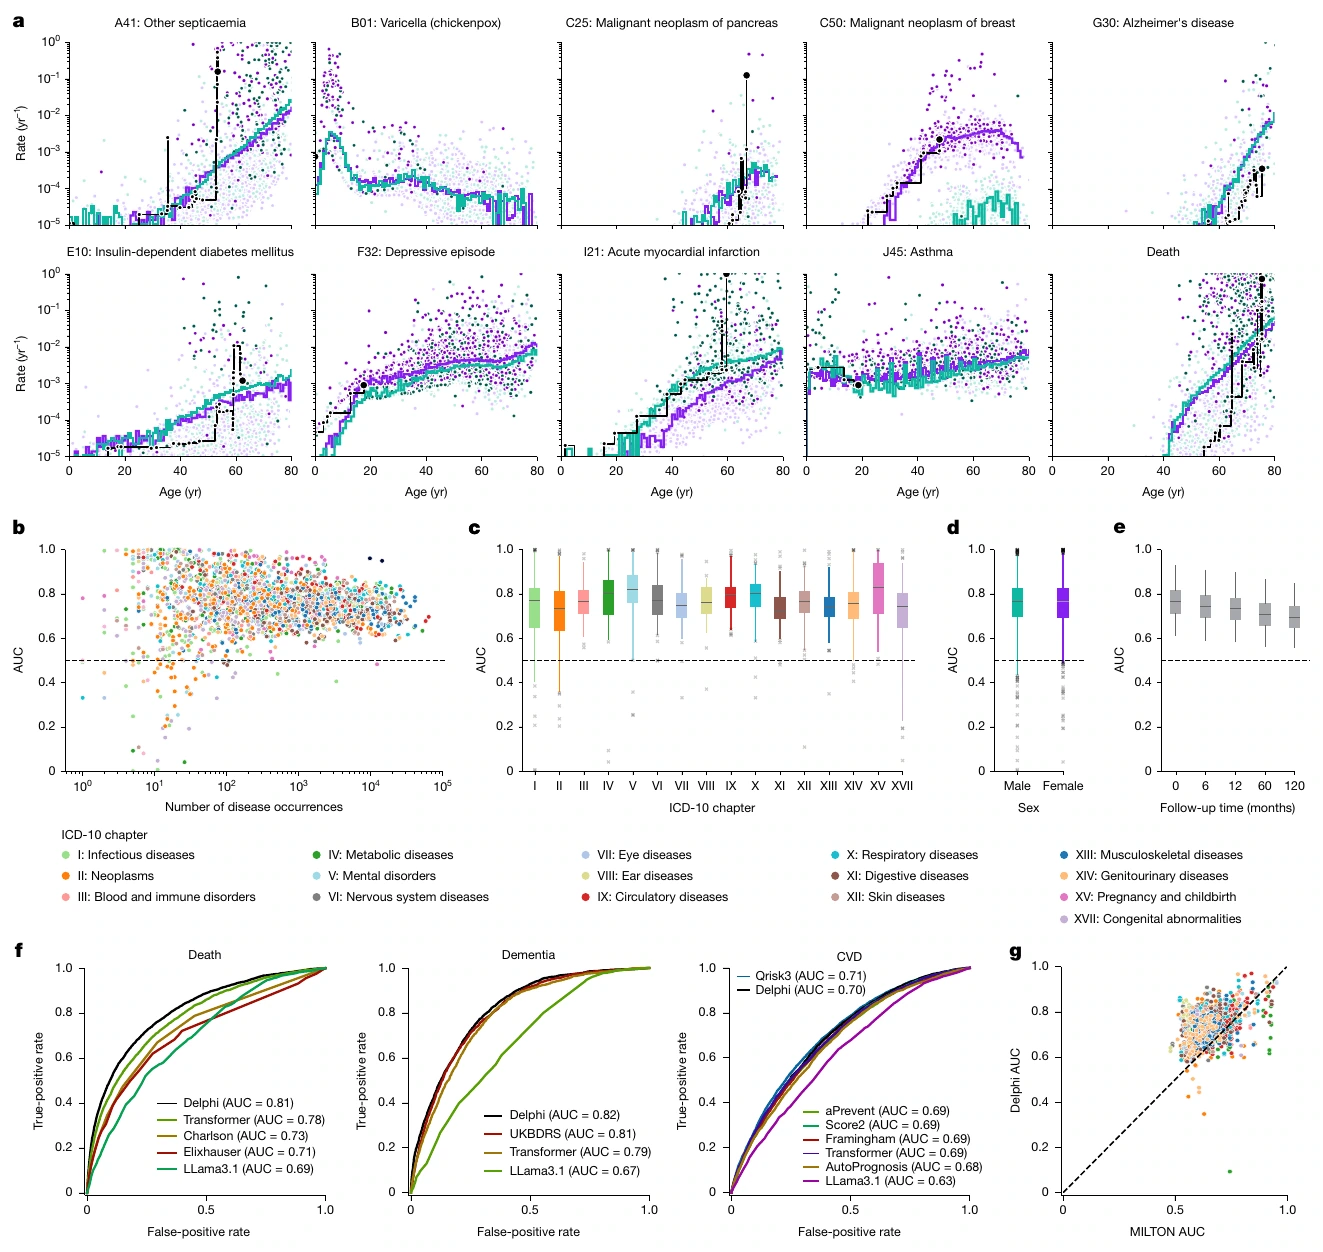
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
图2把共同模型拆成不同疾病、性别和提前间隔评估,避免一个平均值掩盖任务差异。年龄性别基线帮助判断病史是否提供额外信息,个体曲线偏离平均也未必全部有生物原因。与疾病专用模型和生物标志物方法比较,有些终点相当、有些仍需标志物;例如糖尿病不能据总体平均就忽视HbA1c。病例频率影响学习,罕见病表现更不确定。排序AUC较好与绝对风险校准应一起讨论,不能相互代替。
| 子图 | 讲解 |
|---|---|
| a | 九种疾病和死亡的年龄风险轨迹,对比群体发生率及患者逐次更新风险;病史可使个体风险偏离年龄/性别平均。 |
| b | 男女各疾病 AUC 对训练出现次数,显示罕见和常见疾病的性能分布。 |
| c | 按 ICD-10 章节汇总 AUC,比较疾病领域差异。 |
| d | 按性别汇总 AUC,检查男女预测能力。 |
| e | 按预测到确诊的间隔汇总 AUC,检验较远期风险预测的困难程度。 |
| f | 三个终点的 ROC 与临床/机器学习方法比较,评价具体任务而非只看总体平均。 |
| g | 410 种疾病的 Delphi AUC 与使用生物标志物的 MILTON 比较,说明病史模型与其他信息源的相对表现。 |
Figure 3|生成多年未来轨迹
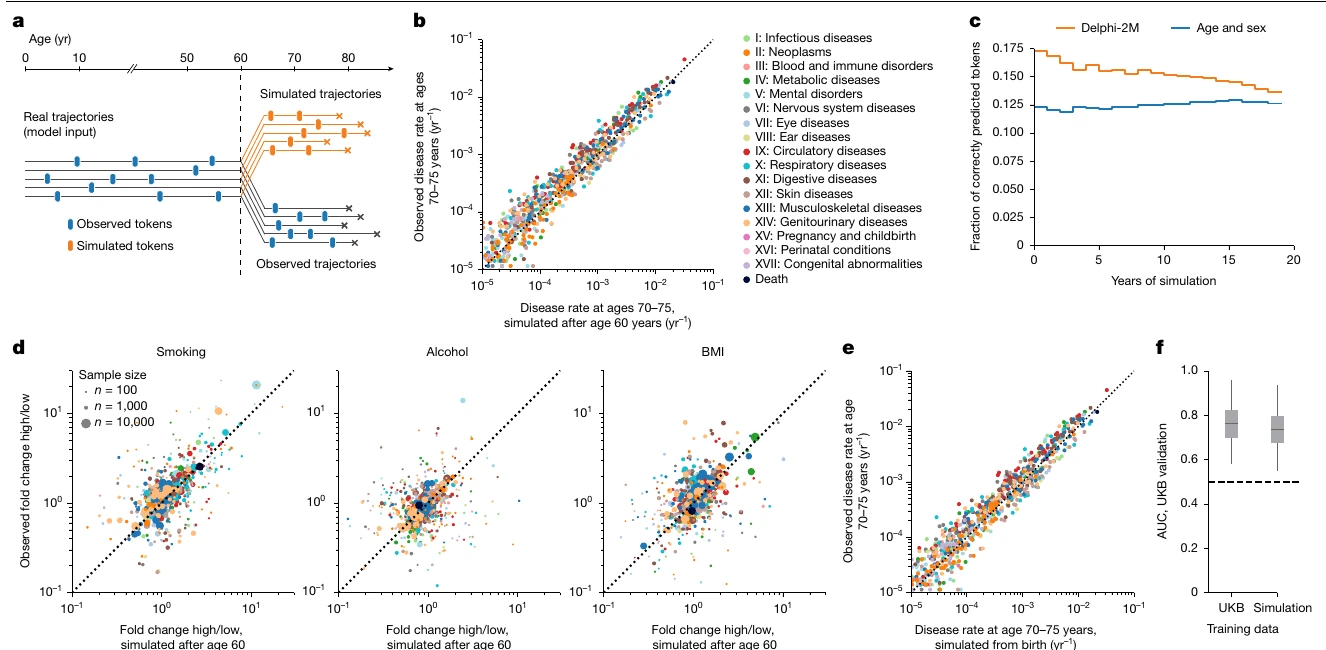
原图来源:所用 PDF 文件第 5 页,Figure 3。点击图片可查看原图。
图3区分群体模拟与个体命中。对63622人各生成一条未来轨迹可检验总体发生率是否再现,逐年命中率则显示单人事件仍有不确定性。高低暴露组率倍数被保留,说明训练关联进入生成,并非已证明暴露的因果效应。合成数据训练模型得到较接近性能,显示可学习信息被保留,但并不自动保证隐私安全或摆脱训练偏差。模拟越长,采样误差和模型误差可能累积,不能把二十年预测视为所有个体都准确。
| 子图 | 讲解 |
|---|---|
| a | 用 63,622 人 60 岁前病史各生成一条未来轨迹,再与本人后续观察比较。 |
| b | 模拟的 70–75 岁疾病发生率与实际率对照,检验群体分布再现。 |
| c | 逐年诊断命中比例高于只用年龄/性别的基线,但随预测时间变化,避免把群体准确率等同个人命运。 |
| d | 模拟与实测的高低吸烟、饮酒、BMI 组疾病率倍数比较,检验生成数据是否保留暴露关联。 |
| e | 从出生开始模拟后的疾病率与实际对照,检验更长生成跨度。 |
| f | 在真实 UKB 或生成合成数据上训练模型后的疾病风险 AUC,评估合成轨迹保留的可学习信息。 |
Figure 4|病史如何影响风险
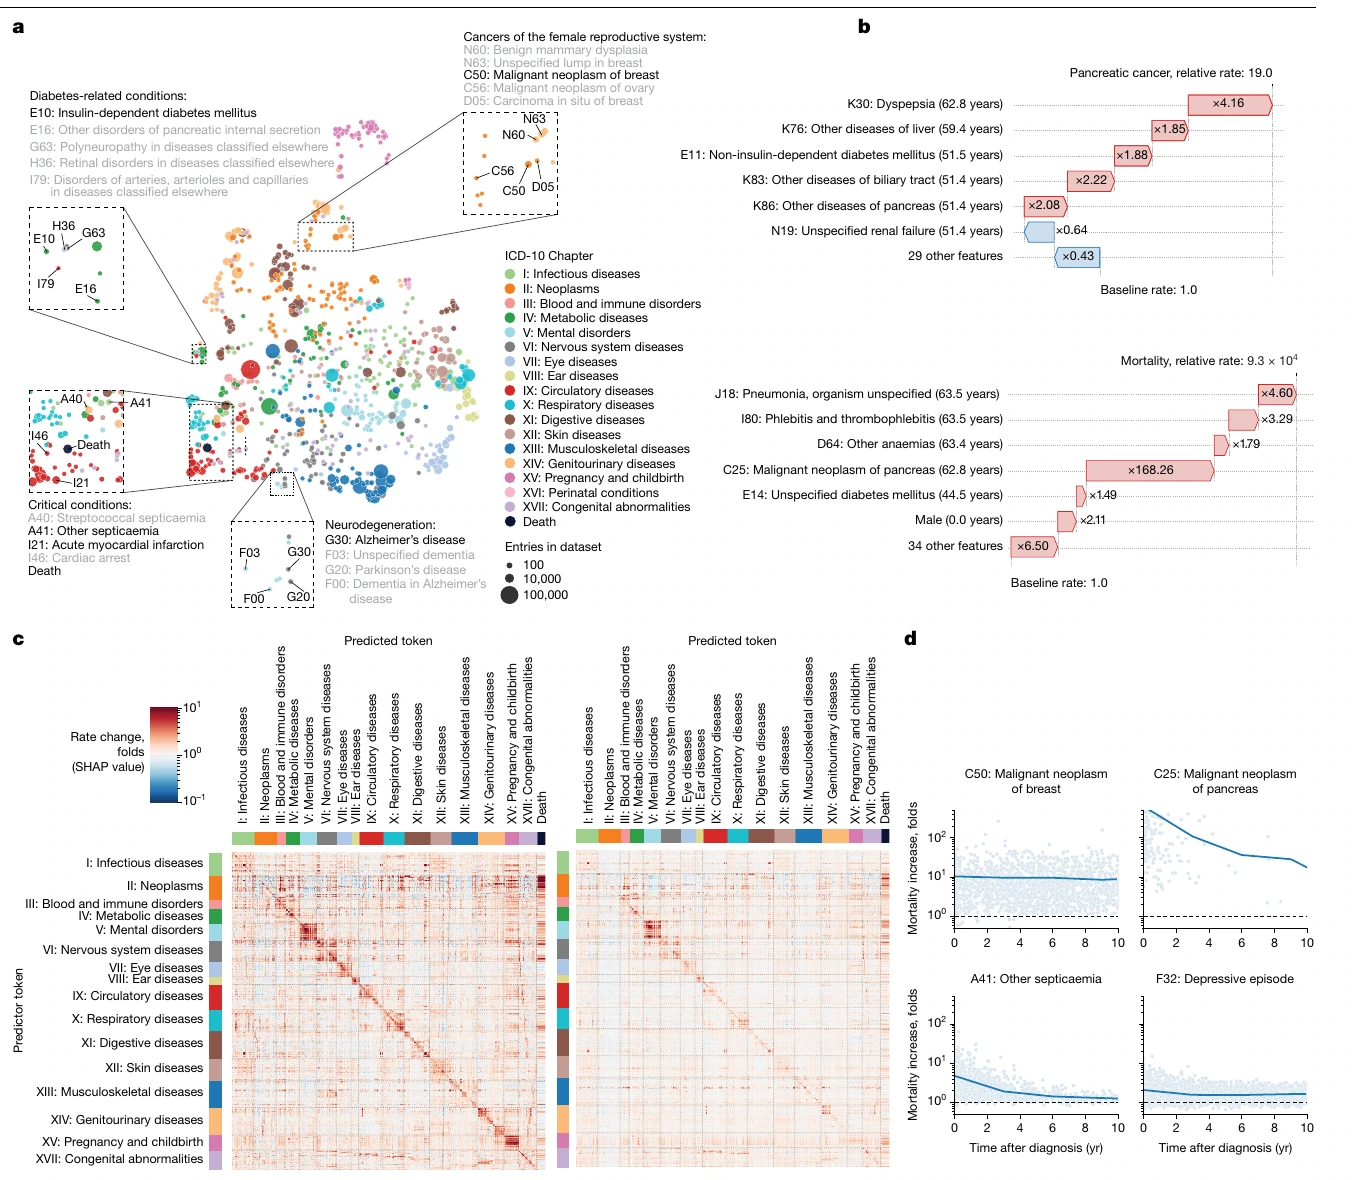
原图来源:所用 PDF 文件第 6 页,Figure 4。点击图片可查看原图。
图4从嵌入和SHAP观察共病结构。同章节聚类与神经退行性疾病区域说明记录模式相近,二维距离不等于真实机制距离。个体SHAP示例解释风险为何变高,矩阵说明模型学到的依赖,仍可能包含共同记录或诊断细化。时间衰减让短期冲击与长期关联可比较,但它描述模型条件风险,不是直接测得的病理恢复曲线。AD相关token与死亡邻近可生成研究问题,不能据此宣称发现AD的演化起源或因果进展机制。
| 子图 | 讲解 |
|---|---|
| a | 疾病 token 嵌入的 UMAP,同类疾病形成相关区域,显示学得的医学结构。 |
| b | 两个个体病史的 SHAP,分别解释胰腺癌风险和死亡风险由哪些既往事件贡献。 |
| c | 778 个疾病 token 对其他疾病/死亡的平均 SHAP 矩阵,红色增加风险、蓝色降低风险,揭示学习到的关联网络。 |
| d | 选定疾病诊断后死亡风险贡献随时间变化,说明模型捕获某些疾病的长时程效应及短期冲击。 |
Figure 5|外部泛化与记录缺失偏差
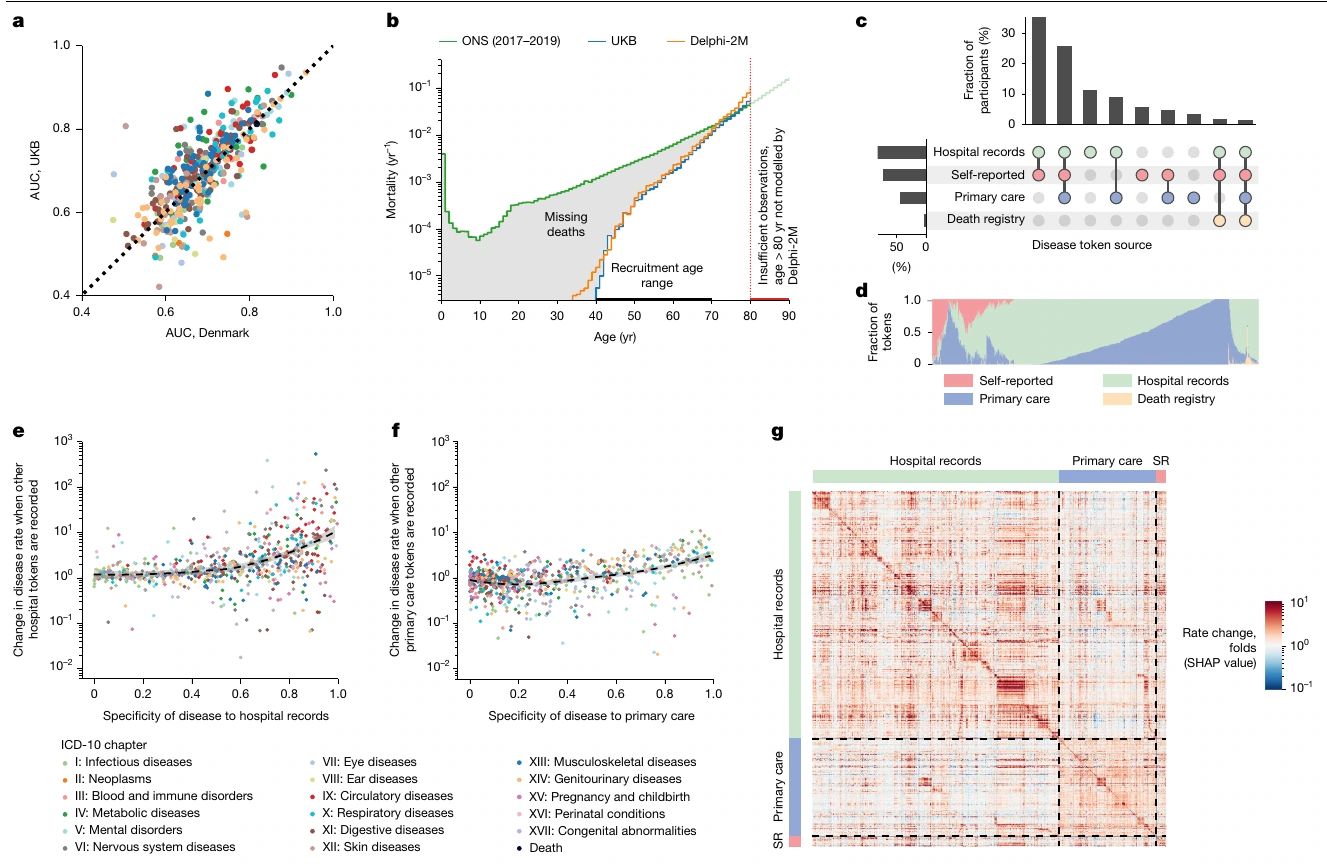
原图来源:所用 PDF 文件第 7 页,Figure 5。点击图片可查看原图。
图5主动展示数据偏差,是整篇文章最有方法学价值的部分。无需重训的丹麦外部表现支持部分迁移,却有下降;UKB与全人口死亡率差异揭示招募存活偏差。首次出现某种记录来源后,其他同来源疾病风险提高,提示模型也学习了“从此能看见记录”的过程。SHAP同来源块不能全部解释为生物学共病。它提醒读者,生成器能忠实复制数据但数据本身可能偏,因此真实自然史推断需要额外采样与测量模型。
| 子图 | 讲解 |
|---|---|
| a | 英国内部与丹麦外部各疾病 AUC 对照,总体相关但有差异,检验跨人群泛化。 |
| b | UKB、模型和全国死亡率比较:模型学到 UKB 招募造成的存活选择偏差,不能直接等同全人口自然史。 |
| c | UpSet 图显示住院、基层医疗、自报、死亡登记信息覆盖的不同组合,说明记录可用性不一致。 |
| d | 每个疾病 token 的来源比例堆积图,显示哪些疾病主要依赖某类记录。 |
| e | 首次住院记录前后发生率变化与住院来源特异性的关系,揭示住院记录缺失/获取导致的预测偏差。 |
| f | 对基层医疗来源作同类偏差分析,说明数据采集过程也可被模型学成风险信号。 |
| g | 按主要记录来源排序的 SHAP 矩阵中,同来源疾病相互影响更强,提示部分关联反映记录来源而非纯生物机制。 |
依据:对应主图、完整图注及正文 Results;实验结果只按本文给出的对象和条件解释。
对无监督AD与病程研究的启发
我的判断是,这篇文章支持用适度规模生成模型研究条件轨迹,但前提是有真实纵向事件。公共单细胞尸检资料可以学习状态结构和病理关联,不能把潜空间排成一条线就当成患者多年病程。若想研究AD进展,需要独立病理等级、纵向临床或重复测量约束,再明确哪些只是横断面推断。
两百万参数提供了硬件可行的范例:复杂问题不必靠巨大模型才能有价值,连续时间、合理目标和外部验证更重要。可以先复现小规模时间编码或事件模型,并以年龄性别、简单生存模型及线性基线检验增量;若没有类似事件数据,则应选择多组学状态模型而不是硬套GPT。
本文还提示把采样过程纳入解释。AD脑区、细胞质量、测序平台和病理样本选择都像医疗记录来源一样,会制造貌似疾病依赖的块结构。外部donor与不同数据来源验证、技术变量预测检查及匹配对照有助区分,但不能保证所有偏差被消除。
对于转座子研究,家族共现和开放状态模块可能反映细胞身份或可比对性。自监督表示可先发现这些结构,再用独立疾病资料检验;生成相似模式并不说明转座子推动AD。把模型学到的模式、病理关联和干预因果分成三层,是我最愿意从本文迁移的写作与研究原则。
