17.GEARS:原图、模型逻辑与研究范式

17.GEARS:原图、模型逻辑与研究范式
Perry论文题名: Predicting transcriptional outcomes of novel multigene perturbations with GEARS
期刊与年份: Nature Biotechnology,2024。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Nature Biotechnology,2024;以当前 PDF 为准。
研究瓶颈怎样转化为问题
组合扰动数量增长很快,且有些基因从未在训练中被扰动。只为已见基因学习独立字典,很难推断这些新组合。GEARS 将基因关系图作为信息桥梁:未见基因仍有已知功能或表达邻居,可从邻居传播扰动先验。依据设计逻辑推断,其 idea 同时针对两个瓶颈——未见单扰动与非加性组合——而非只在表达空间把两个单扰动相加。
输入、目标与结构
输入包括对照表达和被激活/抑制基因集合,基因与扰动嵌入通过关系图聚合,再组合、跨基因处理和基因特定输出层预测扰动后表达。图先验降低未见扰动的冷启动困难,非线性层容纳交互。监督来自真实单细胞扰动表达;图关系不必等于直接物理调控。输出是表达表型,对增殖、疾病逆转或药物协同仍需另设实验读出。
Figure 1:GEARS 的问题与架构
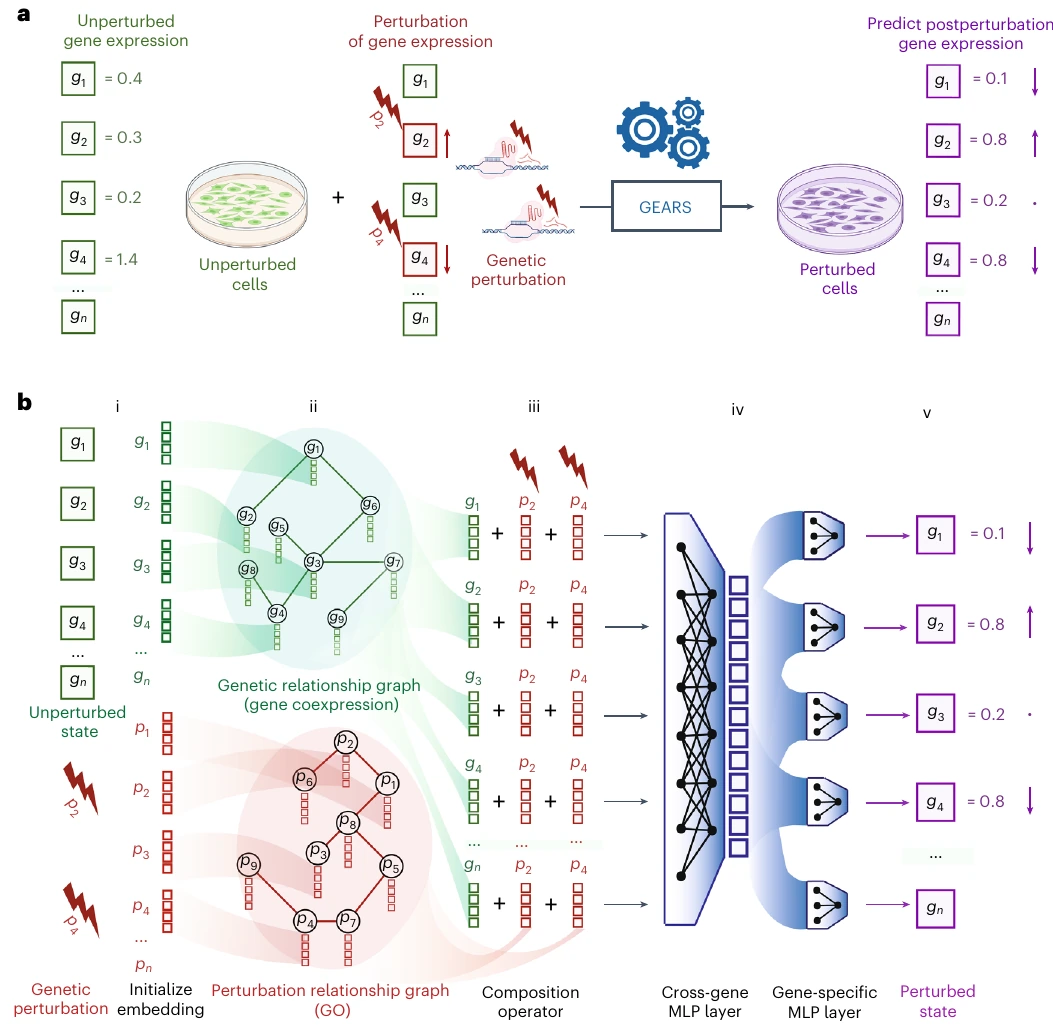
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 输入未扰动表达及被扰动基因集合,预测每个基因的扰动后表达。 |
| b | 基因与扰动嵌入分别通过关系图的图神经网络聚合,组合扰动信息后经跨基因层和专属输出层产生表达;图先验帮助对未见扰动泛化。 |
a 明确模型从对照状态出发,b 说明图增强如何把未测基因与训练信息联系。若某基因缺图邻居或网络来自不同细胞,泛化也会困难。关系图可包含测试基因的已有生物知识,这属于方法输入,不能描述成完全无先验的新基因预测。新研究应固定图版本,并用去图、随机图及简单相加消融辨别真正信息增量。
Figure 2:单基因及双基因扰动预测
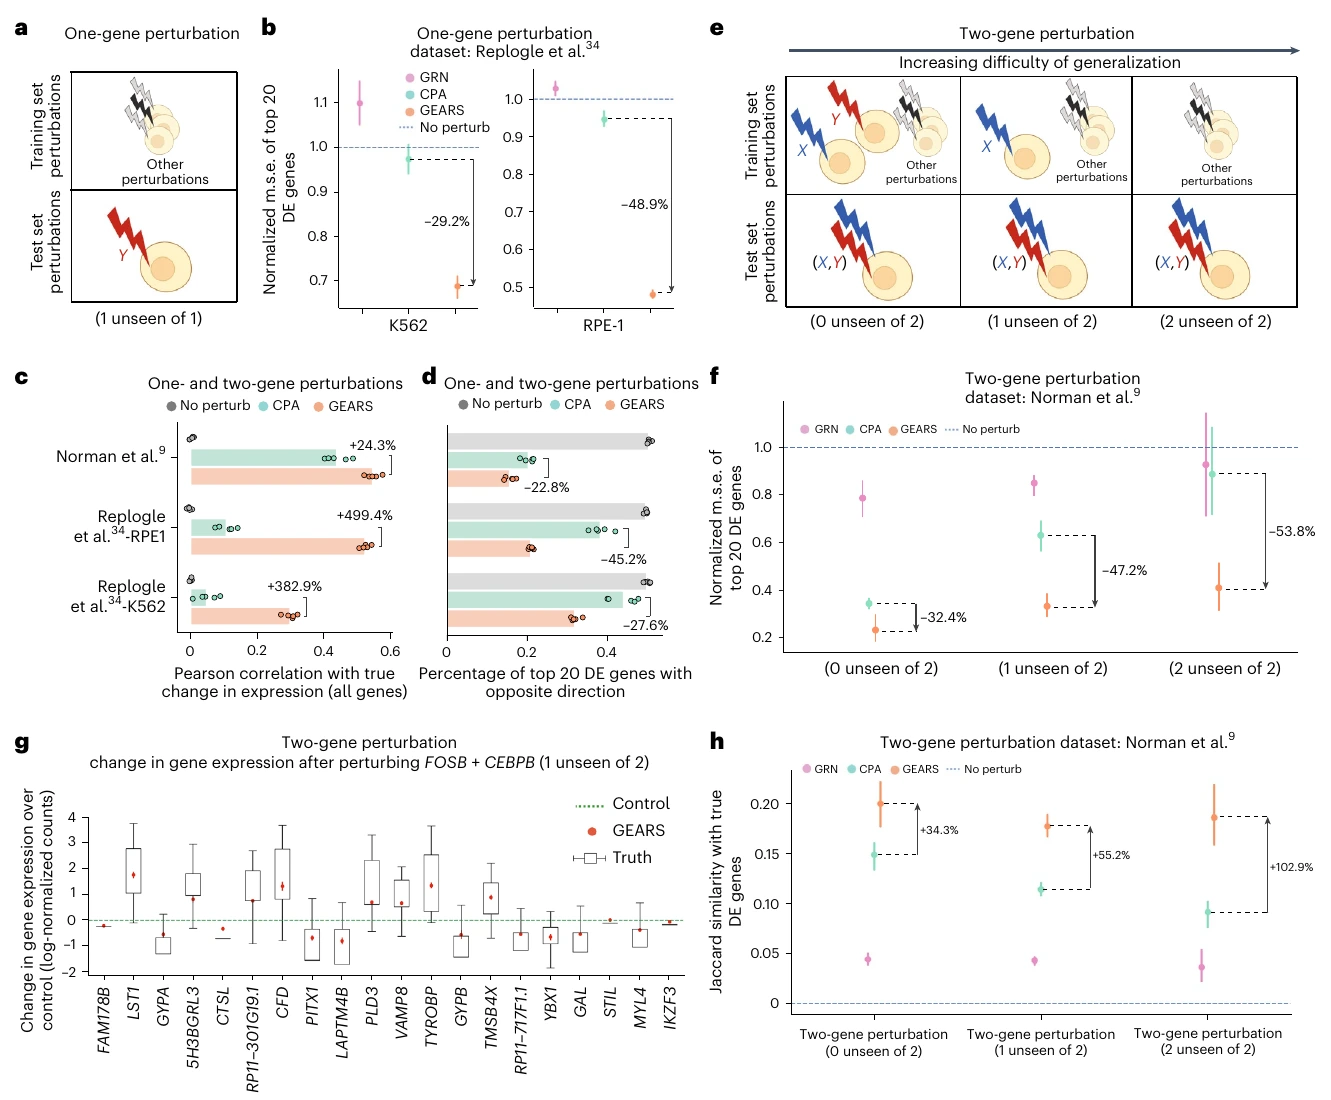
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 单基因训练/测试划分示意,测试基因的扰动未在训练中出现。 |
| b | 比较前 20 个差异基因的标准化均方误差,检验是否比“无扰动”及其他模型更准确。 |
| c | 比较全基因预测与真实表达差的 Pearson 相关,关注响应而非基线表达。 |
| d | 统计前 20 个差异基因预测方向错误比例,评估上/下调是否正确。 |
| e | 双基因测试按两个基因已见情况划分类别,区分组合未见与单个基因未见。 |
| f | 各类双基因测试的标准化均方误差,检验泛化难度。 |
| g | FOSB+CEBPB 的真实差异基因箱线图与预测均值;训练只见过 FOSB 单扰动,检验组合表达方向和幅度。 |
| h | 预测与真实差异基因集合的 Jaccard 相似度,检查响应基因是否找对。 |
将双基因分为两个单基因均见、一个见或均未见,是比随机拆细胞更有意义的外推评估。前 20 DEGs 的误差、变化相关和方向错误刻意避开基线表达高相关的陷阱。g 的具体例子必须与总体指标一起看,h 则检查是否找对响应集合。差异基因根据真实测试结果定义可用于评价,但不能反过来作为模型预测时可知的输入。
Figure 3:非加性遗传相互作用
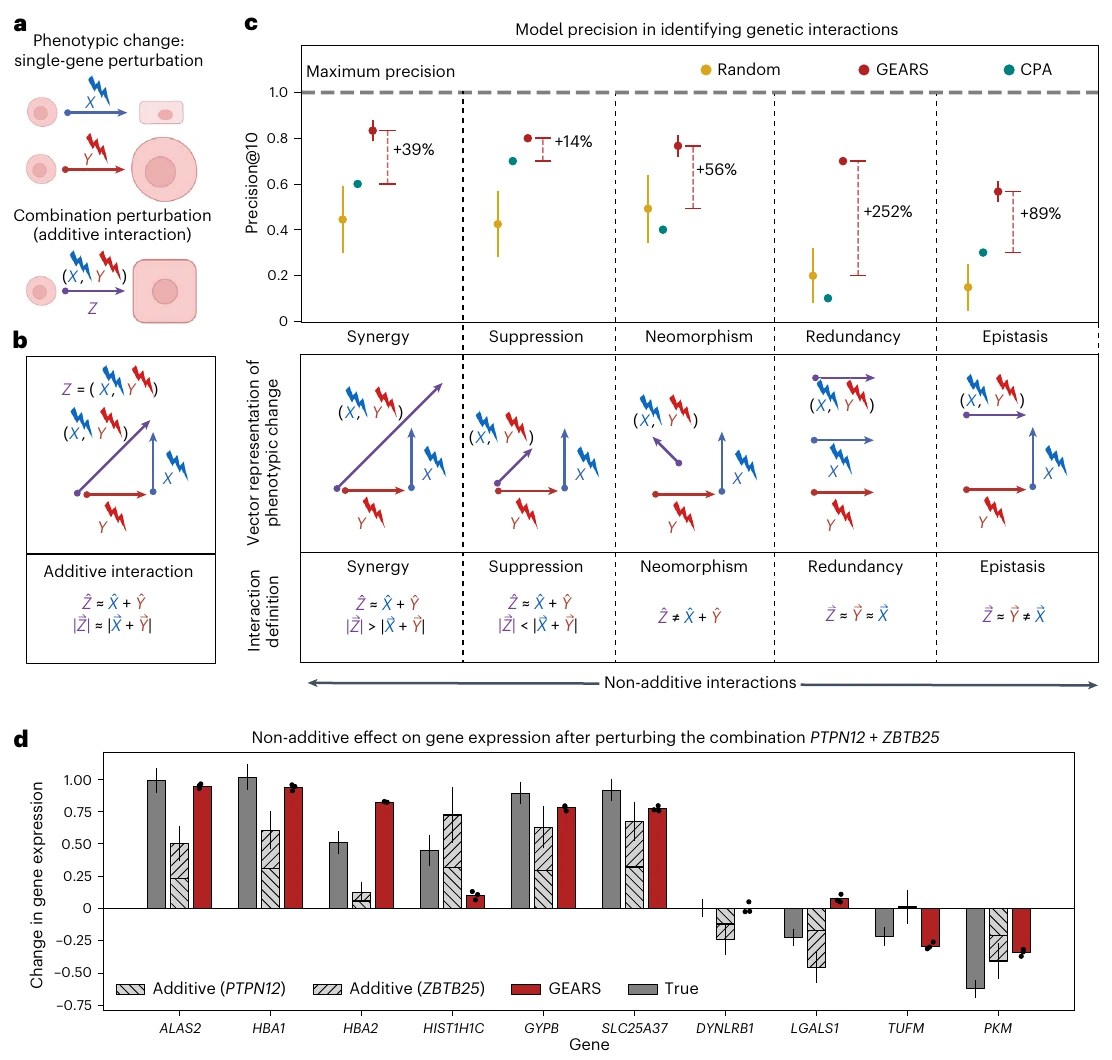
原图来源:所用 PDF 文件第 5 页,Figure 3。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 以两个单扰动效应相加定义简单加性预期。 |
| b | 示意协同、抑制、新形态、冗余、上位性等交互类型,说明组合如何偏离加性。 |
| c | 比较前十预测组合真正具有对应交互的比例 precision@10,评估模型推荐实验的效率。 |
| d | PTPN12+ZBTB25 的真实表达、单扰动相加及 GEARS 预测比较;GEARS 更能捕捉非加性组合后果。 |
a/b 先定义加性基线及交互类别,之后的 precision@10 问模型是否能优先推荐真正强交互,贴近有限实验预算。表达非加性不必等于细胞生长的药物协同,交互类型还依赖选用的表达距离和回归定义。PTPN12+ZBTB25 的单扰动相加对照说明为何需要非线性,但一个成功案例不能证明所有组合有效;推荐集合仍需实际实验检验。
Figure 4:搜索新的表达表型
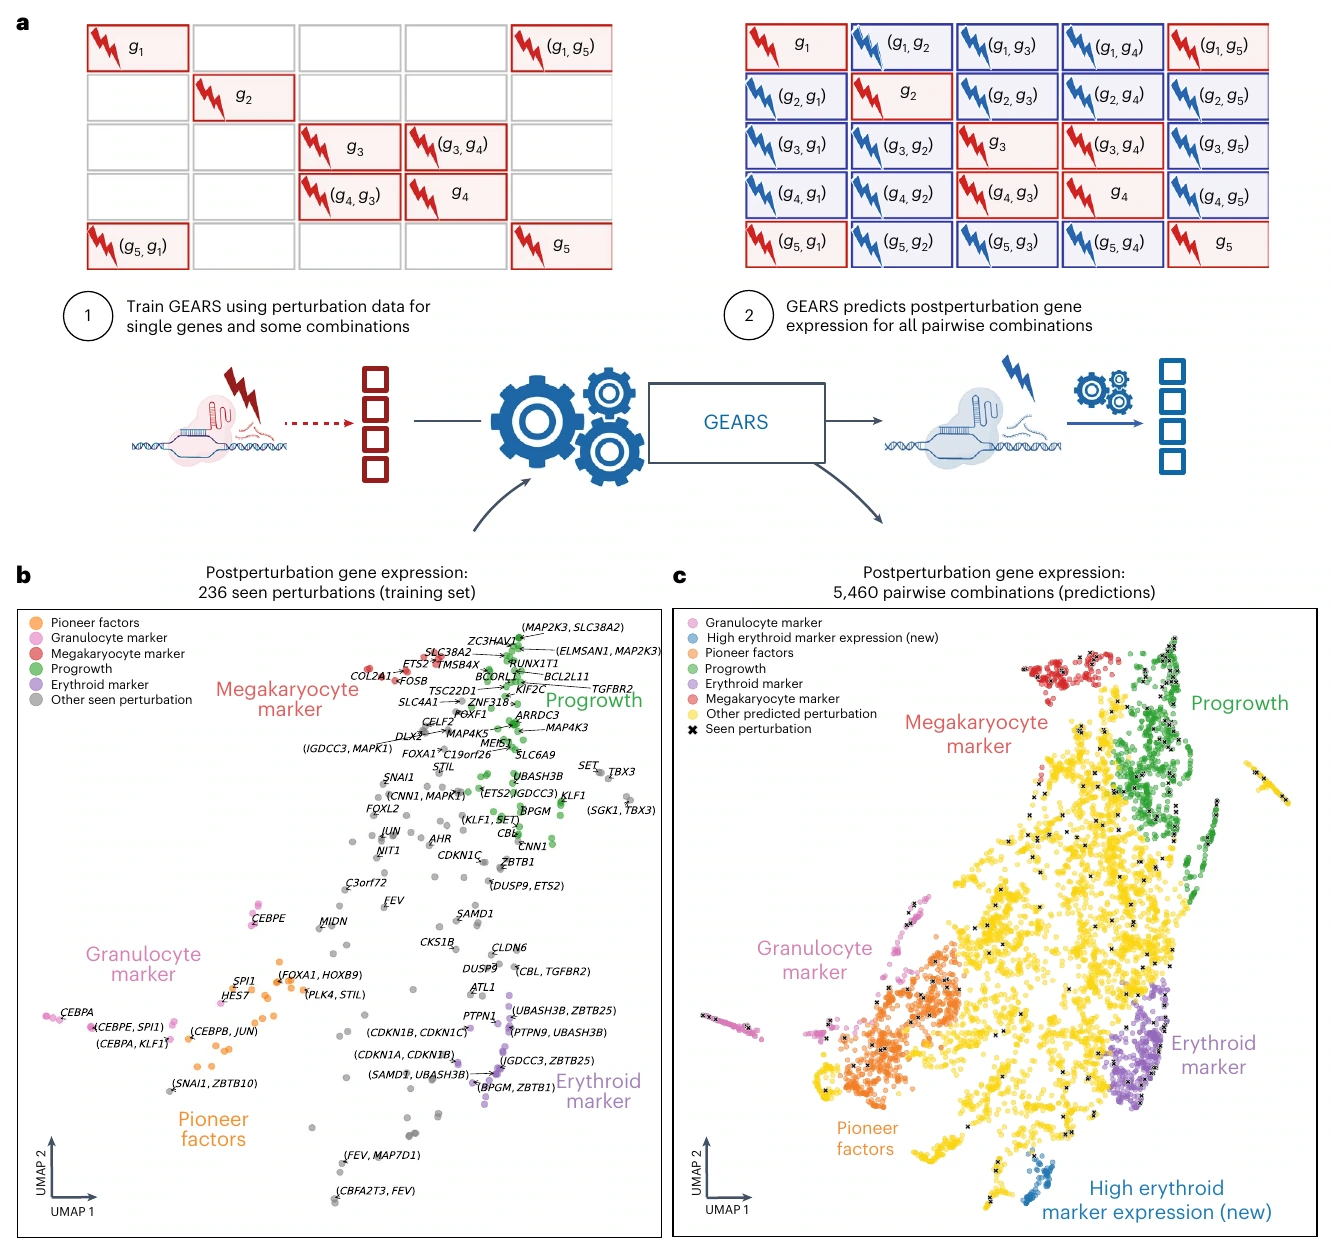
原图来源:所用 PDF 文件第 6 页,Figure 4。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 对给定基因集合全部两两组合预测的流程。 |
| b | 训练中 102 个单基因及 128 个双基因扰动的低维表达表型图,作为已见范围。 |
| c | 预测 5,151 个两两组合后的表型分布,许多预测落在已见表型之外;颜色按 marker 注释群集,提示后续可实验检验的新状态。 |
预测 5,151 组合扩大可探索空间,UMAP 中离开已见表型提示候选新状态,而非新细胞状态已存在。降维会压缩距离,聚类 marker 也来自模型输出,不能作为独立验证。实际选择应考虑训练距离、不确定性和生物可行性,优先检验多个代表组合,而不只挑最大视觉位移。
Figure 5:大规模遗传交互图
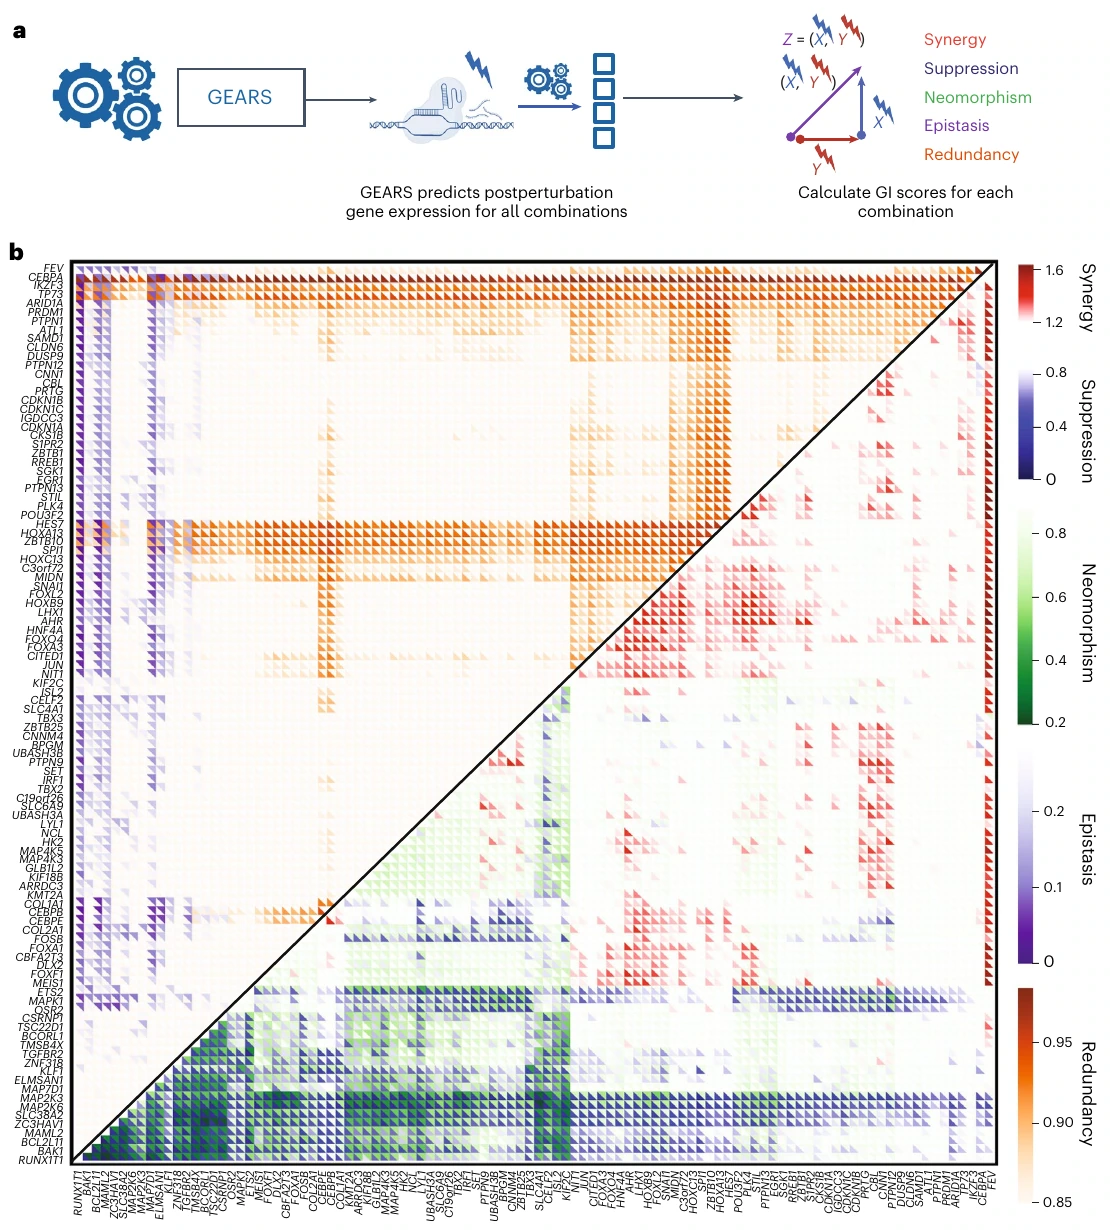
原图来源:所用 PDF 文件第 7 页,Figure 5。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 从组合表达预测计算五种交互分数的流程。 |
| b | 102 个基因全部两两组合的多维交互地图,以不同颜色表示交互类型,展示模型可筛选的候选组合空间。 |
交互地图汇总五种评分,方便为不同目标选择组合,但整张地图是推断产物。相同训练表达、图先验和评分函数会造成相关误差,彩色网络不能算多个正交证据。与已测交互的比较为局部可靠性提供支持,未测边仍保留候选性质。使用者应保存预测版本和阈值,避免后续从模型地图中挑最符合故事的边再宣称发现。
我的理解与可迁移设计
GEARS 值得借鉴的是把‘未见’拆清楚,及用响应增量而非终点总表达评估。AD 公共观察数据没有随机基因扰动,不能直接训练出相同意义的组合干预模型;需有与目标细胞相关的 Perturb-seq 或 CRISPR 表达数据。对 DNA 变异,也应区分未见替换、未见位点和未见研究,位点内随机拆分通常过于容易。图先验可以连接 enhancer 和基因,但关联边仍须验证。资源有限时先建立小的真实扰动任务和相加基线,再询问图信息是否增加跨基因泛化,而不是直接生成巨大的 AD 治疗组合表。
如果两个候选都只有同一背景的功能信息,组合预测所需的是它们相互作用的证据;用模型补全可以提出假说,但不能替代实验标签。应明确哪些边已测,哪些是插值,哪些为真正外推,并把失败条件同样保留。
此外,未见基因扰动仍可能有该基因的普通表达和公共图知识,数据契约必须逐项列清楚。对新的细胞类型,网络和响应可能都变,不能只依据旧细胞系验证就承诺泛化。独立测试的目标应是干预条件或研究,不是随机单细胞;预测均值和细胞间方差也应分别评价。只有这样,模型推荐的实验才有可解释的成功概率。
