28.crossNN:原图、模型逻辑与研究范式

28.crossNN:原图、模型逻辑与研究范式
Perry论文题名: crossNN is an explainable framework for cross-platform DNA methylation-based classification of tumors
期刊与年份: Nature Cancer,2025。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Nature Cancer,2025;以当前 PDF 为准。
研究瓶颈怎样转化为问题
跨甲基化平台的困难不仅是值的批次不同,更是 CpG 覆盖集合不同。crossNN 用缺失与甲基化状态分开的编码及极高随机遮蔽训练,让同一分类器适应不同稀疏测量。依据设计逻辑推断,idea 是把平台差异的一部分变成训练中可见的缺失条件,再用多种真实平台检查。甲基化类别是监督终点,分类标记不是自动的致癌位点。
输入、目标与模型选择
缺失 0、未甲基化 −1、甲基化 1 的二值化输入,避免把缺失当生物学未甲基化;99.75% 遮蔽和 1,000 epoch 通过重采样提供稀疏训练。随机遮蔽提供冗余学习,但真实平台可能有非随机覆盖、噪声和细胞混合,所以独立验证不可省。分类置信的 MC 与家族 MCF 层级、芯片与测序阈值各不同,不能只报一个总体精确率。
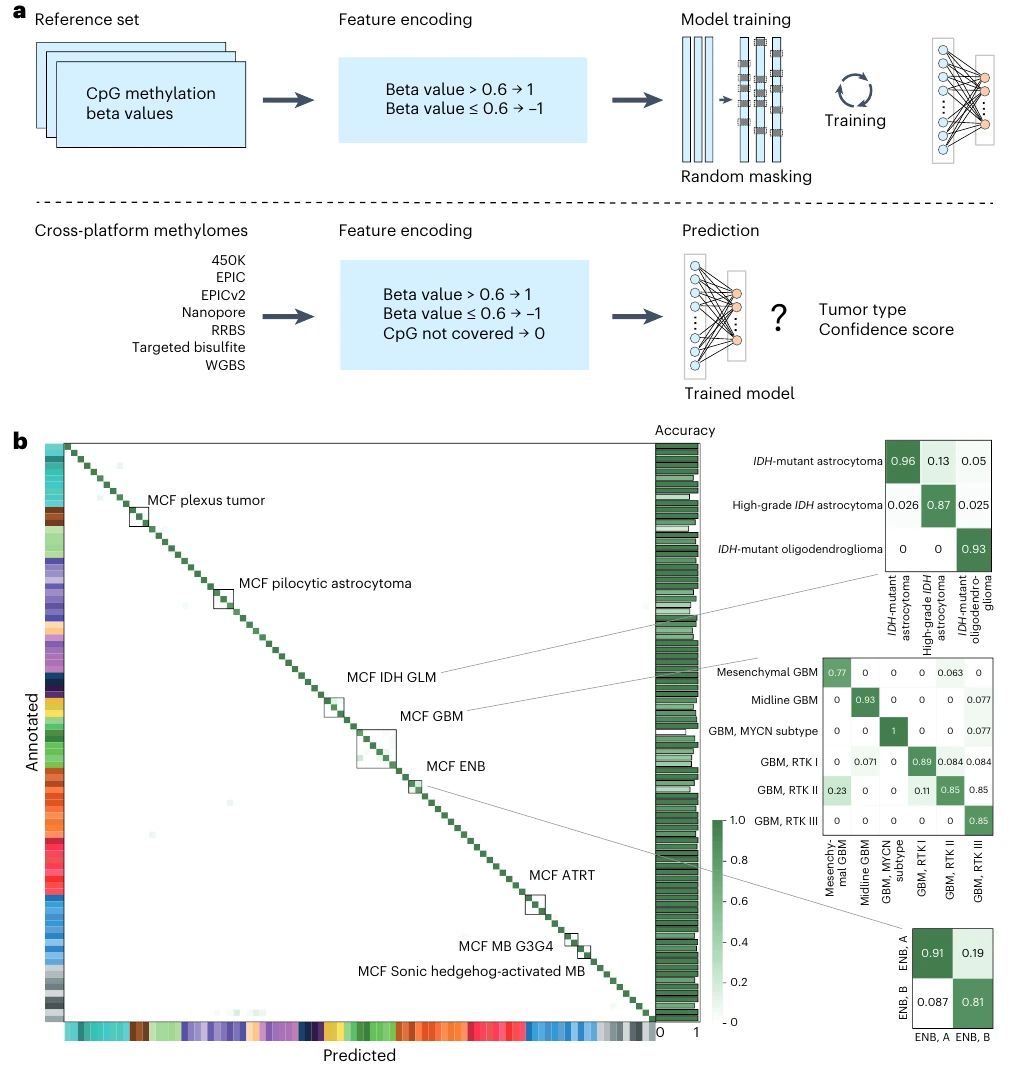
Figure 1:随机遮蔽训练与内部分类表现
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 模型将缺失位点编码为 0、未甲基化为 −1、甲基化为 1,并在训练中反复随机遮蔽位点;通过学习稀疏输入适应不同平台的覆盖。 |
| b | 五折交叉验证的混淆矩阵;主要混淆发生在同一家族的近似亚型,具体类 MC 与家族 MCF 层级应分别评估。 |
编码和随机遮蔽是模型泛化的重要设计,混淆矩阵则检验哪些细分类别仍相近。MCF 正确不等于 MC 正确,家族层更高准确率反映目标放宽。仿真稀疏性支持方法,但不代替真实平台验证;缺失与未甲基化分开也不消除二值化损失的连续信息。
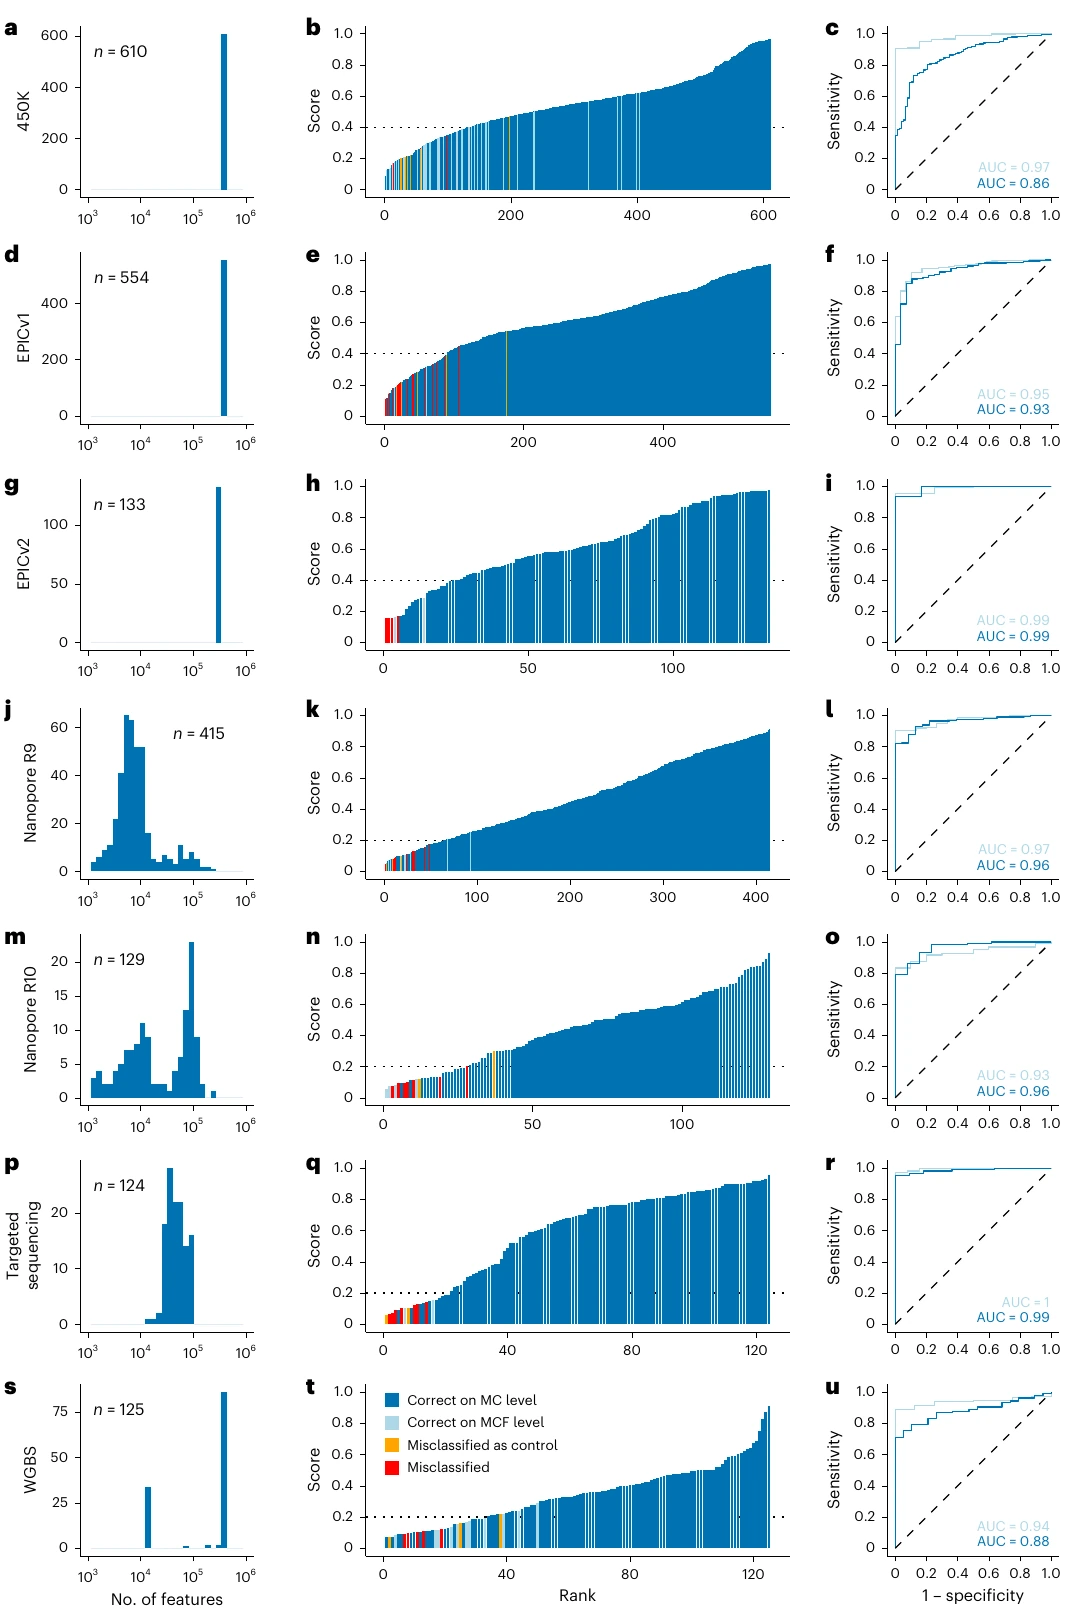
Figure 2:七个平台的独立脑肿瘤验证
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 450K 芯片 的 610 个样本输入 CpG 数分布;记录该平台实际覆盖了多少模型特征,用于比较不同实验平台的信息稀疏程度。 |
| b | 450K 芯片 样本按置信分数排序的瀑布图;颜色区分具体甲基化类别 MC 正确、仅类别家族 MCF 正确及误判,虚线为诊断阈值。显示哪些预测可接受、哪些应保留为低置信。 |
| c | 450K 芯片 中用置信分数识别分类是否正确的 ROC,分别评价 MC 与 MCF 层级;曲线反映分数区分可靠预测的能力,并非肿瘤/健康筛查 ROC。 |
| d | EPICv1 芯片 的 554 个样本输入 CpG 数分布;记录该平台实际覆盖了多少模型特征,用于比较不同实验平台的信息稀疏程度。 |
| e | EPICv1 芯片 样本按置信分数排序的瀑布图;颜色区分具体甲基化类别 MC 正确、仅类别家族 MCF 正确及误判,虚线为诊断阈值。显示哪些预测可接受、哪些应保留为低置信。 |
| f | EPICv1 芯片 中用置信分数识别分类是否正确的 ROC,分别评价 MC 与 MCF 层级;曲线反映分数区分可靠预测的能力,并非肿瘤/健康筛查 ROC。 |
| g | EPICv2 芯片 的 133 个样本输入 CpG 数分布;记录该平台实际覆盖了多少模型特征,用于比较不同实验平台的信息稀疏程度。 |
| h | EPICv2 芯片 样本按置信分数排序的瀑布图;颜色区分具体甲基化类别 MC 正确、仅类别家族 MCF 正确及误判,虚线为诊断阈值。显示哪些预测可接受、哪些应保留为低置信。 |
| i | EPICv2 芯片 中用置信分数识别分类是否正确的 ROC,分别评价 MC 与 MCF 层级;曲线反映分数区分可靠预测的能力,并非肿瘤/健康筛查 ROC。 |
| j | 纳米孔 R9 的 415 个样本输入 CpG 数分布;记录该平台实际覆盖了多少模型特征,用于比较不同实验平台的信息稀疏程度。 |
| k | 纳米孔 R9 样本按置信分数排序的瀑布图;颜色区分具体甲基化类别 MC 正确、仅类别家族 MCF 正确及误判,虚线为诊断阈值。显示哪些预测可接受、哪些应保留为低置信。 |
| l | 纳米孔 R9 中用置信分数识别分类是否正确的 ROC,分别评价 MC 与 MCF 层级;曲线反映分数区分可靠预测的能力,并非肿瘤/健康筛查 ROC。 |
| m | 纳米孔 R10 的 129 个样本输入 CpG 数分布;记录该平台实际覆盖了多少模型特征,用于比较不同实验平台的信息稀疏程度。 |
| n | 纳米孔 R10 样本按置信分数排序的瀑布图;颜色区分具体甲基化类别 MC 正确、仅类别家族 MCF 正确及误判,虚线为诊断阈值。显示哪些预测可接受、哪些应保留为低置信。 |
| o | 纳米孔 R10 中用置信分数识别分类是否正确的 ROC,分别评价 MC 与 MCF 层级;曲线反映分数区分可靠预测的能力,并非肿瘤/健康筛查 ROC。 |
| p | 靶向甲基化测序 的 124 个样本输入 CpG 数分布;记录该平台实际覆盖了多少模型特征,用于比较不同实验平台的信息稀疏程度。 |
| q | 靶向甲基化测序 样本按置信分数排序的瀑布图;颜色区分具体甲基化类别 MC 正确、仅类别家族 MCF 正确及误判,虚线为诊断阈值。显示哪些预测可接受、哪些应保留为低置信。 |
| r | 靶向甲基化测序 中用置信分数识别分类是否正确的 ROC,分别评价 MC 与 MCF 层级;曲线反映分数区分可靠预测的能力,并非肿瘤/健康筛查 ROC。 |
| s | 全基因组亚硫酸氢盐测序 WGBS 的 125 个样本输入 CpG 数分布;记录该平台实际覆盖了多少模型特征,用于比较不同实验平台的信息稀疏程度。 |
| t | 全基因组亚硫酸氢盐测序 WGBS 样本按置信分数排序的瀑布图;颜色区分具体甲基化类别 MC 正确、仅类别家族 MCF 正确及误判,虚线为诊断阈值。显示哪些预测可接受、哪些应保留为低置信。 |
| u | 全基因组亚硫酸氢盐测序 WGBS 中用置信分数识别分类是否正确的 ROC,分别评价 MC 与 MCF 层级;曲线反映分数区分可靠预测的能力,并非肿瘤/健康筛查 ROC。 |
七平台各三面板依次回答覆盖量、预测正确性与置信排序。这里 ROC 是置信分数识别自身分类是否正确,不能称肿瘤/健康筛查。芯片 >0.4、测序 >0.2 的阈值在相应验证中校准;高精确率须连同接受覆盖率读,不保证新平台任意样本同样可靠。
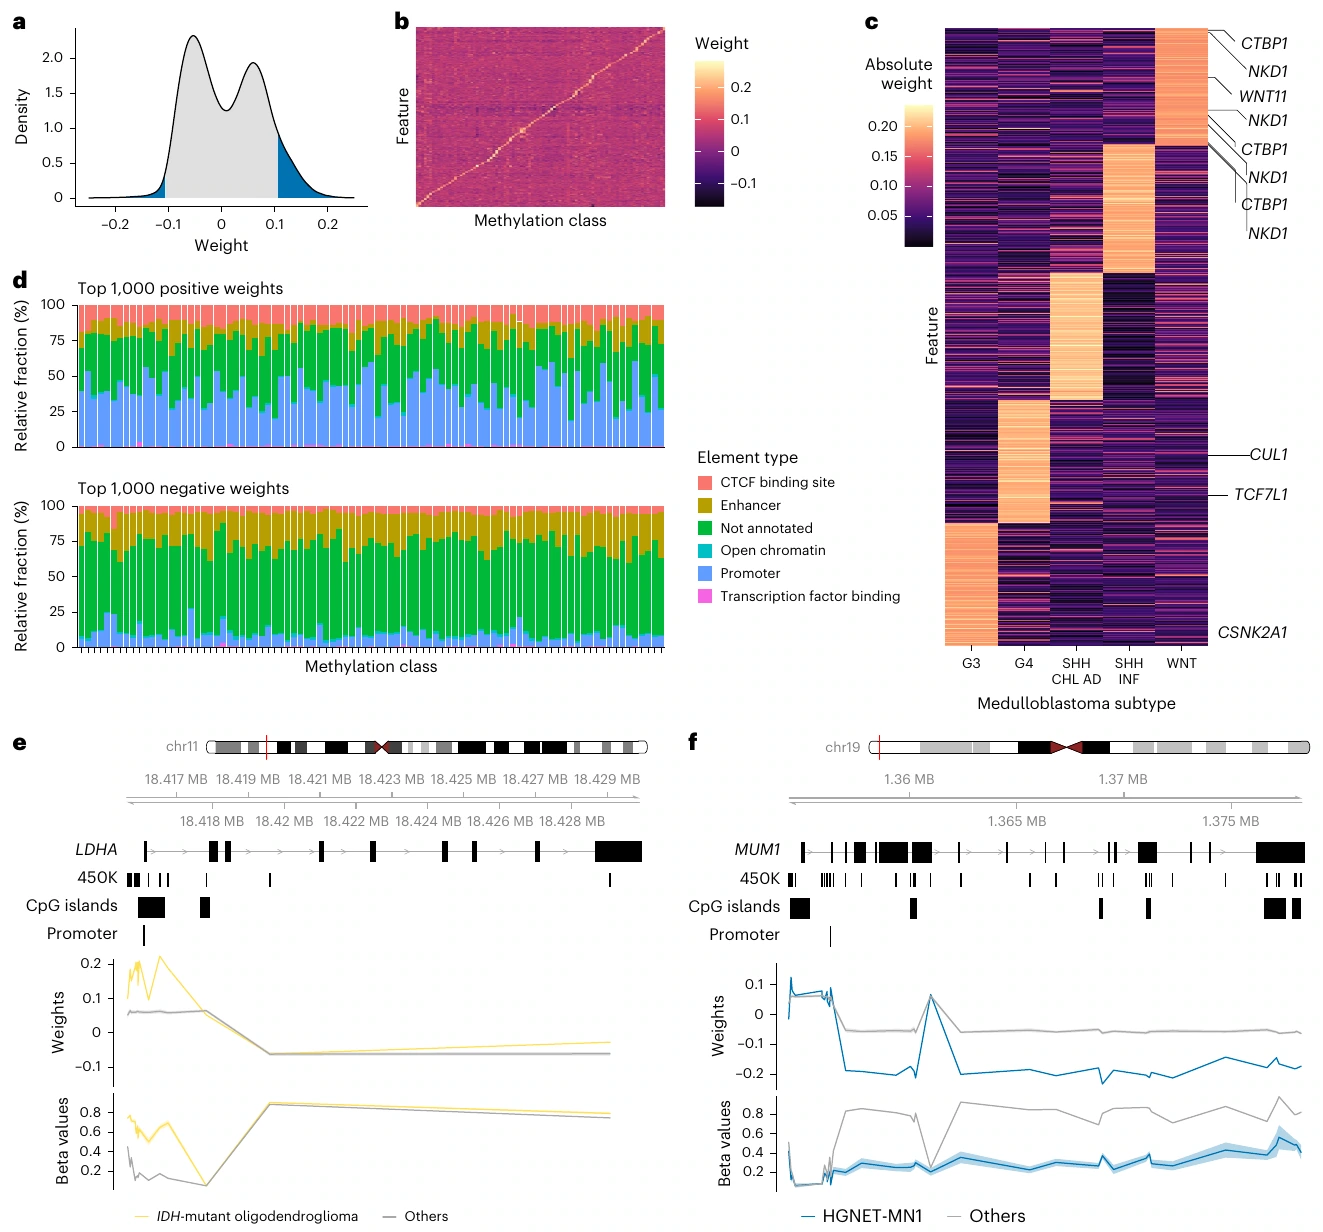
Figure 3:权重如何指向分类标志位点
原图来源:所用 PDF 文件第 6 页,Figure 3。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | IDH 突变、1p/19q 共缺失少突胶质瘤的特征权重分布;高绝对权重位点被突出,正/负权重表示对分类分数不同方向的贡献,这里的分布阴影不是分类 ROC。 |
| b | 91 个甲基化类别各自最高正权重 CpG 的甲基化水平热图;显示模型的重要位点具有类别相关的模式。 |
| c | 不同髓母细胞瘤亚型的前 200 个高权重特征聚类,并标出 Wnt 相关基因;将亚型判别与已知通路背景联系。 |
| d | 各类别前 1,000 个正、负权重位点所覆盖的调控元件注释;比较重要特征在启动子、基因体等背景中的分布。 |
| e | 少突胶质瘤与其余参考样本的 LDHA 区域平均甲基化对照;模型挑出的位点对应启动子差异,给出可定位的分类线索。 |
| f | HGNET-MN1 与其余样本的 MUM1/PWWP3A 区域甲基化;差异主要在基因体,近端 CpG 岛没有同样差异,说明不能只检查启动子 CpG 岛。 |
权重、类别甲基化和基因区域显示可解释分类线索。高权重可能来自与真实驱动共变的标记,LDHA/MUM1 等局部差异不能单独证明表达方向或致癌。正负权重表示模型分类作用,基因体和启动子甲基化也不能统一解读为转录抑制。
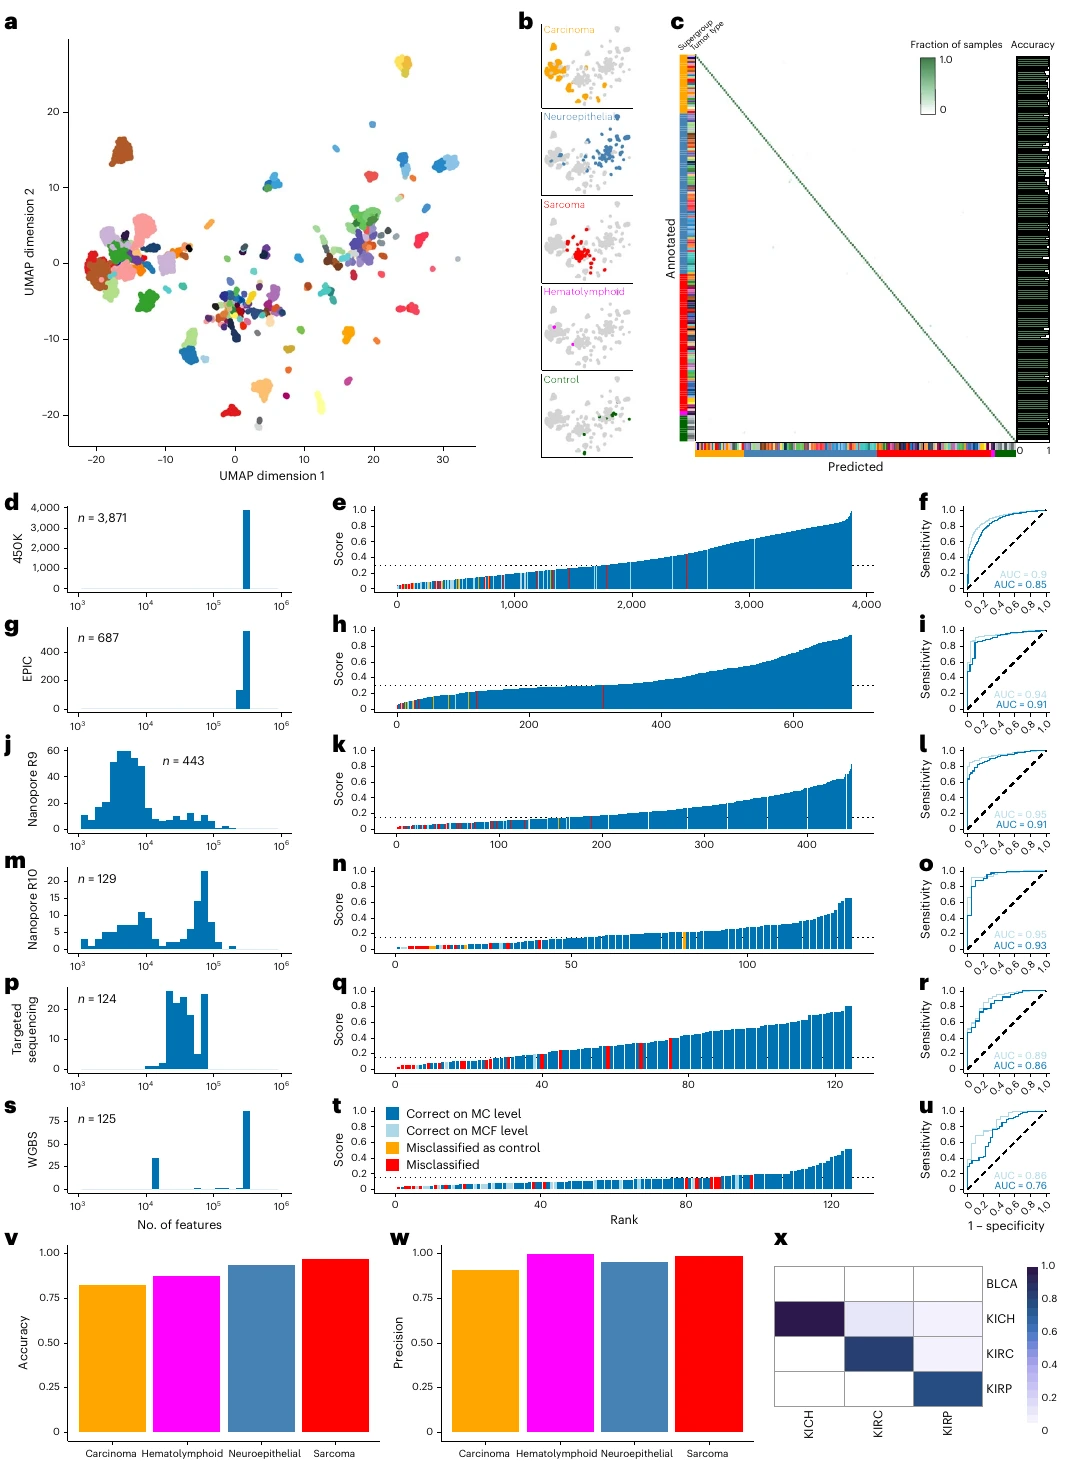
Figure 4:扩展到泛癌分型的验证
原图来源:所用 PDF 文件第 7 页,Figure 4。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| a | 8,382 个泛癌训练样本的 UMAP,展示甲基化参考图谱中的肿瘤分布。 |
| b | 把 a 中样本按癌、造血淋巴系统、神经上皮和肉瘤等大组着色,说明训练集覆盖多个组织谱系。 |
| c | 内部验证混淆矩阵,检查泛癌模型对具体类别及更大分组的识别情况和混淆来源。 |
| d | 泛癌独立验证中 450K 的输入 CpG 特征数分布;显示跨组织后该平台所提供的特征覆盖。 |
| e | 泛癌 450K 队列按分数排序的预测,颜色区分 MC、MCF 层级正确及错误;阈值以上的预测可与实际类别核对。 |
| f | 泛癌 450K 队列的置信分数 ROC,同时比较具体类与家族类的正确性;检验模型在该平台能否识别自身预测的可靠程度。 |
| g | 泛癌独立验证中 EPIC 的输入 CpG 特征数分布;显示跨组织后该平台所提供的特征覆盖。 |
| h | 泛癌 EPIC 队列按分数排序的预测,颜色区分 MC、MCF 层级正确及错误;阈值以上的预测可与实际类别核对。 |
| i | 泛癌 EPIC 队列的置信分数 ROC,同时比较具体类与家族类的正确性;检验模型在该平台能否识别自身预测的可靠程度。 |
| j | 泛癌独立验证中 纳米孔 R9 的输入 CpG 特征数分布;显示跨组织后该平台所提供的特征覆盖。 |
| k | 泛癌 纳米孔 R9 队列按分数排序的预测,颜色区分 MC、MCF 层级正确及错误;阈值以上的预测可与实际类别核对。 |
| l | 泛癌 纳米孔 R9 队列的置信分数 ROC,同时比较具体类与家族类的正确性;检验模型在该平台能否识别自身预测的可靠程度。 |
| m | 泛癌独立验证中 纳米孔 R10 的输入 CpG 特征数分布;显示跨组织后该平台所提供的特征覆盖。 |
| n | 泛癌 纳米孔 R10 队列按分数排序的预测,颜色区分 MC、MCF 层级正确及错误;阈值以上的预测可与实际类别核对。 |
| o | 泛癌 纳米孔 R10 队列的置信分数 ROC,同时比较具体类与家族类的正确性;检验模型在该平台能否识别自身预测的可靠程度。 |
| p | 泛癌独立验证中 靶向甲基化测序 的输入 CpG 特征数分布;显示跨组织后该平台所提供的特征覆盖。 |
| q | 泛癌 靶向甲基化测序 队列按分数排序的预测,颜色区分 MC、MCF 层级正确及错误;阈值以上的预测可与实际类别核对。 |
| r | 泛癌 靶向甲基化测序 队列的置信分数 ROC,同时比较具体类与家族类的正确性;检验模型在该平台能否识别自身预测的可靠程度。 |
| s | 泛癌独立验证中 WGBS 的输入 CpG 特征数分布;显示跨组织后该平台所提供的特征覆盖。 |
| t | 泛癌 WGBS 队列按分数排序的预测,颜色区分 MC、MCF 层级正确及错误;阈值以上的预测可与实际类别核对。 |
| u | 泛癌 WGBS 队列的置信分数 ROC,同时比较具体类与家族类的正确性;检验模型在该平台能否识别自身预测的可靠程度。 |
| v | 跨全部平台,分别统计四个肿瘤大组的准确率;评估泛癌覆盖是否在每个组织大类都保持效果,且各组验证样本量不同。 |
| w | 四个大组的精确率,考察预测为该类的病例中有多少真正属于该类;它与 v 的准确率含义不同。 |
| x | 肾嫌色、肾透明细胞和肾乳头状癌的独立分类混淆矩阵;列为真实亚型、行为模型预测,展示相近器官内亚型的区分及其错误。 |
阅读提醒
- MC 为具体甲基化类别,MCF 为甲基化类别家族。瀑布图中的两级正确性不能互相替代;跨平台置信阈值也不同。权重分析提供分类关联线索,不自动证明甲基化位点驱动肿瘤发生。
泛癌扩展重新学习更多类别,并在多个平台复核;UMAP 和内部混淆之后的独立面板才检验外推。不同器官大组样本量和精确率不同,不能以总体 97.8%代表每类。肾亚型列为真实、行为预测,读错轴会反转错误含义;近似类别应逐项检查。
我的理解与可迁移设计
可迁移的是先定义测量缺失,再设计真实跨平台验证。AD ATAC/TE 区低信号可能来自不开放、低覆盖或不可唯一比对,不能统统编码同一种阴性。缺失mask能帮助模型鲁棒,却不能补出正式功能标签。资源有限的小模型也可做有效研究,前提是输入契约、置信阈值和外部研究分母清楚;分类解释仍需与实际等位序列机制分开。
