44.NYUTron:原图、模型逻辑与研究范式

44.NYUTron:原图、模型逻辑与研究范式
Perry论文题名: Health system-scale language models are all-purpose prediction engines
期刊与年份: Nature,2023。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: 在医院病历文本上预训练的语言模型能否经少量任务微调预测多种临床和运营结局,并在真实流程中前瞻运行?
医生已经写下的文本能否成为统一预测输入
结构化临床模型常需要为每个任务重新抽取字段、处理接口并接入流程,优秀历史性能也不保证上线。本文利用医生记录已经综合病史、检查和决策这一特点,以文本作为多任务公共入口。我的推测是,idea来自模型“最后一公里”的部署障碍,语言表示提供降低任务开发成本的方法;这符合引言,却不是作者个人灵感经历的记录。
掩码预训练与结局微调必须分开
可复用编码器与各任务分类头分别训练,是理解“通用预测引擎”实际含义的基础。
五种任务也体现标签性质不同。再入院可能受计划性治疗和医疗可及性影响,死亡是更直接的终点,合并症指数属于信息填补,保险拒付又受行政规则影响。因此多任务成功证明表示可复用,不能把行政预测与医学机制发现放在同一个证据层级。文本输入能够降低字段抽取成本,同时也需要确认敏感属性或处方习惯不会成为不适当捷径。讨论泛化时应检查每个任务的时间、人口和决策背景,而不是只给五个数值组成的平均结论。
NYUTron是约109M参数的BERT类编码器,在7.25百万份病历、约41亿词上做掩码语言学习,再分别用标签微调再入院、死亡、合并症、住院时长和保险拒付任务。预训练不使用这些终点标签,但下游风险预测是监督任务,不能称为完全无监督发现。它也不是提供医学建议的自由文本聊天机器人,而是从输入记录输出任务类别或风险分数。
双向编码适合整合一份已经可获得的病历,注意力捕捉文本关系;是否可以用于某个终点仍取决于记录时间。入院任务用入院信息,出院再入院任务用出院记录,不能混用。医生写下的判断可能增加预测信息,同时携带文档模板、院区惯例和服务流程。模型因此同时学习医疗状态及其记录方式,不应将所有语言信息解释成病理知识。
历史随机拆分、时间留出、跨院区微调和前瞻上线承担不同泛化测试。领域预训练减少标注需求,足够本地微调也可以弥补异地预训练差异。论文不是证明每个医院都必须从头训练自己的模型,更不是证明预训练后无需本地验证。109M参数与巨大的预训练语料应分别理解:模型规模适中并不使数据获取和医院整合成为轻松任务。
前瞻研究为单组、非干预运行,检验真实签署时间之后的预测,而非通过警报改变治疗。医生复核可预防再入院的比例提供行动空间假说,尚未测得实际干预效果。模型能否减少再入院、产生额外复核负担或改善公平性,需要进一步设计。
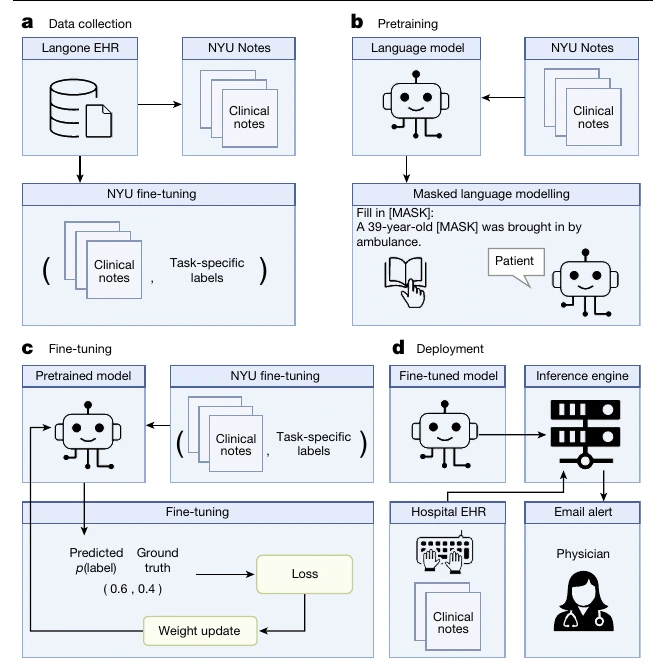
Figure 1|从病历语言预训练到医院部署
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
图1完整展示数据、预训练、微调及部署的区别。预训练目标是填补被遮蔽词,任务标签在后续进入;这使同一表示能被重复使用,却不意味着同一微调模型同时完成所有任务。电子病历签署后推断把模型接到真实流程,压缩加速处理运行延迟,而非增强生物解释。图中的警报工作流是系统设计,不能仅凭箭头证明医生采纳或患者获益。数据时点与输出使用时点应对齐,是临床预测成立的前提。
| 子图 | 讲解 |
|---|---|
| a | 十年 NYU Notes 文本用于预训练,五个带任务标签的数据集用于微调,区分通用语言学习与具体结局监督。 |
| b | 109M 参数的 BERT 类 NYUTron 以掩码语言建模学习医院文本。 |
| c | 将预训练模型微调到再入院等任务,再用留出的历史数据验证。 |
| d | 压缩、加速后接入电子病历,医生签署出院记录时读取文本并产生预测,展示部署工作流。 |
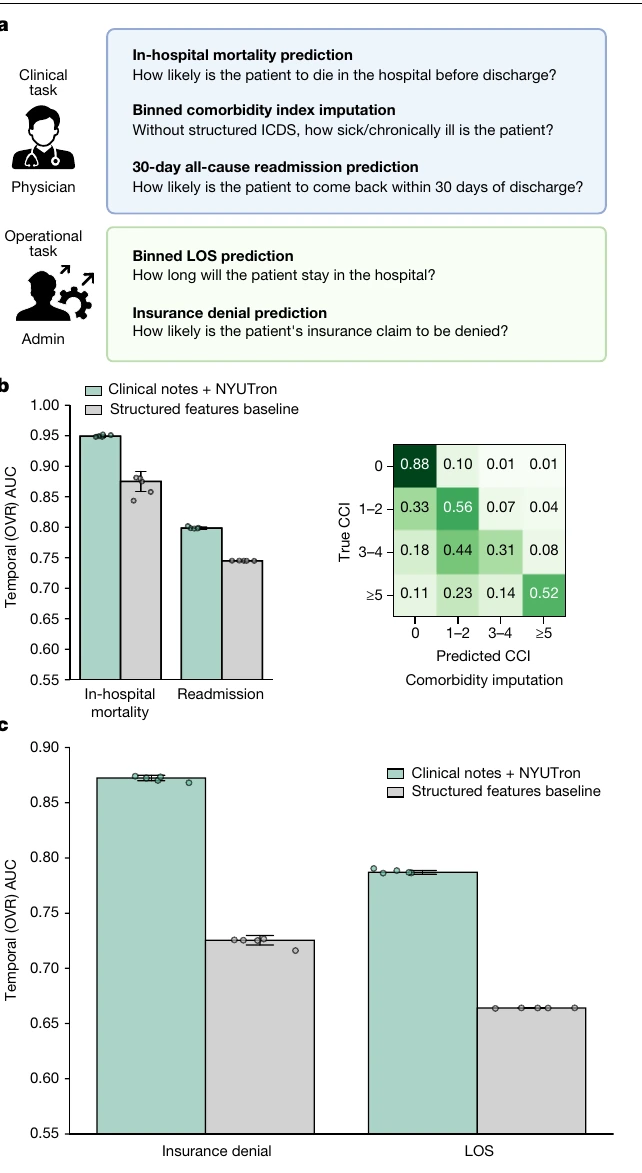
Figure 2|五种任务的时间留出测试
原图来源:所用 PDF 文件第 3 页,Figure 2。点击图片可查看原图。
图2比较五类任务的时间留出性能。死亡AUC较高与再入院AUC较低,反映终点、输入时点和标签差异,不能据此认为模型对死亡机制理解更深。合并症与住院时长被分箱,是分类或填补任务,不是精确连续量预测。结构化基线是重要对照,但文本包含医生整合后的额外信息,因此性能增量不能全归于网络架构。随机种子重复估计训练稳定性,不覆盖未来医院流程变化或人口转移的不确定性。
| 子图 | 讲解 |
|---|---|
| a | 列出再入院、住院死亡、合并症指数、住院时长和保险拒付五个任务,说明同一语言模型的多任务用途。 |
| b | 三项临床任务的 AUC 及合并症混淆矩阵:再入院约 79.9%、住院死亡约 94.9%、合并症 OVR 约 89.4%,与结构化基线比较。 |
| c | 两项运营任务的 AUC:住院时长约 78.7%、保险拒付约 87.2%,显示文本对资源及行政结局也有预测信息。 |
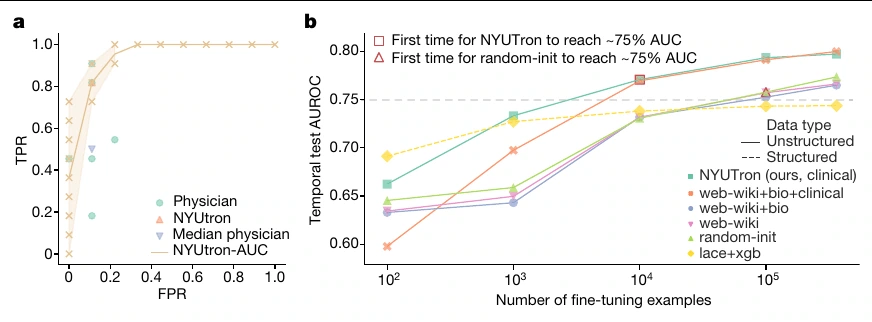
Figure 3|再入院预测的回顾性比较与迁移
原图来源:所用 PDF 文件第 4 页,Figure 3。点击图片可查看原图。
图3的人类比较仅20个病例,且来自随机拆分,不足以宣称模型普遍超过医生。微调曲线更有实际价值:小样本波动大,领域预训练和更多标签提高稳定性。院区矩阵则说明本地微调帮助迁移;Manhattan与Brooklyn都在同一医疗系统内,尚不同于跨国家或全新机构验证。足够微调后异地临床预训练差异缩小,提示应比较复用模型与从头训练的成本,而不是只挑一条最高曲线。
| 子图 | 讲解 |
|---|---|
| a | 20 个病例中把模型 ROC/操作点与六名医生比较;所选阈值下模型真阳性率高于医生中位数、假阳性率相近,样本较小。 |
| b | 不同预训练模型随微调样本增加的 AUC,说明领域预训练和足够微调数据有助稳定效果,小样本变异较大。 |
| c | Manhattan 测试中比较不同预训练/微调地点组合,本地微调较外地微调好。 |
| d | Brooklyn 的同类比较也显示本地微调优势,说明院区文本差异影响迁移。 |
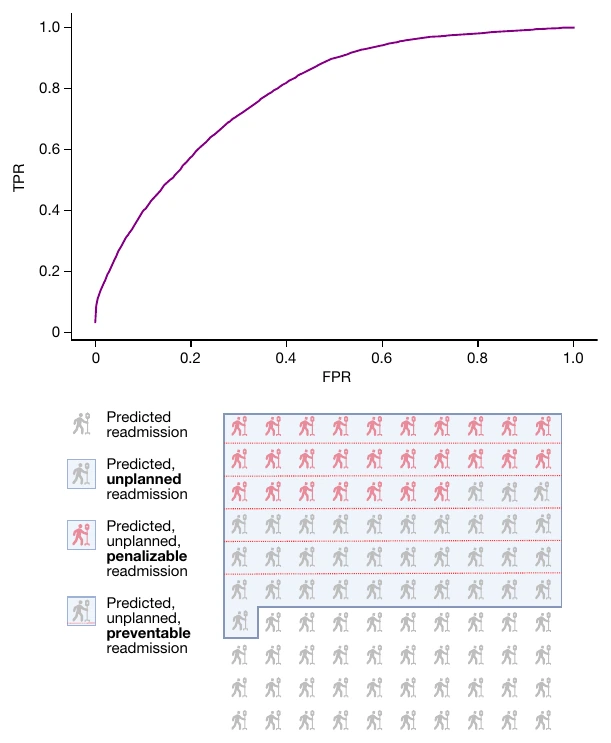
Figure 4|前瞻运行与可干预性评估
原图来源:所用 PDF 文件第 5 页,Figure 4。点击图片可查看原图。
图4把模型置于未来实时数据,AUC约78.7%、召回82.3%与precision20.6%共同说明可识别多数再入院但阳性中误报很多。复核100个正确识别病例得到27%可能可预防,不是27%所有预测阳性已被成功预防。事后临床判断具有价值,却还没有对照干预和实际健康结果。非计划、处罚相关与可预防三种性质也不同;行政收益与患者收益需要分别定义,不能以保险或处罚风险替代医学改善。
| 子图 | 讲解 |
|---|---|
| a | 单组、非干预前瞻研究中 AUC=78.70%,recall=82.3%、precision=20.6%,验证上线时间顺序下的预测表现。 |
| b | 医生复核 100 个被正确识别的再入院:61% 非计划、50% 可能遭处罚、27% 被认为可在出院时预防。它说明潜在行动空间,尚未证明部署减少再入院。 |
依据:对应主图、完整图注及正文 Results;实验结果只按本文给出的对象和条件解释。
我对通用表示的理解
本文说明通用表示的价值在于降低多任务重复开发成本,不是让模型脱离上下文。在AD公共组学中,可以先用大量无标签样本学习表示,再对少量病理标签做明确监督验证;这仍需要区分预训练、标签适应与独立测试。若全程不使用病理标签,则最终疾病联系必须由训练后检验建立。
领域适配同样重要。脑区、细胞类型与技术平台像院区文本一样会改变分布,统一预训练表示不能保证迁移。对16GB显存,复用已有模型或训练紧凑编码器,比重做巨大语料预训练更现实。还应比较简单降维加线性模型,确认表示改善的是病理信息而不是批次识别。
我的主要保留意见是“通用”容易被误读为任务条件不重要。本文五个终点各有标签和可用输入时刻,未来任务也必须重新验证。对于解释,文本中临床判断和模板的贡献需要专门审查,注意力或词归因不能自动拆分病理与文档过程。
我会把前瞻运行视为可信研究的重要阶段,但不给它超出设计的称号。模型在实际流程稳定产生分数是一项工程与预测成果;医生根据分数行动并改善结局,则是下一项临床研究。这样分层也适合blog阅读:既承认论文进展,也让读者清楚下一步还缺什么。
一个可实施的迁移设计,是先固定公共数据及donor划分,对预训练表示分别检验细胞类型、批次和病理预测。若批次很容易被预测而病理外部表现弱,需要重新检查表示而不是继续堆更大模型。论文提醒我们,部署环境的差异不是模型训练之后才考虑的细节,而应从任务定义开始进入评估。
