85.BE-Hive:原图、模型逻辑与研究范式

85.BE-Hive:原图、模型逻辑与研究范式
Perry论文题名: Determinants of Base Editing Outcomes from Target Library Analysis and Machine Learning
期刊与年份: Cell,2020。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
本篇问题: 碱基编辑的效率、副产物和精确纠正结果能否由序列预测并通过工程改进?
问题从实验失败的细节里长出来
我的推测是,作者真正要解决的不是再提高一个编辑效率分数,而是实验人员的选择困境:目标碱基在典型窗口内,却可能产生邻近旁观者编辑;窗口较宽的编辑器反而可能在某些序列更精确;少见的颠换副产物也可能成为所需产物。仅用位置规则无法决定最佳编辑器与sgRNA。论文因此先设计覆盖丰富上下文的整合靶序列文库,再让模型学习结果分布,并利用这些规律改造蛋白。
BE-Hive并不是一个包办所有任务的深度网络。效率模型是梯度提升回归树,输入序列位置、二核苷酸、GC及熔解温度等特征,预测归一化编辑效率;旁观者模型才是深条件自回归网络。它先编码每个可编辑碱基及其左右局部序列,再按顺序预测各位置结果,条件包括前面已生成的编辑状态,用KL散度拟合实际结果分布。不同编辑器与细胞背景对应训练条件,不能假设一个任意新编辑器名称输入后就会可靠泛化。
这个结构适合组合输出:多个底物的状态可以依赖,独立单点概率相乘会漏掉共同编辑或互斥。模型同时把总编辑概率与编辑后条件产物概率分开,两者相乘才得到目标产物在全部读段中的预测比例。后者通常更稳定,前者还受递送、表达和实验批次影响。研究范式是高通量扰动数据驱动的监督概率建模,再以设计实验和蛋白工程闭环验证。疾病位点为应用对象,不是模型学习疾病致病机制的标签。
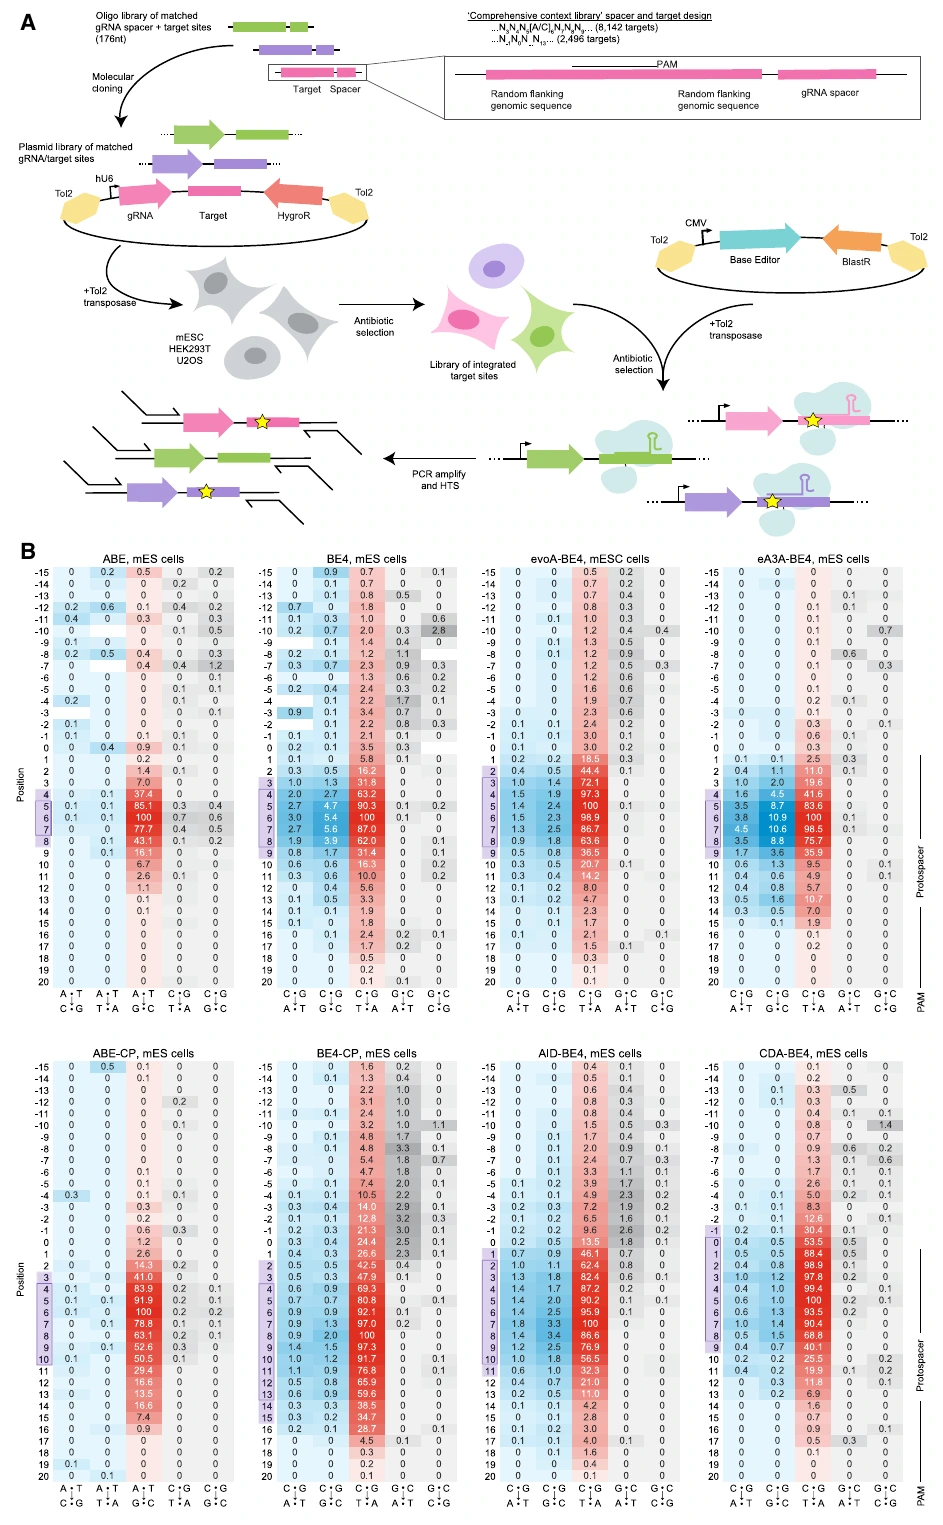
Figure 1:大规模碱基编辑靶位点实验
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
A先把sgRNA与对应靶序列配对整合,测序直接观察多种真实产物;这是预测模型可以成立的数据基础。整合文库控制了序列组合并扩大覆盖,不能完整保留每个原位基因组的染色质背景。B比较多种编辑器的位置谱,典型与非典型突变分开,显示“窗口”并不是硬开关。热图按每种活动的最大值归一化,颜色很深不一定表示该副产物在全部读段里占比很高。因而需要结合绝对效率和相同读数分母理解。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | 把成千上万sgRNA—靶序列整合到细胞,编辑、选择并测序,定义高通量训练数据。 |
| B | 不同编辑器沿protospacer的典型与非典型突变活性热图,展示编辑窗口及副产物的位置依赖。 |
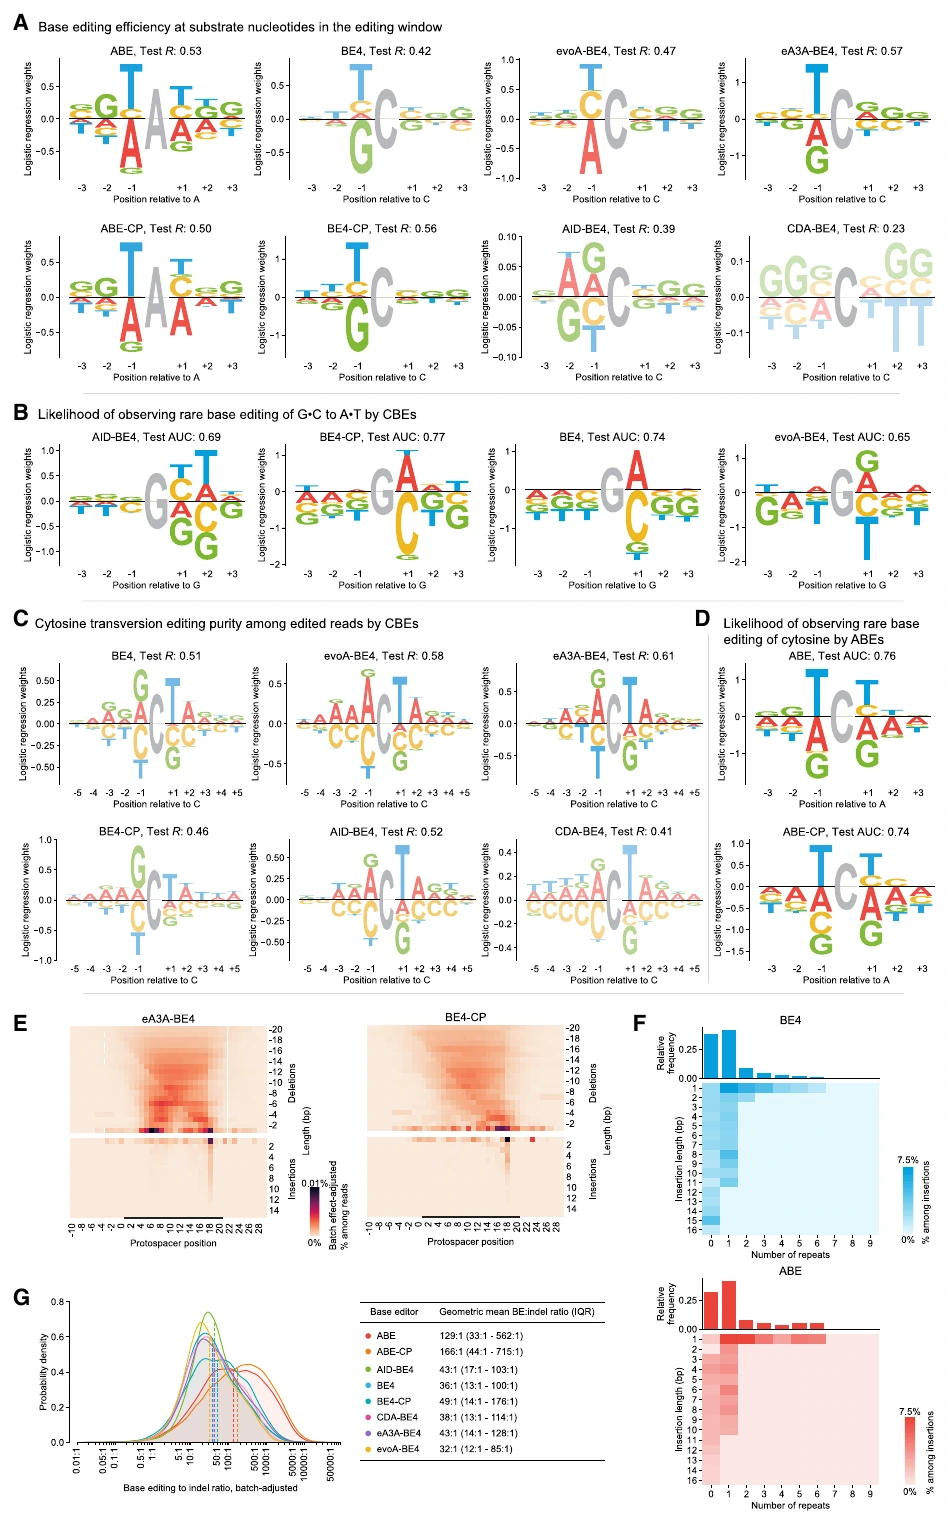
Figure 2:编辑结果的序列偏好与插缺
原图来源:所用 PDF 文件第 5 页,Figure 2。点击图片可查看原图。
A至D用简单回归权重表示局部序列偏好,适合解释上下文促进或抑制编辑,但逐位独立logo并不是最终自回归模型的全部规则。E、F讨论插缺位置、长度与重复来源,为副产物生成路径提供线索;G再比较编辑与插缺比。作者专门用未处理文库排查合成与PCR产生的一碱基错误,并对背景与批次作校正。若没有这些对照,罕见副产物很容易被技术噪声制造出来。高编辑/插缺比也不等于其他旁观者替换或脱靶都安全,这个指标的范围必须限定。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | 典型C→T或A→G效率的序列logo,正负权重表示促进或降低编辑。 |
| B | CBE引起G·C→A·T转换的序列偏好,检查不同底物环境。 |
| C | CBE胞嘧啶颠换的序列偏好,定位非典型产物的上下文。 |
| D | ABE意外胞嘧啶编辑的序列偏好,描述跨底物副作用。 |
| E | 插缺频率按位置和长度的热图,检查副产物的空间分布。 |
| F | 插入长度与重复次数热图,分析插入形成模式。 |
| G | 碱基编辑与插缺比率分布,比较编辑器的产物纯度。 |
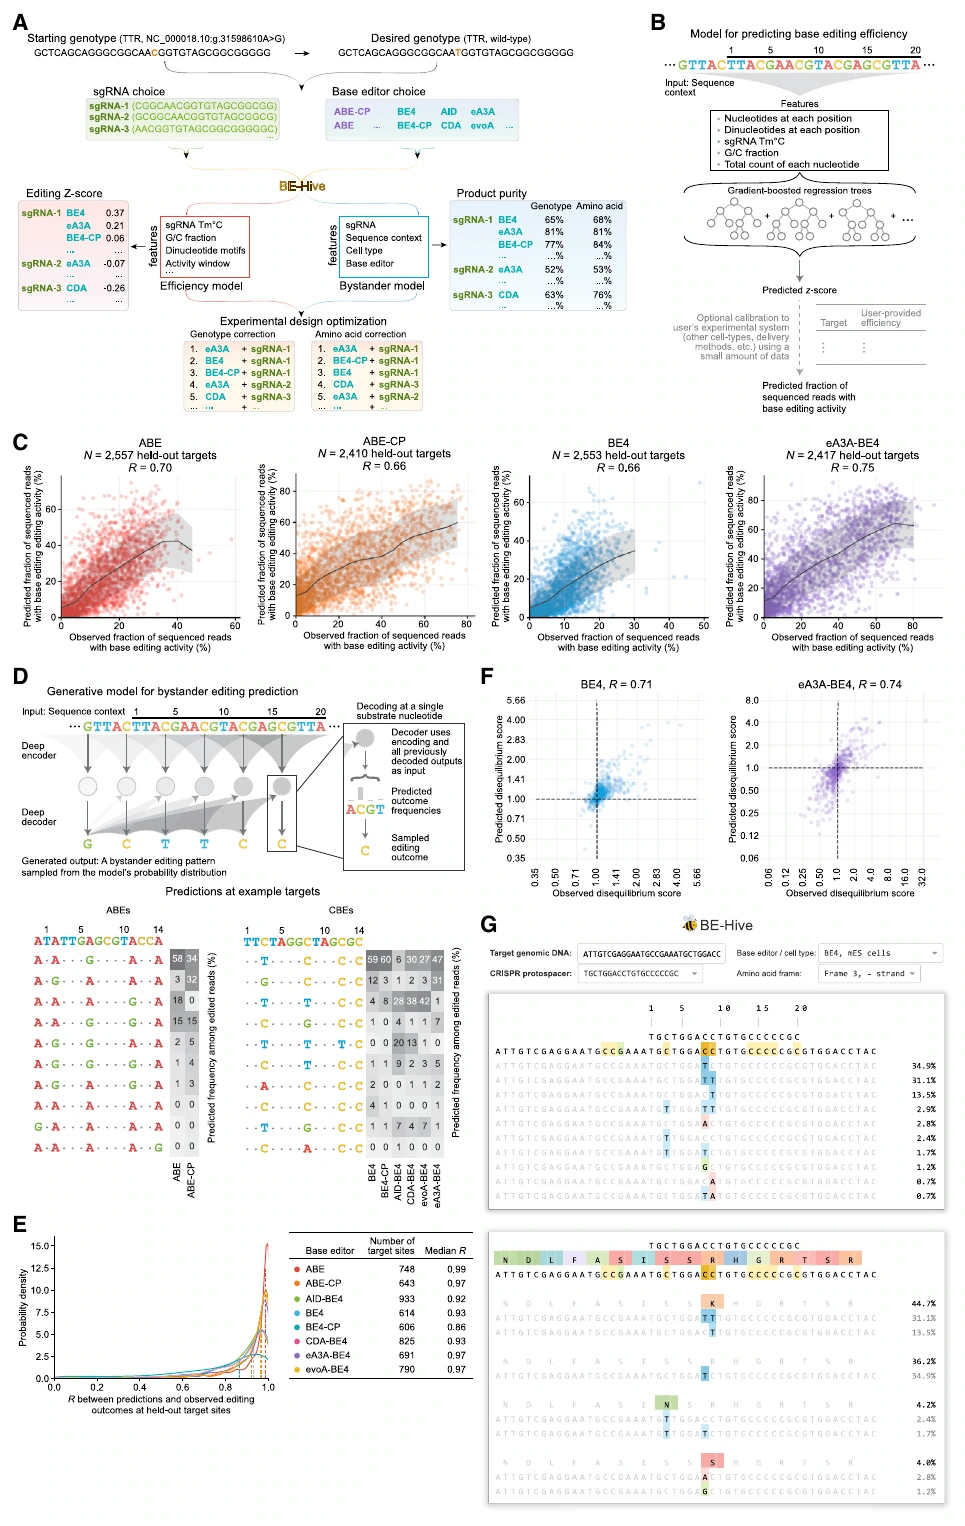
Figure 3:BE-Hive效率与旁观者编辑模型
原图来源:所用 PDF 文件第 7 页,Figure 3。点击图片可查看原图。
A把预测变成具体实验选择,B、C展示效率树模型的任务与泛化,D、E再展示条件产物分布的深度模型。两种相关系数服务不同问题,不应合称同一个“90%准确率”。F比较成对底物共同或分别编辑的失衡程度,检验自回归是否真正捕获联合依赖,而不只把每个碱基概率排对。失衡还受局部序列偏好影响,不能直接视为纯粹酶过程性测量。G展示DNA与氨基酸层面的结果,因为不同DNA组合有时翻译成同样蛋白序列;这为选择任务提供更贴近用途的终点。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | 实验设计决策树,把编辑器及目标选择连接到所需结果。 |
| B | 预测编辑效率Z分数的模型结构,定义效率任务。 |
| C | 未见靶点的预测对实测效率,检验泛化。 |
| D | 条件自回归模型依据序列、向导、编辑器与细胞类型预测每一种旁观者编辑结果频率。 |
| E | 未见靶点旁观者结果频率的预测表现,验证不止能预测总体效率。 |
| F | 两底物一起或分别编辑的失衡评分预测对实测,检验模型学到联合编辑依赖。 |
| G | BE-Hive网页DNA与氨基酸编辑结果展示,说明如何用预测支持实验选择。 |
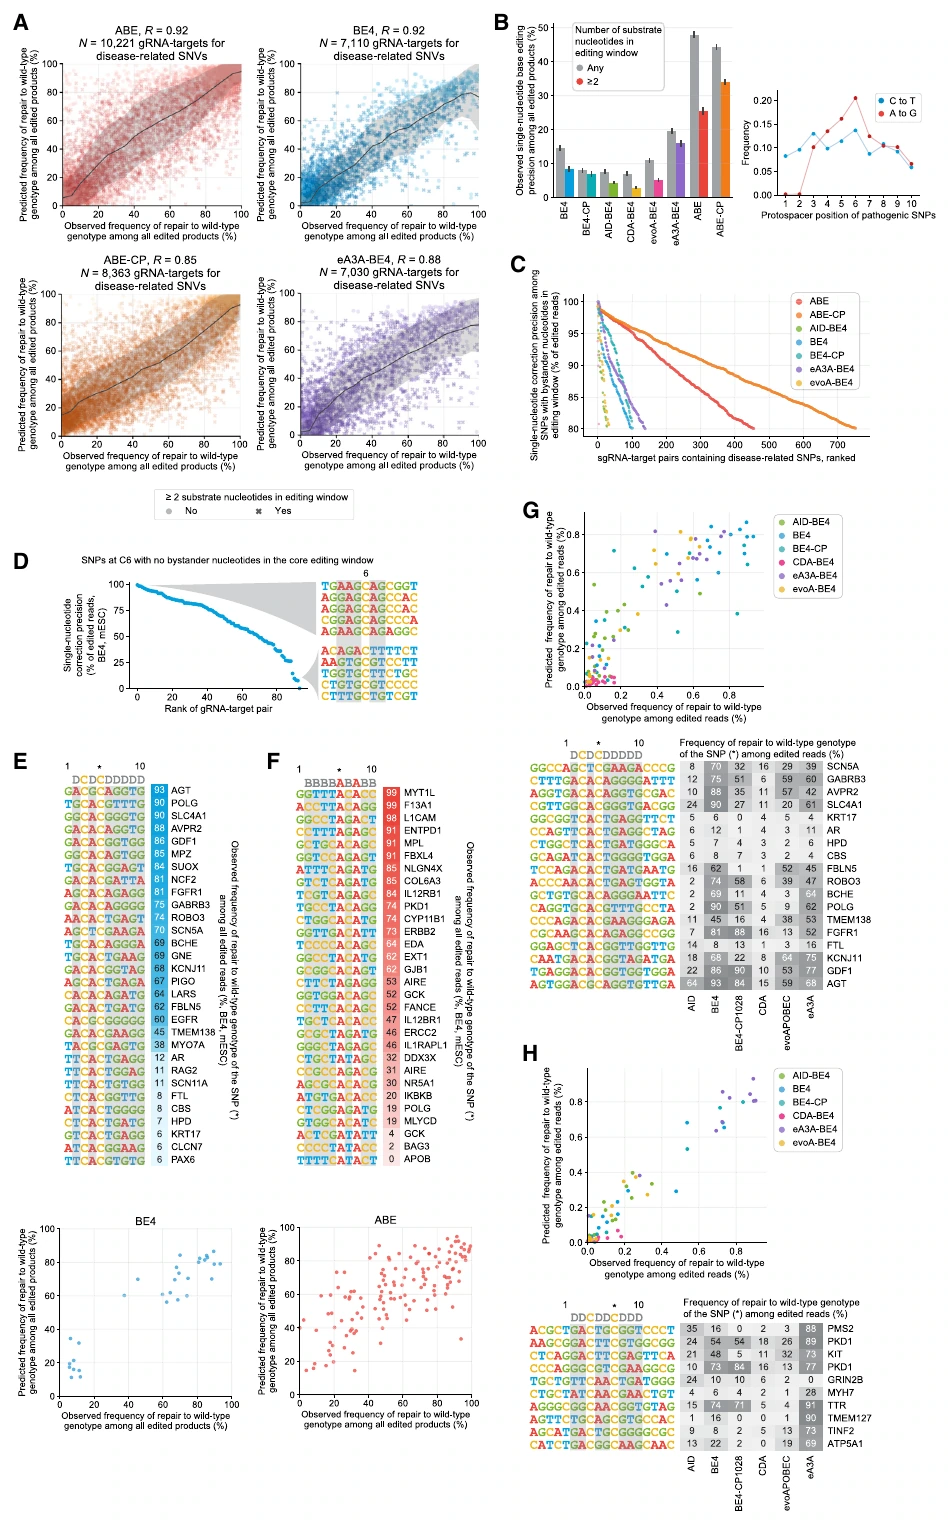
Figure 4:致病等位基因的精确纠正
原图来源:所用 PDF 文件第 9 页,Figure 4。点击图片可查看原图。
A将模型预测与新疾病位点文库实测精确度比较;B、C关注旁观者底物多时还能否精确纠正,D提供窗口内单一底物的参照。E、F固定部分底物位置与数量仍见结果差异,说明上下文信息提供了位置规则之外的贡献。G、H中最佳编辑器随目标位置和序列改变,支持逐位点优化,而非统一使用窗口最窄的工具。
关键分母是“已编辑读段”,不是所有细胞或所有DNA。文库中将致病等位恢复为参考序列也并未测得患者表型恢复。论文选择的疾病SNV注释来自当时数据库版本,在本篇应作为原始应用集合描述;不能把全部历史注释当成当前无争议临床结论。模型纠正序列的能力和疾病机制判断仍是两项工作。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | 疾病SNV的预测对实测纠正精确度,验证模型选择能力。 |
| B | 不同编辑器对多底物及全部疾病位点的纠正频率,分析窗口位置及可用范围。 |
| C | 包含旁观者底物的疾病位点纠正频率,检验邻近可编辑碱基带来的挑战。 |
| D | BE4在C6且无其他旁观者底物的位点结果,给出简单条件参照。 |
| E | BE4纠正疾病SNV的结果及预测/真实精确度,检验CBE应用。 |
| F | ABE对应疾病SNV纠正及精确度,检验另一编辑类别。 |
| G | 第5位疾病底物不同编辑器的纠正,观察位点偏好。 |
| H | 第7位的对应比较,说明最佳编辑器依赖底物位置与上下文。 |
Figure 5:用胞嘧啶颠换纠正变异
原图来源:所用 PDF 文件第 12 页,Figure 5。点击图片可查看原图。
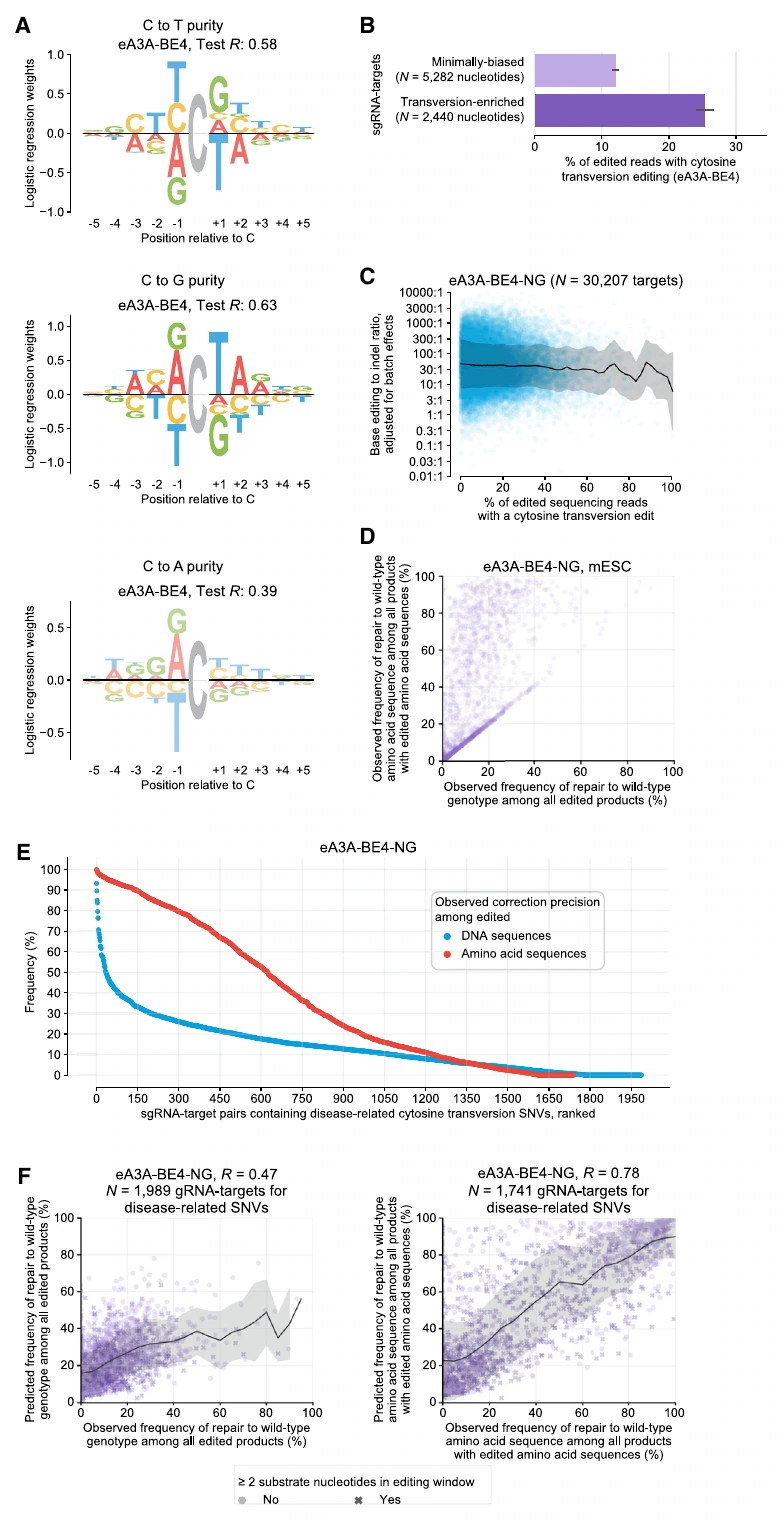
A提出不同C到A、G、T产物的上下文偏好,B用模型挑选富集颠换位点再实验,是从相关规律走向预测设计的验证。C检验颠换提高是否同时增加插缺,两者未表现明显关系,为产物分配而非简单提高损伤量的解释提供支持,但还不直接解析全部修复通路。D、E刻意区分DNA精确度与氨基酸精确度,F分别验证两种预测。蛋白精确度较高可能来自同义副产物归并;同义改变仍可能影响剪接或调控,不能因此一概称无害。此处高精确度属于特定选中靶点集合,不能代表任意颠换位点。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | C分别编辑到A、G、T的纯度序列logo,识别产物类型偏好。 |
| B | 普通靶点与BE-Hive挑选高颠换靶点的纯度比较,检验模型设计的实验收益。 |
| C | 碱基编辑/插缺比对颠换纯度,检查提高颠换是否伴随更多插缺。 |
| D | DNA基因型精确度对氨基酸精确度,说明不同DNA副产物有时仍产生相同蛋白结果。 |
| E | 疾病颠换SNV的DNA和氨基酸纠正精确度,评估可用纠正范围。 |
| F | 颠换纠正预测对实测,分别以DNA及蛋白结果验证模型。 |
Figure 6:改造脱氨酶提高颠换纯度
原图来源:所用 PDF 文件第 14 页,Figure 6。点击图片可查看原图。
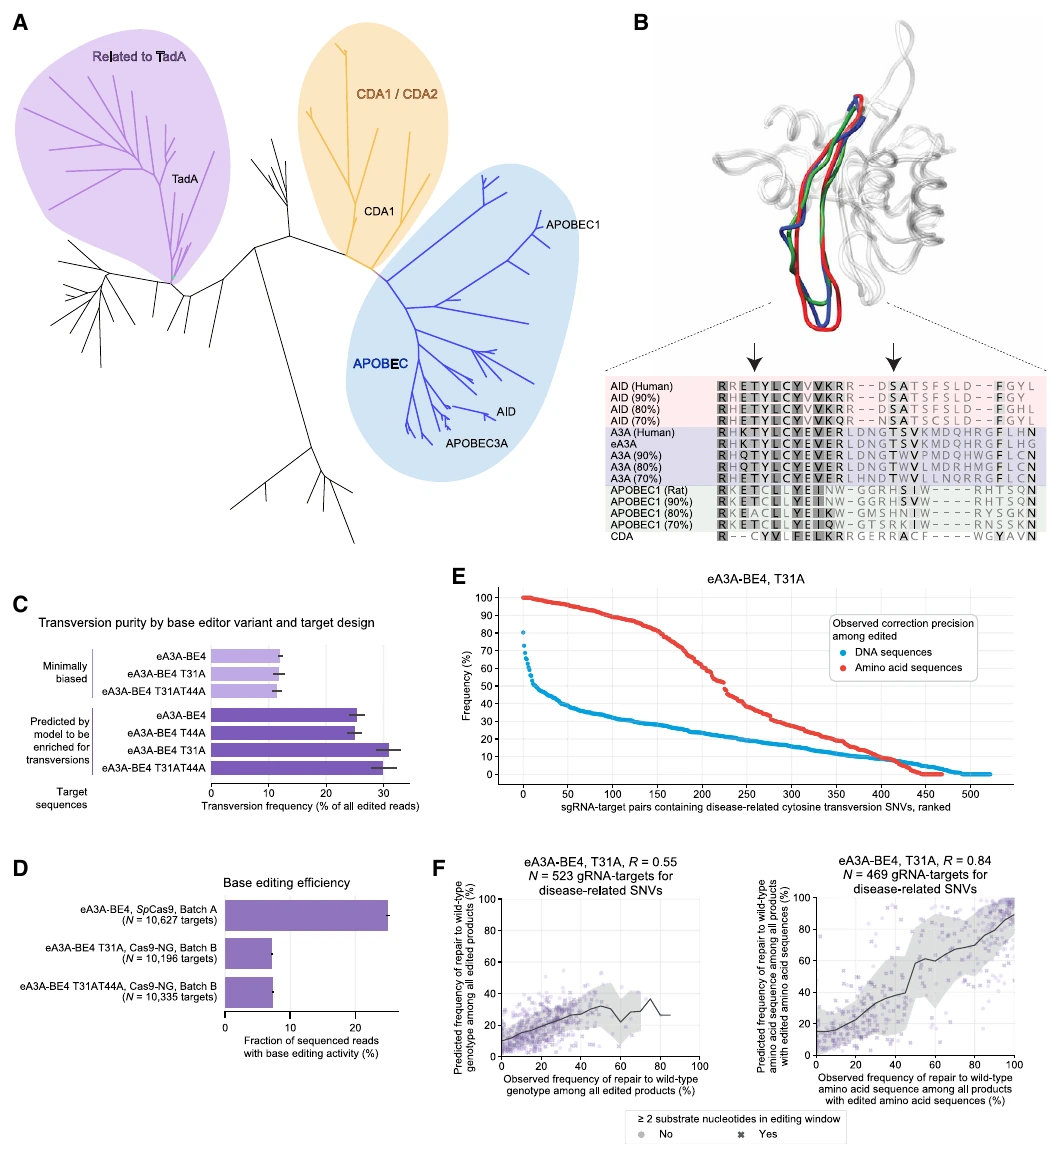
A、B利用酶家族保守位点与结构比对提出工程候选;C看产物纯度,D同时看总体效率,体现工程需要多终点比较。eA3A相关T31A变体提高部分目标的颠换纯度,却带来平均效率下降,若只看C会漏掉实际产量代价。E、F将工程产物放回疾病位点并比较预测与实测,闭合了“规则、改造、应用”链条。保守位点的功能推断因此有真实突变实验支持,但关于磷酸化及修复蛋白如何传递影响的完整机制,仍不能仅凭同源位置和产物变化全部确定。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | 腺嘌呤/胞嘧啶脱氨酶家族树,为结构改造选择保守位点。 |
| B | AID、A3A、APOBEC1结构比对标出同源T27/S38,定义突变位置。 |
| C | eA3A-BE4及位点突变版本的颠换纯度,检验工程改造。 |
| D | 同一编辑器集合的总体效率,检查纯度改变是否损失活性。 |
| E | 改造编辑器纠正疾病颠换SNV的DNA/氨基酸精确度,验证应用效果。 |
| F | 对应预测对实测纠正精确度,检验工程编辑器的结果可预测性。 |
Figure 7:减少非期望颠换与编辑窗口权衡
原图来源:所用 PDF 文件第 15 页,Figure 7。点击图片可查看原图。
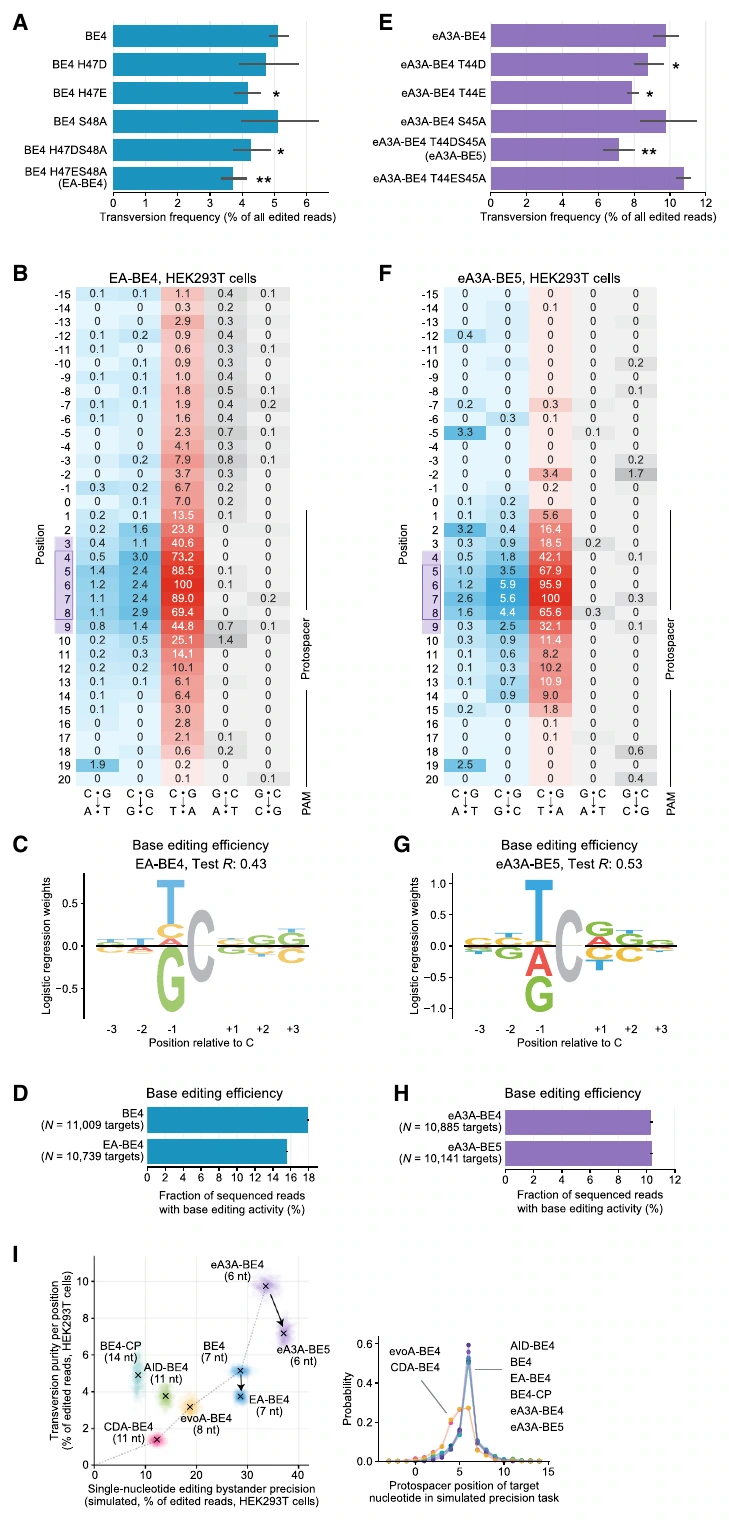
A至D改进BE4,E至H改进eA3A,分别检查颠换、位置谱、上下文偏好和效率,防止一个指标改善靠牺牲其他指标获得。I以Pareto前沿呈现编辑窗口与产物纯度的权衡:宽窗口可能提高可编辑范围,却增加旁观者;窄窗口不能保证所有位点最精确。图中的单碱基精确度含模拟任务结果,并非每一个候选都已经有相同体内干预。我的理解是,工程优劣必须与目标位点和所需产物一起评估;“最佳编辑器”本来就不是一个脱离任务的固定名称。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | BE4保守位点突变后的颠换频率,检验EA-BE4降低副产物。 |
| B | EA-BE4与BE4在HEK293T的活性位置谱,检查编辑窗口。 |
| C | EA-BE4效率序列偏好,说明改造后的上下文依赖。 |
| D | EA-BE4与BE4总体效率比较,检查减少副产物的活性代价。 |
| E | eA3A-BE5对eA3A-BE4颠换频率,检验另一改造方案。 |
| F | 两者HEK293T活性位置谱,比较窗口和副产物位置。 |
| G | eA3A-BE5效率的序列偏好,描述编辑规律。 |
| H | eA3A-BE5对eA3A-BE4效率,检查改造保持活性情况。 |
| I | 颠换纯度、窗口大小与模拟单碱基精确度的Pareto前沿,说明不存在对所有目标都最佳的编辑器。 |
可迁移的是任务分解与实验闭环
这篇对AD研究最直接的用途在验证阶段:候选变异需要做内源编辑时,先用工具比较sgRNA和旁观者结果,减少“名义上改了一个位点,实际上改了一组位点”的解释困难。它不能从编辑容易与否推断一个变异是否导致AD。TE重复背景还可能带来向导多位点匹配,本文的局部产物模型并不负责完整基因组脱靶评估。
纯计算研究也可以借用任务分解:分别建模一个TE副本是否处于可及状态,以及条件于可及时的调控模式,再检查是否比直接预测疾病标签更可解释。但这种分解需数据支持其稳定性,不能只因论文采用就默认成立。另一个具体启发是,在生成模型里报告概率覆盖:BE-Hive只探索最可能的产物组合,并把未覆盖概率保守视为不利结果。对我们的候选排序,同样应记录不确定和未支持的部分,而不是把缺失证据自动当无风险。
这套旁观者网络并不巨大,文中还指出可变形状批次使GPU相对CPU提速有限。它提醒我,可行创新常来自准确的目标定义、控制数据噪声和可验证的输出结构;无需先拥有能容纳超大模型的显卡。
