54.CalibratedPerturbationMetrics:原图、模型逻辑与研究范式

54.CalibratedPerturbationMetrics:原图、模型逻辑与研究范式
Perry论文题名: Deep learning perturbation models can outperform baselines on calibrated metrics
期刊与年份: Nature Biotechnology,2026。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: 扰动预测看似不如平均基线,是否部分因为常见指标无法敏感识别扰动特异信号?
为什么与上一篇结论看似相反
上一类评估要求模型胜过简单基线,这篇先问评价尺度能否识别已知的扰动信息。多数基因变化很弱时,总表达误差会由大量不变基因支配;对照与所有扰动细胞的共同差异也可能让没有条件特异性的均值预测获得高相关。我的推测是,构思来自实验科学的正负对照逻辑:既然真实重复测量也有噪声,先构建一个知道扰动身份的正对照,再检查指标能否将它与不含特异信息的负对照区分。
校准还改变了怎样解释负结果。若正对照本身不领先,当前指标的阴性结果不足以区分模型没有生物信号和测量无法显示信号;若正对照清楚领先而模型仍接近负对照,模型失败的解释就更有力。两种情形需要不同下一步:前者改任务尺度,后者改输入、训练或数据覆盖。正对照因此不是替模型找借口,而是增强结论的可否定性。
同时,校准正对照不能被解释为噪声上限的唯一估计。随机拆分同一扰动的细胞没有覆盖不同实验日、批次或供者的系统差异,插值也借用了显著性信息。真实部署到新资料时,性能可能低于这个参照。因此我会另做跨批次或独立重复的校准,分别报告同资料可测信号和跨资料可迁移信号,避免把技术半分的良好结果称为外部验证。
校准框架的输入与目标
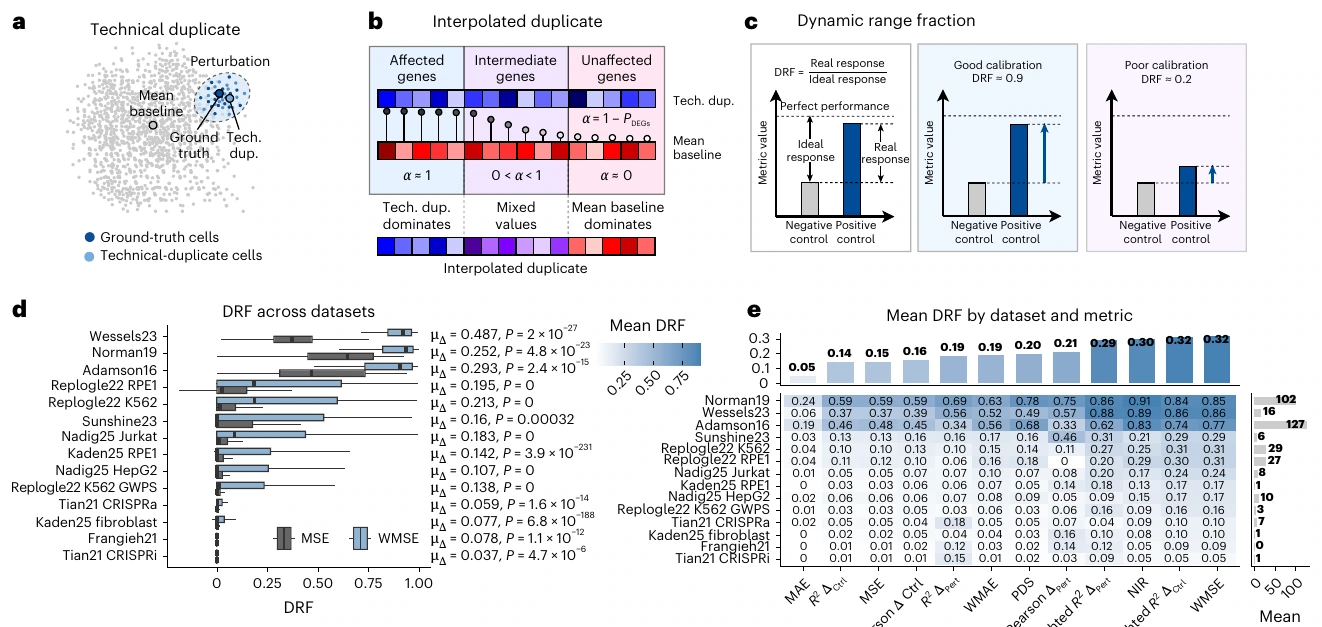
输入是实际扰动后的单细胞表达。每个扰动的细胞被分为两半,一半预测另一半,形成技术重复;再按照基因差异表达的调整后P值设置权重,将技术重复与训练扰动的平均基线插值。变化强的基因更多依赖技术重复,变化弱的基因借助平均值减少估计噪声。这是评估的正对照,拥有目标扰动的测量信息,不能当成可以预测未知干预的部署模型。
DRF衡量正负对照实际分数差占负对照到完美预测理论差的比例。它评价的是指标灵敏度,而不是模型临床可信度。一个指标的DRF接近零,表示它难以区分此数据中已知特异信号;DRF较高也不保证任何模型都好。作者在14个资料、18类指标上检验,并将加权误差、参考差值和检索指标并置,避免只凭单个指标确定胜负。
模型范式与实验条件
随后比较的模型包含预训练嵌入加MLP、图或注意力方法、变分自编码器及flow matching等。它们用扰动条件和响应训练,属于监督的条件预测;基础嵌入是否自监督得到,与下游是否无监督是不同问题。本文主要创新在评价校准与基准分析,而非把一种新神经网络宣布为通用虚拟细胞。
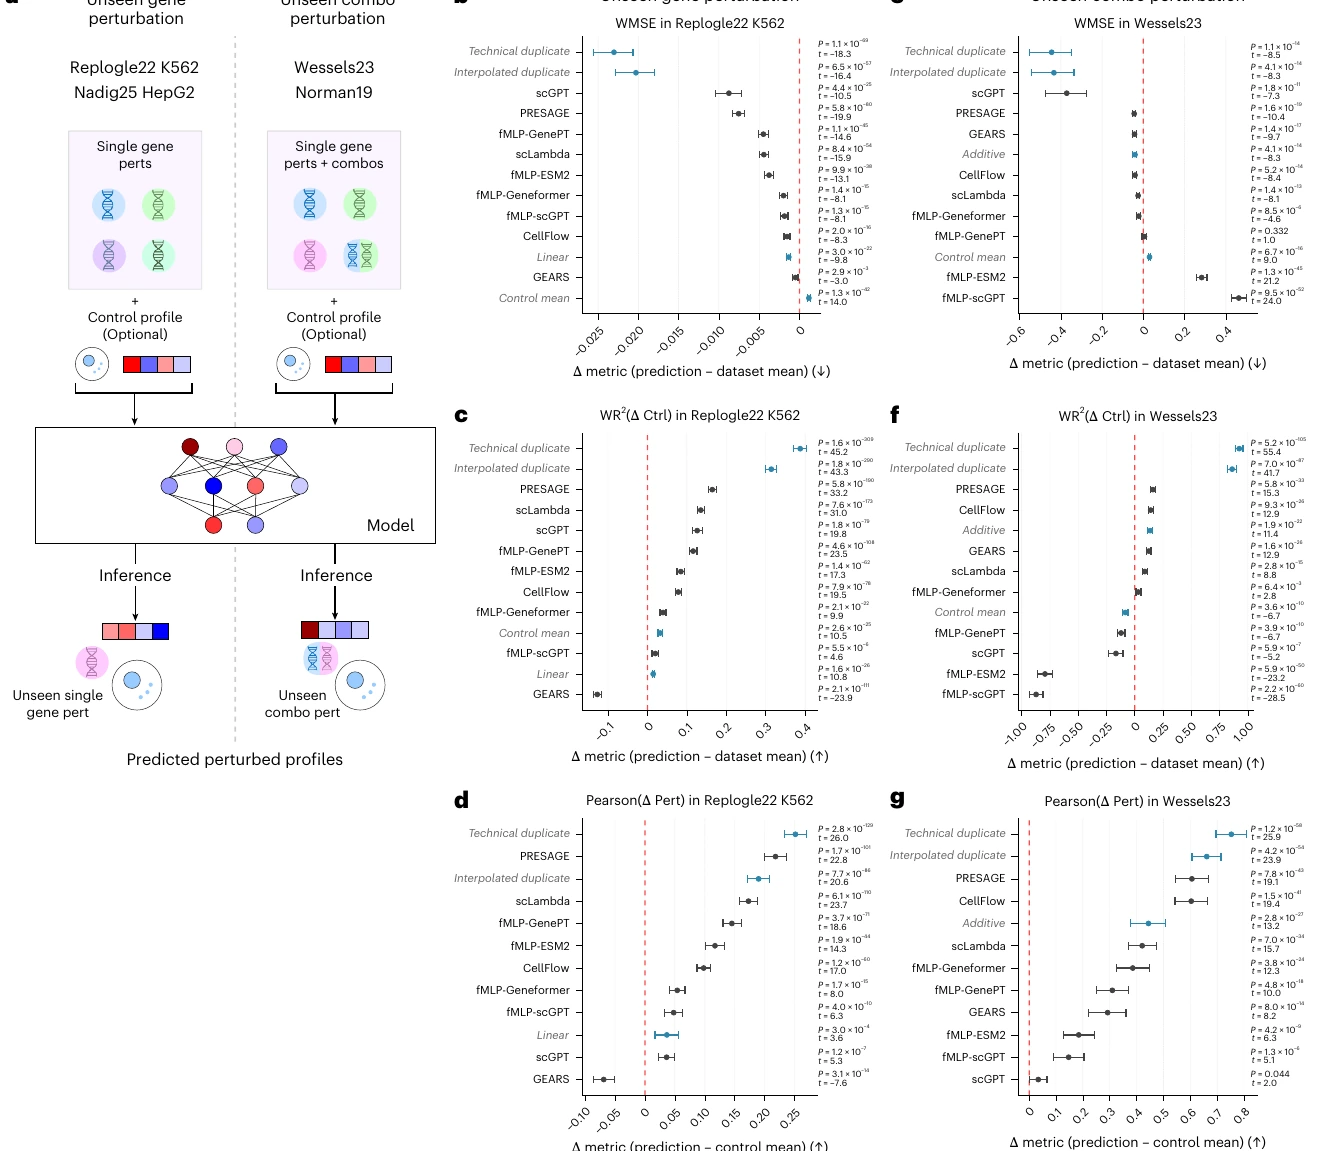
未见单扰动与未见组合仍需分开。组合测试中训练包含单扰动及部分组合,模型可能从已测组合学习非加性结构。Norman数据的近似加性和组合覆盖不足使加法基线很难超过;Wessels有更高组合覆盖,给学习互作提供更多机会。因此与第53篇的关系应同时考虑指标、训练划分、模型更新和数据覆盖,不能简化成一方推翻另一方。源PDF的上线日期仍有排版占位,这里按文件正文及所列2026年版本解释,不据此补造具体发表日。
评价目标必须先明确,模型排序才有实际含义。
为什么均值可能比重复更准
弱扰动的单条件细胞较少,其均值的抽样误差较大;汇总许多扰动的均值则更稳定。若绝大多数基因都没变化,整体误差倾向奖励这个稳定背景,真正受影响的少数基因贡献被稀释。加权指标有目的地提高这些基因的影响,使评价更接近“是否识别干预响应”,但也改变了任务偏好。研究者必须说明希望预测总表达、差异方向、通路还是相似扰动排序,而非看到有利结果才选指标。
Figure 1|用正负对照检验评价指标
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
a给出技术重复,b用显著性插值减少未变化基因上的噪声,c定义正负对照与理论理想值之间的动态范围。d在14个资料中比较MSE与WMSE的DRF,e同时显示指标家族和每个资料的扰动强度。动机是先证明尺子能够测到真实变化,再用它评模型;否则模型分数都相近可能来自尺子钝,而非所有模型都没有信号。
读e时应把强弱扰动视为任务条件,不能因为一个资料的平均DEG多就判断其技术更先进。正对照利用目标测量只服务于校准,不参加未知扰动泛化竞赛;评估权重也不能成为模型在训练时偷看测试响应的通道。本文给出的校准结果支持加权及部分排序指标有更好的信号灵敏度,但没有证明它们覆盖了所有生物学需求。
| 子图 | 讲解 |
|---|---|
| a | 把同一扰动细胞分两半,一半预测另一半,形成含正确扰动信号的技术重复正对照。 |
| b | 以差异表达显著性加权技术重复与平均基线:强响应基因靠重复,弱响应基因靠平均,减少有限细胞数噪声。 |
| c | DRF 是正负对照实测差距占负对照到完美预测差距的比例;接近零说明指标看不清已知正信号。 |
| d | 14 数据集 WMSE 与 MSE 的 DRF 箱线图;加权 MSE 更强调真正受扰动基因,改善信号被大量不变基因稀释的问题。 |
| e | 跨指标和数据集的 DRF 热图及 DEG 数,说明指标校准依赖扰动强度;加权/排名类指标更能保留特异响应。 |
Figure 2|校准后再比较预测模型
原图来源:所用 PDF 文件第 4 页,Figure 2。点击图片可查看原图。
a定义两种留出任务,b–d在未见单扰动上用加权误差、加权差值解释度及相对扰动均值的相关等互补尺度检查。e–g转向Wessels组合,多个模型能超过加法基线,说明有足够组合训练覆盖时,学习非加性可以取得实际收益。这里不是所有模型在所有指标上都获胜;部分模型在一个尺度强、另一个尺度仍接近均值,必须保留这种不一致。
与Norman近加性的情形并读,就能看见数据设计的作用。若加法已接近可测的理想性能,复杂模型剩余改善空间很小,未超过并不必然说明表达能力不足。反之在可测互作更多、覆盖更充分的资料中超过加法,才更接近非线性贡献的证据。即使如此,这些仍是细胞系的转录响应评估,不能从模型排名直接推出人类AD治疗靶点有效。
| 子图 | 讲解 |
|---|---|
| a | 区分未见单扰动与未见组合两任务:后者训练见过全部单扰动,测试留出组合。 |
| b | Replogle K562 的 WMSE 相对 mean 性能差,部分深度模型在该加权指标下优于弱基线。 |
| c | 同数据的加权 R²Δctrl,较高越好,检查改善是否跨指标成立。 |
| d | 以扰动平均背景为参照的 Pearson(Δpert),减少对照偏差,评价真正扰动特异变化。 |
| e | Wessels 留出组合的 WMSE 对照,观察组合任务的模型优势。 |
| f | 同组合任务的加权 R²Δctrl,提供第二种度量。 |
| g | 同组合任务的 Pearson(Δpert),与 e、f 共同表明某些旧/新模型的信号可在校准指标下检出;并非所有模型在所有数据集胜出。 |
阅读说明
- 这是对评价指标的校准讨论,与第 53 篇的指标及设置不同。源 PDF 的首页仍有‘Published online: xx xx xxxx’排版占位;讲解以该文件所载正文结果为准。
依据:对应主图、完整图注及正文 Results;实验结果只按本文给出的对象和条件解释。
我从这篇得到的实施启发
我会把第53、54篇合在一起形成评价流程:先有强基线,再有正负对照校准,还要有与最终生物问题相同的留出方式。对AD的转座子或染色质状态研究,整体重建误差很低可能只是重建了大量静默峰。可以另外检查真实可重复的病理相关模块是否被恢复,以及检索出的相似状态是否对应独立供者;不能只把某一加权损失降低当成发现机制。
建议提前固定几个互补终点,例如整体误差、条件差值、模块或通路恢复及样本邻域。技术重复可以用来估计测量上限,但不能代替跨供者验证。若模型只在一个指标改善,应说明它优化了哪个具体用途,并报告其他代价。对有限硬件,这比增加参数更值得优先投入:合适的尺度可能发现已有小模型的真实信息,也可能证明漂亮分数只是背景预测。后续机制推断仍要依赖外部证据,校准本身不产生因果。
