77.DeepMEL2:原图、模型逻辑与研究范式

77.DeepMEL2:原图、模型逻辑与研究范式
Perry论文题名: Interpretation of allele-specific chromatin accessibility using cell state-aware deep learning
期刊与年份: Genome Research,2021。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
本篇问题: 状态感知序列模型能否解释个人黑色素瘤基因组的等位特异开放度?
从等位偏倚走向机制解释
等位特异 ATAC 有一个吸引人的优势:同一细胞里的两个单倍型共享大体相同的反式环境,因此比跨人的简单开放度比较更靠近顺式调控问题。但它仍只告诉我们哪个单倍型更开放,未必指出哪个变异导致差异。DeepMEL2 将分相 WGS、个人基因组比对、等位计数与状态匹配的序列模型连起来,试图补上机制这一环。下面关于 idea 的形成是我的推测:作者先看到通用模型擅长常见 AP-1 程序,却漏掉黑色素细胞特有代码,因此扩大相关样本并强化主题输出,而不是只继续扩大通用训练集。
网络输入 500 bp DNA,输出 47 个共开放主题;CNN 与双向 LSTM 分别提取局部模体和组合关系。300 个卷积核中 283 个以 JASPAR 模体初始化,再训练,既不是纯粹无先验发现,也不是固定 PWM 扫描。主题来自无监督 cisTopic,但网络本身是主题标签的监督分类。比较两个等位序列的输出差,再结合真实偏倚与独立 ChIP、报告实验解释功能。它是一条细胞状态匹配的功能证据链,而非直接预测黑色素瘤诊断、患者生存或变异致病概率。
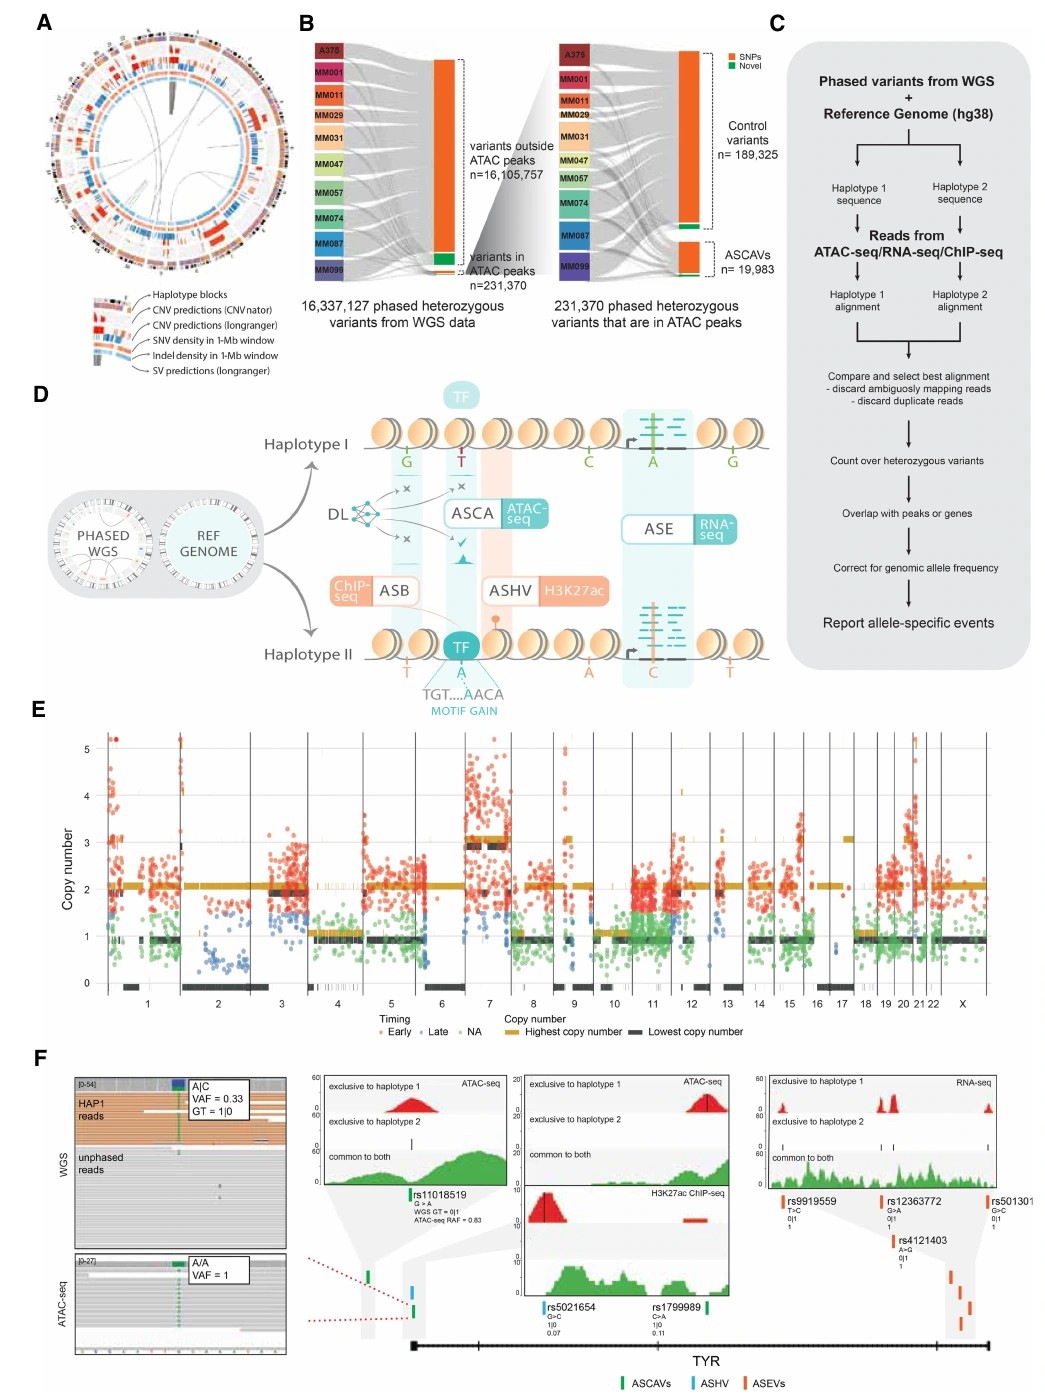
Figure 1:等位特异染色质开放度的识别
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
A–D 的核心不是最后得到多少 ASCAV,而是先把测量偏倚处理正确。个人二倍体参考减少参考等位更容易比对的问题,WGS 等位比例又校正肿瘤拷贝数造成的读数不平衡。若默认每个等位各占一半,许多拷贝数差异会伪装成开放偏倚。E 据突变拷贝数讨论相对复制事件的早晚,是在特定拷贝数背景下的时间推断,不是从模型直接测得癌症发生日期。
F 的 ATAC、H3K27ac 和 RNA 偏向同一单倍型,使 TYR 附近差异更像功能性顺式事件。不过同一个单倍型上可能有多个连锁变异,一个 ASCAV 既可能是原因,也可能只是标记。本文用不在 gnomAD 中作为“可能体细胞”的线索,作者也承认其中可能混入罕见生殖系变异与培养产生的变异,不能逐个写成已证实肿瘤突变。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | MM074基因组Circos概览,展示变异与等位事件的全局背景。 |
| B | 筛选流程中的变异数量Sankey,说明ASCAV识别的过滤步骤。 |
| C | 分相基因组联合功能组学识别等位偏倚的分析流程。 |
| D | 10个黑色素瘤个体化二倍体基因组及ATAC、RNA、ChIP整合,定义开放、表达、乙酰化和结合偏倚及模型解释。 |
| E | MM074等位拷贝数对ASCAV突变拷贝数,推测变异发生时间并避免拷贝数背景混淆。 |
| F | TYR附近同一单倍型偏向的ATAC、H3K27ac与RNA实例,展示跨模态一致的等位特异调控。 |
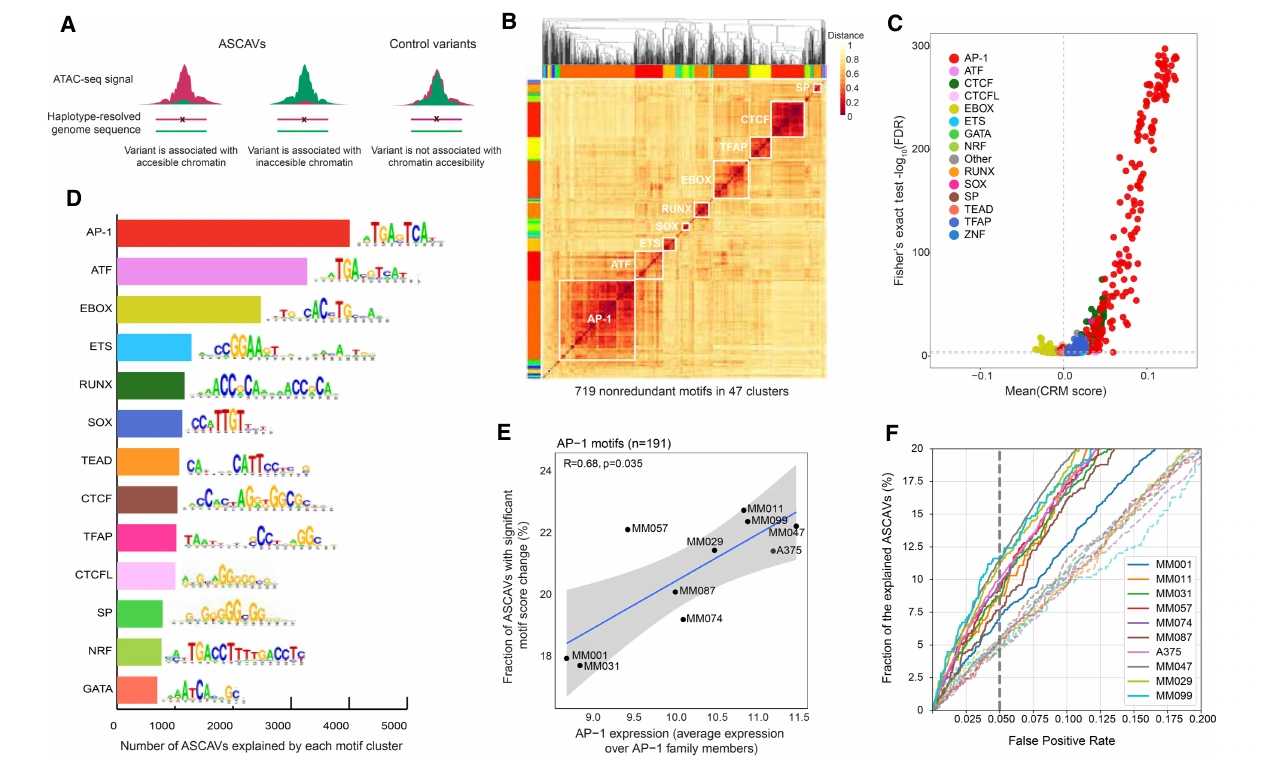
Figure 2:开放度偏倚相关的TF模体
原图来源:所用 PDF 文件第 5 页,Figure 2。点击图片可查看原图。
A–D 将等位模型差值与无显著偏倚的控制变异比较,寻找统计富集的模体变化。47 家族不是 719 种不同独立机制,多个 PWM 描述相近结合偏好,合并能防止重复计数。AP-1 突出支持它在这些样本开放度变化中的作用,但一次模体得分变化不能指定 JUN、FOS 哪个成员真正结合。E 的家族表达与可解释变异比例相关,说明同一序列变异的功能可见性依赖状态;样本数少,这个相关不能证明表达升高导致更多突变。
F 在固定误报率下报告能覆盖的 ASCAV,便于和模型比较。“控制变异没有显著偏倚”也可能只是覆盖不足,而非真正零效应;因此这里的敏感度、误报率都是对该操作性标签而言,不是全人群临床诊断性能。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | ASCAV及对照变异的选择流程,定义模体关联比较。 |
| B | 719个富集模体聚为47家族的热图,归纳等位偏倚相关序列代码。 |
| C | 模体分数等位差异对显著性散点,识别改变开放度的候选家族。 |
| D | 各模体家族能解释的ASCAV数量,比较其覆盖度。 |
| E | AP-1成员表达对AP-1位点ASCAV比例,检验细胞状态与调控变异可见性的关系。 |
| F | 不同误报率下能解释的ASCAV比例与打乱对照,检查模体分析的判别能力。 |
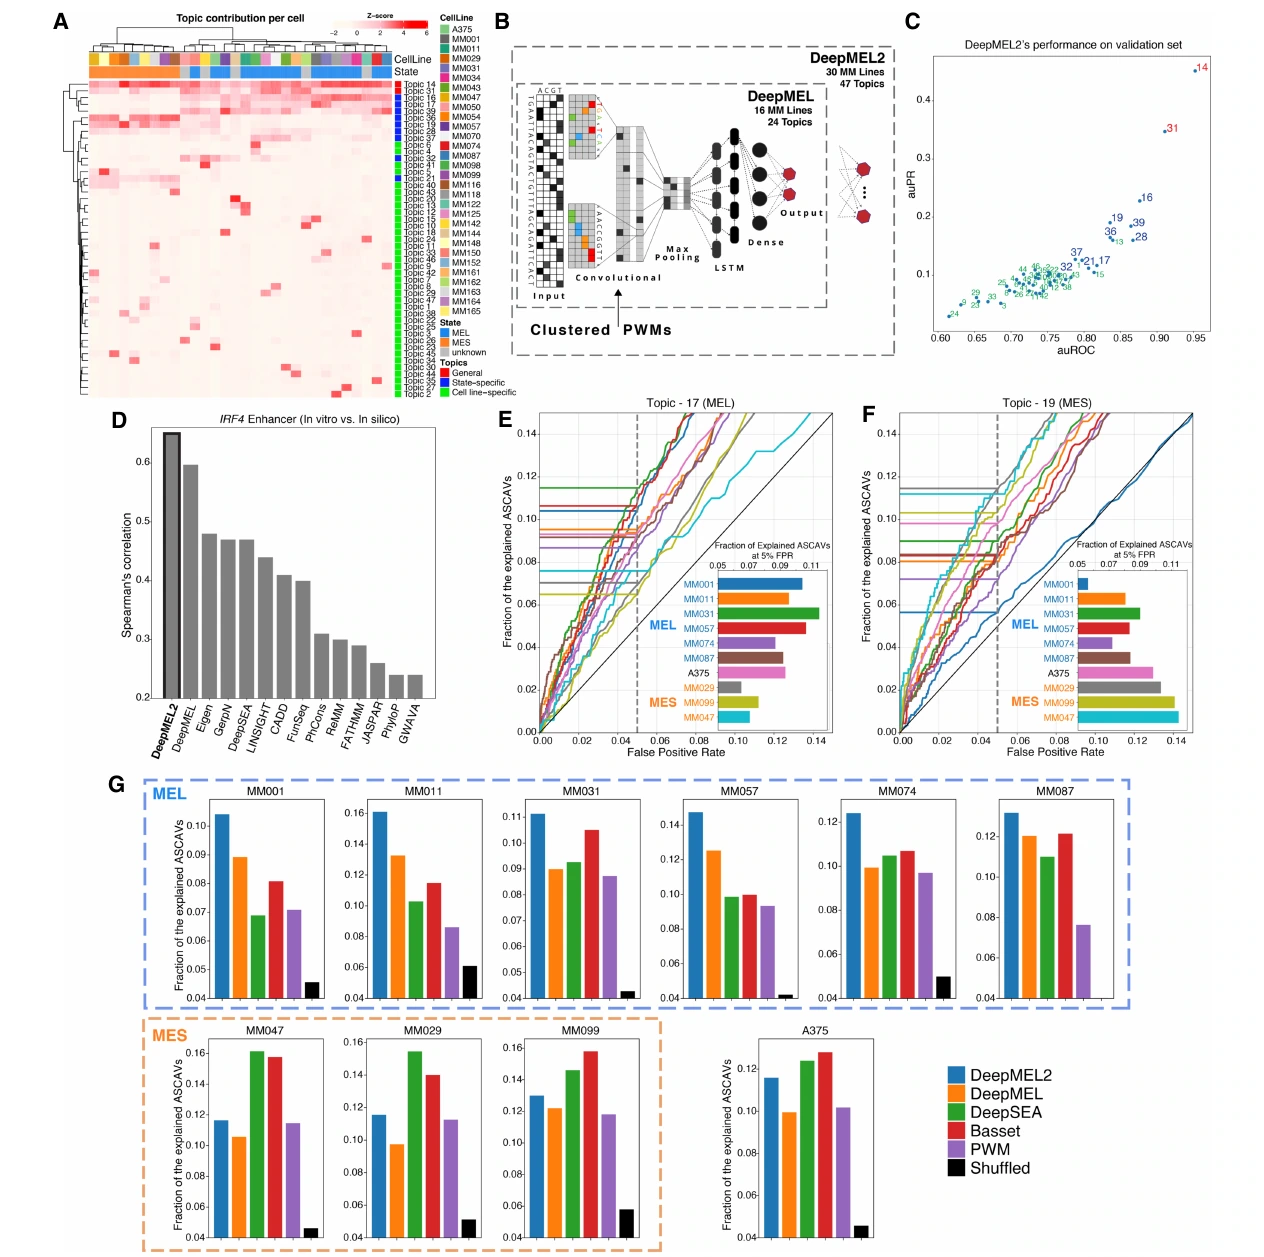
Figure 3:状态感知DeepMEL2解释调控变异
原图来源:所用 PDF 文件第 6 页,Figure 3。点击图片可查看原图。
A、B 同时扩展训练样本、主题数、卷积核容量并加入模体先验,所以 C–G 的改善是组合改进的效果,不能将全部增益归给其中一个因素。C 中细胞系特异主题难预测,提示主题可能包含拷贝数等非序列可解释成分,不能把每个统计主题都命名为真实调控程序。D 的 IRF4 MPRA 则是独立实验读出;E、F 更明确展示 MEL、MES 输出与样本状态匹配时更有解释力。
这里“状态感知”主要指可选择状态对应输出,并非每个输入序列都额外附带患者状态向量。G 用相同 5% 误报率比较覆盖度,支持专业模型对训练中稀缺的黑色素细胞代码有优势;在 MES 背景通用模型仍可能表现好。Methods 给出 80/10/10 划分而未在这段声明严格染色体留出,复现实验应额外核查相邻区域与同源序列泄漏,不能把分类评估自动升级成供体外泛化。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | 30个细胞系开放主题热图,区分通用、状态特异与细胞系特异区域。 |
| B | DeepMEL2相对DeepMEL的结构改进,说明状态感知设计。 |
| C | 各主题auROC和auPR,评估不同目标的分类质量。 |
| D | IRF4增强子变异效应预测的模型比较,提供独立功能实验基准。 |
| E | MEL主题分数在不同细胞系解释ASCAV的曲线,检查状态匹配效果。 |
| F | MES主题的对应曲线,比较另一状态。 |
| G | 固定5%误报率下DeepMEL2、DeepMEL、DeepSEA、Basset及PWM的解释比例,评估状态模型收益。 |
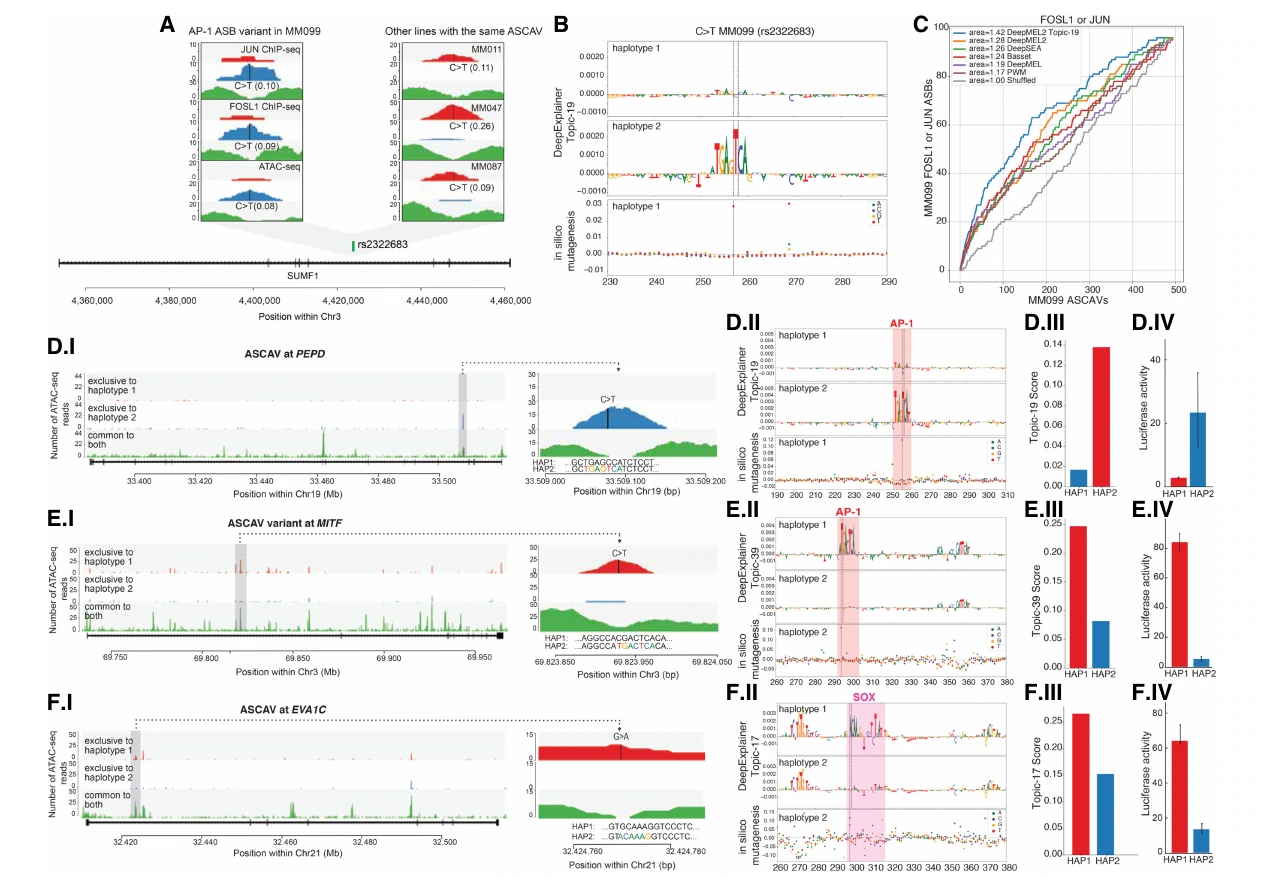
Figure 4:具体调控变异的模型机制与实验验证
原图来源:所用 PDF 文件第 8 页,Figure 4。点击图片可查看原图。
A–C 把 ATAC 偏倚接到真实 JUN/FOSL1 等位结合,证明部分 AP-1 解释不是 logo 看上去相似而已。模型对 ASCAV 的总体排序与对 AP-1 结合偏倚的排序,是两个不同评价任务,前者好并不保证后者好。D、E、F 各自的 I–IV 构成完整小链条:真实 ATAC→归因与虚拟替换→主题分数→两条单倍型的荧光素酶。AP-1 与 SOX10 两种机制并列,使解释不局限于一个家族。
主题分数被用来预测活性方向,不应直接标为实测增强子活性;真正的活性证据来自 IV。报告实验在质粒和所选细胞背景中支持序列造成的功能差异,但不是原位靶基因表达编辑实验。附近基因已有 ASE 使靶向假说合理,仍需排除连锁变异与其他调控元件,才能确立单个位点对内源基因的因果影响。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | SUMF1的rs2322683在ATAC及JUN/FOSL1 ChIP中的等位读段,验证开放与AP-1结合偏倚。 |
| B | 两单倍型归因及饱和突变显示C→T形成AP-1位点,解释MES活性提高。 |
| C | 按不同模型评分排序后回收真实JUN/FOSL1等位结合变异的数量,评估机制识别。 |
| D.I | PEPD内含子C→T的ATAC读段在两个单倍型间不均衡,T等位对应的单倍型更开放;右侧放大直接显示变异处的等位偏倚。 |
| D.II | 两单倍型的归因与饱和突变显示C→T形成AP-1位点。参考序列中只有该位置变成T才明显提高MES增强子分数,定位了效应来源。 |
| D.III | 两单倍型的Topic-19(MES)预测分数比较,含T的单倍型分数更高,量化模型的主题分类分数变化;该分数并非直接测得的增强子活性。 |
| D.IV | 两单倍型的荧光素酶报告活性比较,含T的单倍型活性更强,与模型预测和开放偏倚方向一致。 |
| E.I | MITF内含子C→T的ATAC轨迹及变异处放大图,显示T等位对应的单倍型更开放,是第二个AP-1位点获得的实例。 |
| E.II | 两单倍型归因及饱和突变把差异定位到新形成的AP-1模体,解释局部序列变化为何影响MES调控活性。 |
| E.III | Topic-19分数在含T的单倍型更高,预测该AP-1位点获得会提高MES增强子活性。 |
| E.IV | 荧光素酶实验显示含T的单倍型活性更强,提供与开放度和模型分数一致的功能验证。 |
| F.I | EVA1C内含子G→A的ATAC轨迹及变异处放大图,显示A等位对应的单倍型更开放。 |
| F.II | 两单倍型归因与饱和突变显示G→A形成SOX10结合位点,提供与D、E中的AP-1机制不同的MEL调控实例。 |
| F.III | Topic-17(MEL)分数在含A的单倍型更高,量化SOX10位点获得对MEL增强子活性的预测效应。 |
| F.IV | 荧光素酶实验显示含A的单倍型活性更高,与ATAC等位偏倚及MEL主题分数的方向一致。 |
Figure 5:TERT启动子热点突变解释
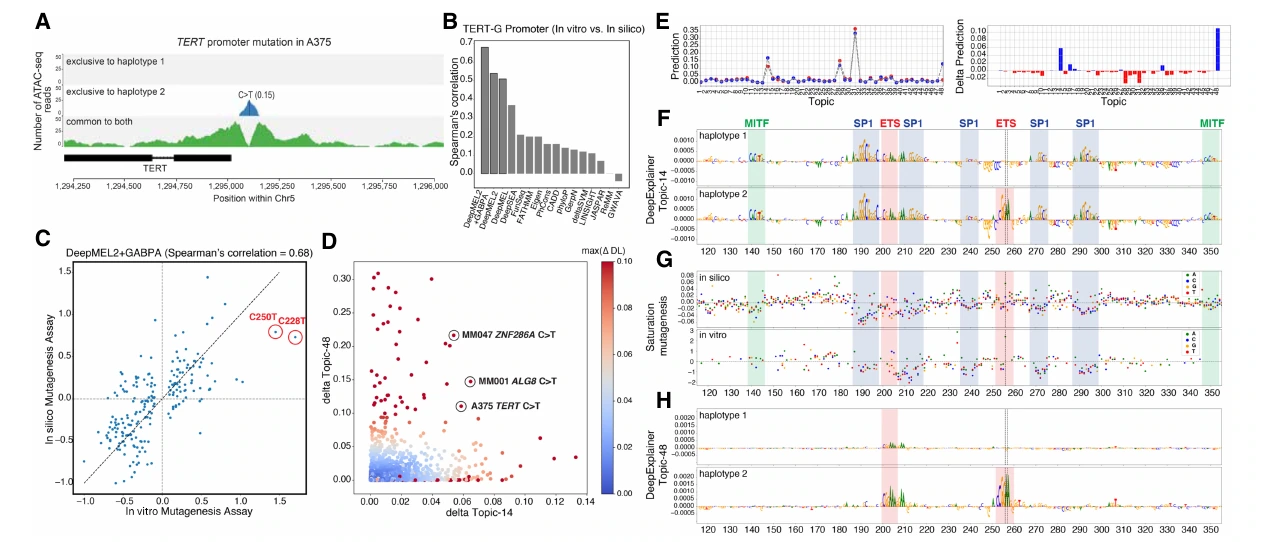
原图来源:所用 PDF 文件第 9 页,Figure 5。点击图片可查看原图。
这张图尤其值得细读失败再修正的逻辑。原版 DeepMEL2 对 TERT 启动子整体突变效果可以相关,却漏掉关键的 GABPA 热点获得;平均相关高并没有保护最重要的个别机制。B、C 通过加入真实 GABPA ChIP 标签作为第 48 类,重新训练后改善热点识别,说明一个对主题区分无用的模体可能对致癌事件非常关键。
A 的开放偏倚来自 A375,B、G 的既有饱和突变实验来自胶质母细胞瘤细胞,跨实验背景的吻合有价值,也不能忽略这种状态差异。D、E 中比热点分数更大的其他候选,只能进入优先验证清单,分数大小不等于比 TERT 更强的致癌能力。F、H 对同一序列选择不同输出归因,展示“解释什么”的选择改变看到的机制;不能把最大输出分数当成统一的生物学答案。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| A | A375 TERT热点T等位的ATAC独占读段,验证突变单倍型更开放。 |
| B | 不同模型对TERT饱和突变实测效应的预测性能,检验启动子建模。 |
| C | 逐变异实测对预测效应散点并标出两热点,检查获功能变异识别。 |
| D | 所有ASCAV的启动子主题对GABPA主题分数变化,筛选TERT和新GABPA获得候选。 |
| E | TERT两单倍型各主题预测及差值,展示热点同时提高启动子和GABPA主题。 |
| F | 按启动子主题归因TERT单倍型,定位其整体调控代码。 |
| G | TERT计算机内与体外饱和突变逐位置对照,验证单碱基效应。 |
| H | 按GABPA主题归因同一区域,定位热点形成的TF结合模式。 |
对 WGS 与 TE 项目的可迁移启发
这条路线很适合把候选 WGS 从“落在哪个注释”推进到“改变了哪个状态中的哪种调控过程”。先用分相信息和可靠的等位计数定位功能偏倚,再由状态适配模型排序机制,最后用独立 MPRA 或结合数据验证。TE 位点更要检查多重比对、参考偏倚和拷贝差异,否则丰富的等位现象可能首先是映射问题。单倍型比较可以提高证据强度,但不能解决所有连锁混杂。
我最想借鉴的是 TERT 的教训:模型必须因任务缺失而修订,不能因平均指标漂亮而认为它理解了一切。AD 项目可在冻结模型后检查它是否漏掉某些细胞类型或 TE 家族的关键功能,再建立新的独立训练标签;若按待验证候选效果反复挑输出与阈值,应另留完全独立数据评价。公共数据做研究可以走到严谨的候选机制与多队列复现,但未有疾病终点证据时,应保留“调控功能变异”与“AD 致病变异”的区别。
等位分析也不能忽略检测功效差异:不同样本开放区覆盖和杂合位点数不同,能够检出的 ASCAV 数量不能直接解释为患者之间调控异常程度。复现时应报告可检验分母、匹配覆盖,并对无显著偏倚控制做高覆盖敏感性分析。对于多个连锁位点,可比较完整单倍型与逐一替换,明确预测是在解释一个局部序列还是一个独立变异。
