29.MutationProjector:原图、模型逻辑与研究范式

29.MutationProjector:原图、模型逻辑与研究范式
Perry论文题名: Translating clinical gene sequencing into a foundational representation of tumor subtype
本次解读版本: bioRxiv version 1, 2025-09-09。预印本原文。
正式发表记录: A Foundation Model of Cancer Genotype Enables Precise Predictions of Therapeutic Response,Cancer Discovery,2026。正式版原文。
正文图讲解依据所提供的预印本;预印本与正式版的题名和部分结果有所不同。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: 用户补入的2025预印本;原表对应2026正式发表版本,题名和部分结果不同。本讲解以所提供PDF为准。
研究瓶颈怎样转化为问题
临床肿瘤 panel 中许多改变罕见,单基因标志物又忽略共现网络。MutationProjector 用三万多个肿瘤的遗传背景和多个网络预训练,学习可被不同任务复用的表示。依据设计逻辑推断,idea 是让稀有改变通过网络及联合遗传模式共享信息,再用独立临床队列检验迁移。当前文件是 2025 bioRxiv v1,下面的 KMT2A 等结果只属于该版本;不可用正式版新结论替换。
输入、目标与结构
体细胞突变、扩增/缺失及协变量通过多类网络消息传递与注意力压缩,预训练联合 15% 基因遮蔽重建、癌种和免疫表型预测。它并非完全无监督,癌种等辅助标签已经进入目标。下游再训练化疗、免疫和转移分类器;同一表示可复用,不等于一个现成头自动适用于全部任务。注意力和特征排名提供机制候选,真实治疗获益仍需另外的因果设计。
Figure 1:用于预训练的数据与模型
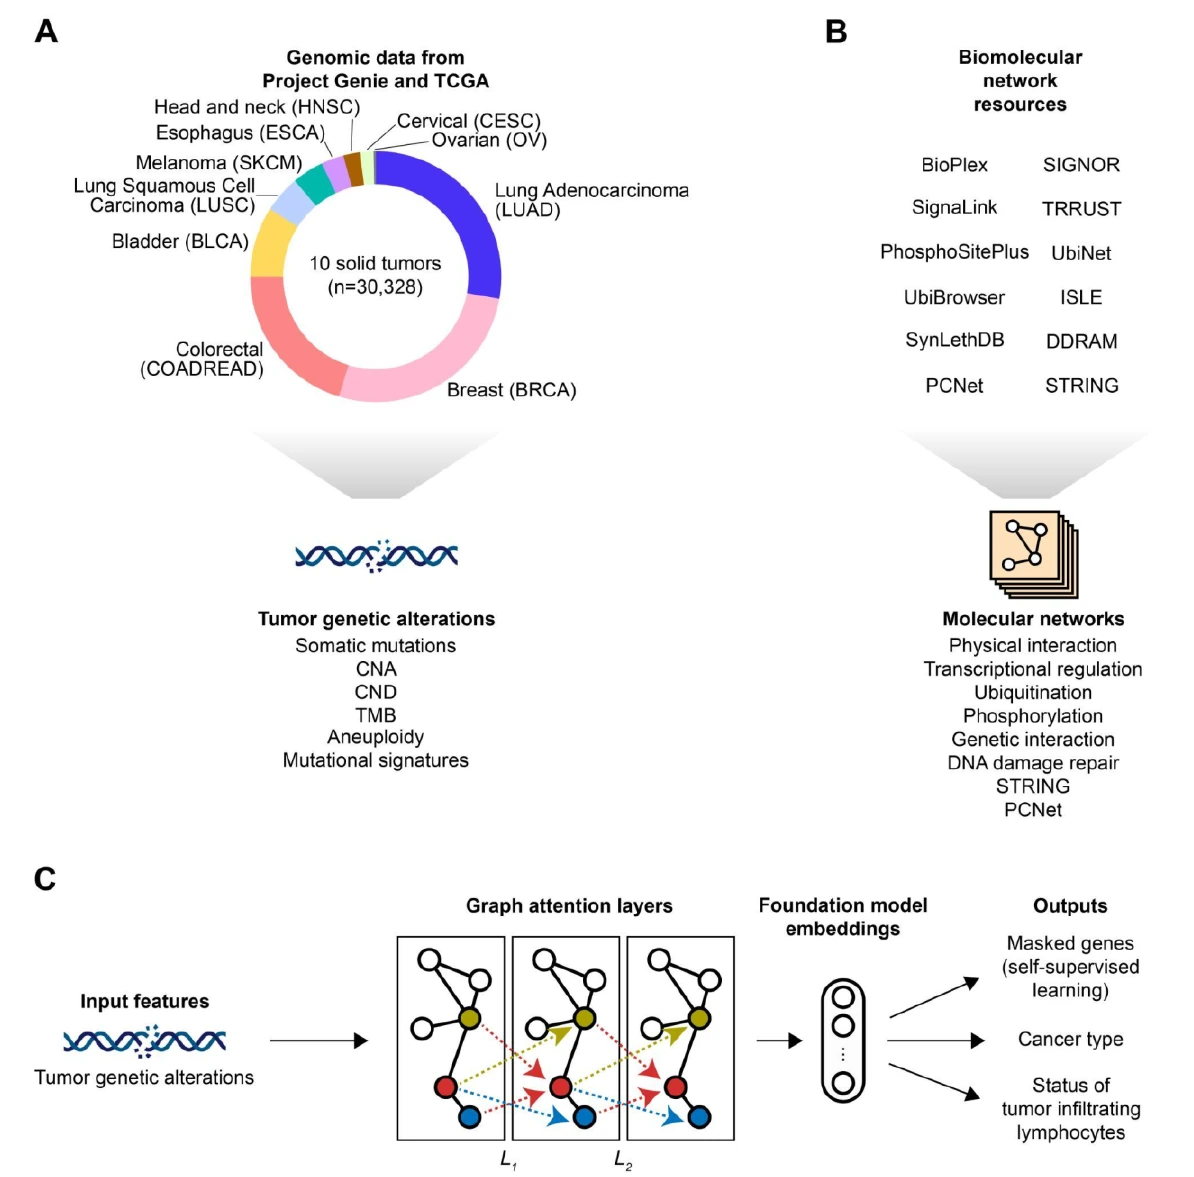
原图来源:所用 PDF 文件第 14 页,Figure 1。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | 收集肿瘤体细胞突变、拷贝数扩增/缺失等改变和协变量;这些肿瘤基因组数据是预训练的输入。 |
| B | 整合信号、转录调控、合成致死、DNA 损伤响应及综合互作网络等先验;不同网络提供互补的基因间关系。 |
| C | 通过网络消息传递及注意力把高维基因改变压缩成肿瘤表示,联合进行遮蔽基因重建、癌种预测及免疫表型预测三项预训练。 |
多网络提供互补的基因关系,也引入已知知识偏倚,模型须和单网络或去网络变体比较。基因改变不是原始 WGS 序列,无法直接定位非编码 SNV/TE 功能。协变量和辅助标签需记录采样时点,预训练样本与下游测试若重叠,应明确区分表示学习与响应标签独立性。
Figure 2:遮蔽重建及辅助任务性能
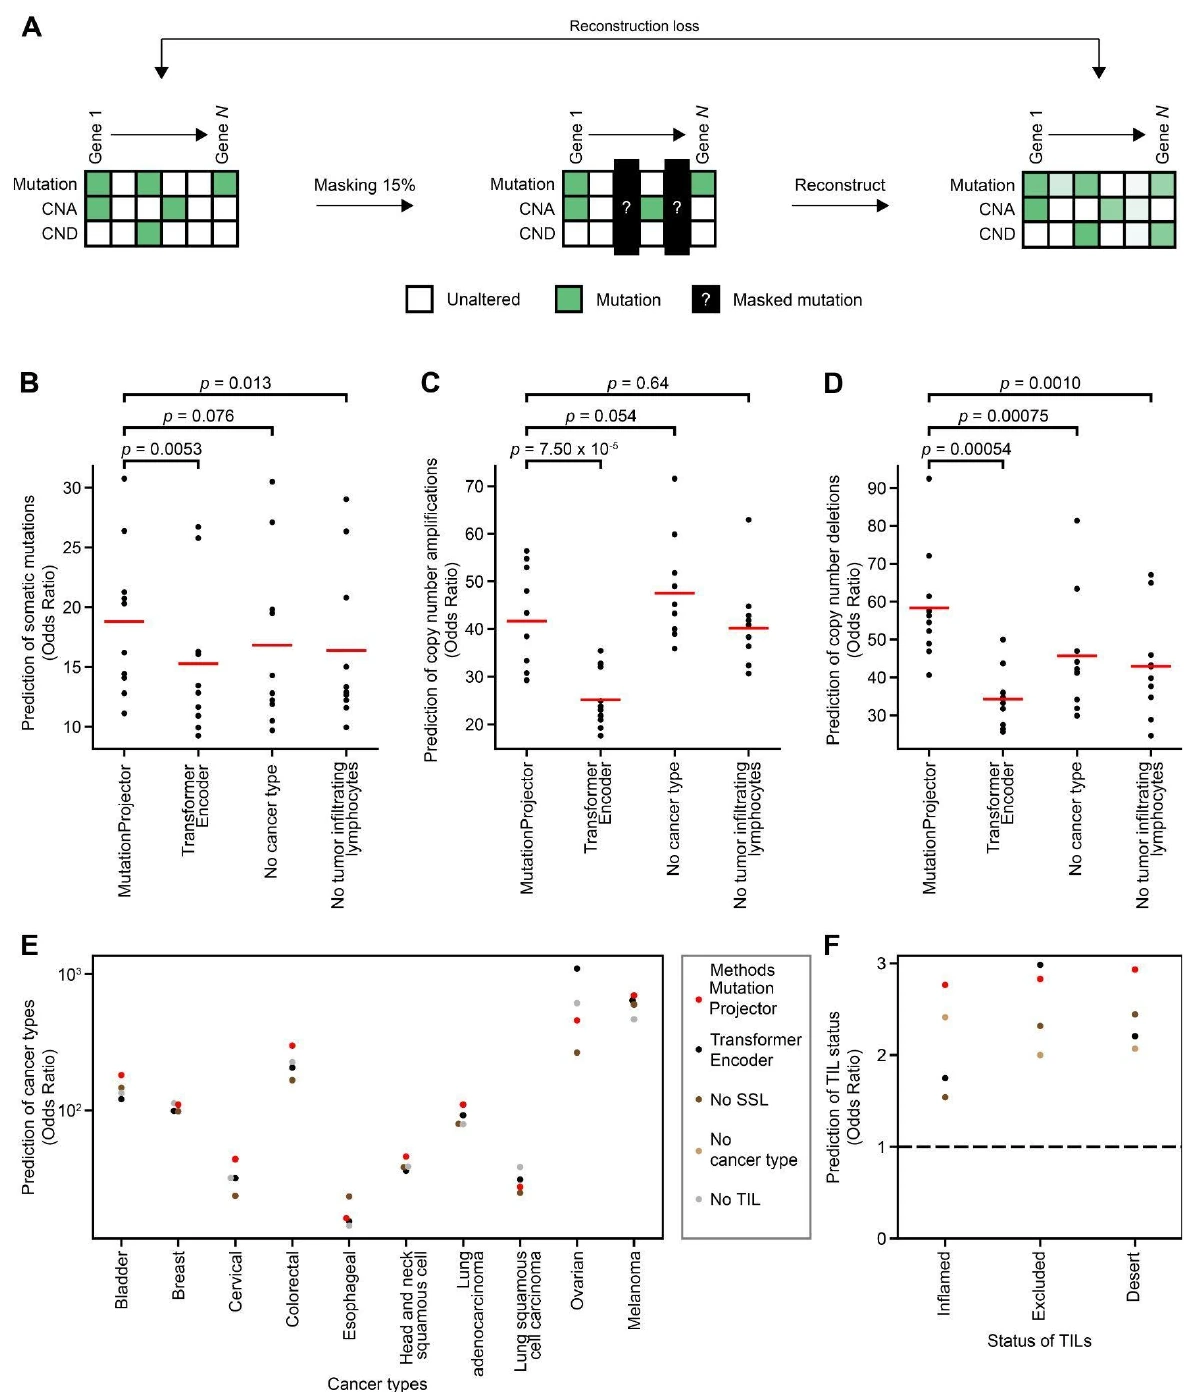
原图来源:所用 PDF 文件第 15 页,Figure 2。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | 每轮随机遮蔽 15% 基因,用自监督重建训练模型;测试时也遮蔽位点,检查模型能否从剩余遗传背景恢复改变。 |
| B | 在留出样本上比较体细胞突变重建的优势比 OR,完整模型优于若干简化训练/架构基线;衡量预测突变的位置是否富集真实突变。 |
| C | 同样评价拷贝数扩增 CNA 重建;检查预训练能否捕获另一类肿瘤遗传改变。 |
| D | 评价拷贝数缺失 CND 重建;与 B/C 一起展示模型学习不同改变之间的关联。 |
| E | 留出样本中的癌种预测,比较完整模型和不同预训练任务设置;说明辅助监督任务也改善表示,但癌种本身参与了训练。 |
| F | 预测肿瘤浸润淋巴细胞相关免疫表型;效果弱于癌种识别,显示单靠基因改变预测免疫环境仍有难度。 |
重建 OR 衡量预测改变富集,不是实际变异检测准确率,也不能把未观察突变都当良性。突变/CNA/CND分开检查不同遗传类型,癌种预测强可能来自已经监督的癌种信息;免疫表型较弱则显示基因改变不能完全决定微环境。预训练任务的消融帮助解释哪种监督增益。
Figure 3:表示空间捕获分子亚型与多基因模式
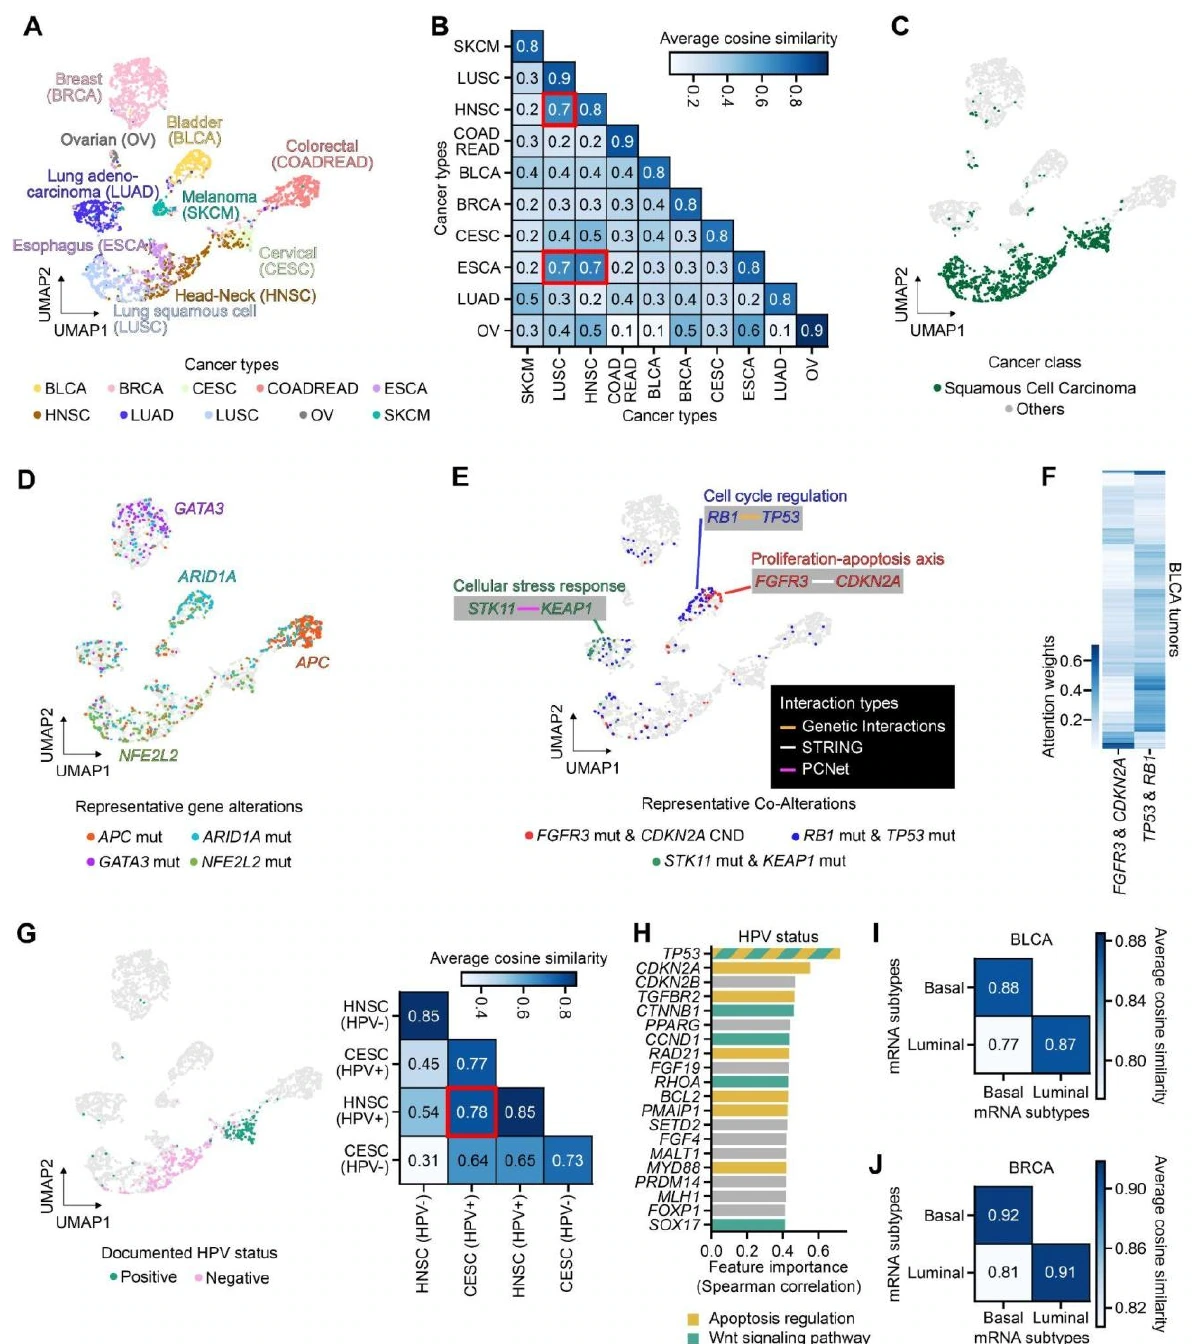
原图来源:所用 PDF 文件第 17 页,Figure 3。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | 将 3,733 个 TCGA 肿瘤的最终嵌入作 UMAP,并按癌种着色;不同癌种出现分组,也有跨组织相似性。 |
| B | 各癌种之间平均余弦相似度热图,红框标出最相近的三对癌种;将 A 的视觉分布转为定量相似性。 |
| C | 突出鳞状癌,观察不同器官来源的鳞状肿瘤在表示中聚集,说明组织来源之外的共享遗传特征也被捕获。 |
| D | 按代表性基因改变着色,如 FGFR3、GATA3、NFE2L2;展示局部亚型分布与特定遗传改变的对应。 |
| E | 展示 FGFR3–CDKN2A、TP53–RB1、STK11–KEAP1 等共同改变的代表性肿瘤;检查模型是否保留联合遗传模式。 |
| F | 膀胱癌中两组基因关系的注意力模式呈互斥,提示模型区分不同分子亚型;注意力是模型关联量,不能直接当作实验互作强度。 |
| G | 按 HPV 状态突出头颈/宫颈肿瘤,并比较相关亚型表示相似度;HPV 状态没有作为输入,模型仍从宿主基因改变捕获相应关联。 |
| H | 与 HPV 状态相关的前 20 个特征,按 Spearman 关联重要性排序;用于解释 G 中的宿主遗传信号。 |
| I | 膀胱癌基底与腔面 mRNA 亚型的表示相似性,检查遗传嵌入能否反映表达定义的分型。 |
| J | 乳腺癌中重复基底/腔面亚型比较,检验这种跨数据层级联系是否延伸到另一癌种。 |
UMAP、余弦相似和共同改变说明表征组织,癌种已参与训练所以癌种分离并非纯涌现证明。HPV 未作为输入,捕捉其宿主模式为额外关联;mRNA 亚型验证跨层一致性,仍不是直接表达预测。注意力互斥不等于实验遗传互作,具体联合改变须在独立数据检验。
Figure 4:下游药物反应和转移预测
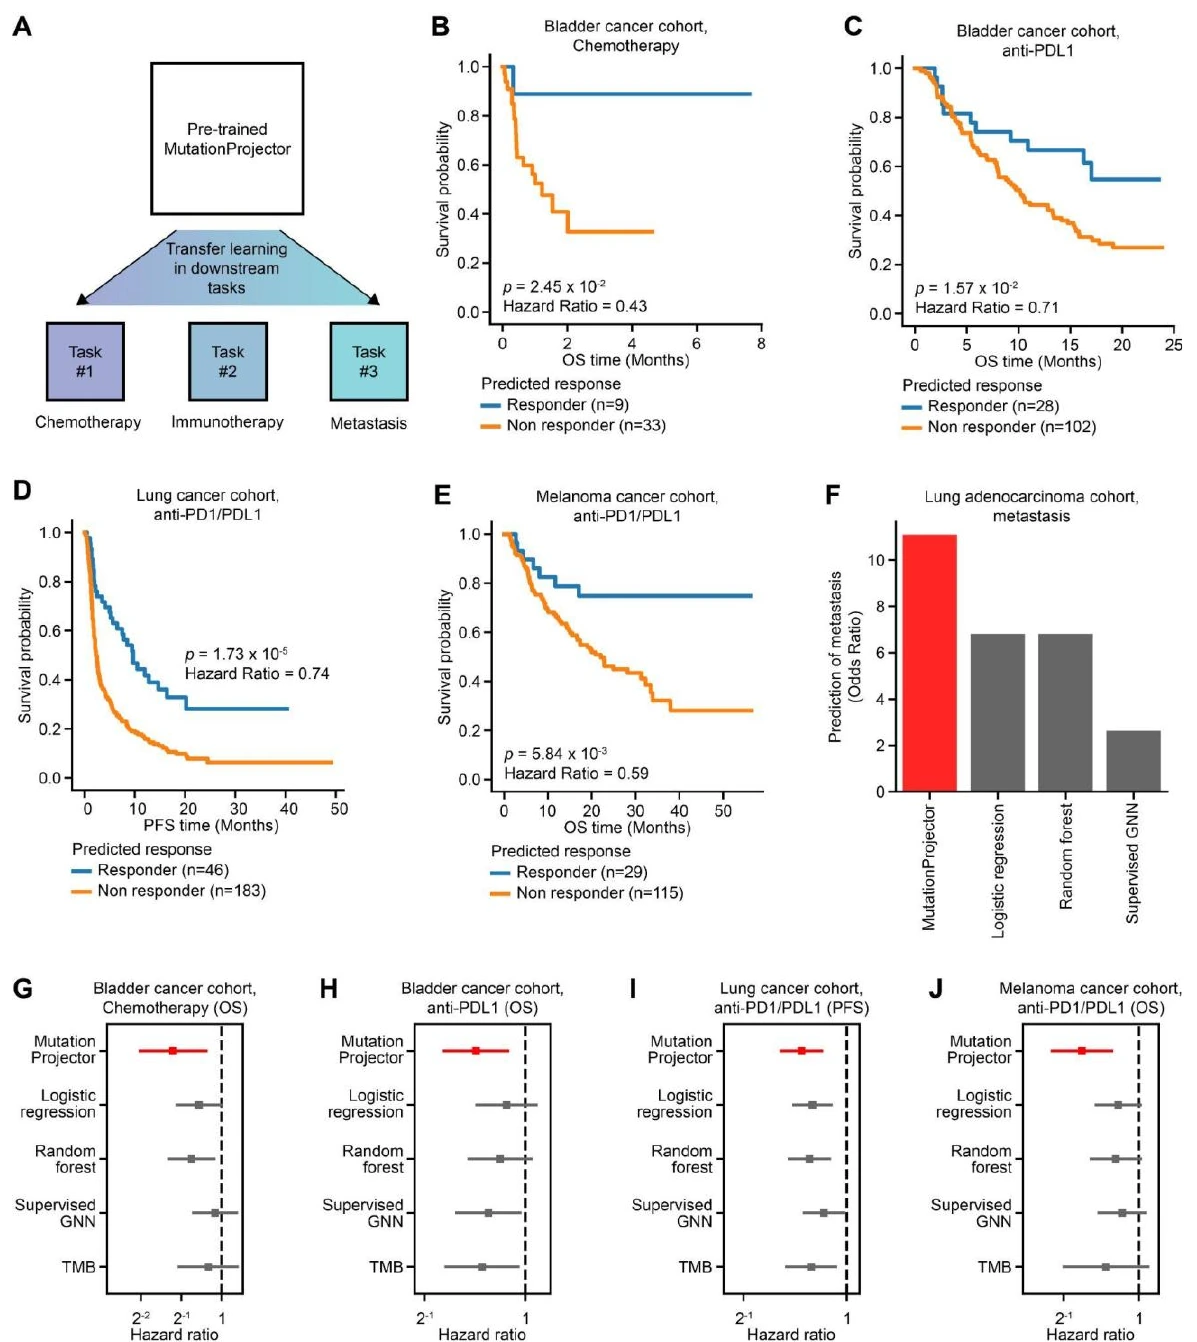
原图来源:所用 PDF 文件第 19 页,Figure 4。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | 将同一预训练表示用于化疗、免疫治疗和转移三个下游任务,再使用各自训练队列建分类器并在独立队列测试。 |
| B | 42 例膀胱癌的化疗测试队列:预测响应组总体生存较长,检查基因表示能否分层顺铂相关结局。 |
| C | 130 例膀胱癌的 anti-PDL1 测试队列:预测响应组总生存较好,支持在独立免疫治疗队列的关联预测。 |
| D | 229 例肺癌 anti-PD1/PDL1 队列:预测组间无进展生存 PFS 不同;这里终点是 PFS,与 B/C/E 的 OS 不同。 |
| E | 144 例黑色素瘤 anti-PD1/PDL1 队列:预测响应组总生存较长,检验跨癌种的下游泛化。 |
| F | 肺腺癌转移预测与逻辑回归、随机森林、监督 GNN 比较;MutationProjector 的预测 OR 更高,显示区分转移与局限肿瘤的能力。 |
| G | 膀胱癌化疗任务的风险比及置信区间,对照多种监督基线和肿瘤突变负荷 TMB;红色为 MutationProjector,虚线为 HR=1。 |
| H | 膀胱癌免疫治疗任务的同类风险比比较,量化模型分层与总生存的联系。 |
| I | 肺癌免疫治疗任务的 PFS 风险比比较,检查模型是否比常规方法更有效地分层进展风险。 |
| J | 黑色素瘤免疫治疗任务的 OS 风险比比较;各队列应按自身终点和置信区间解释,不把生存关联直接写成治疗因果效应。 |
四治疗队列终点分别为膀胱化疗 OS、膀胱免疫 OS、肺免疫 PFS、黑色素瘤免疫 OS,不能混报统一生存改善。独立测试支持风险分层,治疗选择、病期与既往疗程仍可混杂;模型响应组生存较好不证明用它选药获益。F 的转移 OR是另一分类目标,G–J HR还须连置信区间读。
Figure 5:哪些特征支持下游预测
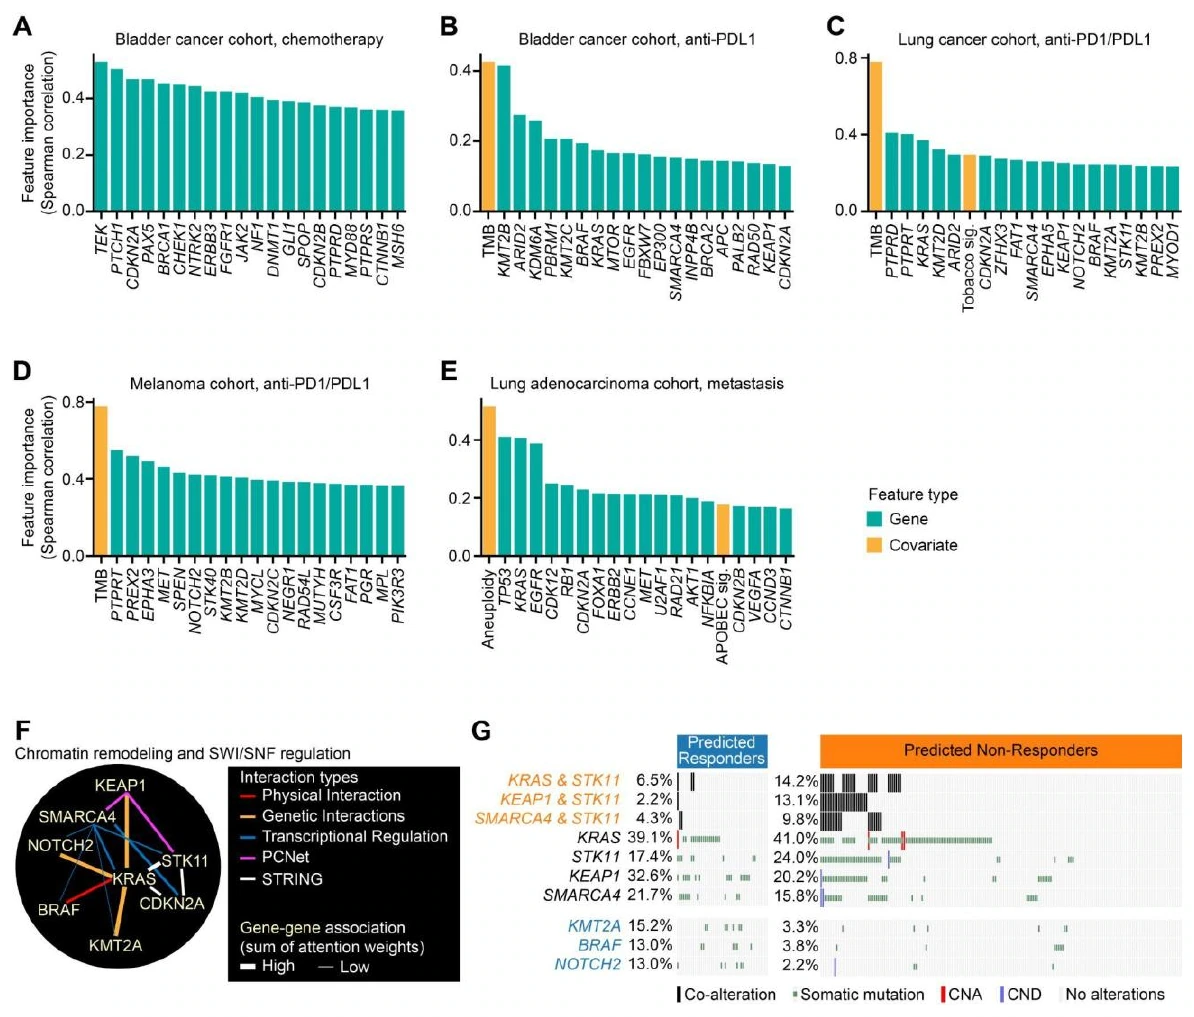
原图来源:所用 PDF 文件第 21 页,Figure 5。点击图片可查看原图。
| 子图 | 讲解 |
|---|---|
| A | 膀胱癌化疗预测的前 20 个特征,区分基因与协变量;说明化疗任务使用哪些遗传/背景信息。 |
| B | 膀胱癌 anti-PDL1 反应的特征排序,TMB 等位居重要位置,显示免疫任务与化疗依赖的信号不同。 |
| C | 肺癌免疫治疗特征排序;除了 TMB,还包括染色质重塑相关改变,作为 F/G 网络分析的起点。 |
| D | 黑色素瘤免疫治疗的前 20 个特征;与 B/C 对照检查跨癌种共享及不同的候选标志物。 |
| E | 肺腺癌转移预测的特征排序,包括细胞周期、DNA 损伤及其他基因组背景信息,解释第三项任务。 |
| F | 以 KRAS 为中心展示染色质重塑/SWI-SNF 相关基因网络;边颜色表示已有互作类型,粗细表示模型注意力总和,用于定位联合改变线索。 |
| G | 比较模型预测响应与不响应组中相关基因的单独或联合改变频率;KRAS–STK11 等组合偏向不响应,KMT2A 等在预测响应组更常见。这是所补预印本中的结果,不能替换为正式版不同的基因结论。 |
阅读提醒
- 本文件只解释用户补入的 2025-09-09 bioRxiv v1:题名为 Translating clinical gene sequencing into a foundational representation of tumor subtype,DOI 10.1101/2025.09.08.674723。原表的 2026 Cancer Discovery DOI 为 10.1158/2159-8290.CD-25-1735。
- Figure 5 使用的是预印本中的 KMT2A 等结果。正式版题名及部分生物标志物发生变化,不能将两个版本的图、基因名和结论混合引用。
特征排序区分不同任务的信息来源,TMB与染色质重塑候选并列;注意力边叠在先验网络上不增加独立实验。G 分组本身来自预测,改变频率差属于解释性关联,不能重新当真实响应标签验证自己。预印本 KMT2A、KRAS–STK11方向需连该版本和队列说明,避免混引用正式版。
我的理解与可迁移设计
值得借鉴的是利用已有遗传结构共享稀有事件信息,并分别验证不同临床任务。对 DNA×AD,应先决定是逐变异功能、病理关联还是病例分类,不能用一个图模型同时宣称完成全部证据链。非编码位点需要正式 allele/build和靶基因联系,肿瘤基因改变模型不能直接提供这些标签。有限资源可建立小的可信网络与固定序列表征,比较无图/随机图/真实图;增益若只来自共享研究或强协变量,应写清而不称新机制。
