50.SleepFM:原图、模型逻辑与研究范式

50.SleepFM:原图、模型逻辑与研究范式
Perry论文题名: A multimodal sleep foundation model for disease prediction
期刊与年份: Nature Medicine,2026。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
研究问题: 大规模多导睡眠生理记录的自监督表示能否迁移到睡眠任务和未来多种疾病预测?
睡眠多模态怎样形成可复用表示
PSG记录脑、心脏、肌肉和呼吸,但不同机构通道配置不一,单任务监督模型难以充分利用长期多系统信息。本文先学习跨模态共同结构,再用冻结表示适应睡眠和疾病任务。我的推测是,idea来自庞大无标签睡眠数据与异质测量条件并存:如果预训练能容纳缺通道和不同排列,就能减少每个任务重复标注。这是引言支持的研究逻辑,不是作者个人构思记录。
对比学习的标签来自同时测量,不来自疾病
跨模态共享有好处也有代价:训练鼓励各系统对齐,可能优先保留共同状态,而某个疾病只存在于一个模态的特有细节可能被弱化。因此对比学习应与单模态表示、简单拼接及不同预训练目标比较,不能因“多模态”便认定所有信息都被最优保留。本文不同模态与下游头的比较提供相应线索,联合结果较好仍限定于受测任务。
同一夜的生理窗口有强时间相关,批次中的负样本选择也可能携带患者或中心身份。患者级留出和外部适配能够部分检查这些问题,不能只用对比损失下降宣布学到疾病表征。五秒输入与五分钟预训练上下文、整夜聚合对应不同尺度;把这些尺度分开有助确定信号来自短暂异常还是长期睡眠结构。若用于新的疾病,需要在同一表示上检查额外风险信息与人口学或已有睡眠指标相比是否仍然存在。
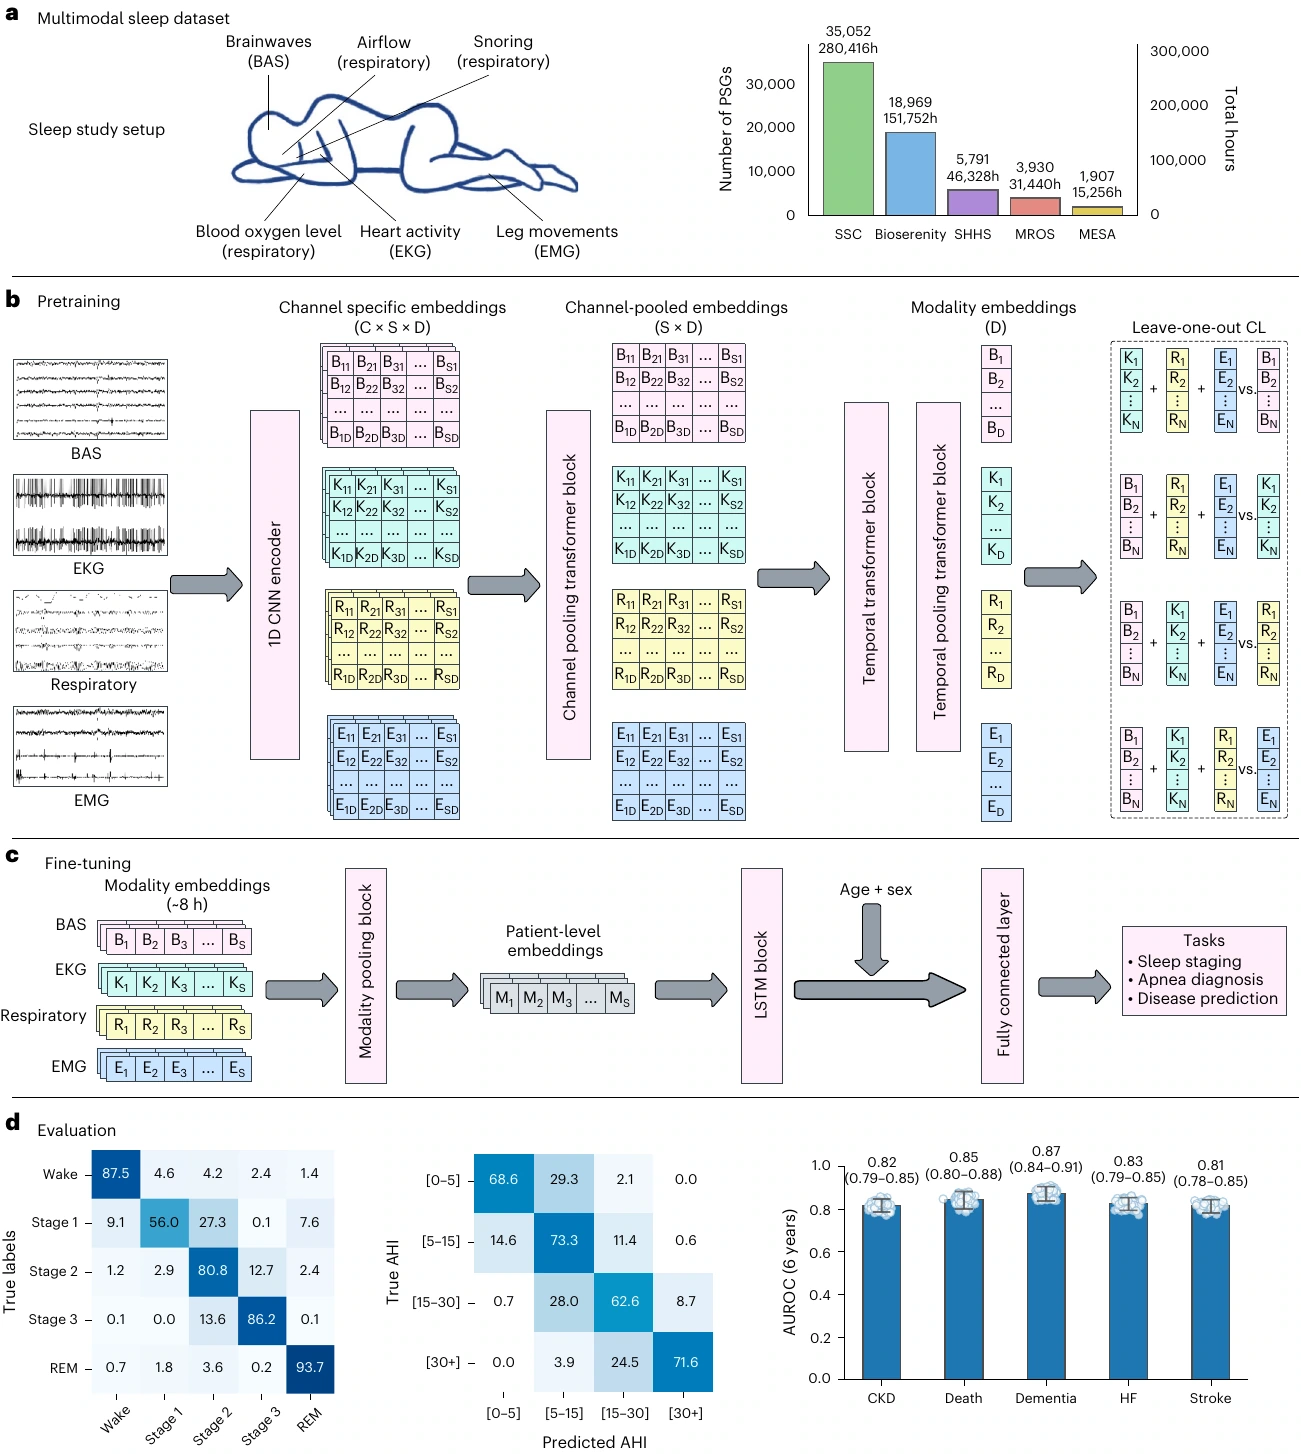
原始信号统一到128Hz并分为五秒窗口,CNN提取局部形态,通道池化处理数量及顺序差异,时间Transformer聚合五分钟上下文。留一模态对比目标将某模态与其余模态的同一片段表示对齐,使网络利用配对测量中的共享信息。这样的自监督条件来自真实同步模态,不是任意将同一数据重命名为多种模态。
下游聚合整夜嵌入并加入年龄、性别,以轻量头预测睡眠分期、呼吸暂停或疾病。疾病部分采用多标签Cox比例风险损失,因此疾病预测是监督生存任务,不是预训练后未经任何标签就产生诊断。冻结表示与简单线性头也具有较强性能,说明信息主要在表示,而非必须靠更复杂下游网络。
疾病定义来自睡眠检查后超过七天首次记录的phecode,排除很低患病率的类别。这减少最明显同期标签,却不能保证检查时尚无亚临床疾病,也不能把首次记录时间当成真实生物发病时间。六年AUROC与C-Index分别看指定窗口区分和时间风险排序,不能互换,风险排序好也不代表绝对概率校准或干预获益。
SHHS未进入预训练,但下游使用其部分患者标签适配,再在2000人测试;这是外部迁移学习,不能说完全零样本疾病预测。Stanford未来时间测试是另一种漂移检验。约六万五千参与者及大量小时提供训练机会,但病人的筛选背景、疾病记录来源和不同队列终点可得性仍限定解释。
论文展示痴呆等终点预测,并不由此证明睡眠模式导致AD或识别其分子机制。综合生理状态可能反映既有共病、年龄及早期病理。理解这条边界后,自监督多模态表示仍然很有研究价值:它给有限标签任务提供可复用的非图像信息,而机制需要独立资料。
Figure 1|SleepFM 的预训练和任务
原图来源:所用 PDF 文件第 4 页,Figure 1。点击图片可查看原图。
图1明确预训练与下游头的分工。跨通道、时间和模态池化解决不同采集配置问题,留一模态对齐利用共同生理,而整夜LSTM或线性任务头负责特定终点。代表疾病图加入年龄性别,所以预测信息不是睡眠信号单独贡献;后面基线才检验增量。患者级bootstrap比以窗口为独立单元更合适,因为一夜数千窗口并不等于数千人。分期混淆矩阵和疾病风险各有指标,不能把睡眠分期成功直接当作疾病机制证明。
| 子图 | 讲解 |
|---|---|
| a | 展示多导睡眠监测设备及多个中心的参与者/记录小时数,界定多模态训练数据规模。 |
| b | 各模态由 CNN、通道池化和时间 Transformer 编码,再以留一模态对比学习 LOO-CL 对齐表示。 |
| c | 冻结预训练嵌入,聚合八小时信号并加入年龄、性别,训练下游睡眠分期、呼吸暂停、疾病预测头。 |
| d | 睡眠阶段、AHI 的混淆矩阵及代表疾病性能,说明一个表示可支持不同任务;疾病曲线来自 5,019 人测试集。 |
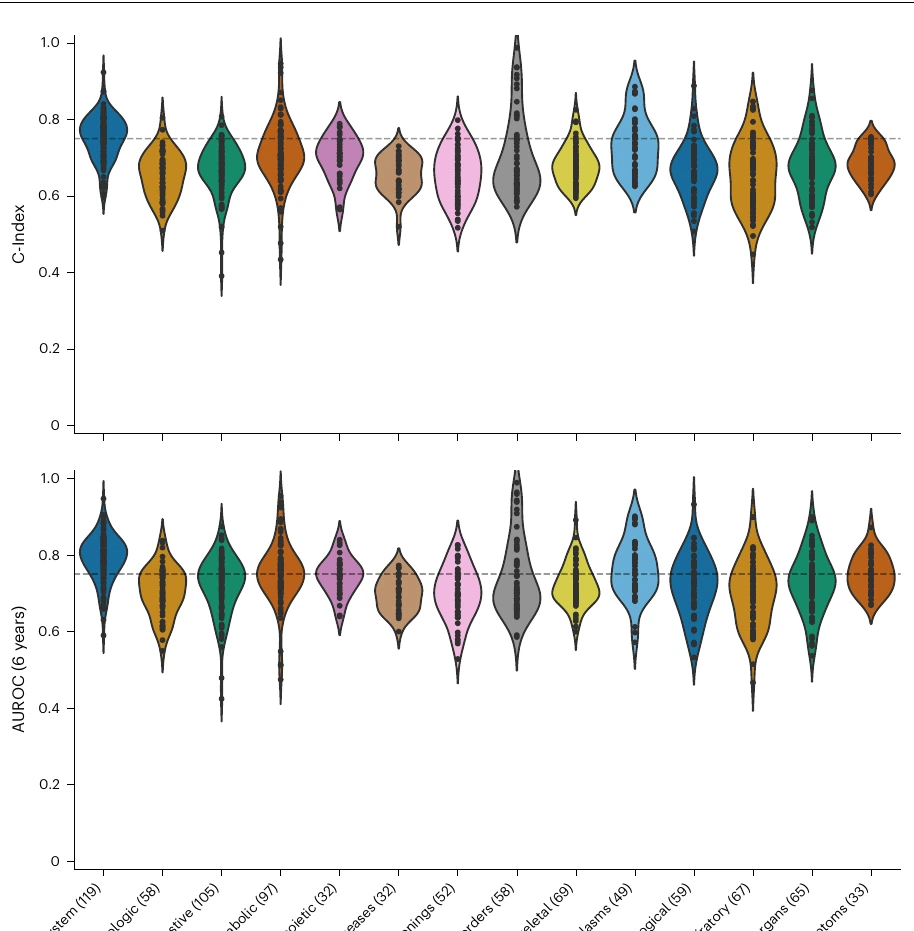
Figure 2|疾病类别的内部测试表现
原图来源:所用 PDF 文件第 5 页,Figure 2。点击图片可查看原图。
图2显示类别内部差异,避免“预测130种病”被读成所有终点同样准确。每个点是一个疾病定义,而非一个病人,类别小提琴描述性能分布。0.75参照线是阈值,达到它并不说明临床操作点有可接受阳性预测值。C-Index涉及风险先后与删失,六年AUROC针对固定窗口,两者同时较高提供互补排序依据。类别频率、随访和诊断过程影响估计,应结合置信区间及独立数据,而不是只数高于线的点。
| 子图 | 讲解 |
|---|---|
| 上图:C-Index | 每点是一种疾病,各类别小提琴显示风险排序能力分布;0.75 虚线作参照,性能随疾病类型不同。 |
| 下图:六年 AUROC | 衡量六年内患病/未患病的区分能力,与上图互补。130 种未来疾病同时达到 C-Index 和 AUROC≥0.75,但不代表每一种疾病都同样准确。 |
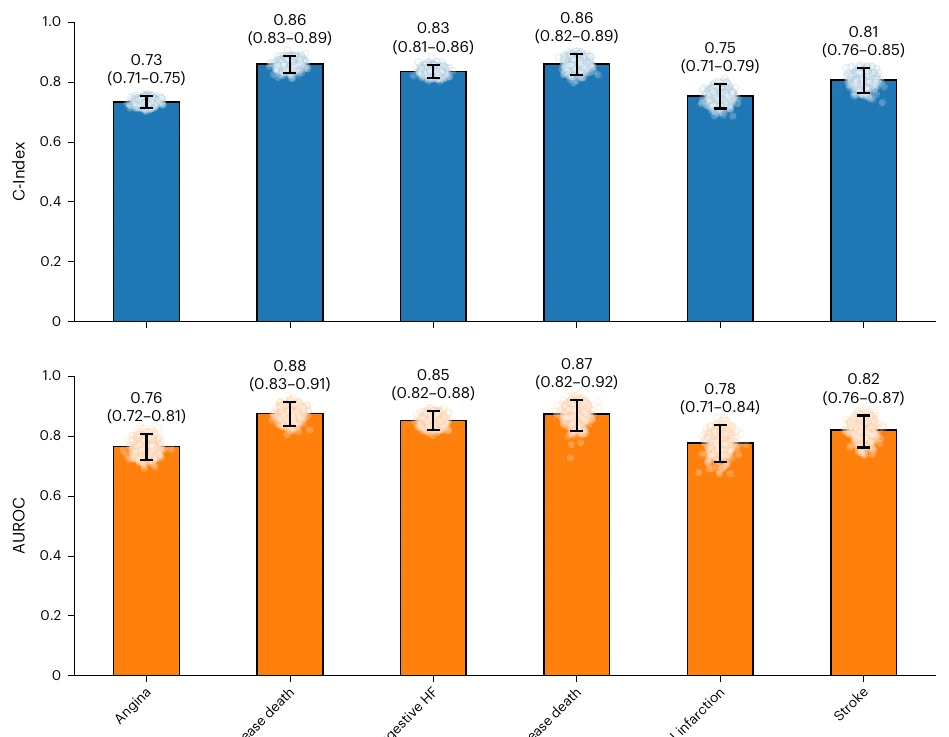
Figure 3|SHHS 外部队列迁移
原图来源:所用 PDF 文件第 6 页,Figure 3。点击图片可查看原图。
图3检验在未预训练队列中使用表示并进行适配。六个心血管终点受SHHS可取得资料限制,不包括全部内部疾病集合,因此不能宣称所有130病均已外部复现。适配训练与测试患者分开,患者级置信区间描述不确定性。良好心衰或卒中性能支持转移信息,但当地标签已经进入任务头;这比纯零样本弱一些,却更贴近实际有少量标签的部署。不同队列测量和随访背景仍需单独校准,不能用外部AUC取消所有漂移问题。
| 子图 | 讲解 |
|---|---|
| 上图:C-Index | 在未用于预训练的 SHHS 上适配后,以 2,000 人测试心绞痛、心血管死亡、心衰、冠心病死亡、心梗和卒中的风险排序。 |
| 下图:六年 AUROC | 同六个终点的区分度及患者级 bootstrap 置信区间,例如心衰约 0.85、卒中约 0.82,验证跨中心迁移而非仅原院数据。 |
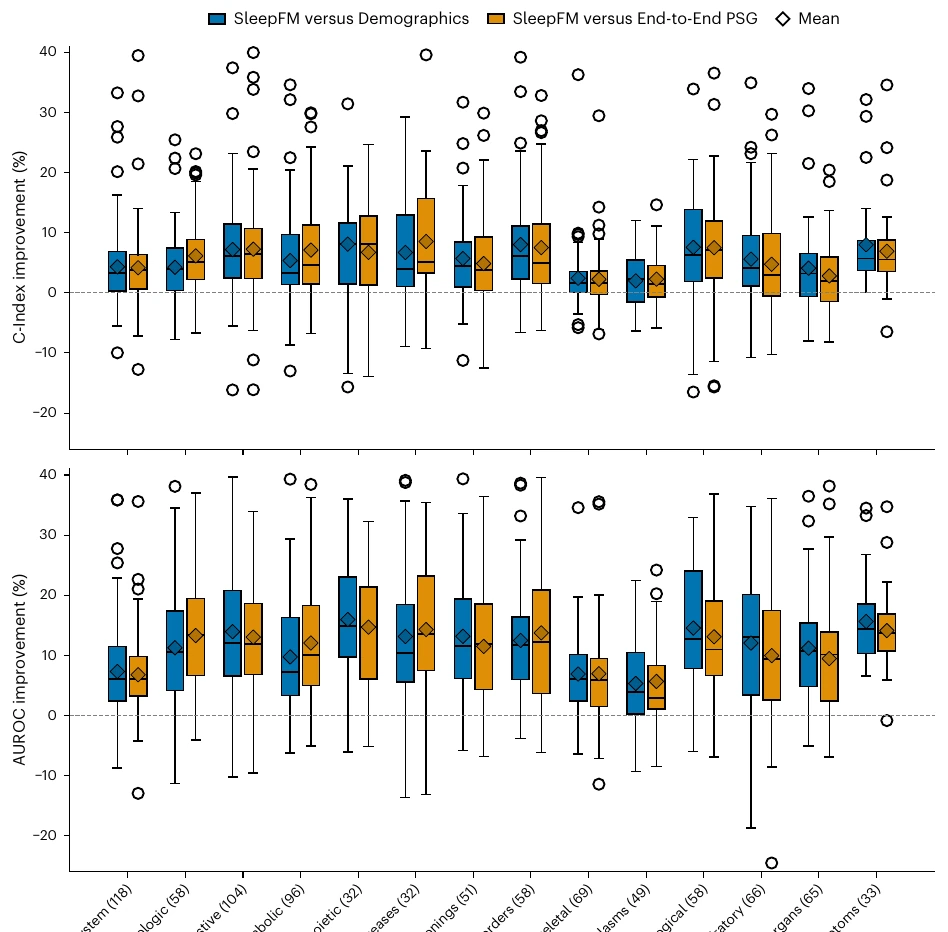
Figure 4|相对基线的性能增益
原图来源:所用 PDF 文件第 7 页,Figure 4。点击图片可查看原图。
图4同时比较人口学和同架构无预训练模型,才能辨别睡眠增量与预训练贡献。人口基线含更多人口变量,模型含年龄性别,对照信息条件需写清;端到端基线相同容量帮助排除只因参数更多的解释。不同疾病类别提升幅度不一样,百分比增益不是同等数量的临床病例或同样绝对AUC百分点。图中的分布也可能有无改善或较小改善的类别,不能只摘最大增益。下游线性头接近LSTM进一步提醒,复杂度应由增量证据决定。
| 子图 | 讲解 |
|---|---|
| 上图:C-Index 提升 | 按疾病类别显示相对人口学基线和端到端 PSG 模型的百分比增益;预训练表示在多数类别增加风险排序信息。 |
| 下图:六年 AUROC 提升 | 对应区分度增益,零线表示无改善。不同疾病类别增益不等,模型优势需看分布及基线选择。 |
阅读说明
- Figures 2–4 原图没有字母标号,按上下位置逐块解释。C-Index 评价时间结局的风险排序;AUROC 使用指定六年窗口,两者不能互换。
依据:对应主图、完整图注及正文 Results;实验结果只按本文给出的对象和条件解释。
对公共数据与TE多组学研究的启发
这篇文章最可迁移的是先使用真实配对模态学习共享结构,再检验疾病信息。RNA与ATAC若为同细胞multiome,可形成明确同步配对;若来自不同细胞或不同donor,就需要桥接设计,不能直接沿用同步对比的标签。将TE重叠峰和非TE峰拆成两个视图可以研究模块,但TE家族汇总不是独立RNA模态,名称变化不会增加新的测量证据。
在16GB显存上,可以冻结已有表示、用单细胞型子集或紧凑编码器建基线,再比较线性头、非深度学习topic模型及共享潜变量方案。创新应来自问题定义、独立验证和可解释模块,不必要求大规模基础模型。预训练重建或对齐优秀也可能主要捕捉批次与细胞身份,必须在donor留出和病理检验中确认。
最后,多终点高性能不能代替机制。若AD关联只来自年龄或一般疾病负担,需要匹配对照并检查增量。自监督训练可以不使用AD标签,但最终关联仍应在训练之后、独立资料中验证。本文说明这种分阶段路径可行,也提醒我们将探索、预测与因果主张分别写清。
