5.SpliceAI:原图、模型逻辑与研究范式

5.SpliceAI:原图、模型逻辑与研究范式
Perry论文题名: Predicting Splicing from Primary Sequence with Deep Learning
期刊与年份: Cell,2019。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Cell,2019;以当前 PDF 为准。
研究瓶颈怎样转化为问题
经典剪接算法通常盯住 GT/AG 邻域,而基因中存在大量看似合格却不会使用的基序。SpliceAI 将问题改成:在完整前体 RNA 背景中,每个位置最终会不会被识别为供体或受体?根据论文的设计逻辑,长程上下文不是单纯扩大输入,而是补入外显子定义、内含子长度及竞争位点的信息,从而解释局部基序为何不足。模型训练不依赖疾病标签,使罕见和未观察突变也可以被计算检验。
输入、训练目标与结构
输入为原始 DNA 编码的前体 RNA 序列,逐位置输出受体、供体或均非的概率。32 层扩张卷积和残差结构扩大感受野,10,000 nt 侧翼上下文在保持碱基定位的同时整合远距离线索。训练标签来自 GENCODE 剪接注释,留出染色体且排除旁系同源影响;不是把临床‘致病’直接当监督目标。变异时成对计算参考和替代序列,Δ score 汇总局部剪接概率变化。它可提出异常连接位置,但无显式组织输入,组织外显率需 RNA 数据补充。
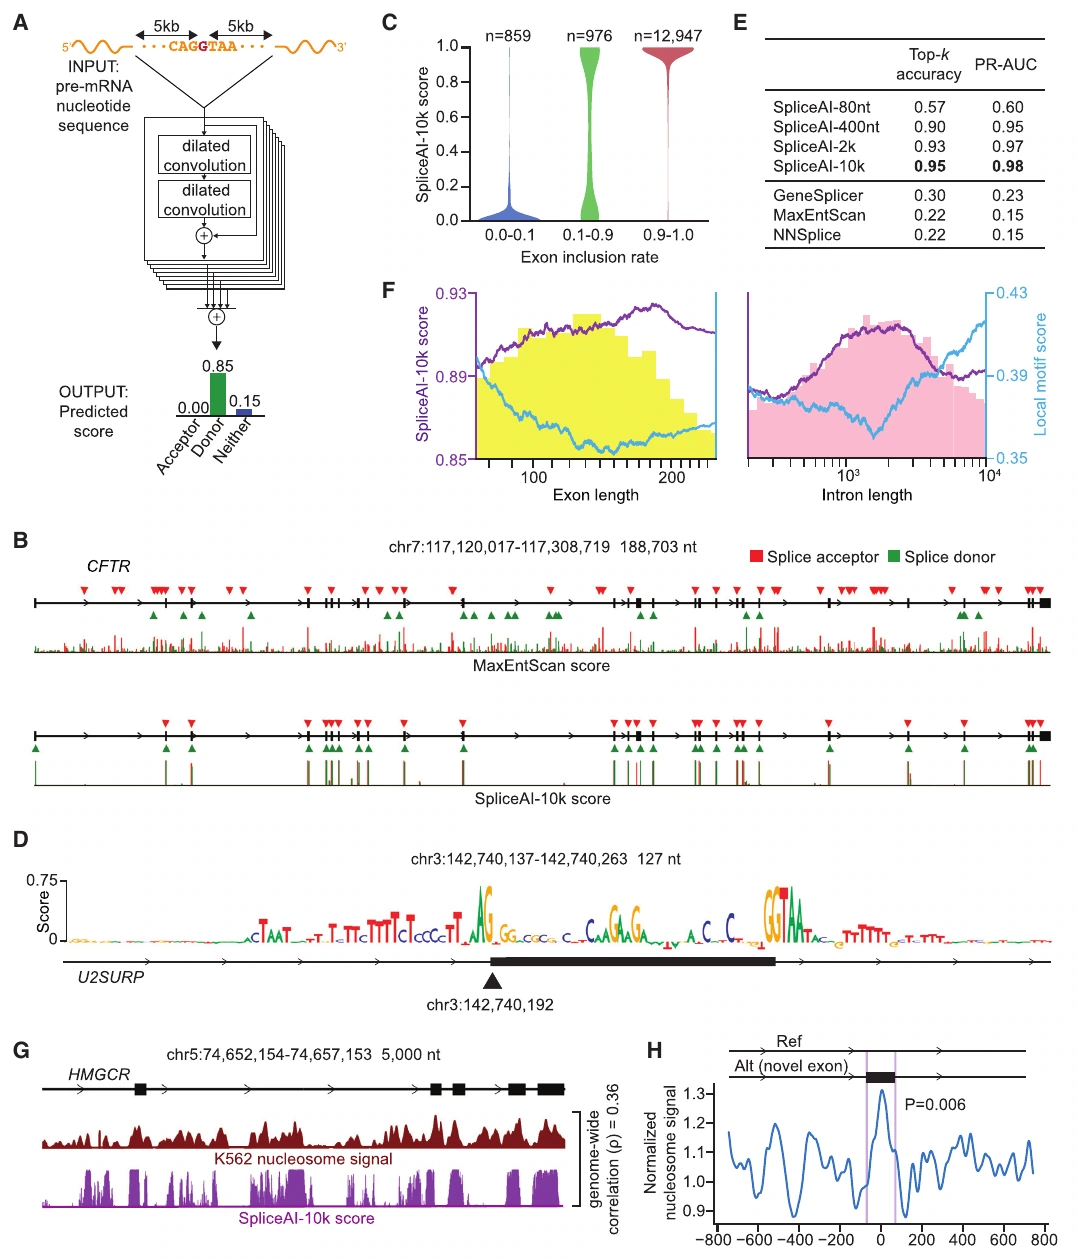
Figure 1:模型及长程剪接信号
原图来源:所用 PDF 文件第 3 页,Figure 1。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| A | 输入每个位置周围 10,000 nt 序列,输出受体、供体或非剪接位点概率;说明 SpliceAI 的逐位置预测。 |
| B | 比较 CFTR 全基因上 MaxEntScan 与 SpliceAI 的位点和实际外显子位置;同一预测数量下,SpliceAI 的定位更贴合真实基因结构。 |
| C | 按 RNA-seq 外显子包含率比较预测分数;组成型外显子与可变外显子呈不同分数,提示分数反映剪接使用程度。 |
| D | 计算突变 U2SURP 外显子 9 附近每个碱基,字母高度表示突变对受体强度的降低;定位模型依赖的调控碱基和成对位点信息。 |
| E | 改变输入上下文长度,比较 top-k 准确率和 PR-AUC;长上下文提高表现,并与其他检测算法对照。 |
| F | 横轴外显子/内含子长度,比较 80 nt 与 10 kb 模型的位点强度;长程模型能识别典型长度的外显子与内含子,即使局部基序较弱。 |
| G | 将间隔 150 nt 的受体/供体基序沿 HMGCR 移动,比较形成外显子的预测概率与 K562 核小体信号;显示预测与染色质位置存在关联。 |
| H | 预测形成新外显子的私有突变周围核小体平均信号,与随机背景检验;支持剪接预测含有可由序列推断的染色质相关信息。 |
B 的比较固定预测位点数,避免一种方法靠报出更多位点获得表面召回。E 的上下文消融把长程信息变成可检验因素;F 解释为什么长程模型能接受典型长度外显子的弱局部基序。D 的计算突变与 G/H 的核小体分析则探查模型是否利用生物学上下文。核小体关联提供合理机制线索,仍不能仅凭预测与相关性证明核小体的直接因果效应。top-k 准确率是在已知总位点数条件下衡量定位,与未知病例中任意阈值的临床阳性预测值不同。
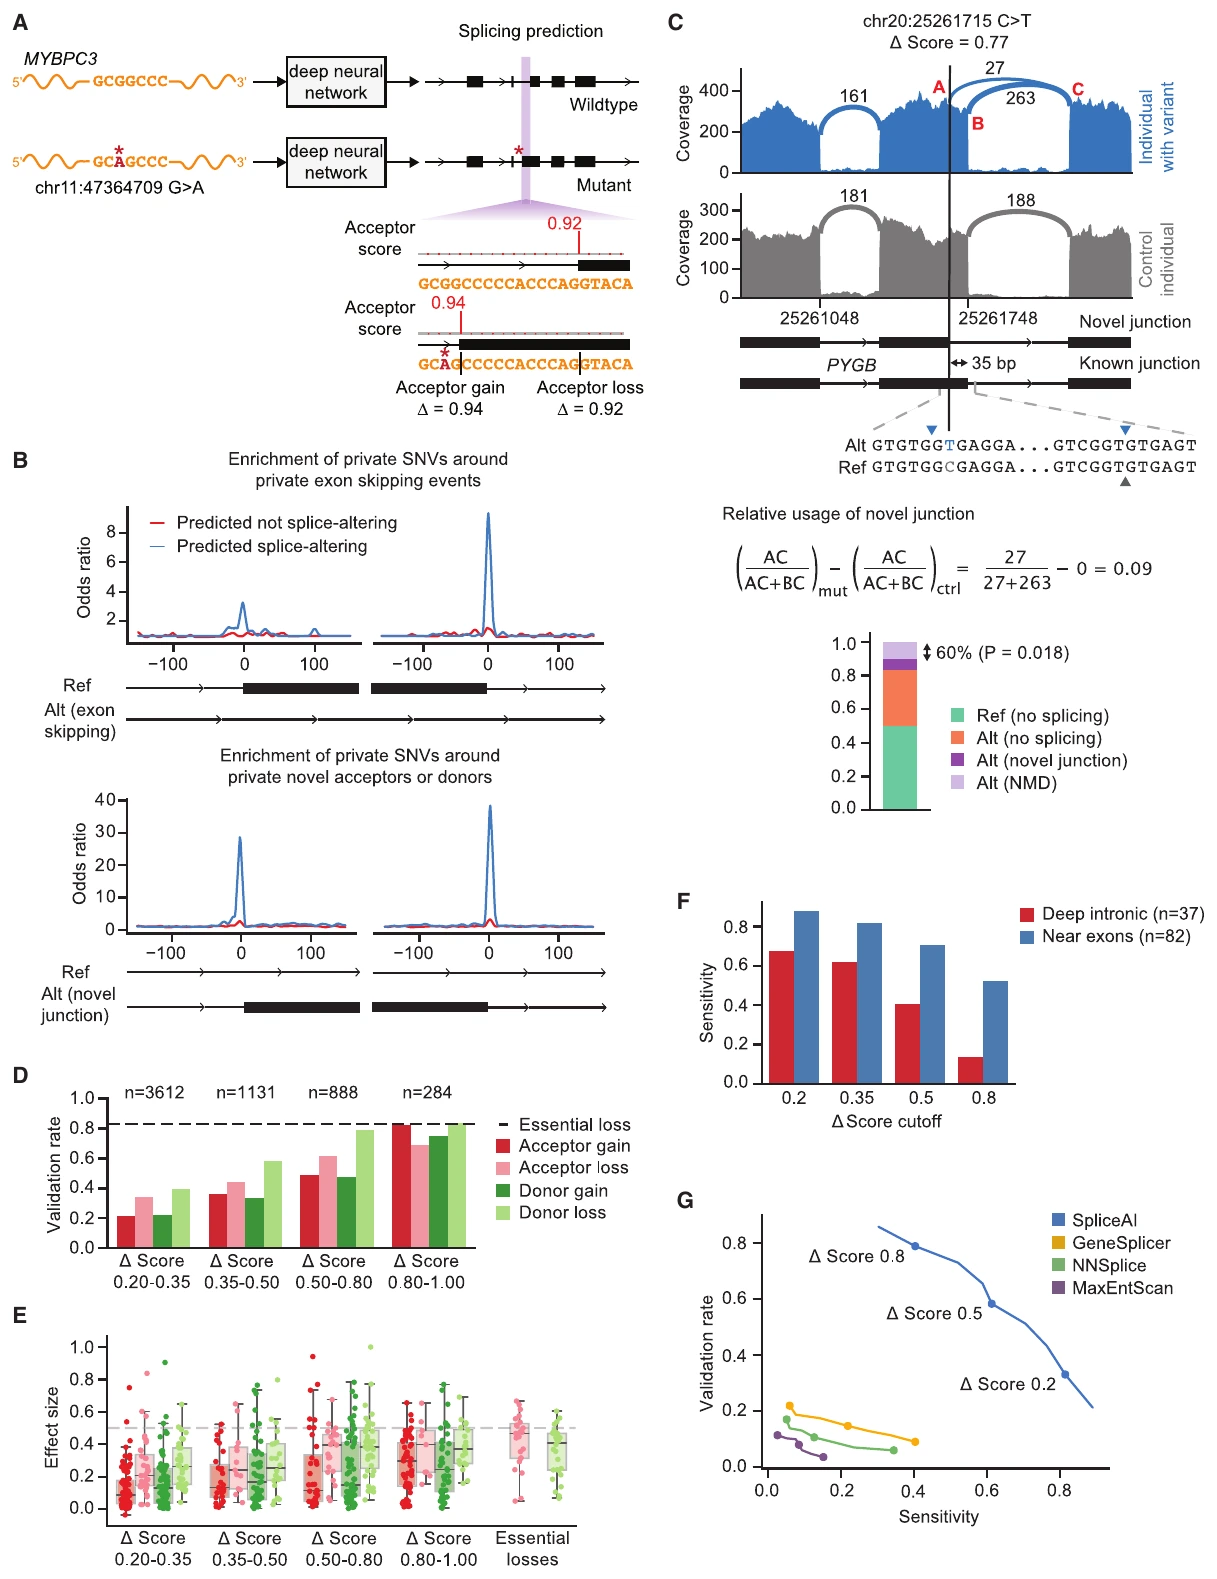
Figure 2:GTEx 中隐蔽剪接变异的验证
原图来源:所用 PDF 文件第 5 页,Figure 2。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| A | 以 MYBPC3 致病内含子变异为例,比较参考/突变序列的供体受体分数;50 nt 内最大分数变化定义 Δ score。 |
| B | 比较私有遗传变异与私有剪接事件在同一人共现的富集;预测有剪接效应的变异较无效应变异更常靠近外显子跳过或新剪接位点。 |
| C | PYGB 同义变异产生新供体位点;RNA-seq 和等位基因读数显示只有部分转录本改用新连接,且部分异常转录本可能被 NMD 清除。 |
| D | 按预测阈值统计 GTEx RNA-seq 验证率;高分变异较易验证,经典必需剪接位点也因覆盖/NMD 无法达到 100% 实测验证率。 |
| E | 展示已验证变异的剪接使用变化幅度;杂合变异并不都达到 50% 的变化,提示效应外显率及转录本降解有差异。 |
| F | 按 Δ score 阈值比较近外显子与深内含子变异的检测敏感性,体现阈值和区域对漏检的影响。 |
| G | 比较 SpliceAI 与其他方法的验证率—敏感性曲线;匹配预测数量后评估发现可靠变异的能力。 |
私有变异与私有剪接事件在同一供体共现,加上预测无效应变异和置换背景,检验的是单碱基预测能否跨越训练标签去解释真实 RNA。C 的读段比例显示异常转录本可能只占一部分,并受无义介导降解影响;因此未见异常 RNA 不能总归因于预测错误。D–G 必须一起读:高阈值提高验证率却降低敏感性,距离外显子更远时覆盖和事件检测更困难。没有足够表达或读段的位点是缺失证据,不能当作可靠阴性训练标签。
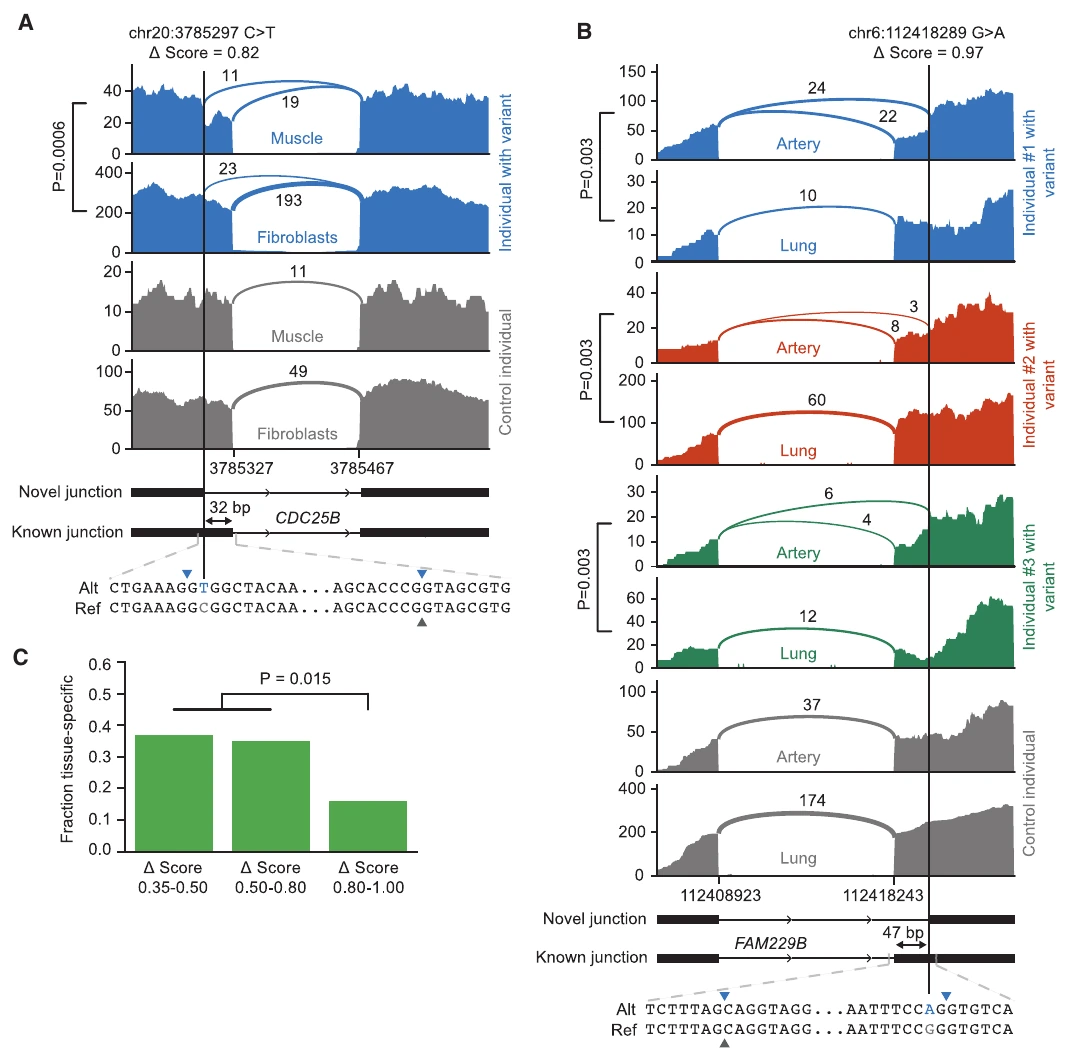
Figure 3:变异诱导的剪接具有组织差异
原图来源:所用 PDF 文件第 8 页,Figure 3。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| A | CDC25B 的新供体变异在肌肉和成纤维细胞产生不同新转录本使用比例,说明同一变异的效应受组织背景影响。 |
| B | FAM229B 的新受体变异在三名携带者的动脉和肺中显示一致的组织差异,支持该模式并非单个样本偶然现象。 |
| C | 统计新位点变异在不同组织的使用是否均匀;低到中分预测更常形成组织特异的可变剪接。 |
同一变异在不同组织产生不同连接使用比例,揭示模型的一个实际边界:序列对位点潜能重要,但 trans 因子、表达和转录本环境决定潜能是否实现。FAM229B 多名携带者的重复方向比单个示例更有说服力,仍不能代表所有组织。C 将组织差异与预测分数联系,说明低到中等强度的新位点更容易受环境调制。做疾病研究时应选择可表达目标转录本的组织,不能用血液阴性否定脑中特异异常。
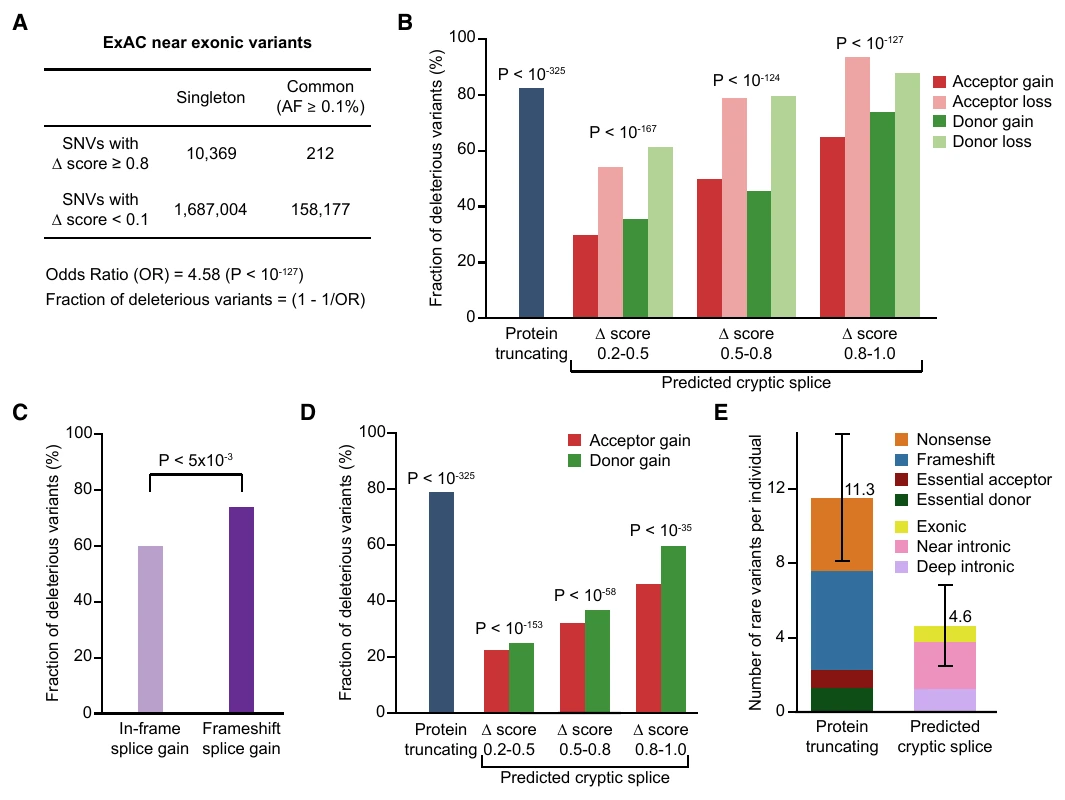
Figure 4:人群选择压力与变异负担
原图来源:所用 PDF 文件第 9 页,Figure 4。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| A | 比较 ExAC 中常见与极罕见的同义/内含子高分剪接变异;常见变异显著缺失,推断它们常受到负选择。 |
| B | 比较蛋白截断及不同类型隐蔽剪接变异的推断有害比例;揭示非编码剪接变异也可能有很强功能约束。 |
| C | 分开会或不会造成移码的新剪接位点变异;两类的有害比例不同,反映转录本结构后果的影响。 |
| D | 在 gnomAD 中评估距外显子超过 50 nt 的深内含子变异,与蛋白截断变异比较其负选择信号。 |
| E | 估计每个人的罕见蛋白截断和功能性隐蔽剪接变异数量;后者约 5 个,是结合选择压力的估计,不是全部预测都已实验验证。 |
人群频率为功能预测提供与 RNA 检测不同的检验:若一类变异显著有害,它们应较少达到常见频率。按同义/内含子、是否移码等类别分开,避免把不同突变后果混成一组。约每人 5 个功能性隐蔽剪接变异是结合选择信号的估计,既不是每人 5 个必然致病事件,也不是逐个实验确证。可突变性、基因约束和人口史仍影响频率,故选择压力支持总体功能重要性,不能直接给单个位点的疾病诊断。
Figure 5:罕见疾病的新生剪接变异
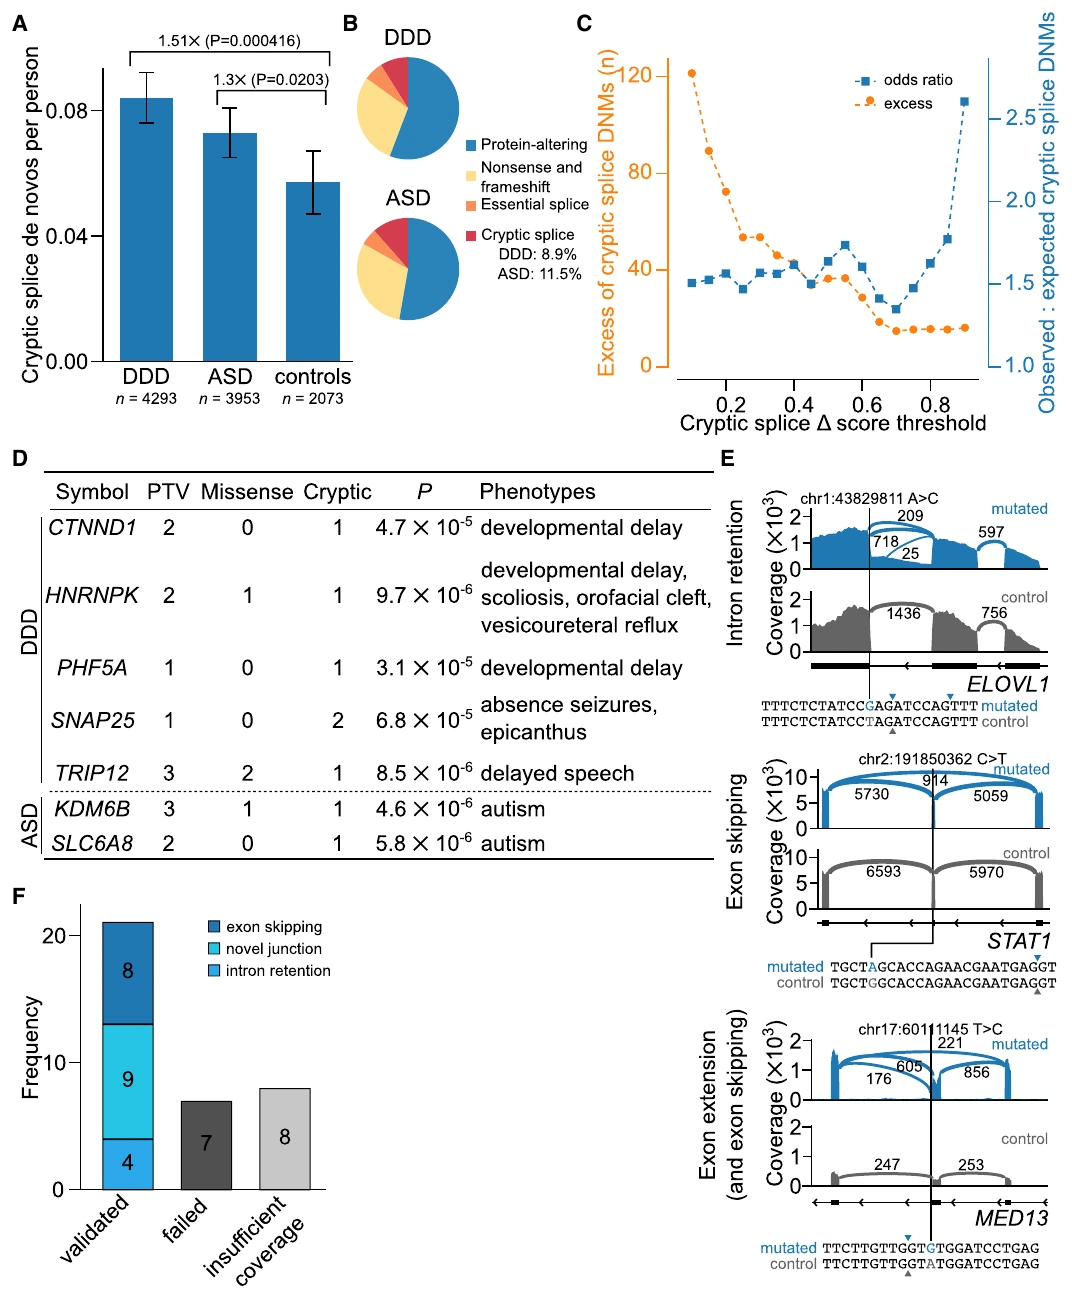
原图来源:所用 PDF 文件第 10 页,Figure 5。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| A | 比较发育障碍、ASD 与健康对照每人的预测新生隐蔽剪接突变数量,校正队列间检出差异后仍观察到病例富集。 |
| B | 按功能类别估计致病新生突变比例;隐蔽剪接变异提供一部分此前未被编码区分析覆盖的疾病负担。 |
| C | 改变 Δ score 阈值展示病例富集和多余突变数量,说明富集不仅依赖最强预测。 |
| D | 将隐蔽剪接和编码突变联合分析后达到发现阈值的新候选基因及共同表型,显示增加剪接信息对基因发现的价值。 |
| E | 展示 ASD 患者 RNA-seq 的三个验证例子:内含子保留、外显子跳过、外显子延长,与对照的连接及覆盖比较。 |
| F | 列出 36 个拟验证位点的验证状态;覆盖充分的 28 个样本中 21 个出现预测的独特异常剪接,覆盖不足者不能据此判阴性。 |
病例新生变异富集把分子层推到疾病层,需校正不同队列的检出差异,并与健康对照背景比较。D 展示增加剪接类别可能提高基因发现功效;E/F 用患者 RNA 验证让候选连接具有直接支持。21/28 是覆盖充分者的验证数,36 个拟验证位点不能全部作为分母上的已知阴性。推断 9%–11% 的致病突变贡献是基于研究队列和统计框架的估计,不能普遍套用到 AD 或所有罕见病人群。
我的理解与可迁移设计
最值得借鉴的是从输出定义改善研究:逐碱基剪接位置比只有一个黑箱致病分数更容易选择 RNA 验证读出。对 AD 内含子或 TE 区变异,可把剪接改变作为独立机制,与 enhancer/MPRA 调控效应并行检验;某个位点能改变报告活性,并不排除它也改变剪接。优先使用已训练模型、限定表达充分的转录本,报告预测方向、异常位置和组织限制。若没有患者 RNA,就只能提出剪接机制候选,不能把该机制写成已完成的实验验证。
