15.scGen:原图、模型逻辑与研究范式

15.scGen:原图、模型逻辑与研究范式
Perry论文题名: scGen predicts single-cell perturbation responses
期刊与年份: Nature Methods,2019。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
阅读来源说明: Nature Methods,2019;以当前 PDF 为准。
研究瓶颈怎样转化为问题
单细胞差异分析能描述已测刺激,但无法填补‘某类细胞在刺激后未测’的状态。scGen 将这一空白设为外推目标:在其他细胞中学习共同响应方向,再迁移到目标细胞未刺激状态。依据设计逻辑推断,其 idea 是让非线性表达变化在低维空间中近似可加,从而避免为每个细胞类型单独收集完整实验。
输入、目标与假设
VAE 由表达向量学习潜空间,通过重建与潜变量正则建立编码/解码映射;刺激和对照的平均潜表示之差 δ 加到目标对照细胞,再解码成刺激后表达。网络的非线性可让同一个 δ 在不同目标背景中产生不同基因响应,但 δ 的可迁移性是强假设。输入是转录组,不包含 DNA 位点或 enhancer 序列。预测‘未见刺激细胞类型’也不等于预测全新药物、全新剂量或真实时间轨迹;本文分别通过留出细胞、研究和物种检验一定范围的外推。
Figure 1:潜空间响应向量
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
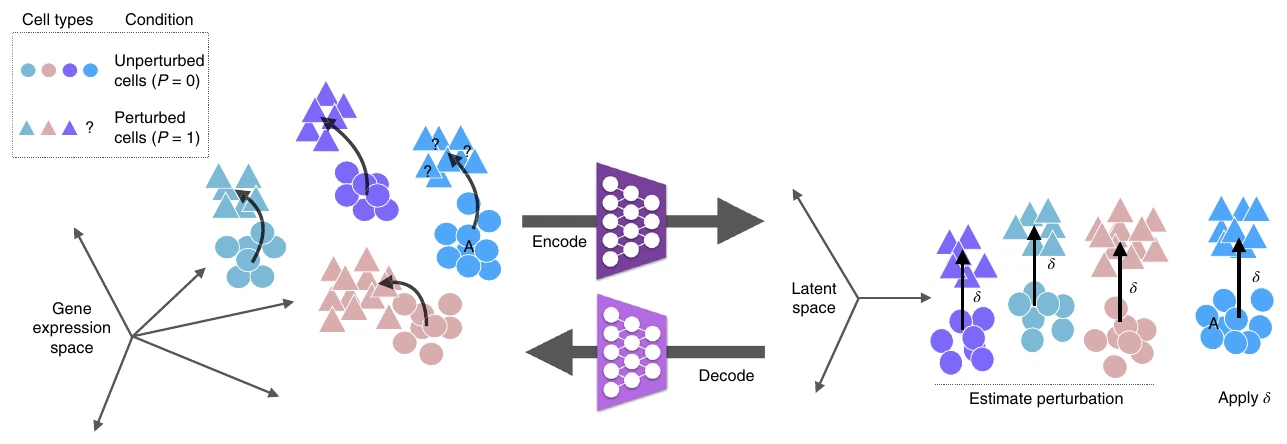
| 全图(无字母标签) | VAE 将表达映射到潜空间,由已见细胞的刺激与对照差计算响应向量 δ;把 δ 加到新细胞的对照潜表示,再解码为刺激后表达。线性潜空间操作可产生非线性的基因表达变化。 |
全图把训练和预测路径分开,最关键的是 δ 来自已测刺激/对照,而不是自动由刺激名称推断。潜空间线性不意味着基因表达线性,也不意味着该向量是一条真实生物时间轨迹。刺激与对照细胞群构成若不同,均值差还可能混入细胞组成和批次;设计中需要匹配标签和有效背景。它是一个简洁可解释的响应基线,后续复杂模型应证明超越它的具体场景。
Figure 2:留出细胞类型的 IFN-β 响应
原图来源:所用 PDF 文件第 3 页,Figure 2。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
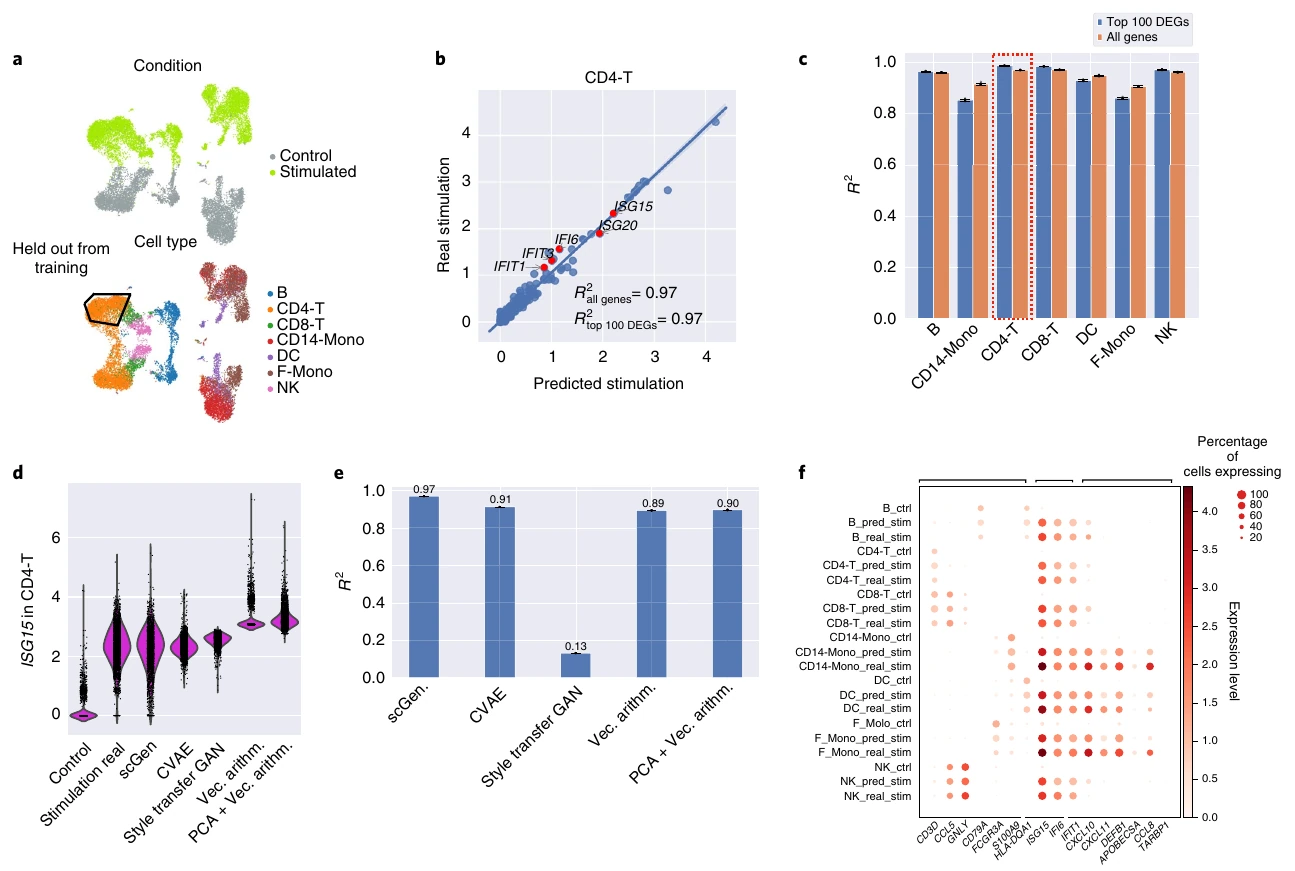
| a | UMAP 显示 PBMC 细胞类型、刺激状态和训练/留出分布,以 CD4 T 刺激状态作为未见目标。 |
| b | 比较预测与真实刺激 CD4 T 的平均表达,突出最强上调基因;评估整体相关性及响应基因。 |
| c | 七类细胞依次留出,比较平均表达的 R²(此处为 Pearson 相关平方),检验跨细胞类型稳定性。 |
| d | ISG15 在对照、真实刺激及不同模型预测中的表达分布,检查平均之外的单细胞异质性。 |
| e | 用相同 CD4 T 留出任务比较各模型 R²,展示 scGen 的相对表现。 |
| f | 七类细胞关键基因的点图对照未刺激、真实和预测刺激,检验响应模式。 |
CD4 T 刺激细胞留出,保留其未刺激状态,使模型只能迁移响应而不能直接重建训练中同一终点。总体平均相关容易由稳定基因主导,因此前 100 DEGs、ISG15 分布和细胞轮流留出更重要。文中 R² 为 Pearson 相关平方,不等于回归残差定义的解释方差;相关高也可能有系统幅度误差。单基因分布对应异质性,但不能证明每个预测细胞与真实细胞有一对一关系。
Figure 3:肠上皮感染响应
原图来源:所用 PDF 文件第 4 页,Figure 3。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
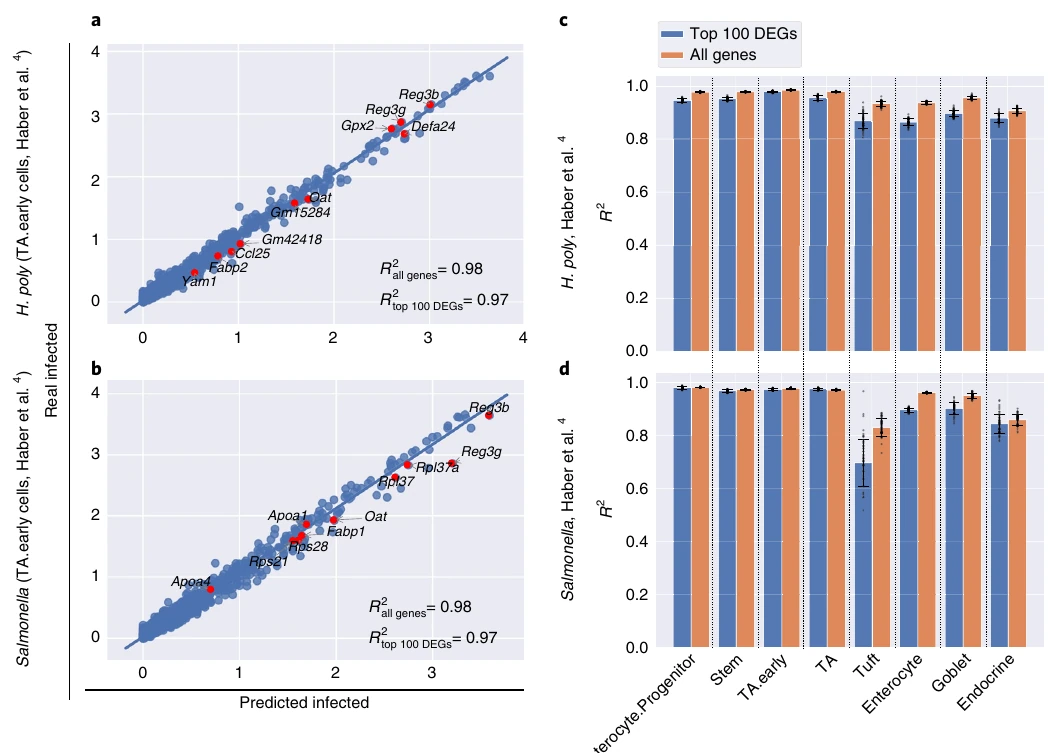
| a | 在沙门氏菌感染数据中留出早期 transit-amplifying 细胞,比较预测/真实平均表达及主要上、下调基因。 |
| b | 在蠕虫 H. poly 感染重复 a 的评估,检验不同感染时间及机制。 |
| c | 汇总沙门氏菌数据各细胞类型的 R²,比较响应预测范围。 |
| d | 汇总蠕虫数据各细胞类型的 R²,检验另一感染背景。 |
两种感染的数据检验响应向量不只在 IFN-β 的强共享程序有效。主要上/下调基因比所有基因平均更接近目标,多个细胞类别汇总检查结果是否被一个好案例支撑。感染同时可能改变细胞状态比例和取样时间,预测平均表达不能完全重建这种组成变化;也不能从一次感染外推另一种病原而不提供相应训练响应。
Figure 4:跨研究的刺激迁移
原图来源:所用 PDF 文件第 5 页,Figure 4。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
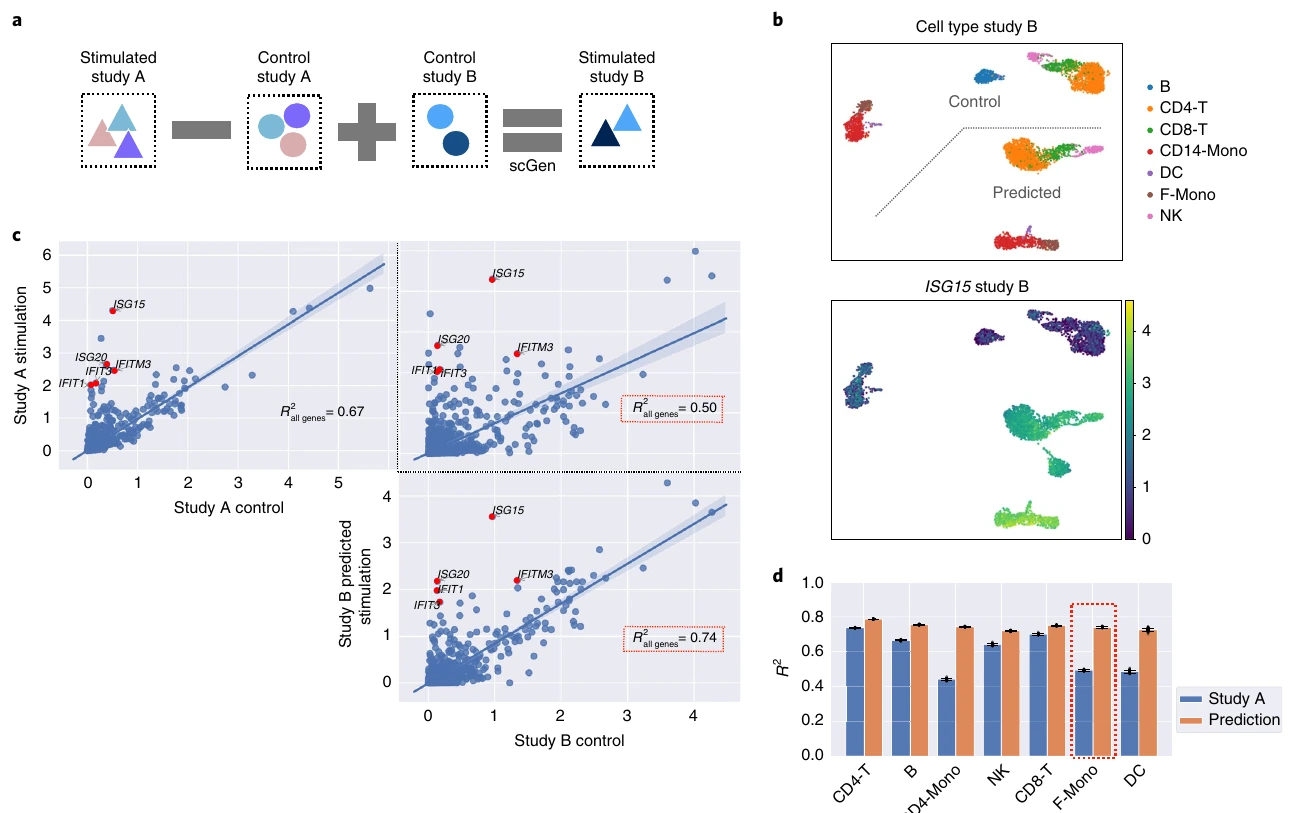
| a | 用研究 A 的响应向量加到研究 B 的对照细胞,模拟未测量的刺激状态。 |
| b | 研究 B 细胞的 UMAP 及 ISG15 颜色,显示预测后免疫响应基因激活。 |
| c | 比较 F-Mono 不同研究/状态的平均表达:先展示研究间背景差异,再展示 B 对照到 B 预测的变化,突出 A 中的响应基因。 |
| d | 对各细胞类型汇总 c 的相关性,衡量迁移与研究背景之间的关系;B 的预测状态缺乏同研究的真实刺激测量时不能当作直接实验验证。 |
跨研究背景迁移具有实用价值,但 B 的预测刺激若没有同研究真实刺激测量,就缺少直接终点对照。UMAP 移动和 ISG15 上升只说明模型应用了预期响应,并不验证全部响应强度。c/d 以已有研究作参照可以检查合理性,仍不能把生成状态称为新实验数据。后续若要验证,需预留独立有真实配对条件的研究,而非用训练研究的响应基因再次证明自己。
Figure 5:跨物种 LPS 响应
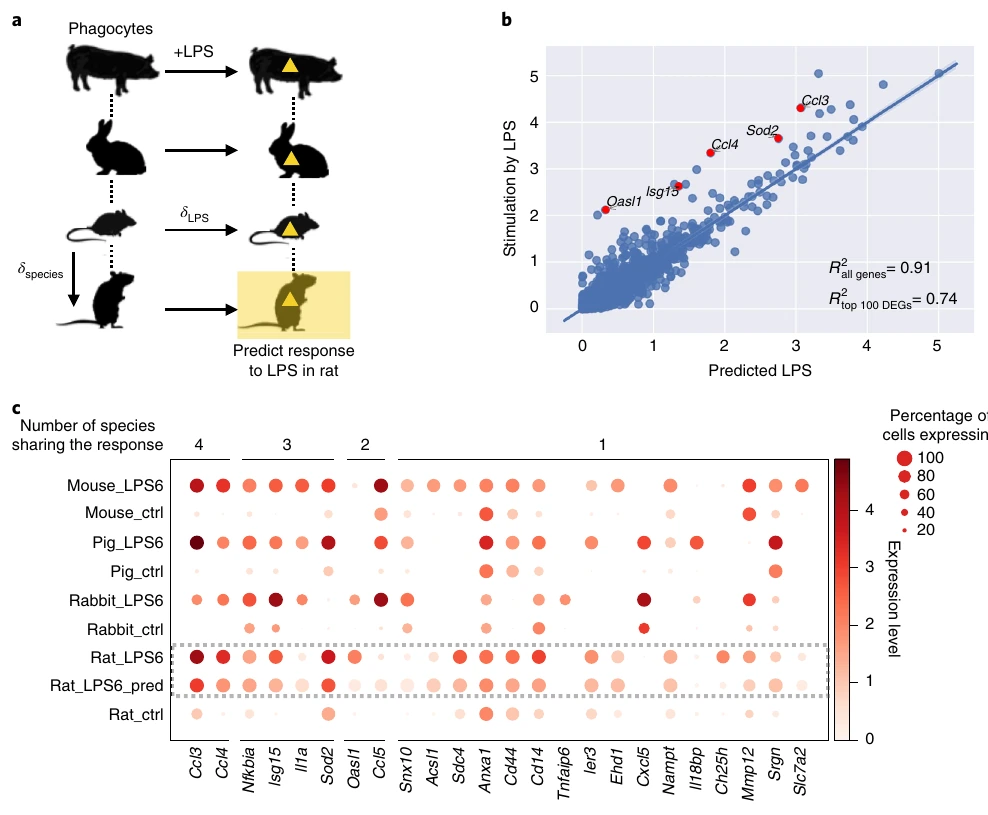
原图来源:所用 PDF 文件第 6 页,Figure 5。点击图片可查看原图。
| 子图 | 讲什么,以及怎样理解 |
|---|---|
| a | 从鼠、兔、猪刺激/对照学习,用于未见大鼠的刺激状态,展示跨物种数据安排。 |
| b | 对 6,619 个一对一直系同源基因比较大鼠真实/预测表达,突出主要响应基因,检验跨物种泛化。 |
| c | 各物种前十差异基因点图及共享数量,说明保守与物种特异的响应成分。 |
一对一直系同源基因确保表达空间基本可比,大鼠留出刺激的真实数据检验跨物种迁移。保守响应与物种特异成分需要同时读;去掉无一对一同源的基因也会丢失物种特异机制。该图证明一定 LPS 响应可迁移,不证明物种疾病风险、寿命或 AD 相同,更不能把潜空间响应差归因于 DNA 演化,因为模型未直接输入各物种调控序列。
我的理解与可迁移设计
有限资源研究可以用 scGen 作为很强的简洁基线,但应选择确有配对条件的公共实验,并按供体/研究留出。AD 病例与对照是观察状态,不能自动当作随机疾病扰动;病理、年龄和细胞组成可能被 δ 一起搬过去。若目标是 DNA 变异跨环境效应,则需要序列和真实等位标签,scGen 可帮助理解细胞状态,不能替代 MPRA。最重要的写作边界是:生成一个看似合理的表达状态,和在真实未见条件中验证预测,是两件不同的事。
实际基准中应加入‘不发生改变’和简单细胞类型平均响应,确认模型确实预测了扰动增量。若只比较预测与真实终点的跨基因相关,静态基因强弱可能让无响应模型也得高分。还应报告 DEGs 的方向、响应幅度及分布,而不是只报告漂亮的 UMAP。生成数据可用于假说探索,不能与真实细胞合并后再次作为独立验证,避免把模型假设反复强化。
