63.TaskiranEnhancerDesign:原图、模型逻辑与研究范式

63.TaskiranEnhancerDesign:原图、模型逻辑与研究范式
Perry论文题名: Cell-type-directed design of synthetic enhancers
期刊与年份: Nature,2024。论文原文。
范围为正文全部编号主图及其子图,包含流程示意图。Extended Data 和 Supplementary Figures 不在本次范围。页码指阅读时所用 PDF 的文件页码。
本篇问题: 能否用深度模型把随机序列设计成指定细胞活性的增强子,并控制表达范围?
图中的KC指果蝇蘑菇体的Kenyon细胞,是一类神经元;γ-KC是其中一个亚类。PNG指神经周胶质细胞。先记住这两个目标分别属于神经元和胶质细胞,就能理解后面最关键的比较:同一段随机DNA,朝不同细胞目标优化后,是否真的在不同细胞中开启报告表达。
把预测模型反过来用,能检验什么
通常的序列模型从天然 DNA 预测功能,容易停留在相关解释:一个 motif 与某类细胞开放相关,却不能说明把它植入另一段 DNA 后是否足够产生功能。这篇把预测器当作设计向导,从随机背景逐步制造新 enhancer,再通过报告实验检验。作者关注的不只是强活性,还包括活性在哪些细胞出现、能否添加第二套代码、能否删掉一套代码,以及实现功能所需的最短组合。
我的推测: 思路来自一个可直接操作的逆问题:既然模型能辨认目标细胞的序列,能否让它指出从无活性到有活性的最短改动路径?前向预测和逆向设计的证据责任不同;搜索能钻模型的漏洞,因此需要新序列、新实验和另一预测器检查。论文使用先前训练的 DeepFlyBrain 与 DeepMEL2,而不是在此重新从所有报告结果训练一个万能模型。输入主要为 500 bp 序列,细胞类型开放性分数提供搜索目标;逐碱基策略每轮测试全部单碱基替换并选择目标分数增长最多的一种,是贪心搜索,不是真实物种演化过程的重建。
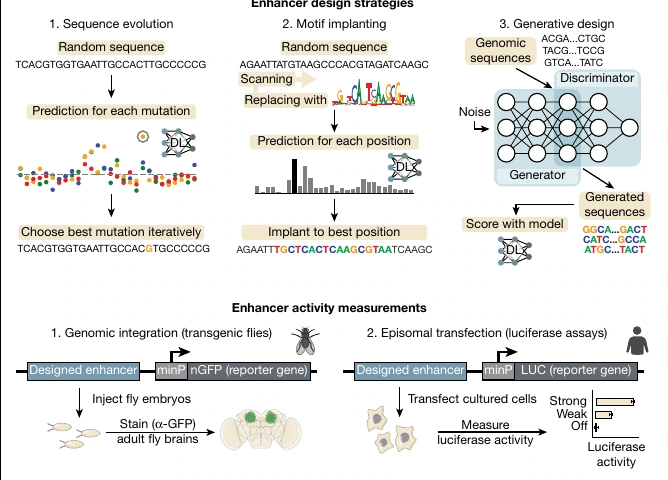
另一条策略按已知 motif 逐个植入,由模型选择位置;第三条是 GAN 从噪声生成类似真实 enhancer 的序列。三者分别偏向可追踪改动、可控制组件和可生成分布,正文重点展开前两种。随机背景按基因组的碱基分布调整,避免起点 GC 完全不同造成容易的对照;最终成功仍要由体内或细胞报告读出判断,而不能只由设计分数判断。
Figure 1:三种深度学习增强子设计策略
原图来源:所用 PDF 文件第 2 页,Figure 1。点击图片可查看原图。
图虽然没有字母,实际上包含三种不同研究范式。序列进化反复改变候选,motif 植入直接规定组件,生成设计学习天然序列分布;它们共同使用预测或功能测定筛选,但“生成了像 enhancer 的序列”和“生成了指定细胞中的 enhancer”并不等价。下面的人与果蝇实验还承担不同验证角色,不能把体外人细胞实验写成整个人体组织特异验证。
值得注意的是,每种策略的解释信息不同。逐步搜索保留中间步骤,可以观察功能在哪一步出现;直接植入适合问组合和间距是否足够;GAN 生成则较难把结果归结为一个可重复的最小改动。选择哪种方法取决于要回答的生物问题,不能只按哪个算法名字更新来排序。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| 全图(无字母) | 总览逐碱基优化、TF模体植入及生成式设计,并在果蝇脑及人细胞报告实验中验证增强子活性的流程。 |
Figure 2:把随机或天然序列进化成特定细胞增强子
原图来源:所用 PDF 文件第 3 页,Figure 2。点击图片可查看原图。
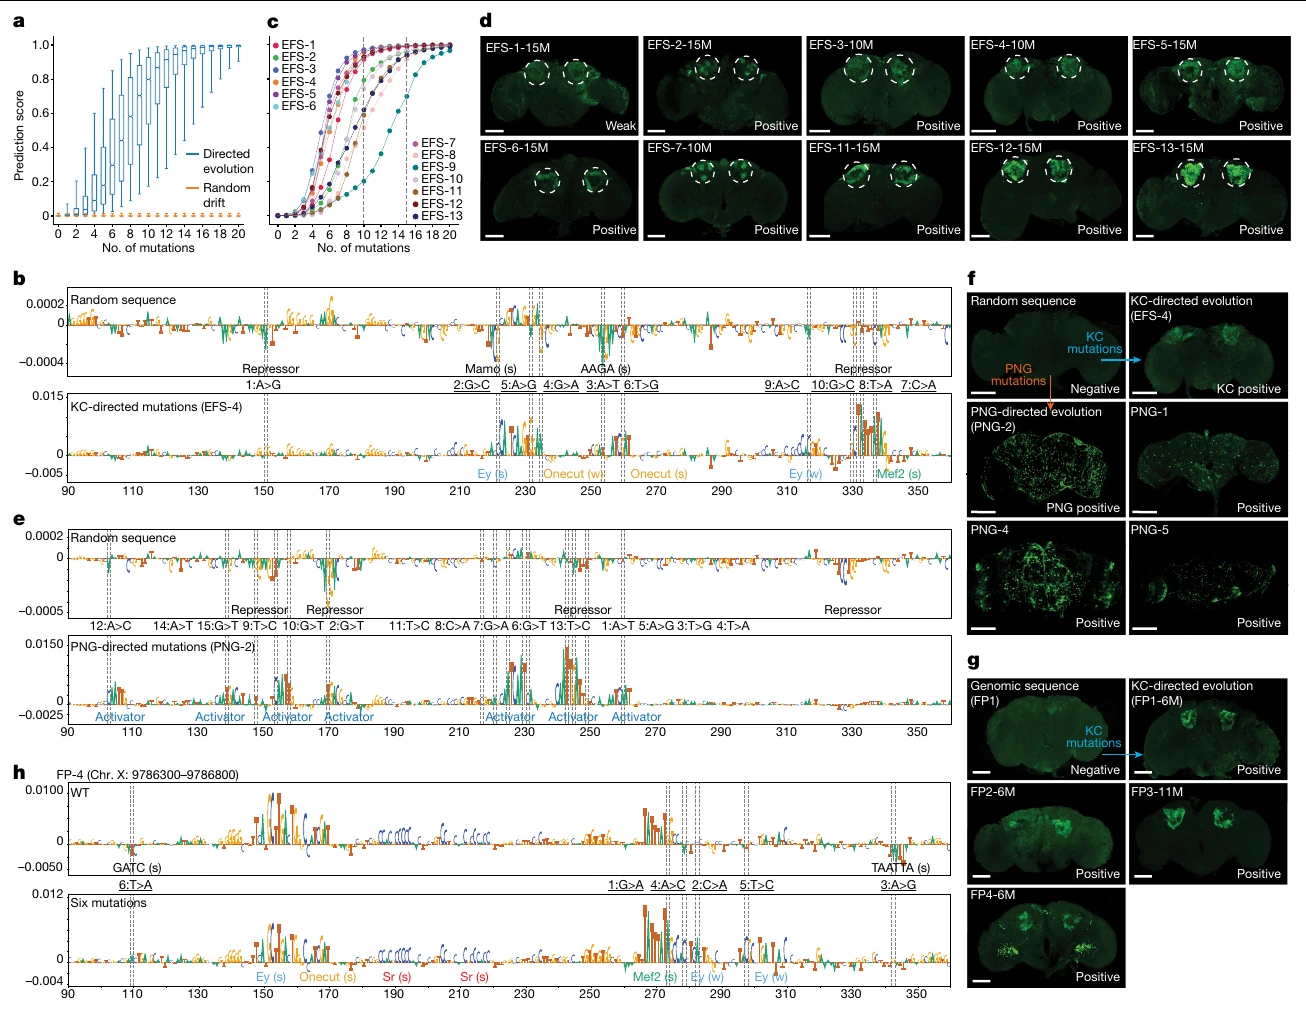
a 的随机漂变对照排除“任意增加同样多突变都会升分”的解释;b 的归因追踪新增与消失的候选结合位点,c 再明确实际克隆的是哪些中间步骤,避免把整体计算分布与少量实验测试混在一起。d 是关键外部检验:指定 KC 的新序列是否真在果蝇脑中报告表达。并非每条高分序列都成功,失败与难以判定的例子也影响总体成功率,不能用代表图代替分母。
e/f 更有力,因为同一个随机起点分别优化向 KC 和 PNG,减少起始序列不同的解释空间。目标改变后出现不同细胞活性,支持设计路径改动与合成序列功能相关。g/h 将策略延伸到天然的 near-enhancer,说明少量改动可以在报告环境中产生新活性;这并不证明自然选择历史上曾沿同一条最短路径进行,也不代表相应天然位点的原位靶基因已被改写。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 比较朝γ-KC目标优化与随机漂变的逐轮分数,目标导向突变提高预测活性。 |
| b | 随机序列优化前后γ-KC核苷酸归因,展示新出现或加强的模体及突变次序。 |
| c | 13个选中序列逐次突变的分数,标出用于实际克隆的轮次。 |
| d | KC设计序列的果蝇脑报告图,验证模型优化能产生目标细胞活性。 |
| e | 同一起始序列向PNG目标优化后的归因,显示目标改变会改变序列代码。 |
| f | PNG报告图比较初始序列、KC优化及PNG优化,验证活性可按指定细胞类型改变。 |
| g | 天然序列经过少量优化后的体内报告图,检验已有增强子可被重新定向。 |
| h | 对应天然序列优化前后的归因,定位产生新活性的碱基与模体变化。 |
Figure 3:通过激活与抑制代码扩展或限制表达范围
原图来源:所用 PDF 文件第 4 页,Figure 3。点击图片可查看原图。
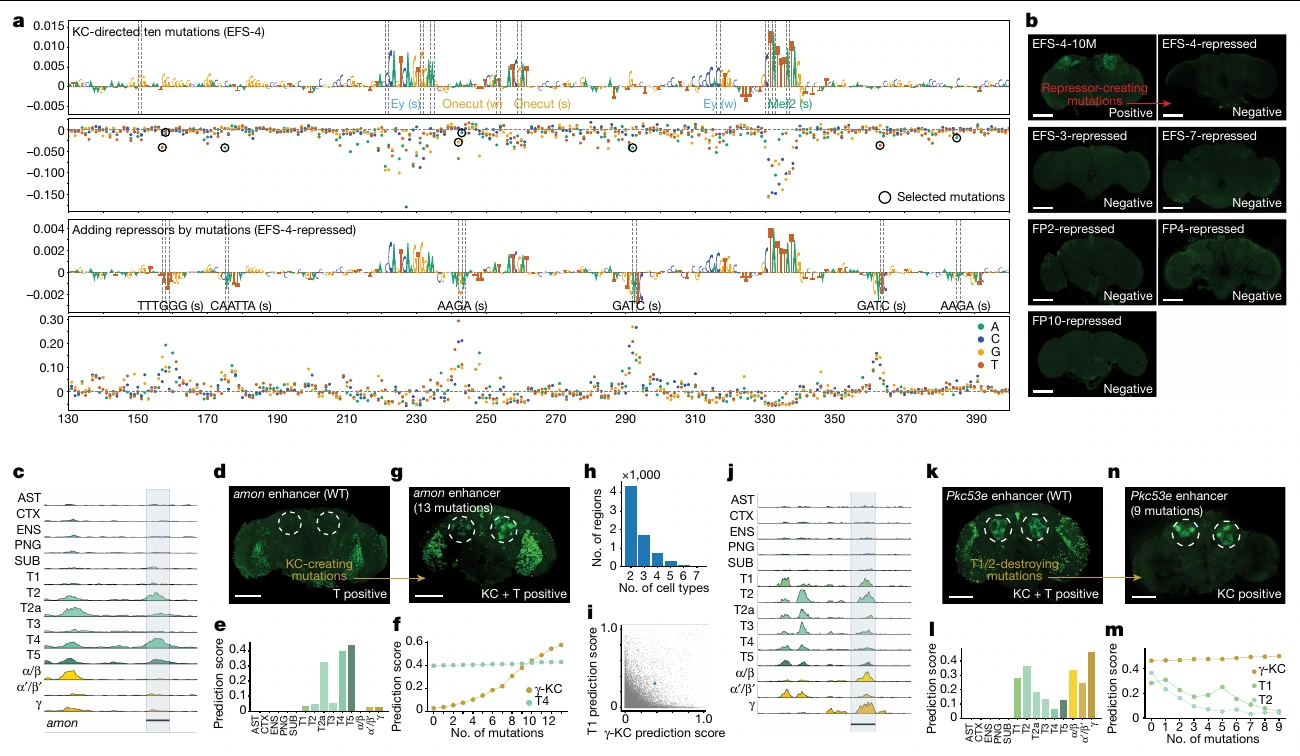
这张图包含两种必须分开的操作。a/b 向已优化的 KC enhancer 添加候选抑制位点,观察其目标活性被关闭;这不是单纯限制非目标细胞表达。归因给出建议,添加位点后的实测失活才使抑制代码具有功能证据,但仍需谨慎确定是哪个具体蛋白及何种分子过程。
c–g 从 amon 的天然开放与报告模式出发,向原有 T4 代码添加 KC 代码并保留旧输出,是“扩展”;h–n 从多细胞活性的 Pkc53e 出发,保留 KC、压低 T 神经元输出,是“剪枝”。原始报告图、预测向量、优化曲线和改造后报告图分别对应起点、目标、搜索、检验,缺一环就难以说明代码可独立调整。这里特别值得学的是多目标约束:仅让 KC 分数升高,无法回答原来 T4 功能是否仍在。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | EFS-4加入抑制位点前后的归因与饱和突变分数,识别会抑制目标KC活性的候选位点。 |
| b | 加入抑制位点前后的脑荧光图,验证添加抑制位点是否关闭KC报告活性。 |
| c | amon位点的染色质开放轨迹,定位天然增强子及原始细胞环境。 |
| d | amon增强子的体内报告图,给出原始活性模式。 |
| e | amon增强子各细胞类型预测分数,说明原有代码的特异性。 |
| f | 逐轮优化的γ-KC与T4分数,展示加入KC代码同时保留原有T4代码。 |
| g | 13次突变后的体内图,验证新增KC活性并保留原有T4模式。 |
| h | 同时对多个细胞类型高分的区域数量,展示多细胞代码在天然区域中的存在。 |
| i | 所有开放区域的γ-KC对T1分数,选择同时高分的Pkc53e实例。 |
| j | Pkc53e的多细胞ATAC轨迹,提供所选区域的实际开放背景。 |
| k | Pkc53e原始报告图,验证其多细胞活性。 |
| l | Pkc53e各类型预测分数,展示改变设计前的输出。 |
| m | 逐轮γ-KC、T1、T2分数,检验优化能有选择地调整多类型活性。 |
| n | 9次突变后的体内报告图,验证重新组合后的多细胞活性模式。 |
Figure 4:通过模体植入设计最小增强子
原图来源:所用 PDF 文件第 5 页,Figure 4。点击图片可查看原图。
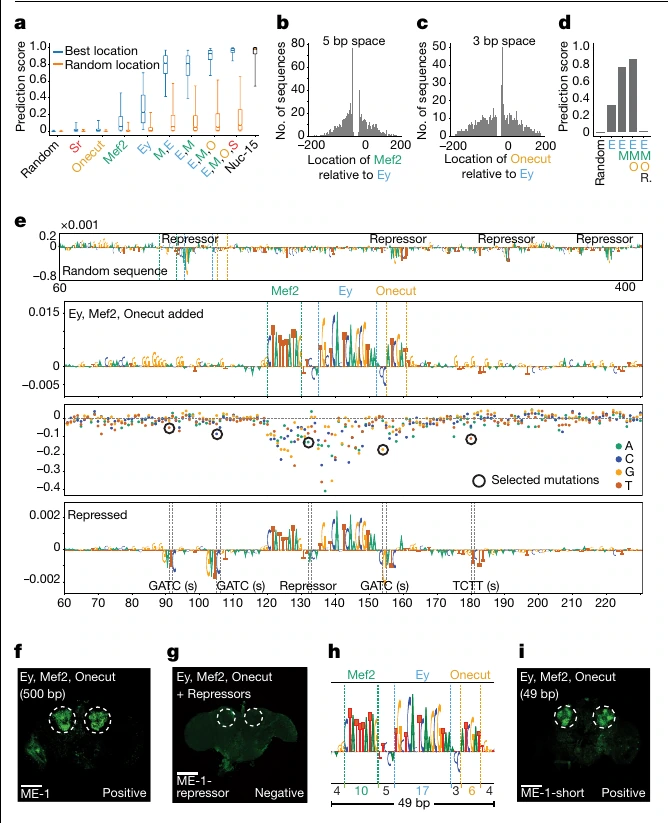
a 比较最佳位置与随机位置植入,检验“有 motif”与“安排得当”是否相同。b/c 在大量计算候选中显示 Ey–Mef2、Ey–Onecut 的位置偏好,提示空间组合规则;这些偏好来自模型选择的分布,不是所有天然 enhancer 必须遵守的刚性间距。d/e 用一条可追踪的构建将组合、分数和单碱基扰动联系起来。
f/g 不仅检验植入能否激活,还检验保留激活位点、加入抑制位点能否关闭输出。h/i 则把 500 bp 背景缩到 49 bp 的关键组合,检验所选组件在报告设置中的充分性。短片段成功是强有力的合成生物学结果,但没有说明自然基因组中周围序列永远无关,也没有证明用不同启动子、位置或发育时点仍有同样表现。最小性应限定为本次组合和测定环境。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 比较最佳位置、随机位置植入模体及15次碱基优化的KC分数,评估位置选择的重要性。 |
| b | Mef2相对Ey的位置分布,检验设计偏好的模体间距。 |
| c | Onecut相对Ey的位置分布,分析另一种模体的空间配置。 |
| d | ME-1依次植入模体及生成抑制位点后的分数,展示构建增强子代码的步骤。 |
| e | ME-1各步骤归因及饱和突变,定位激活模体、间距和抑制突变。 |
| f | 500bp模体植入序列的脑报告图,验证人工组合可驱动目标活性。 |
| g | 同一500bp序列加入抑制位点后的报告图,验证目标KC活性丢失。 |
| h | 把关键区域缩为49bp并展示模体、间隔和两侧序列,说明最小设计的构成。 |
| i | 49bp序列的体内报告图,验证很短的组合代码仍有增强子功能。 |
Figure 5:人黑色素细胞增强子设计及多模型检验
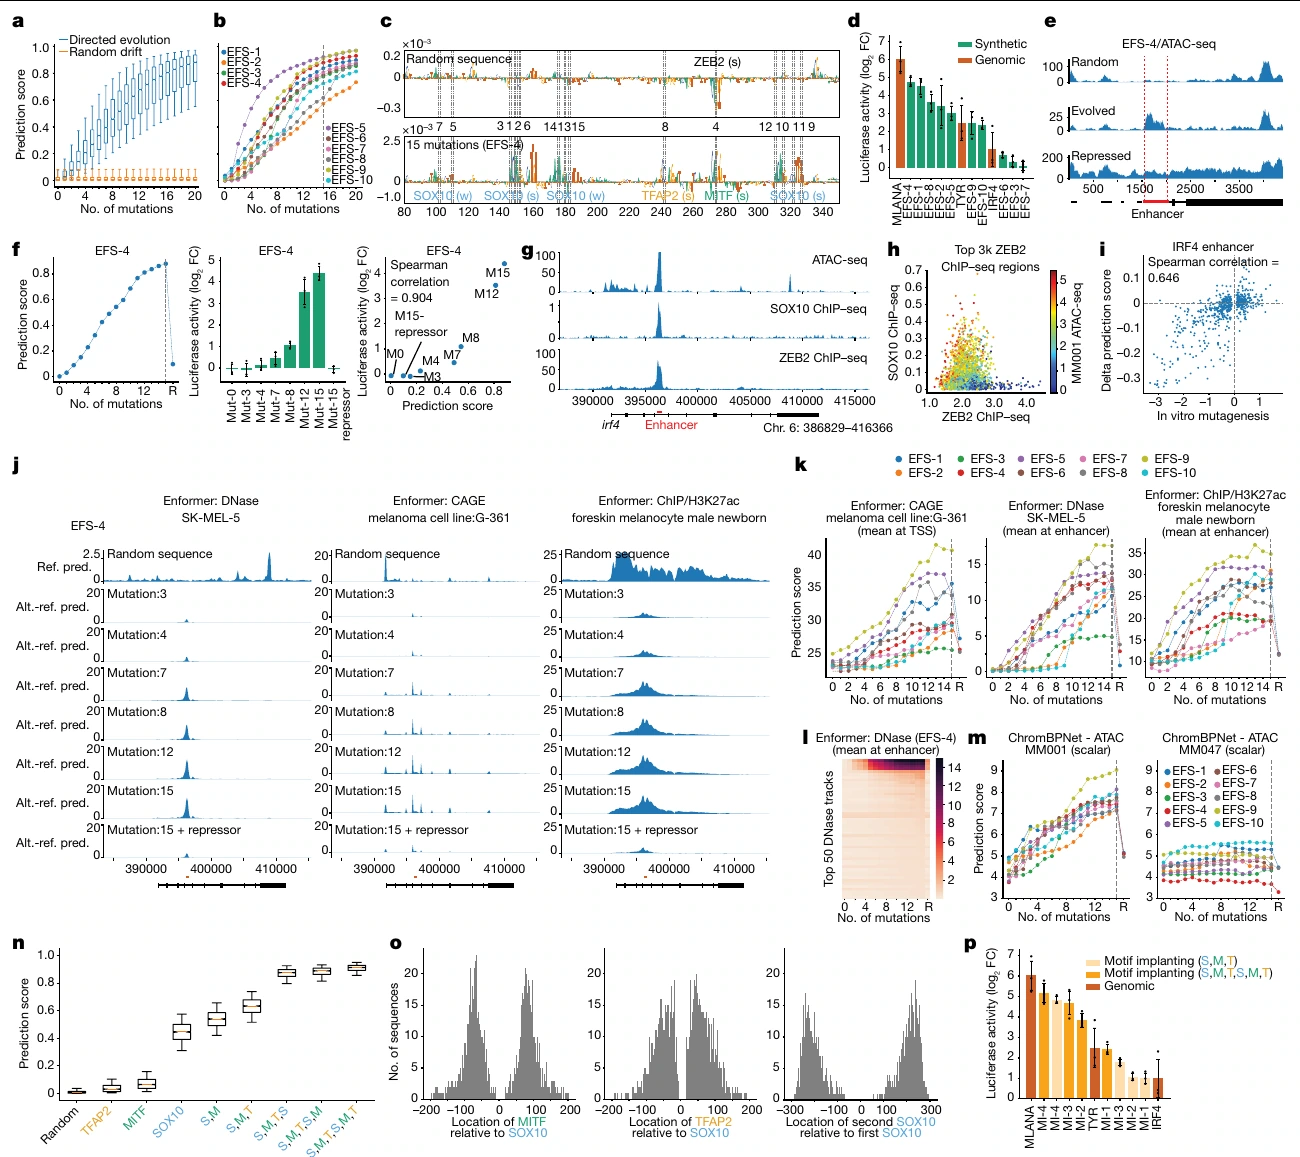
原图来源:所用 PDF 文件第 6 页,Figure 5。点击图片可查看原图。
a–f 将逐步设计从果蝇转到人黑色素细胞相关状态,分数分布、选中路径、荧光素酶与整合构建的 ATAC 分别提供计算、抽样和功能层面的信息。MEL 与 MES 的背景比较尤其重要:强表达若在两种状态都出现,就不满足目标特异性。g/h 用天然 IRF4 区域的 SOX10、ZEB2 结合与开放观察支持激活—抑制解释,i 的逐碱基实测功能提供比另一张 motif 图更直接的变异检验。
j–m 必须标清哪些是计算:替换 IRF4 enhancer 后的 Enformer 输出是 in silico 操作,不是已经在原位完成 CRISPR 并测到 IRF4 上调。另一模型也支持变化,能减弱只优化 DeepMEL2 特有漏洞的疑虑,但模型一致性仍不能替代实验。n–p 改用人 TF motif 植入,显示机制策略可以移植;与果蝇的明确间距偏好相比,人实例显示较宽松的邻近配置,提醒读者不要把一个系统的语法写成全基因组普适定律。
| 子图 | 讲的是什么,以及如何理解 |
|---|---|
| a | 4000条随机序列朝MEL目标逐轮优化的分数分布,展示整体设计成功趋势。 |
| b | 10条实际选择序列的分数轨迹,连接总体优化与实验测试。 |
| c | 代表合成序列15次突变前后归因,标出形成的TF结合位点。 |
| d | 合成与天然增强子的荧光素酶活性,验证预测优化产生真实表达增强。 |
| e | MM001中整合初始、优化和带抑制位点报告序列的ATAC轨迹,检验设计改变染色质开放。 |
| f | EFS-4的DeepMEL2分数、报告活性及其相关,检验预测方向与实测结果是否一致。 |
| g | IRF4附近ATAC、SOX10及ZEB2 ChIP轨迹,为激活/抑制代码提供天然参照。 |
| h | ZEB2与SOX10结合强度散点按ATAC着色,考察两类因子共现与开放度关系。 |
| i | IRF4增强子的体外与计算机内饱和突变比较,检验逐碱基效应。 |
| j | 把不同EFS-4版本替换IRF4增强子后的Enformer预测,检查整个位点上下文中的作用。 |
| k | Enformer随逐轮突变及抑制位点加入的输出,检验另一模型是否支持设计变化。 |
| l | EFS-4在多种DNase轨道的预测,检查活性是否集中于黑色素细胞相关环境。 |
| m | ChromBPNet在MEL与MES细胞中的ATAC预测,检验状态特异性与逐步设计效果。 |
| n | 2000条序列植入MEL模体后的分数分布,展示模体植入也可在人细胞应用。 |
| o | 人TF模体的相对位置分布,分析设计中的间距偏好。 |
| p | 模体植入序列与天然增强子的报告活性,验证这一路径的实验效果。 |
我的理解:好的设计研究应把轨迹也送去验证
最值得借用的不是“给序列加几个 motif 就能做 enhancer”这一简化说法,而是保留起点、中间步骤、终点和反向破坏的完整比较。逐步加强后功能出现,再添加抑制或破坏位点使功能消失,比终点一个高分和一张阳性图片更能说明规则。与此同时,贪心搜索偏向局部最优,计算最短路径也未给出自然突变概率、适应度或祖先状态,不能把这种“进化”直接用作物种起源的证据。
这篇属于模型指导的干预设计与实验闭环。序列层面的设计对报告活性具有干预证据,疾病层面的因果仍未完成:人黑色素瘤状态和 IRF4 构建实验不是 AD 队列、神经病理或治疗效果的验证。对 AD 的 TE 片段,我会借其“原序列、精确 SNP、motif 破坏、功能救回”的四组思路,在同一背景中识别某个候选 motif 是否解释等位差;若只有模型升分而真实 MPRA 没有变化,该机制就需要被否定或修正。
纯计算阶段可以先寻找这样的可检验路径,并用独立公共功能数据检查,不能把候选设计写成已完成实验。还要注意论文的 ATAC/ChIP 实验与报告实验重复配置不同;不同图的误差和分母不应互换。这种对证据责任的区分,比把所有验证合写成“模型准确”更能指导下一步研究。
来源核对: 依据原文正文 Figure 1–5、Discussion 及 Methods 的随机背景、逐碱基搜索、motif植入、报告与多模型验证设置。本文卷期为2024,在线发表于2023年12月。
